SillyTavern 모델 순위 선정 기준
주요 근거는 14개의 공식 모델을 10개 카테고리로 나누어 840개의 답변을 평가한 2026년 9월 AI 역할극 벤치마크(AI Roleplay Bench)입니다. 해당 벤치마크는 동료 채팅, 게임 마스터 행동, 엄격한 캐릭터 음성, 악역, 견고성, 성인 테마 및 안전 경계 등을 다룹니다. Kimi K3, GLM-5.3, DeepSeek V4.1 Flash 간의 점수 차이가 2점 미만이기 때문에, 벤치마크 자체에서도 소수점 차이를 결정적인 승리로 보기보다는 사실상 동점으로 해석할 것을 권장합니다.
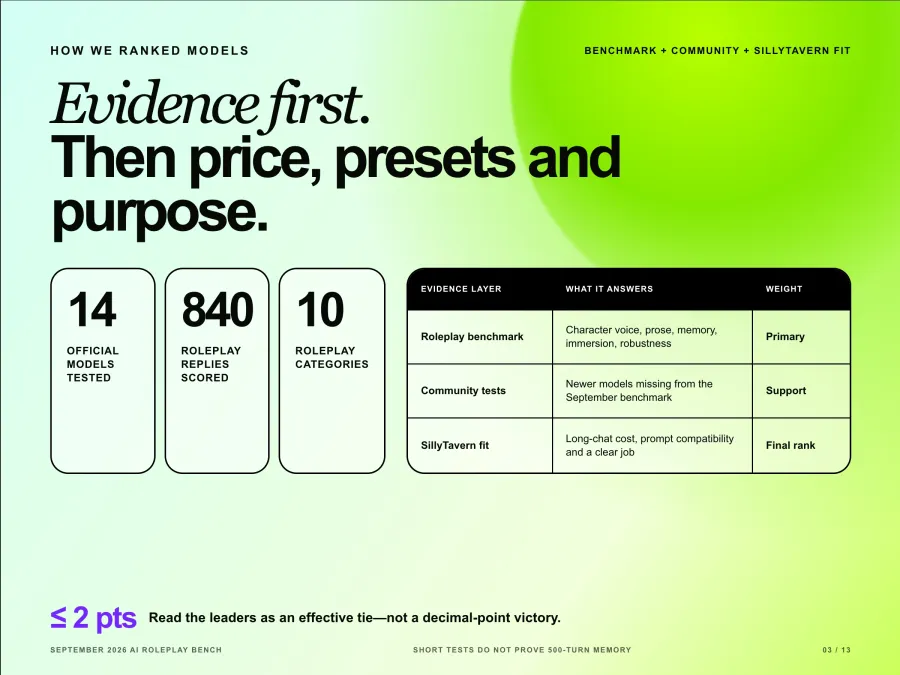
이 벤치마크에도 한계는 있습니다. 공개된 방법론은 짧은 다회차 시나리오를 사용하며, 수백 개의 메시지에 걸친 드리프트(일관성 저하)를 측정하지 않고, 커뮤니티 파인튜닝 모델을 제외합니다. Gemini 4 Argon과 같은 최신 릴리스는 테스트 이후에 출시되었습니다. 이러한 모델의 경우, 커뮤니티 비교 자료를 보조 증거로 활용하며 추천의 확실성을 낮게 표시했습니다.
최종 순위에는 세 가지 SillyTavern 특화 요소가 추가되었습니다:
장기 채팅 경제성. SillyTavern은 캐릭터 카드, 지침, 관련 설정 및 대화 기록을 반복해서 전송하므로, 후반부 대화에서는 입력 토큰 비용이 지배적인 비중을 차지합니다.
프롬프트 및 프리셋 호환성. 채팅 완성(Chat Completion), 텍스트 완성(Text Completion), 인스트럭트 템플릿, 샘플러 및 추론 제어 설정은 서로 호환되지 않습니다.
모델별 명확한 역할. 저렴한 모델은 단순히 가격이 낮다는 이유가 아니라, 유용한 역할을 수행할 수 있을 때만 순위에 포함됩니다.
SillyTavern 역할극을 위한 최고의 AI 모델 8선
1 Kimi K3: 최고의 종합 SillyTavern 모델
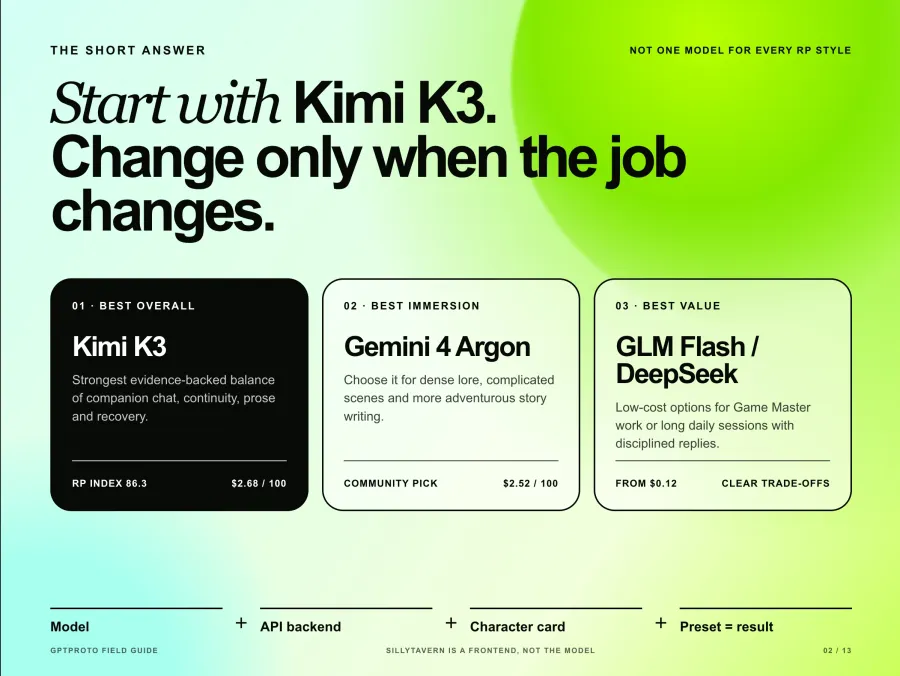
Kimi K3는 어떤 역할극 스타일을 선호하는지 아직 확실하지 않을 때 가장 안전한 첫 번째 선택지입니다. 이 모델은 역할극 벤치마크에서 종합 86.3점, 동료 부문 90.0점, 견고성 부문 88.3점을 기록했습니다. 또한 캐릭터성, 문체, 기억력, 몰입도 부문에서도 벤치마크 평가를 주도했습니다.
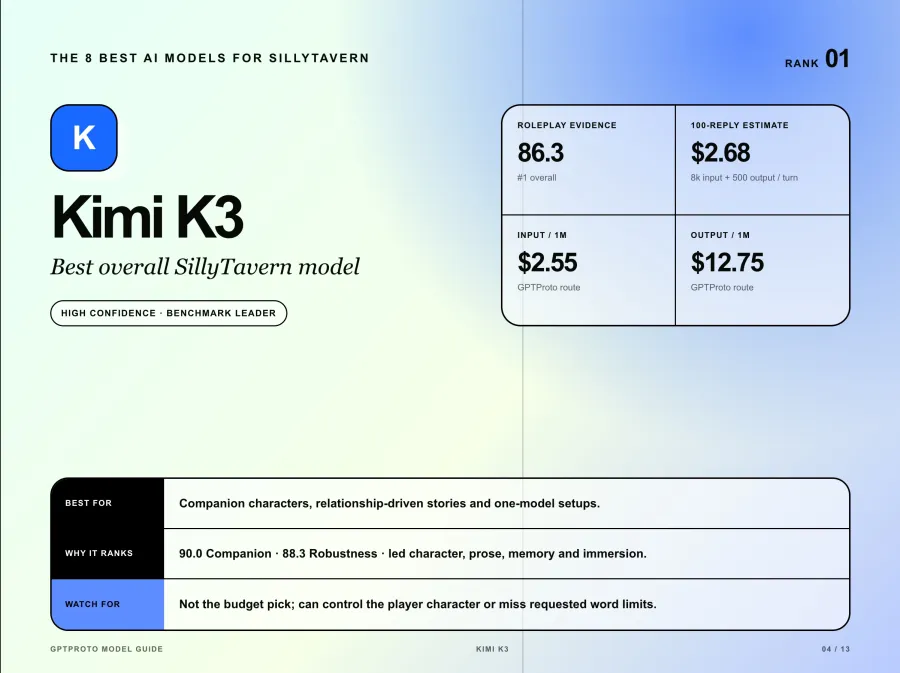
SillyTavern에서는 화려한 답변 한두 번보다 이러한 균형감이 훨씬 중요합니다. Kimi는 사용자의 단답형 메시지를 잘 처리하고, 심어둔 세부 정보를 기억하며, 일반적인 어시스턴트처럼 변하지 않고 캐릭터를 활발하게 유지했습니다. 단점도 명확했는데, 때때로 게임 마스터처럼 플레이어의 캐릭터를 조종하거나 요청한 단어 제한을 지키지 못하는 경우가 있었습니다.
최적의 용도: 동료 캐릭터, 관계 중심 스토리, 그리고 여러 역할극 스타일에 하나의 모델을 사용하려는 사용자. SillyTavern 시작 가이드: Chat Completion을 사용하고, 정확한 kimi-k3 모델 ID를 선택한 뒤, 더 복잡한 프리셋 규칙을 추가하기 전에 적절한 응답 길이를 설정하세요. 백만 토큰당 입력 $2.55, 출력 $12.75로, 예산 절감형 모델은 아닙니다.
2 Gemini 4 Argon: 몰입형 롤플레잉을 위한 최고의 선택
Gemini 4 Argon은 방대한 세계관 설정, 복잡한 장면, 장문 스토리 작성을 위한 최근 커뮤니티에서 가장 강력한 지지를 받는 모델입니다. SillyTavern 사용자들은 이 모델이 긴 프롬프트를 정확하게 처리하며, 단순히 캐릭터 카드의 내용을 바꾸어 말하는 대신 유용한 장면 세부 정보를 추가하는 능력을 높게 평가했습니다. 장문 스토리 활용에 관한 한 상세한 커뮤니티 토론에서는 다른 모델에서 정체되었던 스토리가 이 모델을 통해 명확하게 개선된 사례를 설명했습니다.
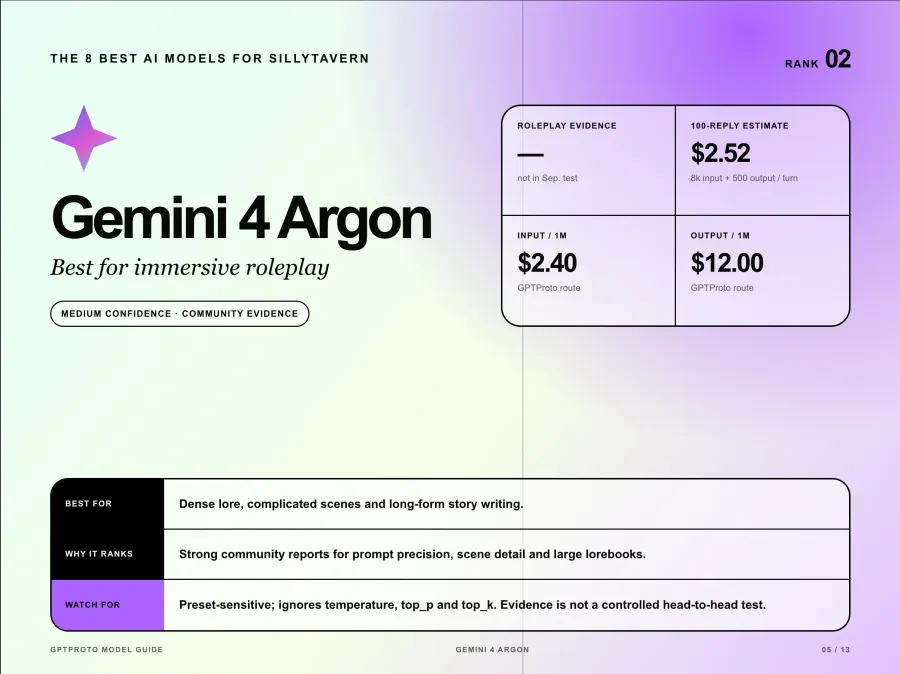
Argon은 9월 롤플레잉 벤치마크에 포함되지 않았기 때문에 Kimi나 GLM보다 신뢰 수준은 낮습니다. 커뮤니티의 열광적인 반응은 증거가 될 수 있지만, 통제된 일대일 비교 테스트 결과는 아닙니다.
또한 Argon은 전용 프리셋이 필요합니다. 이 모델의 API는 temperature, top_p, top_k를 무시하므로, 기존의 샘플러 중심 Gemini 프리셋을 복사해서 사용하면 해당 값들이 변경되지 않은 채 제어되고 있다는 착각을 줄 수 있습니다. 일대일 캐릭터 채팅에는 'medium thinking'으로 시작하고, 규칙이 많은 RPG나 방대한 로어북(lorebook)의 경우에만 'high thinking'을 테스트해 보세요. 단점은 비용입니다. 입력 100만 토큰당 $2.40, 출력 100만 토큰당 $12의 요금으로 인해, 대화 기록이 늘어나기 전 100회 응답 테스트 비용이 약 $2.52에 달합니다.
3 GLM 5.3: 가장 균형 잡힌 스토리 모델
GLM-5.3은 모델이 스토리의 더 많은 부분을 주도하기를 원할 때 Kimi K3를 대체할 수 있는 가장 설득력 있는 대안입니다. 이 모델은 종합 점수 85.1점, Strict Voice 부문 92.5점, Robustness 부문 85.8점을 기록했습니다. 벤치마크에 따르면 이 모델은 스토리 중심의 롤플레잉, 다크 픽션, 어드벤처 봇에 특히 효과적입니다.
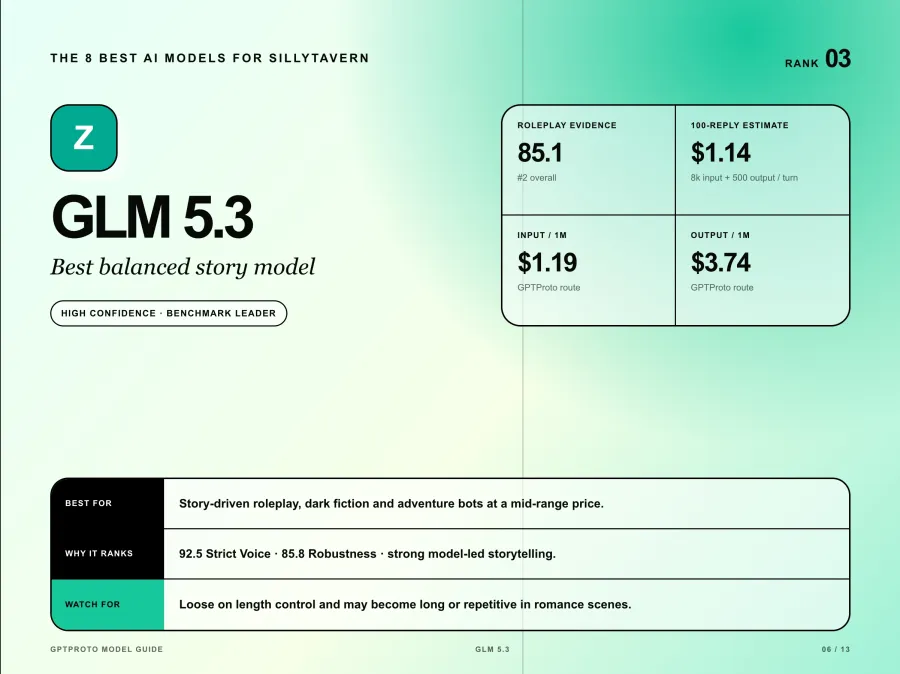
단점은 길이와 속도 조절입니다. GLM-5.3은 주요 모델 중 단어 제한을 가장 느슨하게 적용하며, 벤치마크의 로맨스 시나리오에서는 응답이 길어지고 반복적이게 되는 등 성능이 훨씬 저조했습니다. 엄격한 최대 응답 길이 설정과 명확한 대화 기록 이후 지침이 도움이 될 수 있지만, 간결한 출력을 보장하지는 않습니다.
입력 100만 토큰당 $1.19, 출력 100만 토큰당 $3.74의 비용으로, GLM-5.3은 앞서 언급한 100회 응답 테스트에서 Kimi K3 비용의 절반 이하입니다. 모델 ID glm-5.3을 사용하세요. 매번 프리미엄 모델 요금을 지불하지 않고도 강력한 롤플레잉 품질을 원하는 사용자에게 합리적인 기본 선택지입니다.
4 DeepSeek V4.1 Flash: 가성비 좋은 긴 세션용 모델
DeepSeek V4.1 Flash는 이 목록에서 품질 대비 비용 효율성이 가장 뛰어납니다. 이 모델은 종합 점수 84.4점을 기록했으며, 28개의 핵심 역할극 응답 중 28개 모두에서 단어 제한을 준수했고, 빌런(Villain) 카테고리에서 공동 1위를 차지했습니다. 입력 100만 토큰당 $0.24, 출력 100만 토큰당 $0.96의 요금으로, 100회 응답 기준 약 $0.24의 비용이 발생합니다.
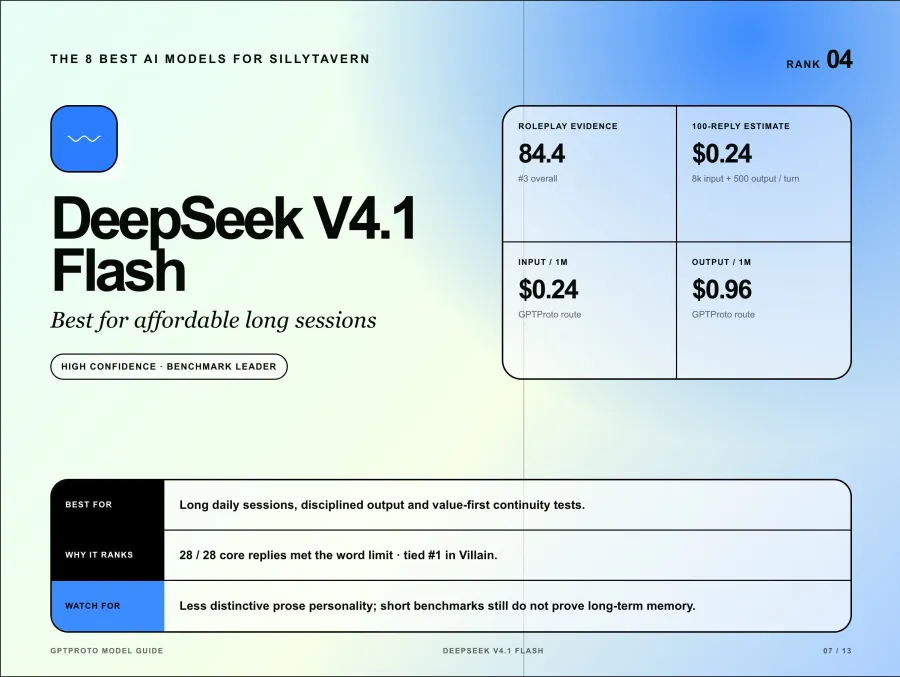
이 모델은 Kimi, Argon, Opus에 비해 문체 면에서 개성이 덜 뚜렷합니다. 하지만 캐릭터 카드에 이미 강력한 말투가 설정되어 있다면, 모델 고유의 문체로 덮어씌울 가능성이 낮아 오히려 장점이 될 수 있습니다. 또한 매일 긴 대화를 나누면서 중요한 장면에서만 더 비싼 모델을 사용하고 싶을 때 유용합니다.
SillyTavern에서 deepseek-flash를 사용해 보세요. 장기 대화 세션을 위한 첫 번째 가성비 테스트 모델로 가장 적합하다고 판단되지만, 벤치마크는 짧은 시나리오를 기준으로 진행되었습니다. 저렴한 가격이 곧 장기 기억력을 보장한다고 단정하기 전에, 직접 30~50턴 정도의 연속성 테스트를 수행해 보는 것이 좋습니다.
5 GLM 5.3 Flash: 최고의 가성비 게임 마스터
GLM-5.3 Flash는 저예산 특화 모델입니다. 9월 벤치마크에서 게임 마스터 부문 89.2점 및 엄격한 말투(Strict Voice) 부문 98.3점을 기록하며 단일 카테고리 최고 점수를 달성했습니다. 입력 100만 토큰당 $0.1275, 출력 100만 토큰당 $0.425의 요금으로, 100회 응답 기준 약 $0.12의 비용이 발생합니다.
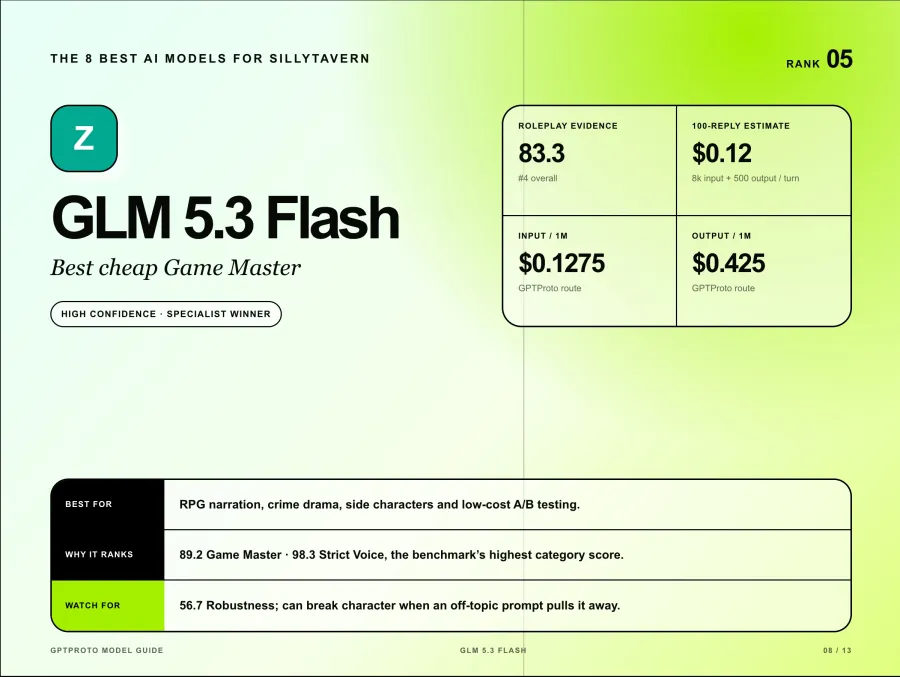
이 모델의 단점 또한 중요합니다. GLM-5.3 Flash는 일반적인 어시스턴트처럼 주제를 벗어난 질문에 답하기 위해 캐릭터 설정을 깨뜨리는 바람에 견고성(Robustness) 부문에서 56.7점을 기록하는 데 그쳤습니다. 또한 다른 상위 모델들에 비해 핵심 역할극의 단어 제한을 더 많이 어겼습니다.
RPG 내레이션, 범죄 드라마, 조연 캐릭터 연기 또는 저렴한 A/B 테스트용으로 선택하세요. 가격이 저렴하다고 해서 최고의 동료 모델이라고 단정해서는 안 됩니다. SillyTavern에서 사용할 때는 캐릭터 규칙을 프롬프트 끝부분에 배치하고, 장기 대화를 시작하기 전에 의도적으로 대화 흐름을 방해하는 테스트를 먼저 수행해 보세요. 모델 ID는 glm-5.3-flash입니다.
6 Gemini 3.8 Flash: 최고의 일상용 고속 모델
Gemini 3.8 Flash는 단순히 언급하고 넘어가는 수준을 넘어 이 목록에 포함될 자격이 충분합니다. 최근 진행된 커뮤니티 롤플레잉 벤치마크에서는 8개 챕터에 걸쳐 모델당 최대 64개의 응답을 테스트했으며, Gemini 3.8 Flash는 91.9점의 품질 점수를 기록했습니다. 해당 테스트는 작문 선호도에 75%, 견고성에 25%의 가중치를 두었습니다. 이는 유용한 증거가 되지만, 프롬프트와 채점 방식이 다르기 때문에 AI Roleplay Bench의 점수와 직접 비교할 수는 없습니다.
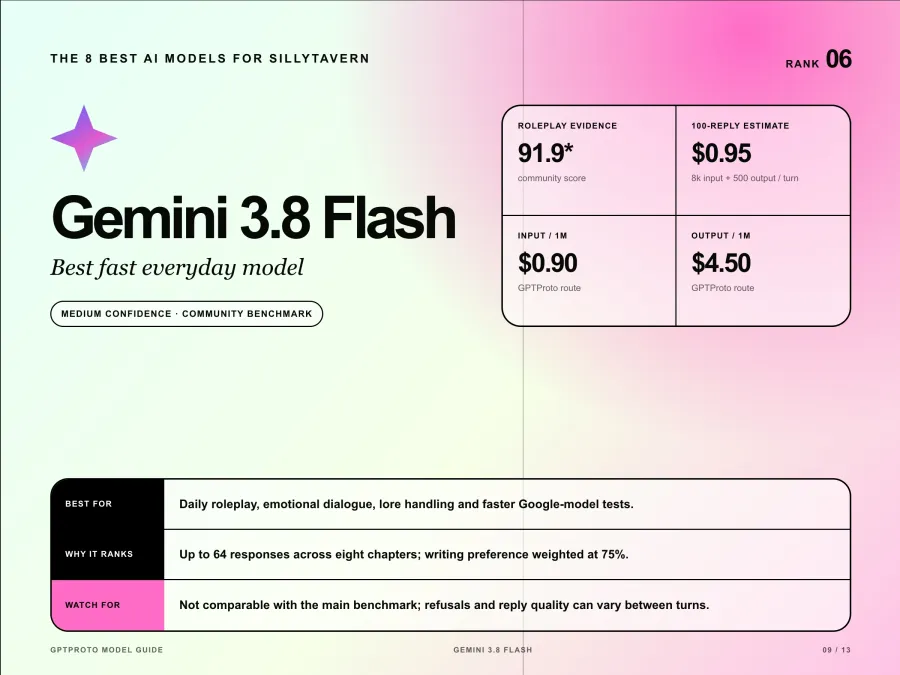
커뮤니티 보고서들은 이 모델의 감정적인 대화, 세계관 처리, 대화의 리듬을 높게 평가합니다. 다만 일관성 면에서는 다소 아쉬움이 있는데, 일부 사용자는 인접한 턴에서는 잘 작동하다가도 갑자기 거부 반응을 보이거나 답변이 고르지 못하다는 보고를 하기도 합니다.
gemini-3.8-flash를 사용하고 중간 정도의 사고(thinking) 수준으로 시작해 보세요. 입력 100만 토큰당 $0.90, 출력 100만 토큰당 $4.50의 요금은 Argon보다 훨씬 저렴하며, 고정된 100회 응답 예시의 경우 약 $0.95의 비용이 듭니다. 매일 사용할 Google 모델이 필요하지만 모든 턴에서 Argon 수준의 프리미엄 추론이 필요하지는 않을 때 선택하세요.
7 Claude Opus 5.5: 최고의 프리미엄 산문 모델
Claude Opus 5.5는 만능 승자가 아니라 프리미엄 산문을 위한 선택지입니다. 이 모델을 선호하는 사용자들은 공간 인식 능력, 세계관 지식, 페이싱, 그리고 배경을 생동감 있게 만드는 능력을 꼽습니다. 상세한 SillyTavern 커뮤니티 보고서는 일반적인 스토리 롤플레잉에는 이 모델을 추천하되, 장면마다 다른 콘텐츠 처리가 필요할 때는 모델을 전환할 것을 권장합니다.
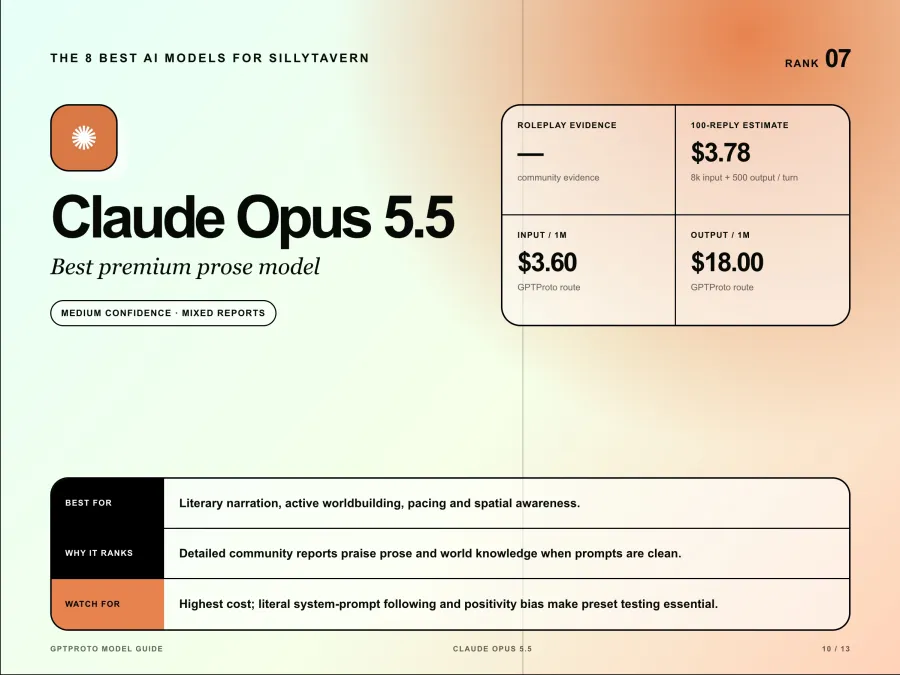
다른 사용자들은 Opus가 대규모 시스템 프롬프트를 너무 문자 그대로 따르기 때문에, 캐릭터 카드나 프리셋 내의 상충하는 지침이 캐릭터를 왜곡할 수 있다고 보고합니다. 긍정 편향(Positivity bias) 또한 반복적으로 제기되는 불만 사항입니다. 이러한 호불호가 갈리는 점 때문에 정확한 캐릭터 카드를 테스트해 보지 않고는 이 모델을 벤치마크 상위 모델보다 높게 평가하기 어렵습니다.
가격이 가장 큰 단점입니다. 입력 100만 토큰당 $3.60, 출력 100만 토큰당 $18이며, 고정된 100회 응답 예시 기준 약 $3.78가 소요됩니다. claude-opus-5-5를 사용할 때는 깔끔한 프롬프트로 시작하고, 설명할 수 없는 상속된 프리셋 규칙은 제거하세요. Opus는 문학적 서사를 위해 테스트해 볼 가치가 있습니다. 하지만 캐주얼한 대량 채팅용으로 사용하기에는 비용을 정당화하기 어렵습니다.
8 GPT 6 Luna 최고의 초저가 GPT 모델
GPT-6 Luna는 최고의 전체 롤플레잉 모델은 아닐지라도, SillyTavern 가이드에서 GPT가 빠져서는 안 되는 이유를 보여줍니다. Luna는 종합 점수 71.1점을 기록하여 4대 벤치마크 선두 모델보다 훨씬 낮았으며, 컴패니언(Companion) 부문 68.3점, 엄격한 음성(Strict Voice) 부문 60.0점, 견고성(Robustness) 부문 54.2점을 기록했습니다. 지나치게 신중한 태도로 인해 반복적으로 픽션의 흐름이 끊기기도 했습니다.
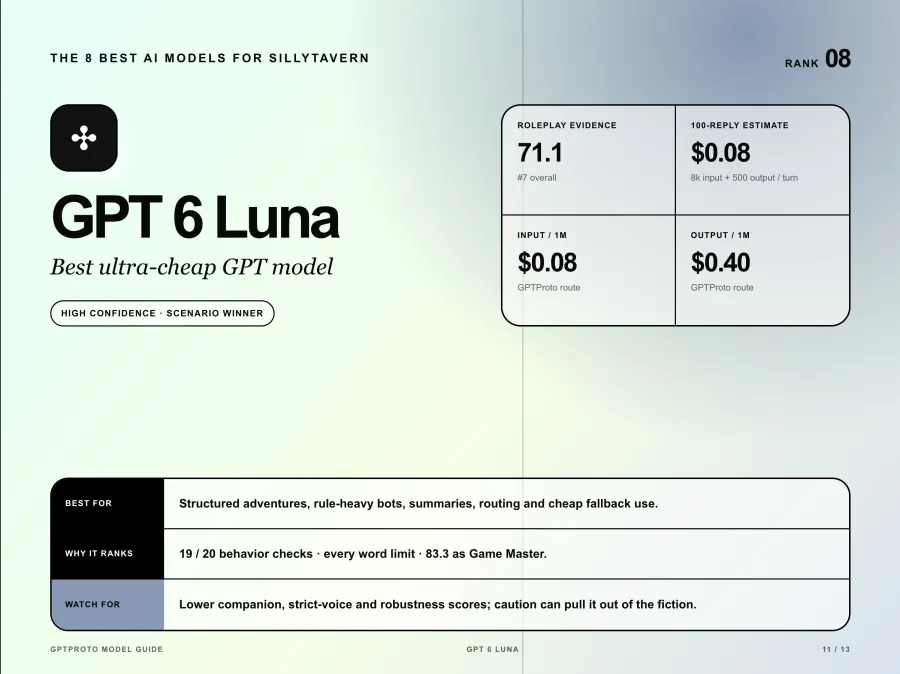
결과의 나머지 절반은 유용합니다. GPT-6 Luna는 20개의 행동 검사 중 19개를 통과했고, 테스트된 모든 단어 제한을 준수했으며, 게임 마스터 부문에서 83.3점을 기록했습니다. 백만 토큰당 입력 $0.08, 출력 $0.40의 비용으로, 고정된 100회 응답 예시의 비용은 약 8센트입니다.
구조화된 모험, 규칙이 많은 봇, 요약, 라우팅 또는 저렴한 대체 모델이 필요할 때 gpt-6-luna를 사용하세요. 감정적 몰입이 주된 목표라면 Kimi, GLM 또는 Gemini를 선택하는 것이 좋습니다. 이 모델은 시나리오에 특화된 승자이지, 벤치마크 7위 모델이 전체 최고라는 위장된 주장이 아닙니다.
GPT, Claude, Gemini 모델이 더 많지 않은 이유
유용한 순위라면 각 제공업체에 동일한 공간을 할애해서는 안 됩니다. 추가되는 각 모델은 강력한 롤플레잉 증거를 갖추거나 명확하게 다른 작업 목적이 있어야 합니다.
| 모델 제품군 |
메인 리스트 선택 |
테스트해 볼 가치가 있는 다른 모델 |
대안 모델이 별도로 순위에 오르지 않은 이유 |
| GPT |
GPT-6 Luna |
GPT-6.1 Terra ($0.80 / $4.00) |
Terra는 매력적인 가격과 일반적인 작문 능력을 갖추고 있지만, 아직 비교할 만한 롤플레잉 벤치마크 결과가 없습니다. |
| Claude |
Claude Opus 5.5 |
Claude Sonnet 5.5 ($1.80 / $9.00) |
더 저렴한 Claude 옵션이지만, 현재 RP 전용 증거가 부족하여 별도의 승자로 선정하기 어렵습니다. |
| Claude |
Claude Opus 5.5 |
Claude Haiku 5.5 ($0.09 / $0.45) |
Haiku는 대용량 경량 작업에 최적화되어 있습니다. 낮은 가격만으로는 강력한 문장력이나 긴 세션에서의 일관성을 입증할 수 없습니다. |
| Gemini |
Gemini 4 Argon 및 3.8 Flash |
Gemini Flash Lite 변형 |
더 저렴한 Lite 모델은 동일한 RP 관련 커뮤니티 증거가 부족합니다. |
| Kimi |
Kimi K3 |
Kimi K3.1 Pro ($2.00 / $10.00) |
더 새롭고 유망하지만, 전문가 벤치마크에서 K3를 대체하지는 못했습니다. |
이것이 바로 GPT-6 Luna가 순위에서 사라지지 않고 8위를 차지한 이유입니다. 특정 작업에 대한 증거가 있기 때문입니다. 나중에 Terra가 이를 앞지를 수도 있지만, 지금 그런 주장을 하는 것은 일반적인 성능과 테스트된 롤플레잉 성능을 혼동하게 만들 수 있습니다.
VRAM 기준 SillyTavern을 위한 최고의 로컬 모델
SillyTavern을 로컬에서 실행한다고 해서 언어 모델까지 로컬인 것은 아닙니다. 프론트엔드 자체는 요구 사양이 낮지만, 로컬 추론을 위해서는 모델 가중치와 컨텍스트 캐시를 담을 충분한 GPU 메모리가 필요합니다. 공식 SillyTavern 개요에서는 로컬 추론을 시작하기 위한 최소 사양으로 6GB 이상의 VRAM을 권장합니다.
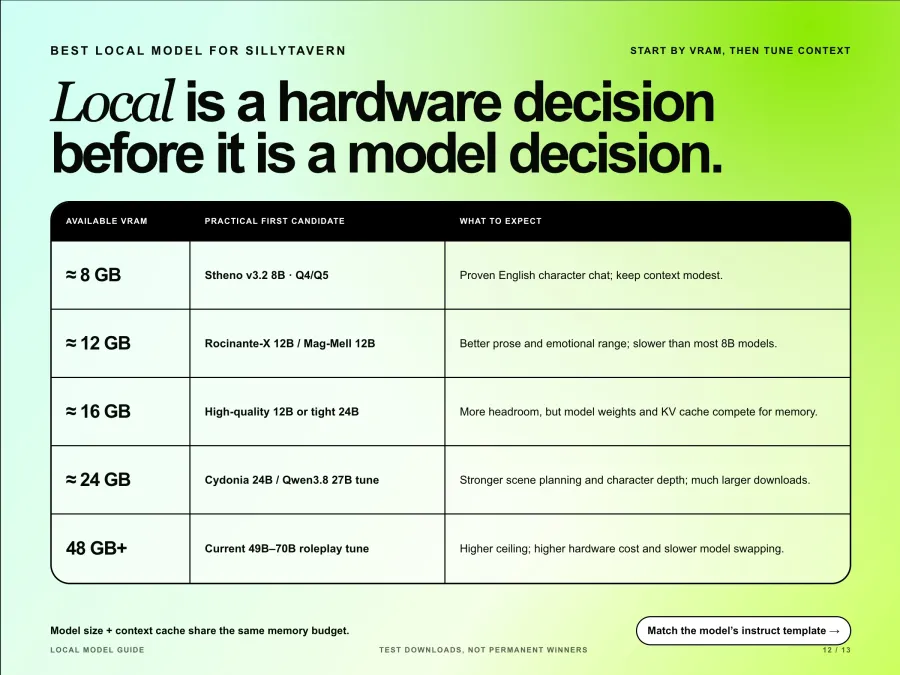
로컬 모델 권장 사항은 빠르게 변하므로, 이를 영구적인 정답이라기보다는 테스트해 볼 첫 번째 다운로드 대상으로 여기는 것이 좋습니다. 현재 Hugging Face 역할극 모델 디렉토리에는 매우 다양한 템플릿과 양자화 방식을 가진 수천 개의 커뮤니티 변형 모델이 존재합니다.
| 사용 가능한 VRAM |
실용적인 첫 번째 후보 |
기대 효과 |
| 약 8 GB |
Stheno v3.2 8B (Q4 또는 Q5) |
영어 캐릭터 채팅을 위한 검증된 입문용 모델이지만, 컨텍스트는 적절하게 유지해야 합니다. |
| 약 12 GB |
Rocinante-X 12B 또는 Mag-Mell 12B |
대부분의 8B 모델보다 뛰어난 문장력과 감정 표현 범위를 제공하지만, 생성 속도는 더 느립니다. |
| 약 16 GB |
더 높은 품질의 12B 양자화 모델, 또는 짧은 컨텍스트와 부분 오프로드를 사용하는 24B 모델 |
품질 면에서 더 여유가 있지만, 모델 파일이 VRAM에 들어간다고 해서 큰 KV 캐시까지 들어간다는 보장은 없습니다. |
| 약 24 GB |
Cydonia 24B 또는 Qwen3.8 27B 역할극 튜닝 모델 |
더 나은 장면 구성과 캐릭터 깊이를 제공하지만, 다운로드 용량이 훨씬 큽니다. |
| 48 GB 이상 |
최신 49B~70B 역할극 튜닝 모델 |
더 높은 성능을 기대할 수 있지만, 하드웨어 비용이 많이 들고 모델 교체 속도가 훨씬 느립니다. |
8GB 카드 사용 시 핵심적인 절충안은 간단합니다. 모델 크기와 컨텍스트가 동일한 메모리를 두고 경쟁합니다. 작은 컨텍스트로 시작하여 캐릭터의 말투를 확인한 다음, VRAM과 생성 속도를 주시하며 제한을 높이세요.
로컬 텍스트 완성(Text Completion) 백엔드의 경우, 해당 모델의 실제 지시(Instruct) 템플릿을 선택하세요. SillyTavern의 Instruct 모드 문서에서는 선택한 템플릿이 모델이 예상하는 형식과 일치해야 한다고 경고합니다. 올바르게 설정되지 않은 템플릿을 사용하면 성능이 뛰어난 파인튜닝 모델이라도 제대로 설정된 작은 모델보다 결과가 나쁠 수 있습니다.
장기 롤플레잉을 위한 최고의 모델
Kimi K3는 장기적인 캐릭터 연속성을 위해 증거 기반으로 가장 강력하게 추천되는 모델이며, 대화 기록이 길어져 비용이 부담될 때는 DeepSeek V4.1 Flash가 더 경제적인 선택입니다. Gemini 4 Argon은 방대한 로어북(lorebook)에 매력적이지만, 100만 토큰의 컨텍스트 윈도우가 곧 신뢰할 수 있는 기억력을 의미하는 것은 아님을 유의해야 합니다.
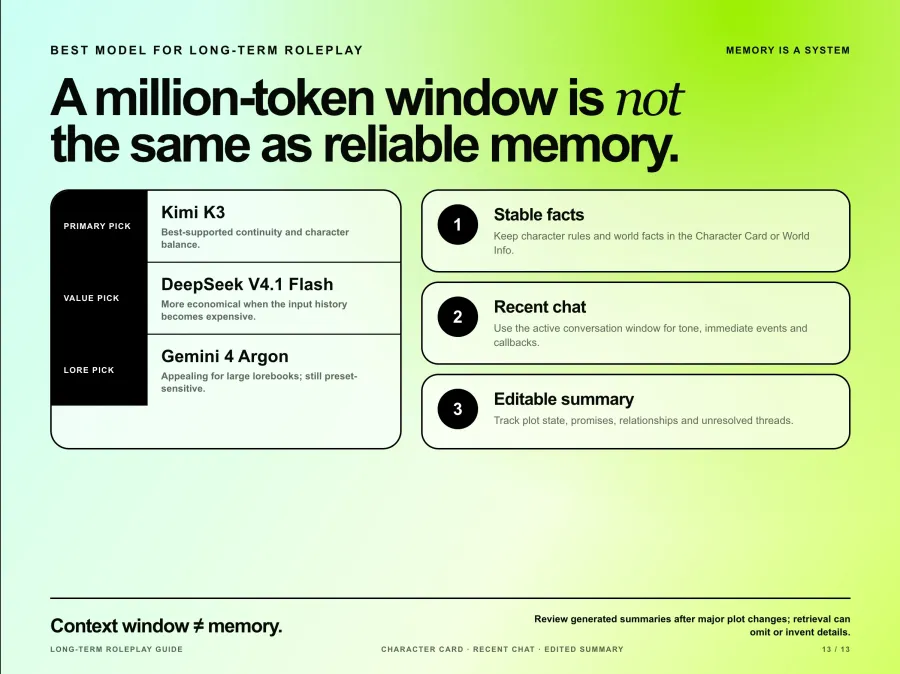
SillyTavern의 컨텍스트 문서에 따르면, 활성 컨텍스트 범위 내의 메시지만 모델로 전송됩니다. 캐릭터 정보, 시스템 프롬프트, 월드 인포(World Info), 요약, 응답 공간 모두 동일한 예산을 소비합니다. 오래된 메시지가 이 범위를 벗어나면, 관련 사실을 다시 주입하지 않는 한 모델은 이를 기억할 수 없습니다.
컨텍스트 크기에만 의존하지 말고 다음 세 가지 계층을 활용하세요:
변하지 않는 캐릭터 사실과 세계관 규칙은 캐릭터 카드나 월드 인포에 보관하세요.
최근 대화 기록은 어조와 즉각적인 사건을 위해 사용하세요.
플롯 상태, 관계, 약속, 해결되지 않은 실타래를 위해 짧고 수정 가능한 요약을 유지하세요.
요약(Summarize) 확장 기능은 세 번째 계층을 자동화할 수 있지만, 해당 문서에서도 모델이 생성한 요약이 세부 정보를 누락하거나 지어낼 수 있다고 경고합니다. 주요 플롯 변경 후에는 요약을 검토하세요. 채팅 벡터화(Chat Vectorization)는 실험적인 기능이며 검색 효율을 떨어뜨릴 수 있으므로, 무조건 활성화하기보다는 테스트를 거쳐야 합니다.
SillyTavern에서 모델을 전환하는 방법
모델을 전환해도 채팅이 삭제되지는 않지만, 목소리, 서식, 거부 반응, 이전 메시지 해석 방식이 달라질 수 있습니다. GPT, Claude, Gemini, 로컬 텍스트 완성 모델 전체에 하나의 프리셋을 강제로 적용하지 말고, 각 모델 제품군별로 별도의 프리셋을 저장하세요.
GPT Proto의 간단한 설정 방법은 다음과 같습니다:
SillyTavern에서 API Connections를 엽니다.
Chat Completion 및 Custom OpenAI compatible을 선택합니다.
Base URL을 https://gptproto.com/v1(으)로 설정합니다. /chat/completions를 뒤에 붙이지 마세요. SillyTavern이 자동으로 추가합니다.
API 키를 붙여넣고 kimi-k3, glm-5.3-flash, 또는 gemini-3.8-flash와 같은 정확한 모델 ID를 입력합니다.
Prompt Post-Processing을 None으로 설정한 상태에서 시작하여 연결한 후, Test Message를 실행합니다.
이미지가 포함된 SillyTavern API 통합 가이드에서 설치, 캐릭터 카드, 스크린샷 및 일반적인 연결 오류 해결 방법을 확인할 수 있습니다.
SillyTavern 외부에서 동일한 키와 모델을 확인하려면, 다음 요청을 통해 동일한 OpenAI 호환 경로를 사용할 수 있습니다:
export GPTPROTO_API_KEY="YOUR_KEY"

curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3",
    "messages": [
      {"role": "user", "content": "Reply in character with one short sentence."}
    ],
    "max_tokens": 120
  }'
전환 후에는 동일한 캐릭터 카드로 최소 5번의 대화를 테스트하세요. 짧은 답변 하나, 주제를 벗어난 프롬프트 하나, 답변 길이에 대한 지시 사항 하나, 그리고 이전 세부 사항에 대한 언급 하나를 포함하세요. 이것이 첫 메시지만 보고 판단하는 것보다 훨씬 더 많은 문제를 잡아낼 수 있습니다.
어떤 SillyTavern 모델을 선택해야 할까요
검증된 기본 모델을 원하신다면 Kimi K3를 선택하세요.
복잡한 세계관 설정과 몰입감 있는 장면 전개가 필요하다면 Gemini 4 Argon을 선택하세요. 단, 더 높은 비용과 낮은 벤치마크 신뢰도를 감수해야 합니다.
합리적인 가격대에 뛰어난 스토리텔링 능력을 원하신다면 GLM-5.3을 선택하세요.
긴 세션을 저렴하게 이용하고 절제된 출력을 원하신다면 DeepSeek V4.1 Flash를 선택하세요.
예산 내에서 RPG 서사를 즐기고 캐릭터의 말투를 엄격하게 유지하고 싶다면 GLM-5.3 Flash를 선택하세요.
커뮤니티에서 검증된 더 빠르고 저렴한 Gemini를 원하신다면 Gemini 3.8 Flash를 선택하세요.
비용을 지불할 가치가 있을 만큼 뛰어난 문장 품질이 중요하다면 Claude Opus 5.5를 선택하세요.
가장 저렴한 구조화된 RP, 요약 또는 대체용 모델이 필요하다면 GPT-6 Luna를 선택하세요.
설정 시간이나 클라우드 모델의 품질보다 개인정보 보호, 오프라인 사용, 무제한 생성이 더 중요하다면 로컬 롤플레잉 파인튜닝 모델을 선택하세요.
현재 사용 신호와 모델 가격은 GPT Proto SillyTavern 모델 페이지에서 비교할 수 있으며, 롤플레잉 API 플레이그라운드를 통해 동일한 캐릭터와 대화 기록으로 여러 모델을 테스트해 볼 수 있습니다.