오늘 GPT 6.1 Terra와 Sonnet 5.5 사이에서 고민 중이시라면, 벤치마크를 실행하기 전에 제가 사용하는 간단한 결정 규칙을 알려드리겠습니다:
대규모 스크린샷 검사, 양식 및 송장 자동화, UI 레이아웃 디버깅, 또는 0.80달러/4.00달러의 토큰 요금과 3배 빠른 작업 실행 속도가 최고의 자율 리팩토링 깊이보다 중요하고, 단일 요청 입력값이 272K 토큰 이하인 제한된 코딩 작업을 수행하는 파이프라인이라면 GPT-6.1 Terra를 선택하세요.
에이전트가 다중 파일 저장소 마이그레이션을 수행하거나, 편집 실수 한 번이 토큰 비용보다 더 큰 손실을 초래하는 심층 터미널 디버깅을 진행하거나, OpenAI의 긴 컨텍스트 추가 요금으로 인해 Terra의 입력 가격 이점이 사라지는 300K에서 900K 토큰 사이의 단일 패스 프롬프트를 사용하는 경우라면 Claude Sonnet 5.5를 고수하세요.
어느 쪽을 선택할지 결정하기 전에 GPT Proto 모델 비교 허브에서 실시간 카탈로그 요금을 확인하거나 귀하의 월간 토큰 사용량을 직접 계산해 볼 수 있습니다. 아래의 모든 내용은 2026년 11월 5일 기준으로 검증된 문서 및 벤치마크 기반 비교 자료이며, 벤더가 보고한 벤치마크는 Artificial Analysis의 독립적인 측정 결과 및 초기 개발자 피드백과 별도로 표기되었습니다.
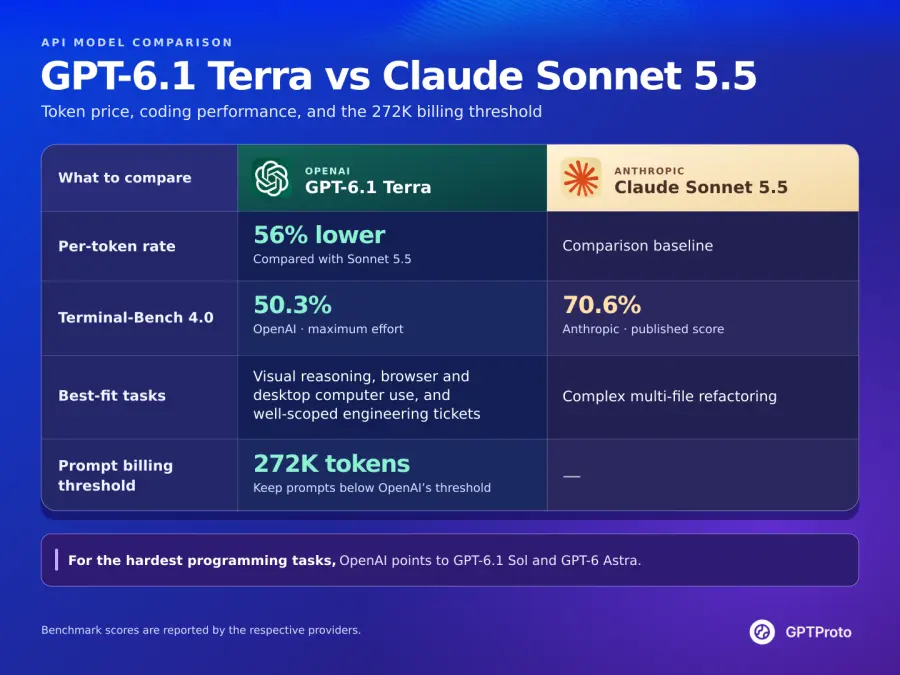
GPT-6.1 Terra 대 Claude Sonnet 5.5 한눈에 비교하기
ChatGPT 6.1 Terra 대 Sonnet 5.5 또는 Anthropic Claude Sonnet 5.5 대 GPT 6.1 Terra를 검색하는 개발자들은 두 공급업체가 추론 제어, 도구 엔드포인트, 긴 컨텍스트 추가 요금을 다르게 구성하기 때문에 종종 상충하는 사양 시트를 접하게 됩니다. 아래 표는 두 모델을 OpenAI의 공식 gpt-6.1-terra 문서, Anthropic의 Claude Sonnet 5.5 개요 및 실시간 GPT Proto 카탈로그 요금과 비교한 것입니다.
| 사양 |
GPT-6.1 Terra (gpt-6.1-terra) |
Claude Sonnet 5.5 (claude-sonnet-5-5) |
| 제공업체 |
OpenAI |
Anthropic |
| 출시일 |
2026년 10월 26일 |
2026년 9월 28일 |
| 공식 표준 입력 / 출력 (100만 토큰당) |
$1.00 / $5.00 |
$2.00 / $10.00 |
| GPT Proto 입력 / 출력 (100만 토큰당) |
$0.80 / $4.00 (공식 대비 -20%) |
$1.80 / $9.00 (공식 대비 -10%) |
| 공식 캐시 입력 읽기 (100만 토큰당) |
$0.05 (기본 입력의 5%) |
$0.10 (2026년 10월 7일 $0.20에서 인하) |
| 공식 캐시 쓰기 (100만 토큰당) |
$1.25 (30분 TTL) / $2.50 (12시간 TTL) |
$2.50 (5분 TTL) |
| GPT Proto 캐시 읽기 / 쓰기 (100만 토큰당) |
$0.04 / $1.00 |
$0.09 / $2.25 (실시간 모델 페이지 확인) |
| 컨텍스트 윈도우 |
1,050,000 토큰 |
1,000,000 토큰 |
| 긴 컨텍스트 가격 정책 |
272K 초과 입력 시 전체 요청에 대해 입력/캐시 2배, 출력 1.5배 청구 |
전체 100만 컨텍스트 윈도우에 걸쳐 단일 요금 적용 |
| 최대 출력 토큰 |
128,000 토큰 |
128,000 토큰 |
| 입력 / 출력 모달리티 |
텍스트, 이미지, 문서 입력 → 텍스트 출력 |
텍스트, 이미지, 문서 입력 → 텍스트 출력 |
| 지식 컷오프 |
2026년 6월 1일 |
2026년 초중반 (Sonnet 5 토크나이저 유지) |
| 추론 / 노력 제어 |
none, low, medium (기본값), high, xhigh, max |
적응형 사고 기본 활성화; medium, high (API 기본값), max, between_tools |
| 도구 호출을 위한 필수 엔드포인트 |
/v1/responses OpenAI 문서에서 요구 |
/v1/messages (네이티브) 또는 OpenAI 호환 /v1/chat/completions |
| 클라이언트 및 IDE 가용성 |
ChatGPT Work & Codex (일반 채팅 아님), GitHub Copilot, Claude Code (API 경유) |
Claude.ai, Claude Code, GitHub Copilot, Cursor |
| AA 인텔리전스 지수 (v4.3.2) |
41 (medium) / 48 (max) |
56 (max, 기본 폴백) |
| AA 평균 평가 작업 비용 |
$0.10 (`medium`) / $0.40 (max) |
$5.46 (max, 기본 폴백) |
| Terminal-Bench 4.0 (공급업체 보고) |
50.3% (max 노력) |
70.6% |
애플리케이션 예산을 책정할 때 이 표의 세 행이 거의 모든 역할을 합니다. 첫째, 272K 토큰 미만의 표준 요청에서 GPT-6.1 Terra는 GPT Proto에서 입력 및 출력 모두 토큰당 56% 더 저렴하므로 긴 완료 작업이 비용 순위를 뒤집지 않습니다. 둘째, Sonnet 5.5는 Terminal-Bench 4.0에서 20.3% 포인트 앞서 있으며, 이는 두 모델이 가이드 없는 저장소 편집에서 어떻게 작동하는지와 밀접하게 연관됩니다. 셋째, GPT-6.1 Sol과 달리 GPT-6.1 Terra는 reasoning.effort: "none"에 대한 지원을 복원하여 OpenAI 개발자들에게 다시 진정한 비추론 고속 경로를 제공합니다.
가격 및 비용 분석: 무엇이 더 비싸고 무엇이 더 경제적인가?
개발자들이 "GPT 6.1 Terra와 Sonnet 5.5 중 무엇이 더 비싼가" 또는 "무엇이 더 경제적인가"를 검색할 때, 보통 가격 페이지에 명시된 백만 토큰당 요금과 실제 에이전트 작업 완료 시 발생하는 달러 비용이라는 두 가지 다른 수치를 조율하려는 경우가 많습니다. 이 두 비율은 동일하지 않습니다.
토큰 단위로 보면 Claude Sonnet 5.5가 훨씬 더 비싼 모델입니다. Anthropic의 공식 가격은 입력 토큰 백만 개당 2.00달러, 출력 토큰 백만 개당 10.00달러로, Terra의 정가인 1.00달러/5.00달러보다 두 배 높습니다. GPT Proto는 GPT-6.1 Terra에 20% 할인(입력 0.80달러 / 출력 4.00달러), Claude Sonnet 5.5에 10% 할인(입력 1.80달러 / 출력 9.00달러)을 적용하므로, 플랫폼상에서 Sonnet 5.5는 토큰당 2.25배 더 비쌉니다. 두 공급업체 모두 현재 캐시된 입력 읽기 비용을 기본 입력 가격의 5%로 책정하고 있으며(Terra 공식 0.05달러 vs 2026년 10월 Anthropic이 Sonnet의 캐시 읽기 가격을 절반으로 인하한 후 Sonnet 5.5 공식 0.10달러), 표준 캐시 쓰기 비용은 기본 입력의 1.25배(공식 1.25달러 vs 2.50달러)입니다. 참고로, 캐시에 기록된 일회성 긴 프롬프트는 해당 접두사를 다시 읽지 않을 경우 두 모델 모두에서 25%의 추가 요금이 발생합니다.
작업 단위로 넘어가면 격차는 훨씬 더 커집니다. Artificial Analysis의 Intelligence Index v4.3.2(2026년 10월 26~27일 발행)에서 테스트된 Claude Sonnet 5.5 구성(max 노력 및 기본 폴백)은 평가 작업당 가중 평균 비용 5.46달러를 기록했습니다. 동일한 평가 제품군에서 [GPT-6.1 Terra at `max` effort](https://artificialanalysis.ai/models/gpt-6-1-terra)는 작업당 평균 0.40달러, GPT-6.1 Terra at medium effort는 작업당 평균 0.10달러에 불과했습니다. 이는 max 노력 설정 시 13.6배, Sonnet의 최고 설정과 Terra의 기본 medium 설정을 비교하면 54.6배의 차이가 납니다.
왜 토큰당 2배의 차이가 13배에서 54배의 청구액 차이로 이어질까요? 추론 모델은 사고 토큰을 출력 토큰으로 청구하기 때문입니다. Sonnet 5.5가 개방형 벤치마크에서 높음 또는 최대 노력으로 실행되면 백만 토큰당 10.00달러(GPT Proto에서는 9.00달러)의 비용으로 긴 추론 체인을 생성합니다. Terra의 발표에 따르면 Agents' Last Exam에서 최대 노력으로 실행했을 때 Terra는 Claude Opus 5.5보다 3분의 1 미만의 토큰을 사용했습니다. 더 중요한 것은 Artificial Analysis의 파레토 최적(Pareto-frontier) 발견입니다. GPT-6.1 Terra의 경우 low 및 medium 노력 설정이 지능 대비 비용 측면에서 파레토 최적입니다. Terra를 max로 올리면 점수가 41에서 48로 상승하는데, 이는 GPT-6.1 Sol at medium effort와 동점입니다. 하지만 Sol medium은 작업당 0.21달러인 반면 Terra `max`는 0.40달러입니다. 요약하자면, Terra에서 가장 경제적인 설정을 원한다면 low 또는 medium로 유지하십시오. 만약 작업이 max 노력을 요구할 만큼 어렵다면, 이미 Sol이나 Sonnet 5.5를 테스트하고 있어야 합니다.
실제 운영 시나리오를 통한 비용 계산
더 저렴한 토큰 요금이 실제로 어디에서 이득이 되고 어디에서 손해가 되는지 확인하기 위해, GPT Proto의 실시간 카탈로그 요금(Terra: $0.80/$4.00, Sonnet 5.5: $1.80/$9.00)을 기준으로 272K 토큰 미만의 캐시되지 않은 요청을 가정하여 정확한 산술 계산을 수행해 보겠습니다.
시나리오 A는 20단계의 시각적 QA 및 양식 추출 에이전트 루프입니다. 각 단계는 스크린샷과 DOM 스니펫을 포함하여 총 15,000개의 입력 토큰을 전송하고 1,500개의 출력 토큰(중간 추론 토큰 포함)을 생성합니다. 20단계에 걸쳐 단일 워크플로우는 300,000개의 입력 토큰(0.3M)과 30,000개의 출력 토큰(0.03M)을 소비합니다:
월 10,000건의 워크플로우를 처리할 경우, Terra 비용은 $3,600로 Sonnet의 $8,100 대비 월 $4,500를 절감할 수 있습니다. Terra가 실행의 20%에서 검증에 실패하여 해당 2,000건의 워크플로우를 처음부터 다시 시도해야 하더라도($720 추가), 총 비용은 $4,320가 되어 재시도 없이 Sonnet을 실행하는 것보다 여전히 월 $3,780를 절약하게 됩니다.
시나리오 B는 활성 풀 리퀘스트에서의 다중 파일 백엔드 리팩토링입니다. 각 시도가 80,000개의 입력 토큰을 읽고 10,000개의 출력 토큰을 생성한다고 가정해 봅시다. Sonnet 5.5에서의 1회 클린 패스 비용은 (0.08 * $1.80) + (0.01 * $9.00) = $0.234입니다. Terra에서의 1회 패스 비용은 (0.08 * $0.80) + (0.01 * $4.00) = $0.104입니다. API 호출에서 13센트를 절약하는 셈입니다. 문제는 Terra가 모듈 간 타입 의존성을 놓칠 경우(Terminal-Bench에서의 50.3% 대 70.6% 격차와 일치함) 3회의 재시도와 함께 시니어 엔지니어의 시간 12분($90/시간 기준, $18.00의 인건비)이 소요된다면, 13센트의 토큰 절감이 팀에게는 $18.18의 비용을 발생시킨다는 점입니다. 한 문장으로 요약하자면, Terra는 반복 가능하고 기계적으로 검증 가능한 루프에서 압도적으로 유리하며, Sonnet 5.5는 실패한 편집으로 인해 사람의 검토 시간이 낭비될 때마다 더 높은 요금을 지불할 가치를 증명합니다.
윈도우 컨텍스트(1.05M vs 1M): 272K를 넘기면 비용이 달라지는 이유
표면적으로 GPT 6.1 Terra와 Sonnet 5.5의 윈도우 컨텍스트 비교는 OpenAI가 근소하게 앞서는 박빙의 승부처럼 보입니다. Terra는 1,050,000개의 입력 토큰을 수용하고 최대 128,000개의 출력 토큰을 생성하는 반면, Claude Sonnet 5.5는 1,000,000개의 입력 토큰을 수용하고 최대 128,000개의 출력 토큰을 생성합니다. 대부분의 비교표는 여기서 멈춥니다.
하지만 OpenAI의 gpt-6.1-terra 모델 문서를 읽어보면, 272,000개의 입력 토큰 지점에 과금 경계가 있어 긴 컨텍스트의 경제성을 완전히 뒤바꿔 놓습니다. GPT-6.1 Terra에서 프롬프트가 272K 입력 토큰을 초과할 때마다, OpenAI는 전체 요청에 대해(272K를 초과하는 토큰뿐만 아니라) 입력 및 캐시 요금의 2배, 출력 요금의 1.5배를 청구합니다.
프롬프트가 272,000 토큰에서 272,001 토큰으로 넘어가는 순간, 공식 백만 토큰당 요금제에 어떤 변화가 생기는지 확인해 보세요:
| 컨텍스트 구간 |
GPT-6.1 Terra (공식 요금) |
Claude Sonnet 5.5 (공식 요금) |
입력 가격 관계 |
| 표준 프롬프트 (≤272K 입력 토큰) |
입력 $1.00 / 출력 $5.00 / 캐시 읽기 $0.05 |
입력 $2.00 / 출력 $10.00 / 캐시 읽기 $0.10 |
Terra가 입력 및 출력 비용 50% 저렴 |
| 긴 컨텍스트 프롬프트 (>272K ~ 1M+ 입력 토큰) |
입력 $2.00 / 출력 $7.50 / 캐시 읽기 $0.10 |
입력 $2.00 / 출력 $10.00 / 캐시 읽기 $0.10 |
입력 및 캐시 읽기 요금 동일 ($2.00 / $0.10) |
Anthropic의 소형 모델인 Haiku 5.5(100K 토큰 초과 시 5배 할증 적용)와 달리, Claude Sonnet 5.5는 1,000,000 토큰 컨텍스트 윈도우 전체에 걸쳐 고정 요금을 유지합니다.
공식 정가 기준으로 10,000개의 출력 토큰을 생성하는 400,000 토큰 리포지토리 감사 작업에 대해 계산해 보겠습니다:
프롬프트가 272K 토큰을 넘어서는 순간, Terra의 50% 입력 할인 혜택은 완전히 사라지며 400K 토큰 호출 시 총 $0.025의 차이만 남게 됩니다. 제 권장 사항은 간단합니다. 반값 경제성을 기대하며 272K 토큰이 넘는 거대한 프롬프트를 GPT-6.1 Terra로 보내지 마십시오. 컨텍스트를 272K 토큰 미만으로 분할/검색하여 Terra가 $1.00($0.80 GPT Proto) 구간에 머물게 하거나, 300K~900K 규모의 리포지토리 덤프는 Claude Sonnet 5.5로 직접 라우팅하십시오. 동일한 공식 입력 요금을 지불하면서 더 강력한 장기 코드 이해력을 얻을 수 있습니다. (GPT Proto를 통해 272K가 넘는 프롬프트를 프로덕션 환경에서 실행하기 전에, 상위 272K 계층 조정이 귀하의 계정 잔액에 어떻게 반영되는지 플랫폼 지원팀에 확인하십시오.)
벤치마크 및 커뮤니티 피드백: 코딩, 프론트엔드 및 에이전트 작업
헤드라인 종합 점수는 각 모델이 실제로 어디에서 성공하는지 숨깁니다. Artificial Analysis Intelligence Index v4.3.2에서 Claude Sonnet 5.5(max, 기본 폴백)는 56점, GPT-6.1 Sol(max)은 52점, GPT-6.1 Terra는 max 노력 수준에서 48점, medium 노력 수준에서 41점을 기록했습니다. (GPT Proto의 비교 카드에 표시된 2026년 11월 3일 인덱스 스냅샷에서 Sonnet 5.5는 54.2점, Terra max는 51점을 기록했으며, 이는 Sonnet이 여전히 우세한 3.2포인트의 더 좁은 격차입니다.) 코드, 프론트엔드 UI 또는 에이전트 루프에 대한 실질적인 라우팅 결정을 내리려면 이러한 집계 데이터를 작업 유형별로 세분화하고 개발자들이 실제 현장에서 보고하는 내용과 비교해야 합니다.
1. 백엔드 및 터미널 코딩 (GPT 6.1 Terra 대 Sonnet 5.5 코딩 비교)
명령줄을 통한 순수 소프트웨어 엔지니어링 분야에서 Anthropic은 여전히 확실한 우위를 점하고 있습니다. Terminal-Bench 4.0에서 Anthropic은 Claude Sonnet 5.5의 성능을 70.6%로 보고했으며 (Sonnet 5의 10.3% 대비 상승), 반면 OpenAI는 GPT-6.1 Terra의 최대(max) 노력 설정에서 50.3%를 기록했다고 보고했습니다 (GPT-5.6 Terra의 21.5% 대비 상승). Artificial Analysis가 새로 발표한 코딩 에이전트 지수(Coding Agent Index) v2.0에서 Terra는 48점을 기록하여 경량 모델인 GPT-6 Luna(31점)보다는 17점 앞섰지만, GPT-6.1 Sol(54점)보다는 6점 뒤처졌습니다. 또한 Artificial Analysis는 코딩 에이전트의 경우 Terra의 낮음(low) 및 매우 높음(xhigh) 노력 설정이 비용 효율성 측면에서 최전선에 위치하며, 다른 노력 설정은 그에 미치지 못한다고 언급했습니다.
초기 실사용 테스트는 두 모델 간의 명확한 경계를 보여줍니다:
GitHub Copilot의 2026년 10월 26일 릴리스 변경 로그에 따르면, 초기 내부 테스트에서 GPT-6.1 Terra가 GPT-5.6 Terra보다 터미널 및 C# 코딩 작업을 눈에 띄게 더 많이 해결했으며, 다음과 같은 중요한 행동 관찰 결과를 덧붙였습니다: "범위가 잘 정의된 작업에 대해 집중적이고 통합된 단계로 작동합니다." GitHub는 해당 메모에서 실제 통과율 수치를 공개하지 않았으므로, 이를 통제된 벤치마크가 아닌 정성적인 플랫폼 평가 결과로 보아야 합니다.
Claude 측의 경우, r/ClaudeAI에서 진행된 초기 개발자 비교 테스트(Claude Code 및 높음(high) 노력 설정에서 10개의 개인 코딩 작업을 구성당 3회씩 실행)pi-agent) 결과, Sonnet 5.5가 이전 모델보다 더 적은 대화 턴과 더 적은 출력 토큰으로 구현을 일관되게 완료했음을 확인했습니다. 이는 주로 Sonnet 5.5가 병렬 도구 호출을 더 공격적으로 배치(batch) 처리하기 때문입니다. 마찬가지로 Cursor의 외부 CursorBench 4.0 평가에서 Sonnet 5.5는 높음(high) 노력 설정에서 작업당 $1.67의 비용으로 47.8%를 기록했습니다.
백엔드 개발자를 위한 결론: 티켓의 범위가 명확하다면(C# 서비스 메서드 작성, 단위 테스트 추가, 또는 독립적인 CLI 스크립트 수정 등), Terra를 낮음(low) 또는 중간(medium) 노력 설정으로 사용하는 것이 토큰 비용의 절반 이하로 작업을 빠르게 완료할 수 있는 방법입니다. 만약 티켓이 10개의 파일에 걸쳐 상태를 추적해야 하고 추가적인 재시도 루프가 워크플로우를 방해하는 상황이라면, Sonnet 5.5의 70.6% 터미널 역량이 더 높은 비용을 지불할 가치를 제공합니다. 과학적 컴퓨팅이 포함된 경우, OpenAI는 Terminal-Bench-Science 0.1(타임랩스 영상에서 세포 분열을 추적하는 코드 작성 등)에서 Terra를 최대(max) 노력 설정으로 사용하면 실제로 GPT-6.1 Sol을 능가하며, 예상 비용의 5분의 1 미만으로 Claude Opus 5.5와 5점 차이 이내의 성능을 보인다고 보고했습니다.
2. 프론트엔드 코딩을 위한 GPT-6.1 Terra vs Sonnet 5.5
프론트엔드 코딩을 위한 GPT 6.1 Terra vs Sonnet 5.5를 검색하는 것은 그 자체로 별도의 답변이 필요합니다. 프론트엔드 엔지니어링은 시각적/DOM 레이아웃 작업과 상태/아키텍처 로직이라는 두 가지 서로 다른 업무가 결합된 형태이기 때문입니다.
OpenAI가 Terminal-Bench 4.0에서 GPT-6.1 Terra의 50.3% 점수를 발표했을 때, 발표에서 강조한 유일한 구체적인 코딩 예시는 프론트엔드 버그였습니다. 바로 "로딩 시 레이아웃이 밀리는 웹페이지 수정"(누적 레이아웃 이동, CLS)입니다. 동시에 OpenAI는 다이어그램, 스크린샷, 복잡한 레이아웃에 대한 시각적 추론 벤치마크인 MMMU-Pro에서 GPT-6.1 Terra가 모든 노력 수준에서 GPT-5.6 Terra를 능가하며, 훨씬 저렴한 비용으로 최첨단 모델인 GPT-6 Astra 및 GPT-6.1 Sol과 거의 대등한 성능을 보인다고 보고했습니다. OpenAI 개발자 커뮤니티 포럼의 출시 당일 스레드에서 한 개발자는 Terra를 다음과 같이 요약했습니다. "특히 시각적 이해도 측면에서 가성비가 매우 뛰어납니다. 코딩 성능도 준수하고요."
이러한 구분은 프론트엔드 팀에게 명확한 업무 분담을 제공합니다.
시각적 및 UI 계층 프론트엔드 작업에는 GPT-6.1 Terra를 사용하세요. Figma 스크린샷이나 와이어프레임을 초기 Tailwind/HTML 마크업으로 변환하거나, 렌더링된 Playwright 스크린샷을 디자인 사양과 비교하여 겹치는 DOM 노드나 모바일 중단점 회귀를 찾아내고, CSS 레이아웃 이동을 진단하는 데 적합합니다. Terra는 이미지를 기본적으로 처리하고, 시각적 작업 벤치마크에서 GPT-6.1 Sol 및 Astra보다 3배 이상 빠르게 실행되며, GPT Proto에서 $0.80/$4.00의 비용으로 이용할 수 있으므로 CI 파이프라인에서 모든 커밋마다 시각적 회귀 테스트를 수행할 수 있습니다.
로직 중심의 프론트엔드 아키텍처에는 Claude Sonnet 5.5를 사용하세요. 복잡한 React/Next.js 서버 액션 상태 트리 리팩토링, 복잡한 TypeScript 제네릭 제약 조건 해결, 또는 하이드레이션 오류 없이 레거시 Redux 스토어 마이그레이션 등을 수행할 때 유용합니다. 검사할 스크린샷이 없고 순수하게 다중 파일 상태 일관성이 문제인 경우, Sonnet 5.5가 더 안전한 선택지입니다.
3. 에이전트 작업, 컴퓨터 사용 및 사실성 (에이전트 작업을 위한)
귀하의 에이전트 작업을 위한 GPT 6.1 Terra 대 Sonnet 5.5에 대한 정의가 GUI 자동화, 문서 파싱 및 백오피스 컴퓨터 사용에 중점을 둔다면, GPT-6.1 Terra는 2026년 OpenAI가 내놓은 가장 강력한 가치 중심의 릴리스라고 할 수 있습니다.
건축 도면을 3D 모델로 변환하거나 애니메이션 영화의 장면별 타임코드를 기록하는 것과 같은 다단계 전문 워크플로우를 테스트하는 OpenAI의 벤더 보고 에이전트 최종 시험(Agents' Last Exam) v1에서, GPT-6.1 Terra는 중간(medium) 노력 수준에서 GPT-5.6 Terra보다 15% 포인트 더 높은 점수를 기록했으며, 비용은 약 3분의 1 수준이고 토큰 가격은 플래그십 모델인 GPT-6 Astra의 10분의 1 수준입니다. 최대(max) 노력 수준에서 OpenAI는 Terra가 Claude Opus 5.5보다 토큰 효율성이 3배 이상 높고 토큰당 가격은 4분의 1 수준이라고 보고했습니다. 이는 GPT-6 Astra 및 GPT-6.1 Sol보다 워크플로우를 3배 이상 빠르게 완료하면서도 작업당 비용을 약 9배 낮추는 결과입니다.
데스크톱 애플리케이션 제어를 다루는 OSWorld 2.1에서, OpenAI는 중간(medium) 노력 수준의 Terra가 GPT-5.6 Terra의 최고 점수를 작업당 훨씬 낮은 비용으로 능가한다고 보고합니다. 균형을 맞추자면, Anthropic이 발표한 Claude Sonnet 5.5의 OSWorld 2.1(오프라인) 점수는 83.9%로 매우 높습니다(Anthropic의 2026년 10월 Haiku 5.5 벤치마크 표에서 공개됨). 두 모델 모두 최고 수준의 컴퓨터 사용 엔진이지만, 차이점은 화면 스크래핑 에이전트가 클릭할 때마다 새로운 스크린샷을 전송하여 입력 토큰을 빠르게 소모한다는 점이며, 이로 인해 Terra의 $0.80/M GPT Proto 입력 요금이 대규모 환경에서 훨씬 더 지속 가능합니다.
자율 에이전트에게 중요한 또 다른 요소는 모델이 무언가를 모를 때 이를 인지하는 것입니다. Artificial Analysis의 독립적인 AA-Omniscience 벤치마크에서, GPT-6.1 Terra의 환각률(모델이 지식이 부족할 때 추측하는 빈도)은 GPT-5.6 Terra의 88%에서 38%로 50% 포인트 감소했으며, 동시에 전반적인 정확도는 2포인트 상승했습니다. 이러한 독립적인 측정 결과는 OpenAI의 내부 사실성 평가(GPT-6.1 Terra 시스템 카드에서 자세히 설명됨)를 뒷받침하며, 어려운 프롬프트에 대한 낮은 노력 수준의 사실 오류율이 53.6%에서 16.7%로(그리고 최대(max) 노력 수준에서는 4.3%로) 감소했습니다. 환각률이 낮을수록 다운스트림에서 잘못된 도구 호출이 발생할 가능성이 줄어듭니다.
개발자 경험 및 API 주의 사항 (개발자를 위한 GPT 6.1 Terra vs Sonnet 5.5)
프로덕션 환경에서 gpt-6.1-terra와 claude-sonnet-5-5 사이를 전환하는 것은 단순히 한 줄의 문자열을 교체하는 것만으로는 거의 불가능합니다. 개발자를 위한 GPT 6.1 Terra vs Sonnet 5.5의 사용 편의성을 평가 중이라면, 네 가지 API 수준의 제약 사항이 통합 작업의 방향을 결정하게 될 것입니다.
첫째, GPT-6.1 Terra는 reasoning.effort: "none"을 지원하지만, GPT-6.1 Sol은 그렇지 않습니다. OpenAI가 2026년 9월 29일에 GPT-6.1 Sol을 출시했을 때, none 및 minimal 추론 계층을 제거하여 모든 요청을 low 이상으로 강제했고, 이로 인해 전반적으로 temperature 및 top_p 설정이 작동하지 않게 되었습니다. OpenAI의 공식 gpt-6.1-terra 프롬프팅 및 마이그레이션 가이드에 따르면, Terra는 none, low, medium (기본값), high, xhigh, max 등 전체 범위를 지원합니다. reasoning_effort: "none"으로 설정하면 Terra는 숨겨진 추론 토큰을 생성하지 않고 표준 샘플링 매개변수를 허용합니다. 그러나 low, medium, high, xhigh 또는 max를 사용하는 순간, 요청 페이로드에서 temperature, top_p, top_logprobs, logprobs를 제거해야 합니다. 그렇지 않으면 API가 HTTP 400 오류와 함께 호출을 거부합니다.
둘째, OpenAI는 GPT-6.1 Terra에서 도구 호출을 위해 Responses API(/v1/responses)를 요구합니다. 일반 텍스트 및 이미지 프롬프트는 /v1/chat/completions에서 작동하지만, OpenAI의 모델 문서는 도구 호출 시 /v1/responses가 필요하다고 명시하고 있습니다. Responses API를 사용하면 Terra는 웹 검색, 파일 검색, 이미지 생성, 코드 인터프리터, 호스팅된 셸, apply_patch, 스킬, 컴퓨터 사용, MCP, 도구 검색 등 OpenAI의 9가지 기본 내장 도구를 모두 지원하며, 사용자 지정 함수 도구에서 async: true를 지원하여 느린 백그라운드 도구가 실행되는 동안 모델이 계속 추론할 수 있게 합니다. 또한 Terra는 대화 중간에 configuration_update 입력 항목을 전송하여, 프롬프트 접두사를 다시 작성하거나 30분 프롬프트 캐시(prompt_cache_options.ttl: "30m")를 무효화하지 않고도 어려운 턴에서 reasoning.effort를 높이거나 낮출 수 있습니다.
셋째, Claude Sonnet 5.5에는 자체적인 엄격한 400 오류 트랩이 있습니다. Anthropic의 Sonnet 5.5 마이그레이션 가이드에 따르면, Sonnet 5.5는 기본적으로 적응형 사고(Adaptive Thinking)를 사용합니다(API에서는 high 노력, Anthropic의 Claude Code 구성 문서에 명시된 대로 Claude Code에서는 medium 노력으로 기본 설정됨). 기존 Claude 통합에서 thinking: {"type": "disabled"}를 전송하는 경우, 가장 낮은 사고 설정인 between_tools로 업데이트해야 합니다. 더 중요한 점은, 적응형 사고가 활성화된 상태에서 강제 도구 선택(tool_choice: {"type": "any"} 또는 강제 명명된 도구)을 사용하면 400 오류가 발생한다는 것입니다. 이 경우 auto를 사용하고 프롬프트 내에서 도구 선택을 유도해야 합니다. 또한 첫 번째 블록이 종종 thinking 블록이기 때문에 content[0]이 텍스트라고 가정하는 대신 type별로 응답 콘텐츠 블록을 파싱해야 합니다.
넷째, IDE 및 CLI 통합은 이미 두 모델 모두에 연결되어 있습니다. 소비자 구독의 경우, OpenAI의 릴리스 노트에서 GPT-6.1 Terra가 표준 ChatGPT 채팅 인터페이스가 아닌 ChatGPT Work 및 Codex(Plus, Pro, Business, Enterprise 및 Edu 플랜용)에 배포되었음을 확인했으며, UAE 추론 상주를 지원하지 않습니다(단, Fast 모드는 EU 데이터 상주를 지원함). 로컬 터미널에서 작업하는 개발자의 경우, 두 모델 모두 GPT Proto를 통해 Claude Code 및 OpenAI Codex에 연결할 수 있습니다. GPT-6.1 Terra 모델 페이지에서 이 모델 사용해 보기를 클릭하면 빠른 시작 패널이 열립니다. 여기에서 AI가 통합을 완료하도록 허용 아래의 Claude Code 또는 ChatGPT (Codex)를 선택하거나, AI용 마크다운 복사를 클릭하여 코딩 어시스턴트가 환경 변수를 자동으로 설정하도록 할 수 있습니다.
앱 빌드: 단일 API 키로 두 모델을 라우팅하는 방법
팀에서 앱 빌드를 위한 GPT 6.1 Terra 대 Sonnet 5.5에 대해 문의할 때, 가장 좋은 아키텍처는 트래픽의 100%를 하나의 모델로만 처리하는 것이 아닙니다. 두 모델 모두 GPT Proto의 단일 선불 잔액 내에서 작동하므로, 공급업체별이 아닌 단계별로 라우팅할 수 있습니다. 고빈도 시각적 검사, 스크린샷 분류, 제한된 UI 수정 작업은 gpt-6.1-terra(입력 $0.80/출력 $4.00)로 보내고, 다중 파일 코드 합성 작업은 claude-sonnet-5-5(입력 $1.80/출력 $9.00)로 에스컬레이션하십시오.
1. 첫 번째 cURL 호출 확인 (OpenAI 호환 채팅 완료)
두 모델 모두 표준 Bearer 토큰을 사용하여 GPT Proto의 통합 OpenAI 호환 /v1/chat/completions 엔드포인트를 통해 텍스트 및 시각적 분석을 위해 호출할 수 있습니다. 모델 간 전환 시에는 "model" 문자열만 변경하면 됩니다:
# 호출 1: GPT-6.1 Terra (GPT Proto 기준 100만 토큰당 입력 $0.80 / 출력 $4.00)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [
      {
        "role": "user",
        "content": "이 CSS 규칙을 검사하고 이것이 모바일에서 레이아웃 시프트를 유발하는 이유를 두 문장으로 설명하세요: .hero-banner { width: 100%; height: auto; }"
      }
    ]
  }'

# 호출 2: Claude Sonnet 5.5 (GPT Proto 기준 100만 토큰당 입력 $1.80 / 출력 $9.00)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "messages": [
      {
        "role": "user",
        "content": "Web Crypto API를 사용하여 상수 시간 비교로 웹훅 서명을 검증하는 TypeScript 헬퍼를 작성하세요."
      }
    ]
  }'
2. 프론트엔드 및 앱 파이프라인을 위한 Python 단계별 라우터 예제
다음은 https://gptproto.com/v1를 가리키는 표준 openai SDK를 사용하는 실용적인 Python 패턴입니다. 이 워크플로우에서 1단계는 gpt-6.1-terra를 사용하여 UI 버그 보고서를 분류(토큰 볼륨이 높고 시각적/DOM 진단 비용이 저렴한 경우)하고, 2단계는 실제 코드 패치를 gpt-6.1-terra(단일 구성 요소 CSS 수정의 경우) 또는 claude-sonnet-5-5(분류 결과 파일 간 상태 변경이 필요하거나 프롬프트가 272K 제한에 가까워지는 경우)로 동적 라우팅합니다:
import os
import json
from openai import OpenAI

# OpenAI 및 Anthropic 모델 간 공유되는 단일 API 키 및 잔액
client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

def triage_and_patch_ui_issue(dom_snapshot: str, screenshot_url: str, approx_tokens: int) -> dict:
    # 1단계: 항상 GPT-6.1 Terra로 시각적/DOM 트리아지(triage) 실행 ($0.80 / $4.00, 100만 토큰당)
    triage_response = client.chat.completions.create(
        model="gpt-6.1-terra",
        messages=[
            {
                "role": "system",
                "content": (
                    "당신은 프론트엔드 QA 트리아지 에이전트입니다. 스크린샷과 DOM을 검사하세요. "
                    "'root_cause', 'scope' ('isolated_css' 또는 'multi_file_state'), "
                    "그리고 'target_files' (문자열 배열) 키를 포함한 JSON을 반환하세요."
                ),
            },
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": f"DOM 스냅샷: {dom_snapshot}"},
                    {"type": "image_url", "image_url": {"url": screenshot_url}},
                ],
            },
        ],
        response_format={"type": "json_object"},
    )

    triage_data = json.loads(triage_response.choices[0].message.content)

    # 2단계: 작업 범위 및 272K 장기 컨텍스트 과금 경계에 따라 라우팅
    # 수정 사항이 다중 파일 상태에 영향을 주거나 272K 입력 토큰을 초과하는 경우, Sonnet 5.5로 에스컬레이션
    if triage_data.get("scope") == "multi_file_state" or approx_tokens > 272_000:
        selected_model = "claude-sonnet-5-5"
    else:
        selected_model = "gpt-6.1-terra"

    patch_response = client.chat.completions.create(
        model=selected_model,
        messages=[
            {
                "role": "user",
                "content": (
                    f"트리아지 진단: {json.dumps(triage_data)} | "
                    f"DOM/컴포넌트에 대한 최소한의 프로덕션 준비가 완료된 패치를 생성하세요: {dom_snapshot}"
                ),
            }
        ],
    )

    return {
        "triage": triage_data,
        "routed_to": selected_model,
        "patch": patch_response.choices[0].message.content,
    }

if __name__ == "__main__":
    sample_dom = "<div class='card-grid'><img src='/hero.webp' /><h2>Checkout</h2></div>"
    result = triage_and_patch_ui_issue(
        dom_snapshot=sample_dom,
        screenshot_url="https://example.com/cls-regression-frame.png",
        approx_tokens=12_000,
    )
    print(f"패치 라우팅 대상: {result['routed_to']}")
    print(result["patch"])
배포 전 참고 사항 (스모크 테스트 필수): 과금 루프를 배포하기 전에 GPT Proto 모델 페이지의 실시간 API 사용량 패널에서 정확한 모델 문자열(gpt-6.1-terra 및 claude-sonnet-5-5)을 확인하십시오. 에이전트가 OpenAI의 기본 Responses API 도구(apply_patch, 호스팅된 셸 또는 async: true 함수 호출)나 Anthropic의 기본 /v1/messages 적응형 사고 매개변수(output_config.effort)에 의존하는 경우, GPT Proto의 각 기본 엔드포인트(/v1/responses 및 /v1/messages)에 대해 간단한 스모크 테스트를 실행하여 경로상의 매개변수 전달을 확인하십시오.
평결: 어떤 모델을 사용해야 할까요?
아키텍처 검토 문서에 붙여넣을 단일 표가 필요하다면, 가장 중요하게 생각하는 실패 모드와 비용 경계에 맞춰 기본 워크로드를 매칭하세요:
| 워크로드 / 시나리오 |
권장 모델 |
권장 설정 |
선택 이유 |
| 대량 스크린샷 QA, 송장/양식 읽기 및 브라우저 컴퓨터 사용 |
GPT-6.1 Terra |
low 또는 medium effort |
GPT Proto 토큰 요금 56% 절감($0.80/$4.00), Sol/Astra 대비 3배 이상 빠른 작업 완료 속도, Astra 수준의 MMMU-Pro 비전 성능 제공. |
| 프론트엔드 UI 디버깅 (CLS 레이아웃 시프트, Figma-to-CSS, 시각적 회귀) |
GPT-6.1 Terra |
medium effort |
시각적 요소 및 DOM 검사를 위해 구축되었으며, 웹페이지 레이아웃 시프트 수정 작업에서 명시적으로 벤치마킹됨. |
저지연 분류, 라우팅 또는 temperature가 필요한 JSON 추출 |
GPT-6.1 Terra |
reasoning.effort: "none" |
GPT-6.1 Sol에서 제외되었던 비추론(non-reasoning) none 티어를 복원하여 지연 시간과 출력 토큰 수를 최소화함. |
| 다중 파일 백엔드 리팩토링 및 복잡한 TypeScript/React 상태 변경 |
Claude Sonnet 5.5 |
medium 또는 high effort |
Terminal-Bench 4.0에서 70.6% vs 50.3% 기록; 도구 호출을 더 적은 턴으로 일괄 처리하여 값비싼 개발자 검토 시간을 절약함. |
| 단일 요청 장기 컨텍스트 저장소 분석 (300K ~ 900K 입력 토큰) |
Claude Sonnet 5.5 |
medium 또는 high effort |
Terra는 272K 토큰을 초과할 경우 2배의 입력 / 1.5배의 출력 추가 요금(공식 입력가 $2.00로 상승)이 발생하여 가격 경쟁력이 사라짐. |
Terra max가 부족할 때 사용하는 가장 심도 있는 OpenAI 네이티브 터미널 코딩 |
GPT-6.1 Sol |
medium effort |
AA Coding Agent Index v2.0에서 Terra의 48점 대비 54점을 기록했으며, Sol medium($0.21/작업)은 실제로 Terra `max`($0.40/작업)보다 작업당 비용이 저렴함. |
결론을 명확히 말씀드리자면, 반복 가능한 모든 시각적 작업, 컴퓨터 사용, 제한된 코딩 단계는 GPT-6.1 Terra의 low 또는 medium effort 설정으로 시작하여 $0.80/$4.00 요금 혜택을 누리세요. 다중 파일 코딩 단계나 272K 토큰 이상의 프롬프트에는 더 높은 초기 정확도와 1M 컨텍스트 고정 가격을 제공하는 Claude Sonnet 5.5를 사용하세요. 본인의 월간 입력 및 출력 비율을 적용해보려면 GPT Proto 비교 계산기를 열어 두 모델을 나란히 테스트해보세요.