Wie wir Modelle für SillyTavern bewertet haben
Die wichtigste Grundlage ist der September 2026 AI Roleplay Bench, bei dem 14 offizielle Modelle in 10 Kategorien getestet und 840 Antworten bewertet wurden. Die Kategorien umfassen Begleiter-Chat, Game-Master-Verhalten, strikte Charakterstimmen, Schurken, Robustheit, reife Themen und Sicherheitsgrenzen. Kimi K3, GLM-5.3 und DeepSeek V4.1 Flash liegen weniger als zwei Punkte auseinander, weshalb der Benchmark selbst dazu rät, sie als effektives Unentschieden zu betrachten, anstatt eine Dezimalstelle als entscheidenden Sieg zu werten.
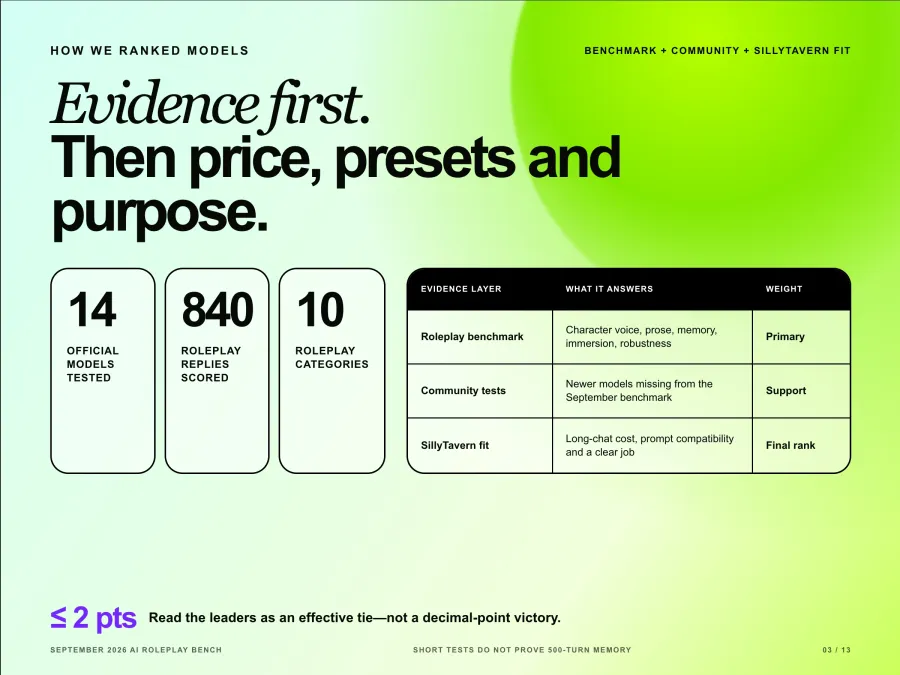
Der Benchmark hat auch Grenzen. Seine veröffentlichte Methodik verwendet kurze Szenarien mit mehreren Interaktionen, misst nicht das Abdriften über Hunderte von Nachrichten hinweg und schließt Community-Fine-Tunes aus. Neuere Veröffentlichungen wie Gemini 4 Argon kamen ebenfalls erst nach diesem Test heraus. Für diese Modelle verwende ich Community-Vergleiche als unterstützende Beweise und kennzeichne die Empfehlung als weniger sicher.
Das endgültige Ranking ergänzt drei SillyTavern-spezifische Faktoren:
Wirtschaftlichkeit bei langen Chats. Eingabetoken dominieren normalerweise spätere Interaktionen, da SillyTavern die Charakterkarte, Anweisungen, relevante Hintergrundinformationen und den Gesprächsverlauf erneut sendet.
Kompatibilität von Prompts und Presets. Chat Completion, Text Completion, Instruct-Templates, Sampler und Reasoning-Steuerungen sind nicht austauschbar.
Eine klare Aufgabe für jedes Modell. Ein günstigeres Modell verdient seinen Platz nur, wenn es eine nützliche Rolle erfüllt, nicht einfach nur, weil der Preis niedrig ist.
Die 8 besten KI-Modelle für SillyTavern-Rollenspiele
1 Kimi K3 – Das beste Allround-Modell für SillyTavern
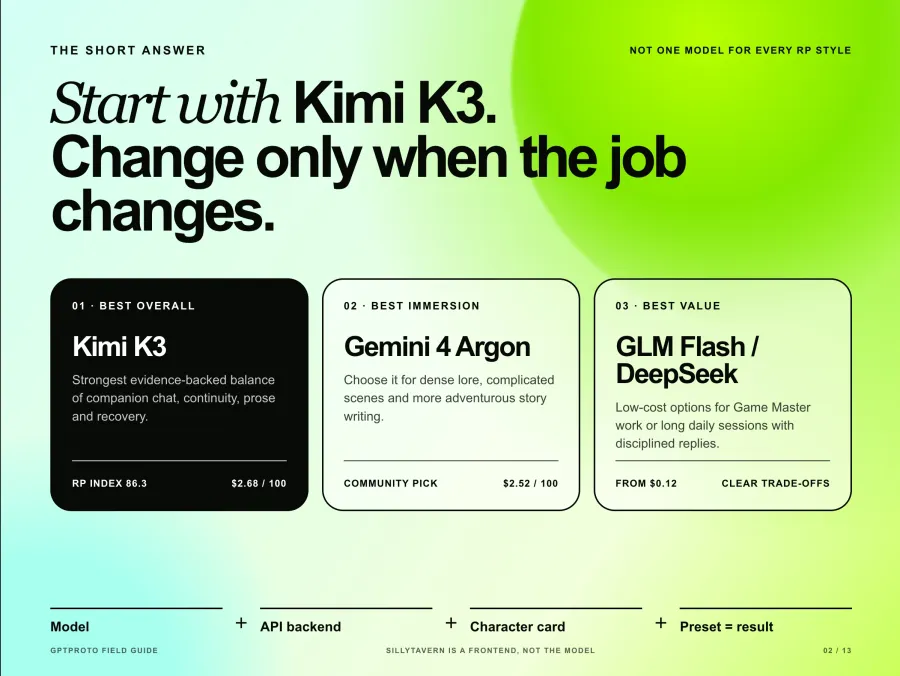
Kimi K3 ist die sicherste erste Wahl, wenn du noch nicht weißt, welchen Rollenspielstil du bevorzugst. Es erzielte 86,3 insgesamt, 90,0 für Begleiter und 88,3 für Robustheit im Rollenspiel-Benchmark. Es führte auch die Bewertungen des Benchmarks für Charakter, Prosa, Gedächtnis und Immersion an.
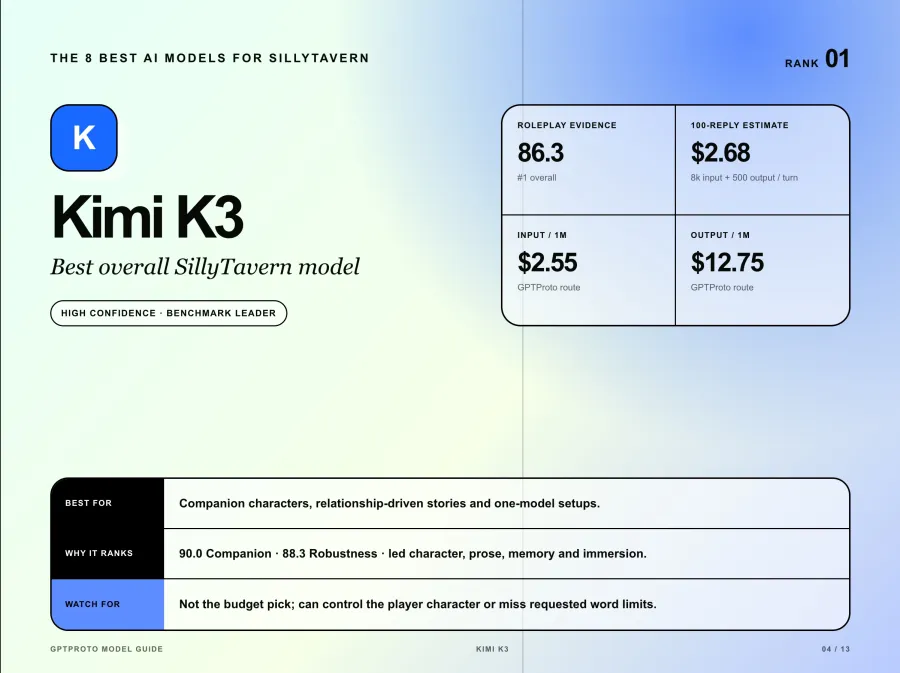
Dieses Gleichgewicht ist in SillyTavern wichtiger als eine einzelne auffällige Antwort. Kimi kam mit Ein-Wort-Benutzernachrichten zurecht, erinnerte sich an eingestreute Details und hielt den Charakter aktiv, anstatt zu einem generischen Assistenten zu werden. Seine Schwächen waren konkret: Es steuerte manchmal den Charakter des Spielers als Game Master und ignorierte gewünschte Wortbegrenzungen.
Beste Eignung: Begleiter-Charaktere, beziehungsorientierte Geschichten und Benutzer, die ein Modell für mehrere RP-Stile suchen. SillyTavern-Startpunkt: Verwende Chat Completion, die exakte kimi-k3 Modell-ID und eine moderate Antwortlänge, bevor du komplexere Preset-Regeln hinzufügst. Mit 2,55 $ für Eingabe und 12,75 $ für Ausgabe pro Million Token ist es nicht die Budget-Wahl.
2 Gemini 4 Argon – Am besten für immersives Rollenspiel
Gemini 4 Argon ist der stärkste aktuelle Favorit der Community für dichte Lore, komplizierte Szenen und das Schreiben langer Geschichten. SillyTavern-Nutzer loben die Präzision bei großen Prompts und die Fähigkeit, nützliche Szenendetails hinzuzufügen, anstatt die Charakterkarte nur umzuformulieren. Eine detaillierte Community-Diskussion über die Nutzung bei langen Geschichten beschrieb eine deutliche Verbesserung, nachdem die gleiche Geschichte bei anderen Modellen ins Stocken geraten war.
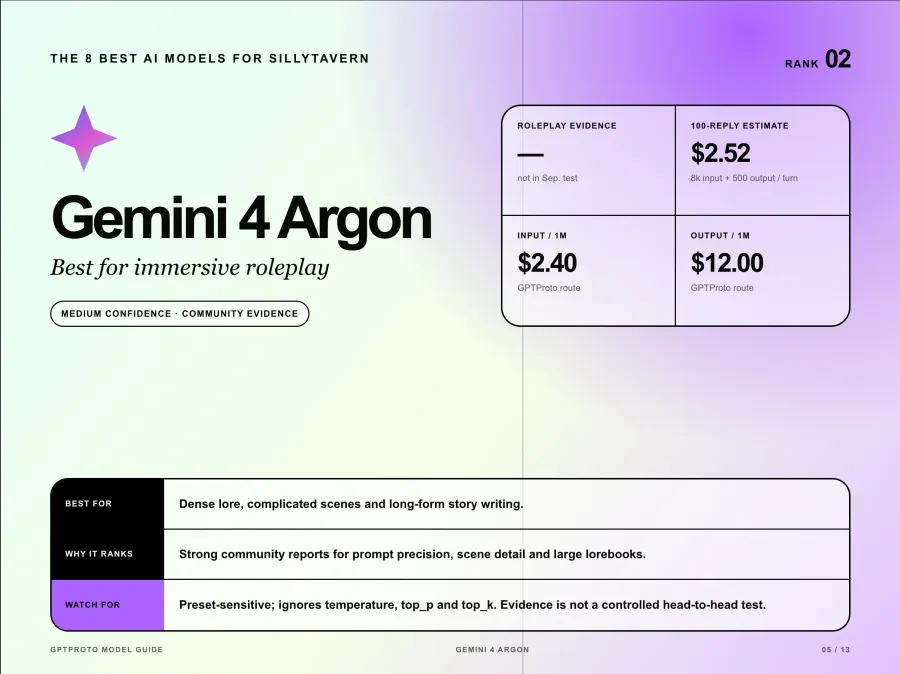
Das Vertrauensniveau ist niedriger als bei Kimi oder GLM, da Argon nicht im Rollenspiel-Benchmark vom September enthalten war. Die Begeisterung der Community ist ein Indiz, aber kein kontrollierter direkter Vergleich.
Argon benötigt zudem ein eigenes Preset. Die API ignoriert temperature, top_p und top_k; das Kopieren eines älteren, sampler-lastigen Gemini-Presets erzeugt also nur die Illusion von Kontrolle, ohne diese Werte tatsächlich zu ändern. Beginnen Sie mit mittlerem „Thinking“ für Eins-zu-eins-Charakter-Chats und testen Sie hohes „Thinking“ nur für regelintensive RPGs oder große Lorebooks. Der Nachteil sind die Kosten: Mit 2,40 $ für Input und 12 $ für Output pro Million Token kostet ein fester Test mit 100 Antworten etwa 2,52 $, bevor der Verlauf erweitert wird.
3 GLM 5.3 – Das beste Modell für ausgewogenes Storytelling
GLM-5.3 ist die überzeugendste Alternative zu Kimi K3, wenn das Modell einen größeren Teil der Geschichte tragen soll. Es erzielte 85,1 insgesamt, 92,5 bei Strict Voice und 85,8 bei Robustheit. Der Benchmark beschreibt es als besonders effektiv für storybasiertes Rollenspiel, Dark Fiction und Abenteuer-Bots.
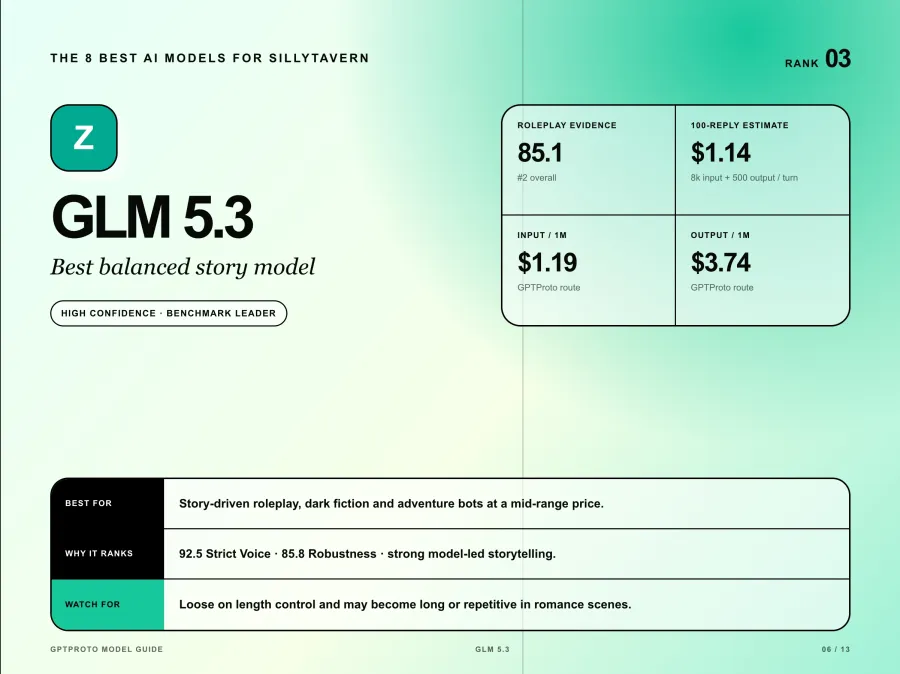
Der Kompromiss liegt bei der Kontrolle über Länge und Tempo. GLM-5.3 war das Modell mit der lockersten Handhabung bei Wortbegrenzungen unter den führenden Modellen und schnitt im Romantik-Szenario des Benchmarks deutlich schlechter ab, da die Antworten lang und repetitiv wurden. Eine strikte maximale Antwortlänge und eine klare Anweisung für den Verlauf helfen, garantieren aber keine prägnante Ausgabe.
Mit 1,19 $ für Input und 3,74 $ für Output pro Million Token kostet GLM-5.3 im festen 100-Antworten-Beispiel weniger als die Hälfte von Kimi K3. Verwenden Sie die Modell-ID glm-5.3. Es ist eine vernünftige Standardwahl für Nutzer, die eine starke Rollenspielqualität wünschen, ohne bei jeder Antwort Premium-Preise zu zahlen.
4 DeepSeek V4.1 Flash – Am besten für erschwingliche lange Sessions
DeepSeek V4.1 Flash bietet das beste Preis-Leistungs-Verhältnis in dieser Liste. Es erzielte insgesamt 84,4 Punkte, hielt bei allen 28 von 28 Kern-Rollenspiel-Antworten das Wortlimit ein und belegte in der Kategorie „Schurke“ den ersten Platz (gleichauf). Mit Preisen von 0,24 $ für Input und 0,96 $ für Output kostet das Beispiel mit 100 Antworten etwa 0,24 $.
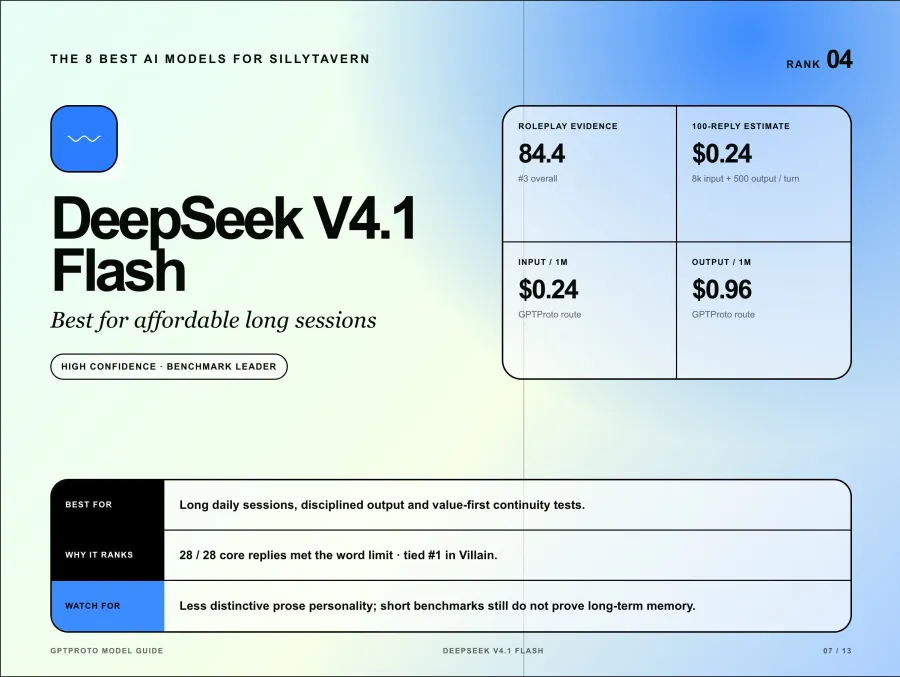
Das Modell ist als Prosa-Stilist weniger markant als Kimi, Argon oder Opus. Das kann ein Vorteil sein, wenn die Charakterkarte bereits eine starke Stimme vorgibt: Das Modell neigt weniger dazu, diese mit seinem eigenen Stil zu überschreiben. Es ist auch nützlich, wenn Sie lange tägliche Sessions erwarten und ein teureres Modell für entscheidende Szenen aufsparen möchten.
Verwenden Sie deepseek-flash in SillyTavern. Meiner Einschätzung nach ist dies der beste erste Wert-Test für lang laufende Chats, aber der Benchmark basierte dennoch auf kurzen Szenarien. Sie sollten Ihren eigenen Kontinuitätstest über 30 bis 50 Runden durchführen, bevor Sie den niedrigen Preis als Beweis für ein Langzeitgedächtnis betrachten.
5 GLM 5.3 Flash – Der beste günstige Spielleiter
GLM-5.3 Flash ist der Spezialist für das kleine Budget. Es erzielte 89,2 Punkte als Spielleiter und 98,3 Punkte für strikte Stimmtreue, das höchste Einzelergebnis im September-Benchmark. Bei 0,1275 $ für Input und 0,425 $ für Output pro Million Token kostet das Beispiel mit 100 Antworten etwa 0,12 $.
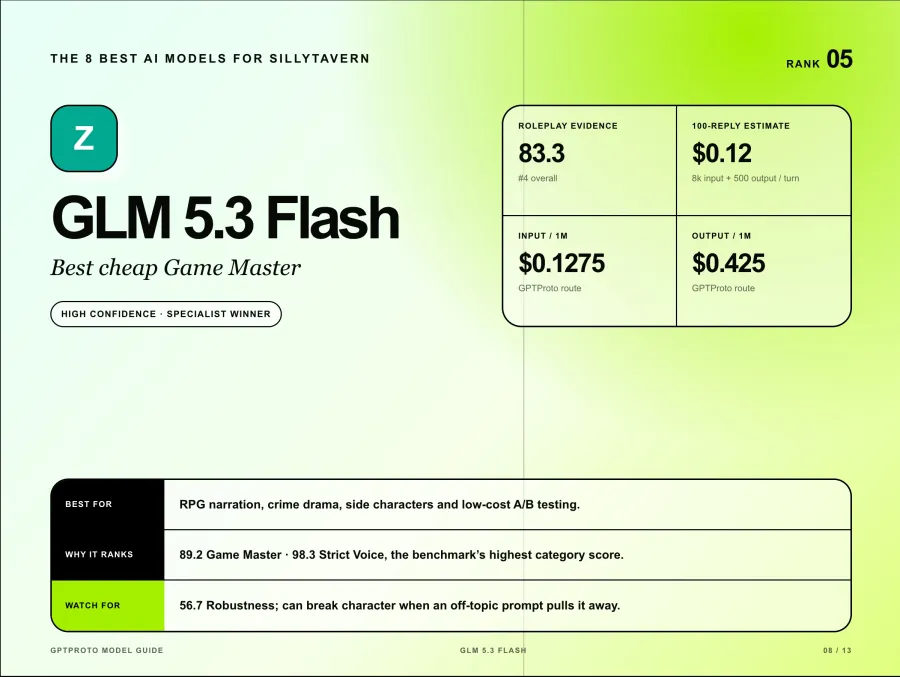
Seine Schwachstelle ist ebenso wichtig. GLM-5.3 Flash erzielte nur 56,7 Punkte für Robustheit, da es aus der Rolle fiel, um eine themenfremde Anfrage wie ein allgemeiner Assistent zu beantworten. Zudem überschritt es bei mehr Kern-Rollenspiel-Antworten das Wortlimit als die anderen Spitzenreiter.
Wählen Sie es für RPG-Erzählungen, Krimidramen, Nebencharaktere oder kostengünstige A/B-Tests. Gehen Sie nicht davon aus, dass der niedrige Preis es zum besten Begleitmodell macht. Halten Sie in SillyTavern die Charakterregeln nahe am Ende des Prompts und testen Sie gezielte Ablenkungsversuche, bevor Sie sich auf einen langen Chat einlassen. Die Modell-ID lautet glm-5.3-flash.
6 Gemini 3.8 Flash: Das beste schnelle Modell für den Alltag
Gemini 3.8 Flash verdient einen festen Platz auf dieser Liste und nicht nur eine beiläufige Erwähnung. Ein aktueller Community-Rollenspiel-Benchmark testete bis zu 64 Antworten pro Modell über acht Kapitel hinweg und verlieh Gemini 3.8 Flash einen Qualitätswert von 91,9. Dieser Test gewichtete Schreibpräferenzen zu 75 Prozent und Robustheit zu 25 Prozent. Dies ist ein nützlicher Beleg, aber der Wert ist nicht direkt mit dem AI Roleplay Bench vergleichbar, da sich die Prompts und die Bewertungsmethoden unterscheiden.
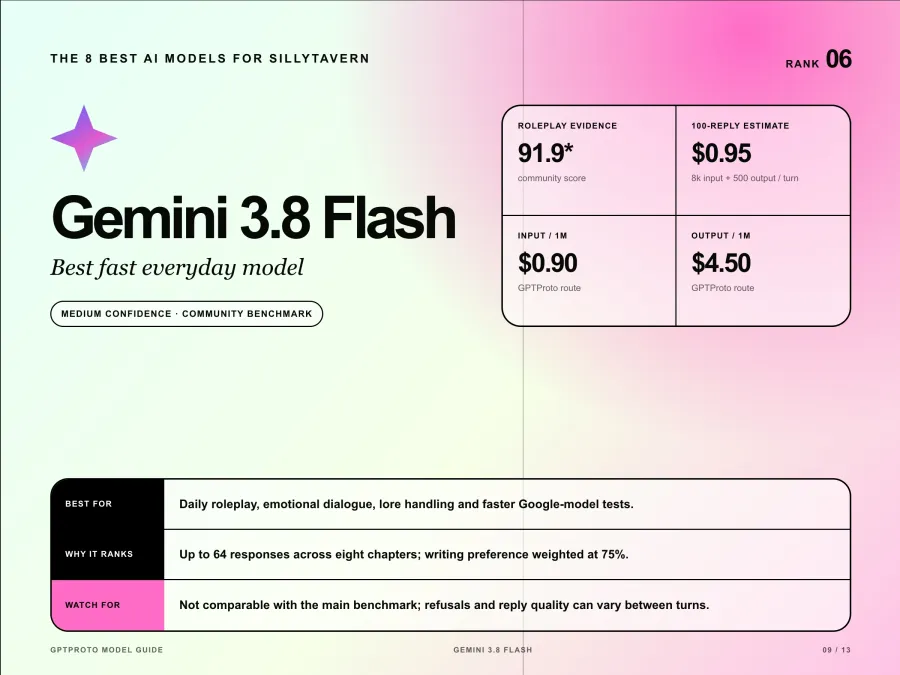
Community-Berichte loben zudem die emotionalen Dialoge, den Umgang mit Lore und den Konversationsrhythmus. Der Schwachpunkt ist die Konsistenz: Einige Nutzer berichten von zufälligen Verweigerungen oder ungleichmäßigen Antworten, selbst wenn die vorherigen Interaktionen gut funktionierten.
Verwenden Sie gemini-3.8-flash und beginnen Sie mit mittlerem „Thinking“. Die Kosten von 0,90 $ für Input und 4,50 $ für Output machen es deutlich günstiger als Argon, obwohl das feste Beispiel mit 100 Antworten immer noch etwa 0,95 $ kostet. Wählen Sie es, wenn Sie ein Google-Modell für den täglichen Gebrauch suchen, aber nicht bei jedem Schritt die Premium-Logik von Argon benötigen.
7 Claude Opus 5.5: Das beste Premium-Modell für Prosa
Claude Opus 5.5 ist die erste Wahl für Premium-Prosa, aber kein universeller Sieger. Nutzer, die es bevorzugen, verweisen auf das räumliche Bewusstsein, das Weltwissen, das Pacing und die Fähigkeit, eine Umgebung lebendig wirken zu lassen. Ein detaillierter SillyTavern-Community-Bericht empfiehlt es für allgemeines Story-Rollenspiel, wobei man das Modell wechseln sollte, wenn eine Szene eine andere Inhaltsverarbeitung erfordert.
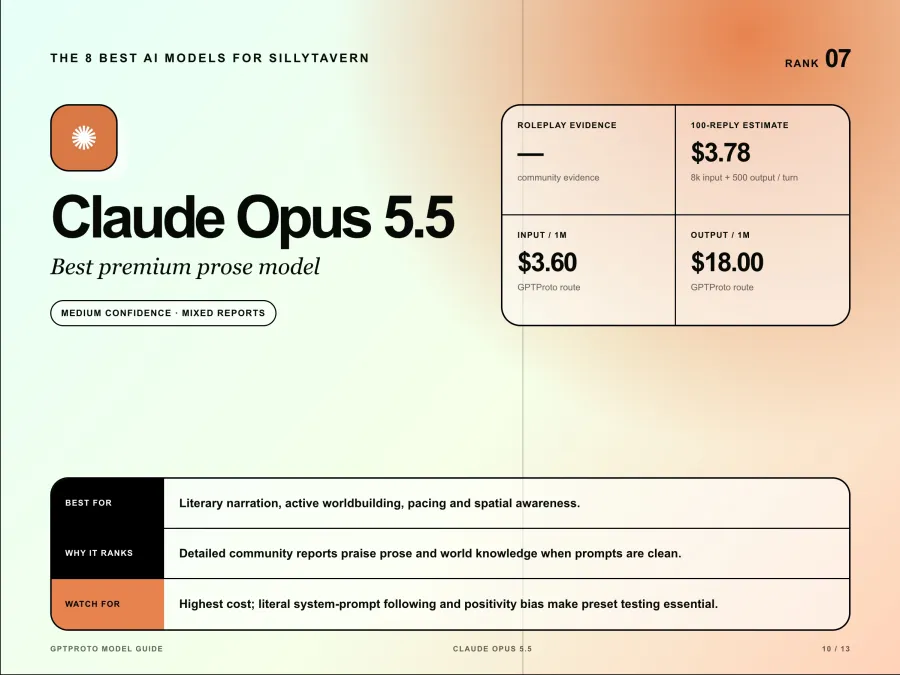
Andere Nutzer berichten, dass Opus große System-Prompts so wörtlich nimmt, dass widersprüchliche Anweisungen in einer Charakterkarte oder einem Preset den Charakter verzerren können. Ein Positivitäts-Bias ist ein weiterer wiederkehrender Kritikpunkt. Diese geteilte Meinung erklärt, warum ich es ohne Test der exakten Karte nicht über die Benchmark-Spitzenreiter stellen würde.
Der Preis ist der deutlichste Nachteil: 3,60 $ für Input und 18 $ für Output pro Million Token, oder etwa 3,78 $ im festen Beispiel mit 100 Antworten. Verwenden Sie claude-opus-5-5, starten Sie mit einem sauberen Prompt und entfernen Sie vererbte Preset-Regeln, die Sie nicht erklären können. Opus ist einen Test für literarische Erzählungen wert. Für beiläufige Chats mit hohem Volumen ist es schwer zu rechtfertigen.
8 GPT 6 Luna Bestes ultra-günstiges GPT-Modell
GPT-6 Luna ist der Grund, warum GPT in einem SillyTavern-Leitfaden nicht fehlen sollte, auch wenn es kein erstklassiges Rollenspiel-Modell ist. Luna erzielte insgesamt 71,1 Punkte, weit unter den vier Benchmark-Spitzenreitern, mit 68,3 für Begleiter, 60,0 für strikte Sprachausgabe und 54,2 für Robustheit. Seine Vorsicht riss es wiederholt aus der Fiktion heraus.
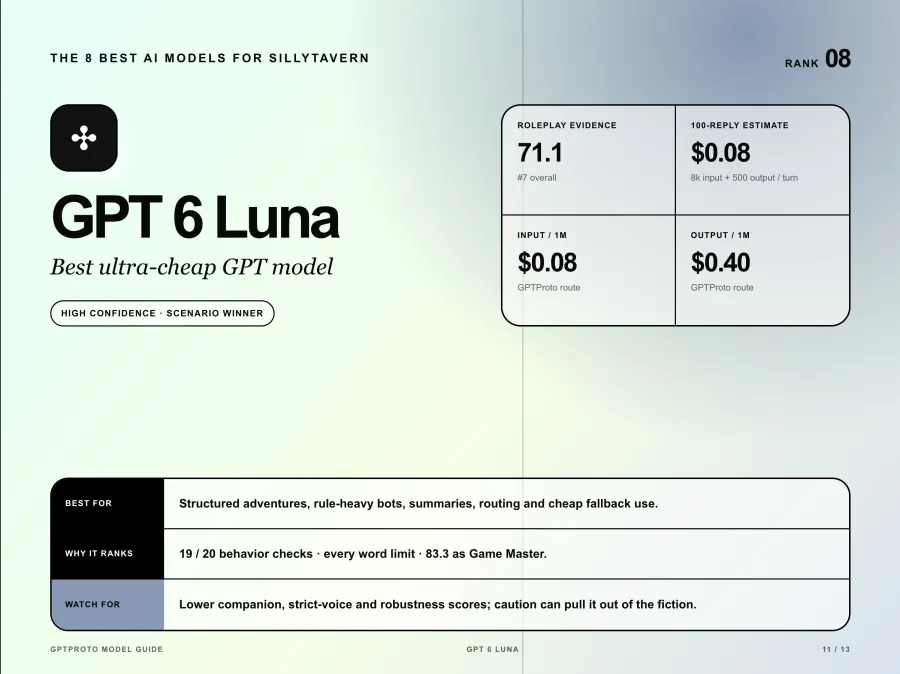
Die andere Hälfte des Ergebnisses ist nützlich. GPT-6 Luna bestand 19 von 20 Verhaltensprüfungen, hielt jedes getestete Wortlimit ein und erzielte 83,3 als Spielleiter. Bei 0,08 $ für Input und 0,40 $ für Output pro Million Token kostet das feste Beispiel mit 100 Antworten etwa acht Cent.
Verwenden Sie gpt-6-luna für strukturierte Abenteuer, regelintensive Bots, Zusammenfassungen, Routing oder als günstige Ausweichlösung. Wählen Sie es nicht gegenüber Kimi, GLM oder Gemini, wenn emotionale Immersion das Hauptziel ist. Dies ist ein Gewinner für Szenarien, keine versteckte Behauptung, dass das siebtplatzierte Modell des Benchmarks insgesamt das beste ist.
Warum es nicht mehr GPT-, Claude- und Gemini-Modelle gibt
Ein nützliches Ranking sollte nicht jedem Anbieter den gleichen Platz einräumen. Jedes zusätzliche Modell benötigt entweder starke Belege für Rollenspiele oder eine klar abgegrenzte Aufgabe.
| Modellfamilie |
Wahl der Hauptliste |
Weiteres Modell zum Testen |
Warum die Alternative nicht separat gelistet ist |
| GPT |
GPT-6 Luna |
GPT-6.1 Terra für 0,80 $ / 4,00 $ |
Terra hat eine attraktive Preisgestaltung und allgemeine Schreibfähigkeiten, aber noch keinen vergleichbaren Rollenspiel-Benchmark |
| Claude |
Claude Opus 5.5 |
Claude Sonnet 5.5 für 1,80 $ / 9,00 $ |
Es ist eine günstigere Claude-Option, aber die aktuellen RP-spezifischen Belege sind zu dünn für eine separate Auszeichnung als Gewinner |
| Claude |
Claude Opus 5.5 |
Claude Haiku 5.5 für 0,09 $ / 0,45 $ |
Haiku ist für leichtgewichtige Arbeiten mit hohem Volumen positioniert; der niedrige Preis allein begründet noch keine starke Prosa oder Konsistenz bei langen Sitzungen |
| Gemini |
Gemini 4 Argon und 3.8 Flash |
Gemini Flash Lite-Varianten |
Den günstigeren Lite-Modellen fehlen die gleichen RP-spezifischen Community-Belege |
| Kimi |
Kimi K3 |
Kimi K3.1 Pro für 2,00 $ / 10,00 $ |
Es ist neuer und vielversprechend, hat aber K3 im spezialisierten Benchmark noch nicht ersetzt |
Dies ist auch der Grund, warum GPT-6 Luna auf dem achten Platz rangiert, anstatt zu verschwinden. Es gibt Belege für eine spezifische Aufgabe. Terra könnte es später überholen, aber diese Behauptung jetzt aufzustellen, würde allgemeine Fähigkeiten mit getesteter Rollenspiel-Leistung vermischen.
Bestes lokales Modell für SillyTavern nach VRAM
SillyTavern lokal auszuführen bedeutet nicht, dass das Sprachmodell lokal ist. Das Frontend selbst hat bescheidene Anforderungen, während die lokale Inferenz genügend GPU-Speicher für die Modellgewichte und den Kontext-Cache benötigt. Die offizielle SillyTavern-Übersicht empfiehlt mindestens 6 GB VRAM als Ausgangspunkt für die lokale Inferenz.
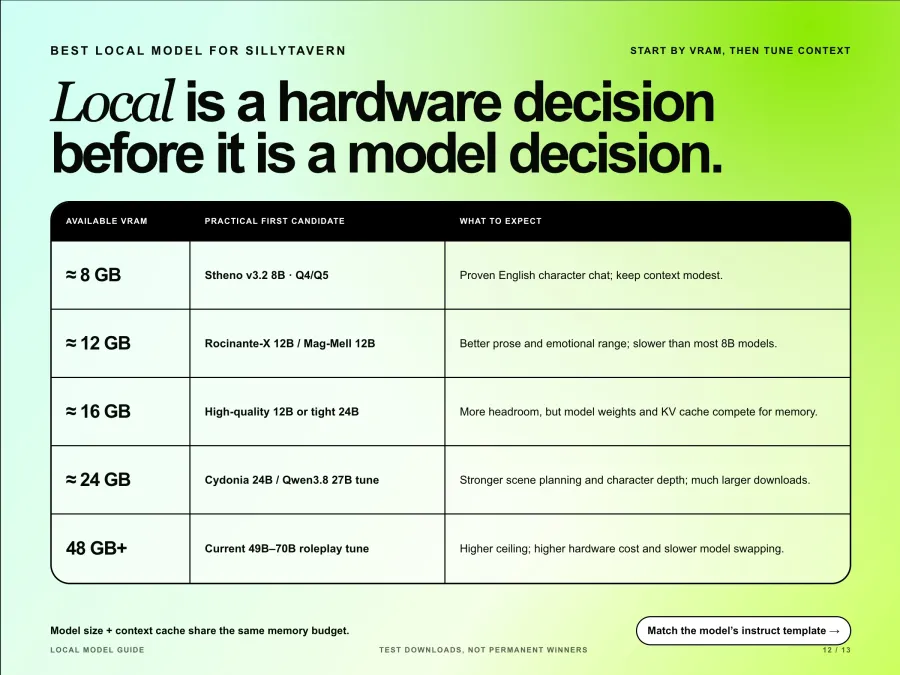
Empfehlungen für lokale Modelle ändern sich schnell, betrachten Sie diese also eher als erste Downloads zum Testen und nicht als dauerhafte Favoriten. Das aktuelle Hugging Face Rollenspiel-Modellverzeichnis enthält Tausende von Community-Varianten mit sehr unterschiedlichen Templates und Quantisierungen.
| Verfügbarer VRAM |
Praktischer erster Kandidat |
Was Sie erwartet |
| Etwa 8 GB |
Stheno v3.2 8B in Q4 oder Q5 |
Ein bewährter Einstiegspunkt für englischsprachige Charakter-Chats, aber der Kontext muss bescheiden bleiben |
| Etwa 12 GB |
Rocinante-X 12B oder Mag-Mell 12B |
Bessere Prosa und emotionalere Bandbreite als die meisten 8B-Modelle, bei langsamerer Generierung |
| Etwa 16 GB |
Ein hochwertigerer 12B-Quant oder ein 24B-Modell mit kurzem Kontext und teilweisem Offload |
Mehr Qualitätsspielraum, aber eine Modelldatei, die in den VRAM passt, garantiert nicht, dass ein großer KV-Cache hineinpasst |
| Etwa 24 GB |
Cydonia 24B oder ein Qwen3.8 27B Rollenspiel-Tune |
Bessere Szenenplanung und Charaktertiefe, bei deutlich größeren Downloads |
| 48 GB und mehr |
Ein aktueller 49B bis 70B Rollenspiel-Tune |
Höhere Obergrenze, aber hohe Hardwarekosten und deutlich langsameres Modell-Swapping |
Bei 8-GB-Karten ist der zentrale Kompromiss einfach: Modellgröße und Kontext konkurrieren um denselben Speicher. Beginnen Sie mit einem kleineren Kontext, bestätigen Sie die Charakterstimme und erhöhen Sie dann das Limit, während Sie VRAM und Generierungsgeschwindigkeit im Auge behalten.
Wählen Sie für lokale Text-Completion-Backends das tatsächliche Instruct-Template des Modells. Die Instruct-Modus-Dokumentation von SillyTavern warnt, dass das gewählte Template mit dem vom Modell erwarteten Format übereinstimmen muss. Ein starkes Fine-Tune mit dem falschen Template kann schlechter aussehen als ein kleineres Modell, das korrekt konfiguriert ist.
Bestes Modell für langfristiges Rollenspiel
Kimi K3 ist die evidenzbasierte, stärkste Wahl für langfristige Charakterkontinuität, während DeepSeek V4.1 Flash die wirtschaftlichere Wahl ist, wenn der Verlauf kostspielig wird. Gemini 4 Argon ist für umfangreiche Lorebooks attraktiv, aber ein Fenster von einer Million Token sollte nicht mit zuverlässigem Gedächtnis verwechselt werden.
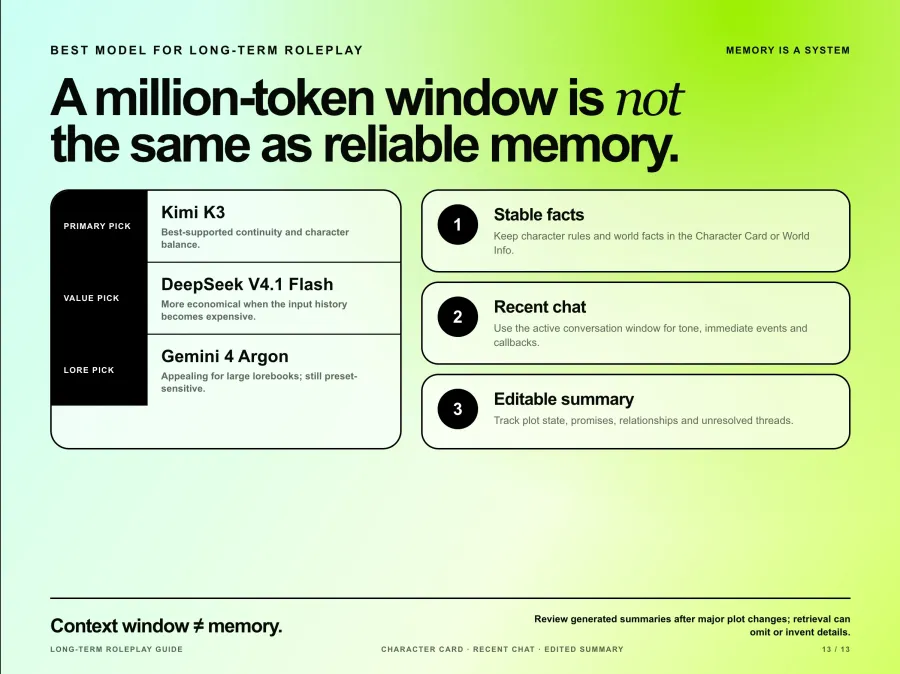
Die Kontext-Dokumentation von SillyTavern erklärt, dass nur Nachrichten innerhalb des aktiven Kontextbereichs an das Modell gesendet werden. Charakterinformationen, System-Prompts, World Info, Zusammenfassungen und der Antwortbereich verbrauchen alle dasselbe Budget. Sobald alte Nachrichten aus diesem Bereich herausfallen, kann das Modell sie nicht mehr abrufen, es sei denn, Sie fügen die relevanten Fakten erneut ein.
Verwenden Sie drei Ebenen, anstatt sich nur auf die Kontextgröße zu verlassen:
Bewahren Sie stabile Charakterfakten und Weltregeln in der Charakterkarte oder in der World Info auf.
Nutzen Sie den aktuellen Chatverlauf für den Tonfall und unmittelbare Ereignisse.
Pflegen Sie eine kurze, bearbeitbare Zusammenfassung für den Handlungsstatus, Beziehungen, Versprechen und ungelöste Handlungsstränge.
Die Summarize-Erweiterung kann die dritte Ebene automatisieren, aber ihre eigene Dokumentation warnt davor, dass vom Modell generierte Zusammenfassungen Details auslassen oder erfinden können. Überprüfen Sie die Zusammenfassung nach größeren Handlungsänderungen. Chat-Vektorisierung ist experimentell und kann den Abruf weniger effektiv machen, daher sollte sie getestet werden, anstatt blind darauf zu vertrauen.
So wechseln Sie Modelle in SillyTavern
Das Wechseln löscht den Chat nicht, kann aber Stimme, Formatierung, Verweigerungsverhalten und die Interpretation früherer Nachrichten verändern. Speichern Sie ein separates Preset für jede Modellfamilie, anstatt ein Preset für GPT, Claude, Gemini und lokale Textvervollständigungsmodelle zu erzwingen.
Für GPT Proto ist die Kurzeinrichtung wie folgt:
Öffnen Sie API Connections in SillyTavern.
Wählen Sie Chat Completion und Custom OpenAI compatible.
Setzen Sie die Base URL auf https://gptproto.com/v1. Hängen Sie nicht /chat/completions an; SillyTavern fügt dies hinzu.
Fügen Sie den API-Schlüssel ein und geben Sie eine exakte Modell-ID ein, wie z. B. kimi-k3, glm-5.3-flash oder gemini-3.8-flash.
Beginnen Sie mit der Einstellung Prompt Post-Processing auf None, verbinden Sie sich und führen Sie Test Message aus.
Der illustrierte SillyTavern API-Integrationsleitfaden behandelt Installation, Charakterkarten, Screenshots und häufige Verbindungsfehler.
Wenn Sie denselben Schlüssel und dasselbe Modell außerhalb von SillyTavern verifizieren möchten, verwendet diese Anfrage die identische OpenAI-kompatible Route:
export GPTPROTO_API_KEY="IHR_SCHLUESSEL"

curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3",
    "messages": [
      {"role": "user", "content": "Antworte im Charakter mit einem kurzen Satz."}
    ],
    "max_tokens": 120
  }'
Testen Sie nach dem Wechsel mindestens fünf Runden mit derselben Charakterkarte. Fügen Sie eine kurze Antwort, einen Off-Topic-Prompt, eine Anweisung zur Antwortlänge und einen Rückbezug auf ein früheres Detail ein. Das deckt mehr Probleme auf, als nur die erste Nachricht zu beurteilen.
Welches SillyTavern-Modell sollten Sie wählen?
Wählen Sie Kimi K3, wenn Sie einen bewährten Standard suchen.
Wählen Sie Gemini 4 Argon für komplexe Lore und immersive Szenenentwicklung, wenn Sie höhere Kosten und eine geringere Benchmark-Sicherheit in Kauf nehmen.
Wählen Sie GLM-5.3, wenn Sie einen starken Geschichtenerzähler zu einem mittleren Preis wünschen.
Wählen Sie DeepSeek V4.1 Flash für erschwingliche lange Sitzungen und disziplinierte Ausgaben.
Wählen Sie GLM-5.3 Flash für kostengünstige RPG-Erzählungen und strikte Charakterstimmen.
Wählen Sie Gemini 3.8 Flash für ein schnelleres, günstigeres Gemini mit vielversprechenden Community-Tests.
Wählen Sie Claude Opus 5.5, wenn die Qualität der Prosa die Kosten rechtfertigt.
Wählen Sie GPT-6 Luna für das günstigste strukturierte RP, Zusammenfassungen oder als Fallback-Option.
Wählen Sie ein lokales Roleplay-Fine-Tune, wenn Datenschutz, Offline-Nutzung und unbegrenzte Generierung wichtiger sind als die Einrichtungszeit und die Qualität von Cloud-Modellen.
Sie können aktuelle Nutzungssignale und Modellpreise auf der GPT Proto SillyTavern-Modellseite vergleichen und dann denselben Charakter und Verlauf über die Roleplay-API-Spielwiese mit verschiedenen Modellen testen.