Kimi K3.1 Pro vs. Opus 5.5 im Überblick
| Punkt |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Offizieller Preis für Input / Output pro 1 Mio. Token |
$2 / $10 |
$4 / $20 |
| GPT Proto Preis für Input / Output pro 1 Mio. Token |
$2 / $10 |
$3,60 / $18 |
| Kontextfenster |
Ca. 1 Mio. Token |
1 Mio. Token |
| Modell-Input / -Output |
Text und Bilder / Text |
Text und Bilder / Text |
| Standard-Reasoning-Aufwand der nativen API |
Max |
Mittel |
| Meine Empfehlung für den ersten Test |
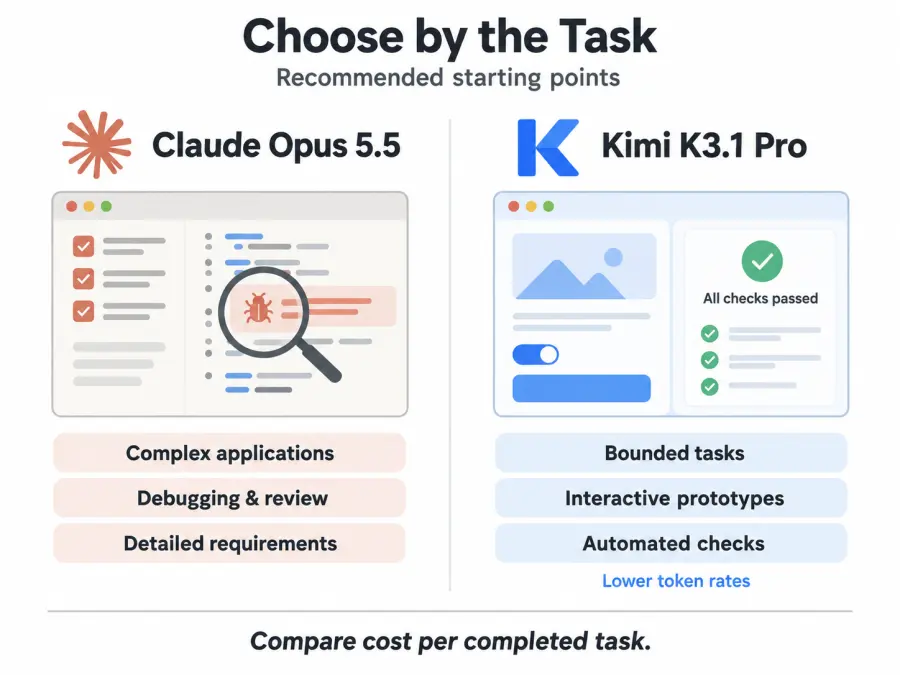
Abgegrenzte Aufgaben mit klaren Prüfkriterien |
Komplexe Entwicklung und abschließende Überprüfung |
Die Preise wurden am 29. Oktober 2026 überprüft. Die offiziellen Spezifikationen stammen aus der Kimi API-Dokumentation und der Claude Modell-Dokumentation. Die GPT Proto-Tarife sind auf der Kimi K3.1 Pro API-Seite und der Claude Opus 5.5 API-Seite aufgeführt. Cache-Operationen und andere anfallende Gebühren müssen separat abgerechnet werden.
Für einen schnellen Katalogvergleich nutzen Sie die Kimi K3.1 Pro vs. Claude Opus 5.5 Vergleichsseite. Hintergrundinformationen zu diesem Kimi-Release finden Sie unter was sich bei Kimi K3.1 Pro geändert hat.
Was uns Benchmarks über Programmierung verraten – und was sie verschweigen
Moonshots veröffentlichter Vergleich zum Launch berichtet von 65,7 % für Kimi K3.1 Pro und 66,4 % für Opus 5.5 im Terminal-Bench 4.0. Dies sind vom Anbieter veröffentlichte Zahlen, die noch einer unabhängigen Überprüfung dieses spezifischen Vergleichs bedürfen. Sie stützen die Annahme, dass Kimi für terminalbasierte Arbeiten ernst zu nehmen ist; sie belegen jedoch keine gleichwertige Leistung bei der Anwendungsentwicklung.
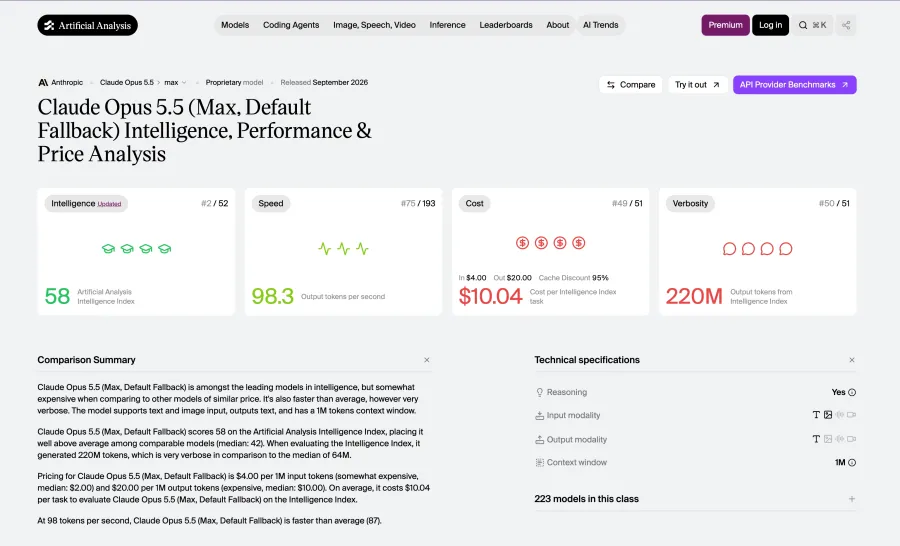
Das breitere, unabhängige Bild sieht anders aus. Am 29. Oktober zeigten die Modellseiten des Artificial Analysis Intelligence Index v5.0 Kimi bei 46 und Opus bei 58, wobei letzteres als „Max with Default Fallback“ gekennzeichnet war. Diese Indexwerte sind keine Prozentzahlen oder Erfolgsquoten für Programmierung. Behalten Sie die Indexversion und die Konfiguration immer im Zusammenhang mit dem Vergleich im Auge.
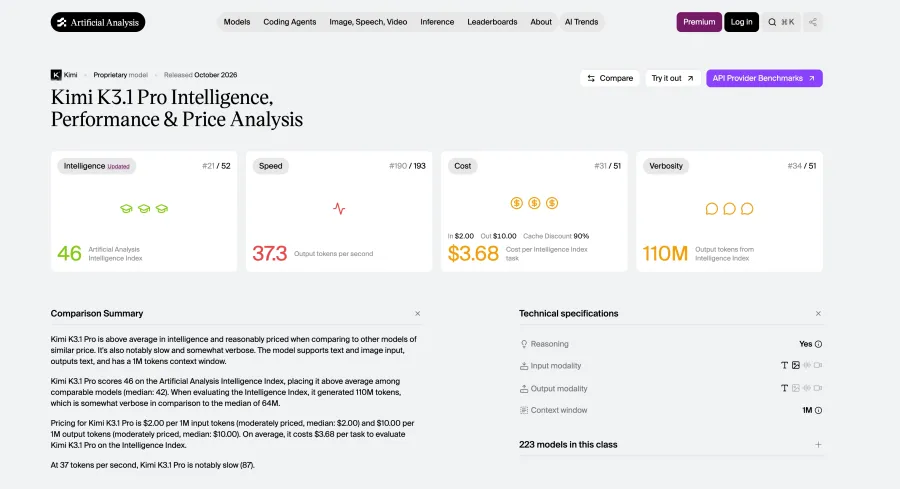
Ich würde Opus als anfängliche Qualitäts-Baseline für anspruchsvolle Arbeiten betrachten und dann testen, ob Kimi dieselben Akzeptanzkriterien zu geringeren Kosten erfüllt. Ein Terminal-Benchmark kann Ihnen nicht sagen, ob ein Buchungsformular seinen Status beibehält oder ein Dashboard auf Mobilgeräten lesbar bleibt. Das müssen Ihre Anwendungstests beantworten.
Frontend-Programmierung: Vom Screenshot zur funktionierenden Schnittstelle
Bei einer Screenshot-zu-Interface-Aufgabe sollten Sie das Erscheinungsbild vom Verhalten trennen. Ein originalgetreues Layout benötigt dennoch eine funktionierende Navigation, Formularzustände, Tastaturzugriff und eine nutzbare mobile Version. Bitten Sie anschließend um eine Änderung. Das Hinzufügen eines Filters, ohne das bestehende Layout zu zerstören, ist ein anderer Test als das Generieren einer neuen Seite.
Hier gibt es ein nützliches Entwicklerbeispiel. In Melvynx' veröffentlichtem Vergleich bevorzugte er Opus' visuelle Umsetzung eines Zeitzonen-Checkers. Das ist ein ästhetisches Urteil über einen einzelnen Build und keine gemessene Erfolgsquote für Frontend-Aufgaben.
Für eine Marketing-Website oder ein kundenorientiertes Dashboard wäre meine erste Wahl Opus, wenn das Design eine klare Differenzierung und wiederholte Verfeinerung erfordert. Kimi ist ein sinnvoller Kandidat für interne Schnittstellen mit einem klaren Designsystem, insbesondere wenn Sie das Ergebnis vor der Veröffentlichung überprüfen können. Der Kompromiss liegt in der Zeit, die für die Korrektur dessen aufgewendet wird, was der ursprüngliche Prompt offen lässt.
Betrachten Sie eine Buchungsschnittstelle als Evaluierungsaufgabe. Geben Sie beiden Modellen dasselbe Referenzbild, die vorhandene Komponentenbibliothek und Anforderungen für die Datumsauswahl, nicht verfügbare Zeitfenster, Validierung und Bestätigung. Bitten Sie beide, die Schnittstelle mit derselben Mock-API zu verbinden. Führen Sie dann eine fehlgeschlagene Anfrage ein und prüfen Sie, ob der Benutzer den Vorgang wiederherstellen kann, ohne das Formular zu verlieren.
Dieser letzte Schritt macht es zu einem Vergleich von Anwendungen. Er zeigt auf, ob eine attraktive Seite auch die nächste Aktion des Kunden korrekt handhabt.
Interaktive Apps und 3D: Visuelle Qualität, Logik und Laufzeitleistung
Kimis Fall wird bei interaktiven visuellen Arbeiten interessanter. Melvynx' Lavalampen-Beispiel enthielt Licht- und Farbsteuerungen. Er bewertete das aufwendigere Ergebnis von Opus als am besten, fand aber auch Kimis Materialien und Glaseffekte überzeugend. Seine berichteten Laufzeitkosten beliefen sich auf 2,30 $ für Kimi High und 4,16 $ für Max, gegenüber 4,35 $ für Opus Medium und 6,39 $ für Extra High.
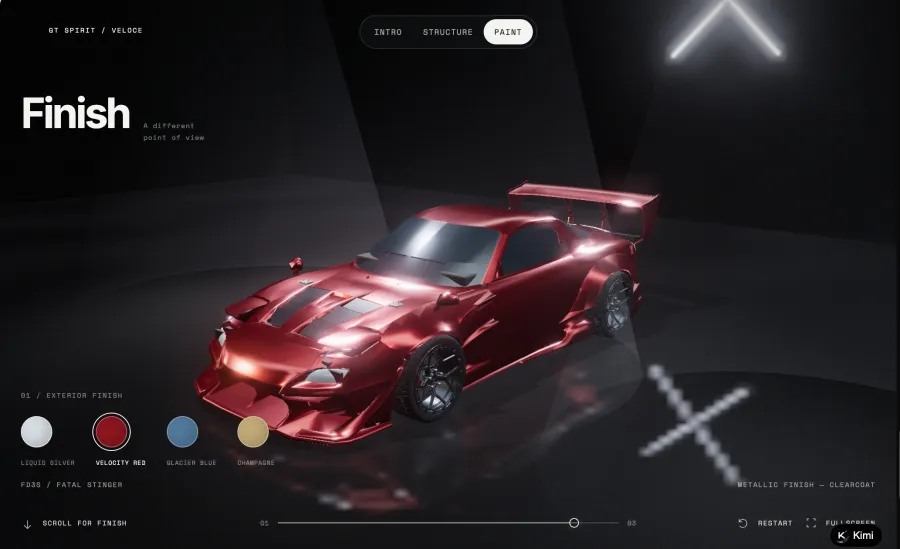
Derselbe Bericht beschreibt eine Crash-Simulation, die bei Kimi High besser funktionierte als bei Max. Der Autor legt einen Kimi-Affiliate-Link und einen gemeinsam genutzten, nicht isolierten Arbeitsbereich offen. Diese Beispiele sind nützliche Beobachtungen, jedoch mit den genannten Einschränkungen.
Meiner Ansicht nach lohnt es sich, Kimi für Produktkonfiguratoren, Bildungs-Demos und visuelle Prototypen zu testen. Die automatische Wahl einer Einstellung mit höherem Aufwand würde eine der praktischen Lektionen dieser Beispiele verpassen. Beginnen Sie mit einer expliziten Anforderung und überprüfen Sie das Artefakt.
Definieren Sie für einen Möbelkonfigurator, was sich ändern muss, wenn jemand ein Material auswählt, die Kameraansicht wechselt oder das Design zurücksetzt. Prüfen Sie, ob der angezeigte Preis mit der Auswahl übereinstimmt. Laden Sie die Seite neu. Testen Sie die Steuerung auf einem Smartphone. Ein optisch ansprechender Stuhl ist nur ein Teil des Lieferumfangs.
Technische Genauigkeit erfordert eigene Prüfungen. Moonshots BenchCAD-Ergebnisse berichten von 92,7 % für Kimi und 96,2 % für Opus mit Tools, unter Verwendung einer Metrik zur Geometrierekonstruktion. Dieses vom Anbieter veröffentlichte Ergebnis beantwortet eine andere Frage, als ob eine Szene attraktiv aussieht. Eine überzeugende Animation erfordert dennoch eine separate Validierung, bevor Sie sie verwenden, um Physik zu lehren oder einen technischen Prozess darzustellen.
Für einen Prototyp würde ich zuerst Kimi testen. Für eine präzisionskritische Anwendung würde ich mit Opus beginnen und domänenspezifische Prüfungen verlangen, unabhängig davon, welches Modell den Code generiert.
Agentische Entwicklung: Kann das Modell eine mehrstufige Aufgabe abschließen?
Ein Agent, der in einem Repository arbeitet, muss das bestehende Verhalten verstehen, die zu ändernden Dateien auswählen, Tools ausführen, Fehler interpretieren und entscheiden, wann er aufhören muss. Zwischen diesen Schritten können sich Fehler anhäufen.
Beide Anbieter veröffentlichen Beispiele für umfangreiche Arbeiten. Moonshot beschreibt, wie Kimi einen Simulator diagnostiziert und korrigiert, bevor ein Geh-Controller neu trainiert wird. Der Opus 5.5-Startbericht von Anthropic beschreibt Verbesserungen an einer Webanwendung, einschließlich einer Ladezeit-Aufgabe, die in 39 von 40 Versuchen erfolgreich abgeschlossen wurde. Dies sind separate Beispiele der Anbieter und kein gemeinsamer direkter Vergleich.
Für eine bestehende Rechnungsanwendung wäre ein nützlicher Vergleich das Hinzufügen von CSV-Importen. Dies erfordert Feldzuordnung, Fehlerbehandlung für ungültige Zeilen, Duplikaterkennung, eine Vorschau und Tests, die das bestehende Verhalten abdecken. Lassen Sie jedes Modell mit demselben Repository-Snapshot arbeiten und prüfen Sie beide Patches. Eine Zusammenfassung mit der Aussage „alle Tests bestanden“ erfordert ein entsprechendes Testprotokoll als Beleg.
Für diese Art von dateiübergreifenden Änderungen wäre Opus mein Standard-Ausgangspunkt. Kimi lässt sich bei einem begrenzten Teil der Aufgabe leichter bewerten, etwa bei der Implementierung einer Validierung anhand eines vereinbarten Schemas. Erweitern Sie den Umfang, nachdem die Tests bestätigt haben, dass es mit der umgebenden Anwendung umgehen kann.
Auch die Konfiguration spielt eine Rolle. Kimis Anleitung zur Tool-Nutzung erfordert die Beibehaltung der vollständigen Assistentennachricht über mehrere Turns hinweg. Claudes Opus-Dokumentation beschreibt modellspezifisches Denken und Tool-Verhalten. Überprüfen Sie diese Details für Ihren gewählten Weg; die Übereinstimmung mit einem grundlegenden Anfrageformat bedeutet nicht, dass das Agentenverhalten identisch ist.
Preise und Kosten: Was kostet ein akzeptiertes Ergebnis tatsächlich?
Kimi K3.1 Pro hat die niedrigeren Standard-Input- und Output-Raten. Die schwierigere Frage ist, wie viele Aufrufe, Wiederholungen und Überprüfungszyklen Ihre Aufgabe erfordert.
Hier ist ein Planungsbeispiel unter Verwendung der aufgeführten Raten von GPT Proto. Nehmen wir an, jeder Versuch verbraucht 1 Mio. nicht zwischengespeicherte Input-Token und 200.000 abgerechnete Output-Token. Dies sind hypothetische Volumina, keine beobachteten Anwendungsergebnisse.
| Planungsszenario |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Ein Versuch bei den angegebenen Volumina |
$4.00 |
$7.20 |
| Zwei Versuche, jeweils bei gleichem Volumen |
$8.00 |
$14.40 |
Unter diesen Annahmen kostet ein Kimi-Ergebnis, das zwei Versuche erfordert, mehr Token als ein Opus-Ergebnis, das nach einem Versuch akzeptiert wird. Echte Wiederholungen wiederholen selten exakt die gleichen Token-Volumina, verwenden Sie daher Ihre Nutzungsaufzeichnungen für die tatsächliche Berechnung.
Caching verändert den Vergleich erneut. Beide Anbieter führen offizielle Cache-Lesezugriffe mit $0,20 pro 1 Mio. Token in ihrer Kimi- und Claude-Dokumentation auf. Eine lange Agentensitzung mit vielen Cache-Treffern hat ein anderes Kostenverhältnis als eine neue Anfrage. Überprüfen Sie auch die Gebühren für das Schreiben in den Cache, die Output-Nutzung und die tatsächlichen Raten Ihres Anbieters.
Für ein Team würde ich die Kosten pro akzeptierter Aufgabe zusammen mit der verstrichenen Zeit und den Minuten für die Überprüfung verfolgen. Ein günstigerer Entwurf kann ein gutes Preis-Leistungs-Verhältnis bieten, wenn die Überprüfung schnell geht. Er wird weniger attraktiv, wenn ein Entwickler rekonstruieren muss, was der Agent geändert hat, bevor er ihm vertrauen kann.
So vergleichen Sie beide Modelle in Ihrer eigenen App über GPT Proto
Nutzen Sie eine kleine Anwendungsänderung mit beobachtbaren Ergebnissen. Ein Buchungsformular, ein CSV-Importer oder ein Produktkonfigurator liefern Ihnen nützlichere Erkenntnisse als eine allgemeine Aufforderung, „etwas Beeindruckendes zu bauen“.
Öffnen Sie die Kimi-Modellseite und die Opus-Modellseite. Verwenden Sie „Try this model“ (Modell ausprobieren) und „Quick Start“ (Schnellstart), um den Integrationsleitfaden zu erhalten, und kopieren Sie dann die Markdown-Anweisungen in Ihren Coding-Assistenten. Bewahren Sie Ihren API-Schlüssel in einer lokalen Umgebungsvariablen oder einer serverseitigen Konfiguration auf.
Bevor Sie die Entwicklungsqualität bewerten, prüfen Sie, ob beide Modellrouten antworten. Dieses Verbindungsbeispiel folgt dem auf den Modellseiten veröffentlichten Chat-Completions-Format. Setzen Sie GPTPROTO_API_KEY lokal, bevor Sie es ausführen; die Anfragen verbrauchen kostenpflichtige Token.
for model in kimi-k3.1-pro claude-opus-5-5; do
  curl --fail-with-body --silent --show-error --max-time 180 \
    https://gptproto.com/v1/chat/completions \
    -H "Authorization: Bearer $GPTPROTO_API_KEY" \
    -H "Content-Type: application/json" \
    --data "{
      \"model\": \"$model\",
      \"messages\": [{\"role\": \"user\",
        \"content\": \"Return only: API connection OK\"}]
    }"
done
Dies überprüft die Konnektivität, nicht die Coding-Qualität. Die nativen APIs haben unterschiedliche Standardeinstellungen für das Reasoning; konfigurieren und protokollieren Sie die unterstützten Aufwandseinstellungen vor einem Anwendungsvergleich. Eine API-Antwort benötigt zudem einen Agenten oder eine Anwendung, um Dateien zu bearbeiten, Tools auszuführen und einen Browser zu inspizieren.
Starten Sie für den Entwicklungstest jedes Modell von einer sauberen Kopie desselben Projekts aus. Geben Sie dieselbe Aufgabe, Berechtigungen, Abhängigkeiten und Abnahmetests vor. Protokollieren Sie die Modellroute, den Aufwand, die abgerechnete Nutzung, die Fertigstellungszeit und die erforderlichen manuellen Änderungen. Wiederholen Sie die Aufgabe, bevor Sie einen kleinen Unterschied zu Ihrem Produktionsstandard machen.
Wenn der Endpunkt einen Authentifizierungsfehler zurückgibt, überprüfen Sie den Schlüssel und den Autorisierungs-Header. Wenn ein optionaler Parameter abgelehnt wird, vergleichen Sie ihn mit dem aktuellen Leitfaden auf der Modellseite. Stellen Sie sicher, dass eine erfolgreiche Antwort die beabsichtigte Modellausgabe enthält, bevor Sie den Auftrag erweitern.
Welches Modell sollten Sie wählen?
| Ihr Arbeitsaufwand |
Meine erste Wahl |
Bedingung für die Beibehaltung |
| Kundenorientiertes Frontend mit wiederholten Designänderungen |
Opus 5.5 |
Bessere akzeptierte Ergebnisse rechtfertigen die Kosten |
| Interaktiver Prototyp oder visuelles Experiment |
Kimi K3.1 Pro |
Steuerelemente funktionieren und das Artefakt ist leicht zu prüfen |
| Komplexe Änderungen in einer bestehenden Anwendung |
Opus 5.5 |
Repository-Tests und Review-Unterstützung bestätigen die Wahl |
| Wiederholte Implementierung gemäß einer festen Spezifikation |
Kimi K3.1 Pro |
Automatisierte Prüfungen halten die Korrekturkosten niedrig |
| Präzisionssensibler Code oder Simulation |
Opus als anfängliche Basis |
Für beide Modelle ist eine externe Validierung erforderlich |
Ich würde Opus 5.5 als anfänglichen Standard für ein Team wählen, das einem Agenten umfangreiche Anwendungsaufgaben überträgt. Die breitere Bewertungsgrundlage spricht dafür, dort zu beginnen, während das tatsächliche Repository entscheidet, ob sich die Premium-Kosten lohnen.
Kimi K3.1 Pro ist ein praktischer Kandidat, um die Kosten für klar definierte Aufgaben zu senken. Beginnen Sie mit Aufgaben, die Sie prüfen oder testen können, messen Sie die akzeptierten Ergebnisse und übertragen Sie dem Modell mehr Verantwortung, sobald sich die Ergebnisse verbessern. Das ist ein stärkerer Grund für einen Wechsel als ein nahezu unentschiedenes Ergebnis bei einem einzelnen Benchmark.
Probieren Sie eine kleine Aufgabe auf den Seiten der Kimi K3.1 Pro API und der Claude Opus 5.5 API aus, nutzen Sie die Integrationsleitfäden und vergleichen Sie das Ergebnis, das Ihre Anwendung akzeptieren kann.