OpenAI API-Alternativen im Überblick
| Alternative |
Beste Eignung |
Zugriffsansatz |
Wichtigster Migrationsaspekt |
| GPT Proto |
Mehrere Modellfamilien und rabattierter Zugriff |
Vereinheitlichte Modellplattform |
Funktionen für das gewählte Modell und den Endpunkt bestätigen |
| Anthropic Claude |
Coding- und Agenten-Workflows |
Direkte Modell-API |
Native Claude-Funktionen und SDK-Kompatibilität unterscheiden sich |
| Google Gemini |
Multimodale Anwendungen |
Direkte Modell-API |
Erweiterte Funktionen erfordern möglicherweise eine Gemini-native Integration |
| DeepSeek |
Budgetorientierte Reasoning-Workloads |
Direkte Modell-API |
Cache sowie Preise für Spitzen- und Nebenlastzeiten berücksichtigen |
| Groq |
Geschwindigkeitssensible Anwendungen |
Gehostete Inferenz |
Unterstützte Modell- und Funktionskombination evaluieren |
| Mistral |
Dokumentenzentrierte Anwendungen |
Modelle plus Dokumenten-APIs |
OCR, Konversationsstatus und Inferenz sind separate Aspekte |
| OpenRouter |
Modell-Exploration und Provider-Routing |
Multi-Provider-Gateway |
Routing-Anforderungen festlegen und Plattformgebühren einplanen |
Wie wir diese OpenAI API-Alternativen verglichen haben
Dieser von GPT Proto veröffentlichte Vergleich basiert auf offizieller Dokumentation, öffentlichen Preislisten und dokumentierten Anwendungsfunktionen, die am 29. Oktober 2026 überprüft wurden. Die Empfehlungen sind redaktionelle Einschätzungen zur Eignung für Workflows; es wurden keine privaten Performance-Benchmarks zwischen den Anbietern durchgeführt. Wir unterscheiden zwischen direkten Modell-APIs, Gateways und Inferenzdiensten, da sie unterschiedliche Teile eines OpenAI-Setups ersetzen.
Die 7 besten OpenAI API-Alternativen
1. GPT Proto für Multi-Modell-Zugriff und rabattierte Preise
GPT Proto eignet sich für SaaS-Teams, deren Produkt mehrere Modelle benötigt: eines für den routinemäßigen Support, ein weiteres für schwieriges Coding und vielleicht separate Optionen für die Bild- oder Videogenerierung. Der Modellkatalog bündelt Text-, Bild-, Video- und Audio-Optionen unter einem Konto, einem API-Schlüssel und einem gemeinsamen Guthaben.
Dies unterstützt eine schrittweise Migration. Behalten Sie die GPT-Anfragen bei, die bereits funktionieren, verlagern Sie eine definierte Aufgabe auf Claude oder DeepSeek und vergleichen Sie die Ergebnisse, bevor Sie den Rest der Anwendung umstellen. Ein gemeinsames Konto reduziert den Aufwand für Abrechnung und Anmeldedaten, der mit dieser Evaluierung verbunden ist.
Es gibt auch eine unkomplizierte Option für Teams, die GPT beibehalten möchten. Die GPT-6.1 Sol API-Seite listet 1,60 $ für Input und 8 $ für Output pro Million Token auf, verglichen mit den Standardpreisen von OpenAI von 2 $ bzw. 10 $. Das entspricht einer Reduzierung dieser Token-Preise um 20 %. Claude Sonnet 5.5 wird mit 1,80 $ und 9 $ gelistet, was 10 % unter den entsprechenden Standardpreisen von Anthropic liegt.
Wählen Sie GPT Proto, wenn die Modellauswahl und ein konsolidierter Zugriff Priorität haben. Überprüfen Sie den Abschnitt zur API-Nutzung des ausgewählten Modells auf unterstützte Schnittstellen und Felder; ein gemeinsamer Schlüssel macht nicht jedes Modell oder jeden Medien-Endpunkt austauschbar. Das Beibehalten von GPT über einen anderen Anbieter bewahrt zudem die Abhängigkeit von der GPT-Modellfamilie.
2. Anthropic Claude für Coding- und Agent-Workflows
Claude gehört in die engere Wahl, wenn die Anwendung den Großteil ihrer Zeit mit dem Bearbeiten von Code, dem Analysieren von Dokumenten oder der Entscheidung verbringt, welches Tool als Nächstes verwendet werden soll. Beginnen Sie mit Sonnet für alltägliche Coding- und Agent-Aufgaben, evaluieren Sie Opus für anspruchsvollere Aufgaben und ziehen Sie Haiku für repetitive Klassifizierungen, Extraktionen oder Routings in Betracht.
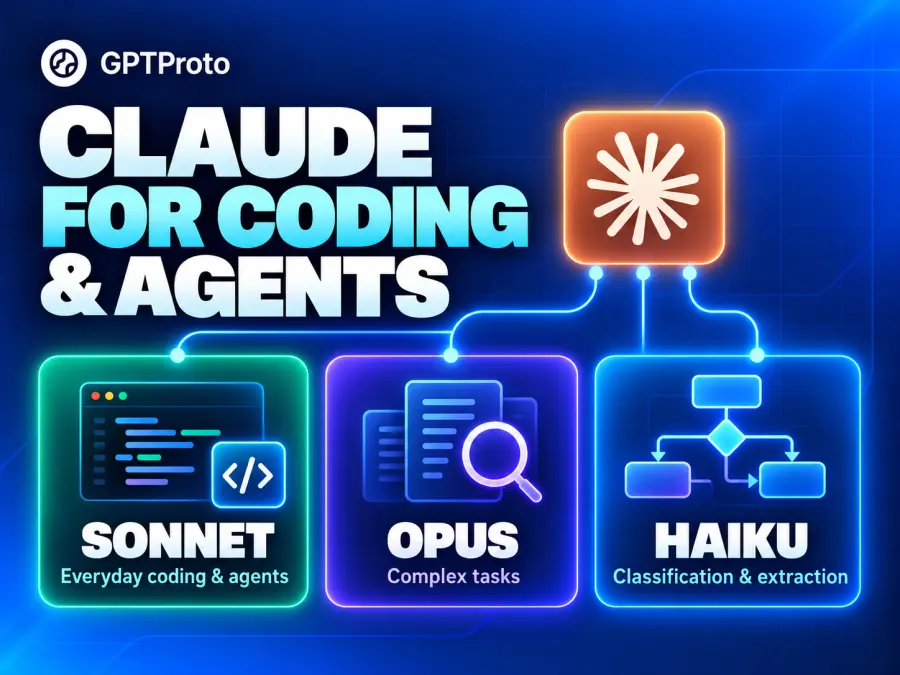
Ein Support-Agent könnte beispielsweise ein leichtgewichtiges Modell verwenden, um Anfragen zu kategorisieren, und ein leistungsfähigeres Modell für die Untersuchung komplexer technischer Probleme reservieren. Die Modellpreise von Anthropic machen diese Stufen transparent: Sonnet 5.5 kostet 2 $ für Input und 10 $ für Output pro Million Token, während Haiku 5.5 bei 0,10 $ bzw. 0,50 $ für Prompts bis zu 100.000 Input-Token beginnt.
Die Migration erfordert Aufmerksamkeit bei der Schnittstelle. Die Dokumentation zur OpenAI SDK-Kompatibilität von Anthropic besagt, dass die Kompatibilitätsschicht das Tool-Schema-Feld strict ignoriert. Anwendungen, die auf einer strikten Validierung basieren, sollten die Unterstützung für strukturierte Ausgaben der nativen Claude-API evaluieren.
Nutzen Sie die Claude-Modellsammlung auf GPT Proto, um verfügbare Routen zu vergleichen. Claude ist eine fähigkeitsorientierte Alternative; die Wahl von Sonnet zum offiziellen Standardtarif senkt die Rechnung im Vergleich zu GPT-6.1 Sol nicht automatisch.
3. Google Gemini für multimodale Anwendungen
Gemini ist ein nützlicher Kandidat für Produkte, die Text mit Screenshots, aufgezeichnetem Audio, Video oder Dokumenten kombinieren. Eine Lern-App, die die Aufnahme eines Schülers überprüft, oder ein Support-Tool, das Bildschirmaufnahmen interpretiert, benötigen mehr als nur reine Texterstellung.
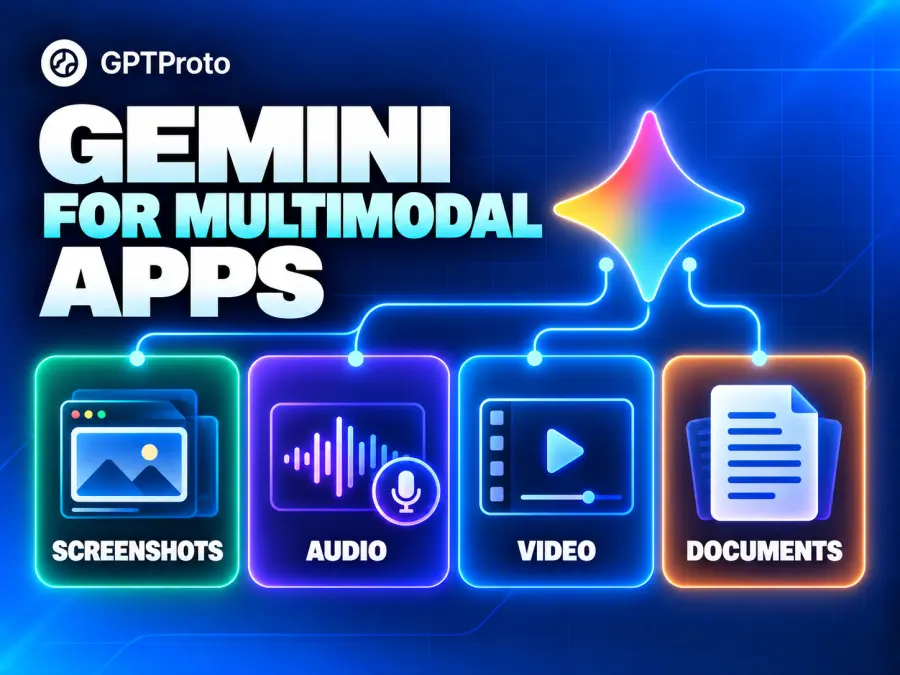
Google dokumentiert die OpenAI SDK-Kompatibilität, einschließlich der Änderung der Basis-URL, des Schlüssels und des Modells für unterstützte Anfragen. Das kann eine erste Evaluierung vereinfachen. Der Integrationsleitfaden erklärt zudem, dass fortgeschrittene Gemini-Funktionen und serverseitige Tools möglicherweise eine zusätzliche Handhabung oder eine native Integration erfordern.
Wählen Sie das Modell entsprechend den tatsächlichen Input- und Output-Anforderungen aus. Ein Flash-Lite-Modell kann ein kostengünstiger Kandidat für einfachere Verarbeitungen sein, während eine separate Live-API die Echtzeit-Interaktion übernimmt. Der Zugriff auf einen Gemini-Text-Endpunkt bedeutet nicht automatisch die Unterstützung für jedes Gemini-Produkt.
Durchsuchen Sie Google-Modelle auf GPT Proto oder prüfen Sie Gemini 3.8 Flash hinsichtlich der aufgeführten multimodalen Inputs. Google bietet auch kostenlose Stufen für ausgewählte Modelle an, mit anderen Limits und Datennutzungsbedingungen als beim kostenpflichtigen Zugriff, wie in der Preisdokumentation dargestellt.
4. DeepSeek für budgetorientierte Reasoning-Workloads
DeepSeek ist eine Überlegung wert für wiederholte Dokumentenanalysen, Programmierunterstützung und Reasoning-Aufgaben, bei denen sich Token-Kosten schnell summieren. Dies ist besonders relevant, wenn Anfragen umfangreiche Eingaben wiederverwenden oder außerhalb der Spitzenzeiten ausgeführt werden können.
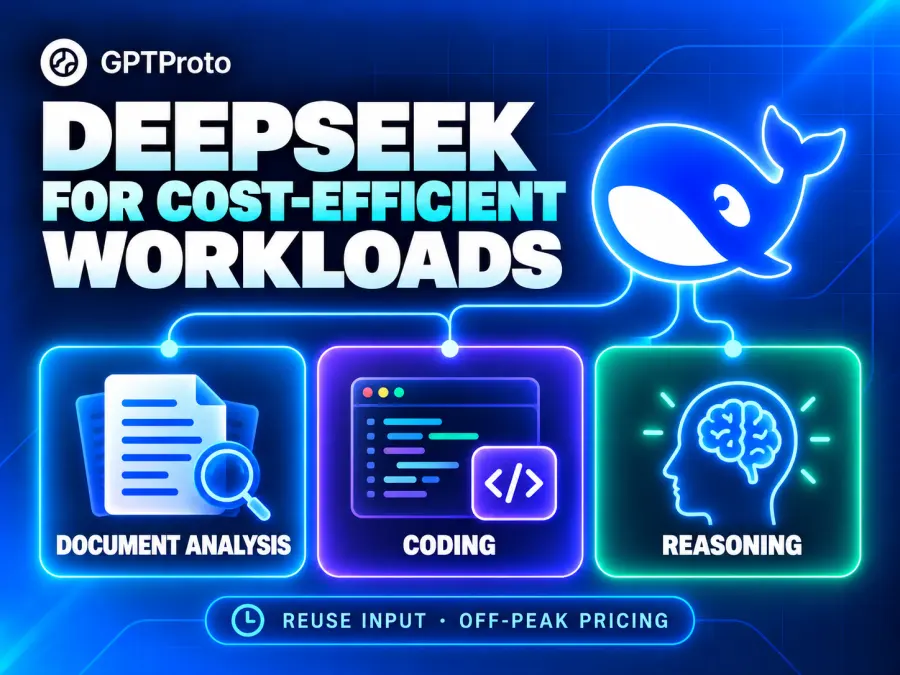
Die offizielle DeepSeek-Preistabelle listet Flash mit 0,30 $ pro Million nicht zwischengespeicherter Eingabe-Token und 1,20 $ pro Million Ausgabe-Token während der Spitzenzeiten auf. Die Preise außerhalb der Spitzenzeiten liegen bei 0,15 $ bzw. 0,60 $. Zwischengespeicherte Eingaben haben einen separaten, niedrigeren Tarif, sodass ein wiederkehrender Dokumenten-Workflow eine andere Wirtschaftlichkeit aufweisen kann als kurze, unabhängige Prompts.
Der API-Leitfaden von DeepSeek dokumentiert den OpenAI- und Anthropic-kompatiblen Zugriff. Verwenden Sie die exakte Modellkennung für den gewählten Dienst; die Kompatibilität mit einem Anfrageformat bedeutet nicht automatisch, dass Modellverhalten und Tool-Handling nicht validiert werden müssen.
Die DeepSeek Flash API-Seite bietet einen GPT Proto-Zugangsweg. Für eine breitere Auswahl vergleichen Sie die führenden chinesischen LLM-Anbieter oder erkunden Sie chinesische LLMs für die Programmierung.
Die niedrigen Preise rechtfertigen eine Evaluierung, machen den Dienst jedoch nicht in jedem Fall günstiger als jedes kleine OpenAI-Modell.
5. Groq für geschwindigkeitssensitive Anwendungen
Groq ist eine Option für Anwendungen, bei denen Benutzer direkt auf die generierte Ausgabe warten: interaktive Assistenten, Funktionen mit kurzen Antworten und Workflows mit mehreren sequenziellen Modellaufrufen. Der Wert hängt davon ab, ein unterstütztes Modell zu finden, das die Qualitätsanforderungen der Aufgabe erfüllt.
Nutzen Sie die Dokumentation zu unterstützten Modellen von Groq, um Verfügbarkeit, Limits und veröffentlichte Bereitstellungsspezifikationen zu prüfen. Messen Sie die Zeit bis zur ersten nützlichen Antwort und die gesamte Workflow-Zeit in Ihrer Anwendung; die vom Anbieter angegebene Generierungsgeschwindigkeit berücksichtigt nicht jede Netzwerk- oder Tool-Verzögerung.
Groq bietet OpenAI-kompatiblen Zugriff mit dokumentierten nicht unterstützten Feldern. Es gibt auch eine Responses API, aber die Dokumentation besagt, dass Anwendungen den Konversationsverlauf selbst verwalten und erneut senden müssen.
Wählen Sie Groq, wenn Antwortgeschwindigkeit eine wesentliche Produktanforderung ist und das verfügbare Modell passt. Wenn die bestehende App stark von gespeicherten Konversationen abhängt, beziehen Sie das Zustandsmanagement in die Migrationsschätzung ein. Der Austausch des Hosting-Dienstes und der Wechsel des Modellentwicklers sind getrennte Entscheidungen.
6. Mistral für dokumentenzentrierte Anwendungen
Mistral ist eine Überlegung wert für Anwendungen, die auf Dokumentenaufnahme, -extraktion und -beantwortung basieren. Ein Tool zur Rechnungsverarbeitung benötigt beispielsweise eine zuverlässige Textextraktion, bevor es ein Dokument klassifizieren oder eine Unstimmigkeit erklären kann.
Sein API-Katalog und die Preisgestaltung unterscheiden zwischen allgemeinen Modellen und OCR-Diensten. Dies hilft Teams dabei, Extraktion und Generierung separat zu kalkulieren, anstatt die gesamte Dokumenten-Pipeline als eine einzige Chat-Anfrage zu behandeln.
Der Migrationsleitfaden von Mistral deckt Chat-Completions im OpenAI-Stil ab. Seine Responses API unterstützt Textgenerierung, unterstützte Datei- und Bildeingaben, Funktionsaufrufe und Streaming. Zum Zeitpunkt der Überprüfung befindet sie sich in der öffentlichen Vorschau und ist zustandslos: Ihre Anwendung liefert den Gesprächsverlauf.
Mistral ist ein sinnvoller Kandidat, wenn die Dokumentenverarbeitung für das Produkt von zentraler Bedeutung ist. Bewerten Sie die Extraktionsausgabe, die Qualität der nachgelagerten Antworten und die Kosten beider Phasen. Eine funktionierende Chat-Migration allein validiert noch keinen vollständigen Dokumentenverarbeitungs-Workflow.
7. OpenRouter für Provider-Routing und Modell-Exploration
OpenRouter eignet sich für Teams, die Modelle vergleichen und kontrollieren möchten, welche zugrunde liegenden Provider ihre Anfragen bedienen. Es kann auch hilfreich sein, wenn eine Anwendung eine explizite Backup-Provider-Strategie benötigt.
Routing bringt eigene Entscheidungen mit sich. Entscheiden Sie, ob Anfragen zwischen Providern verschoben werden dürfen, ob jeder angeforderte Parameter unterstützt werden muss und welche Anforderungen an die Datenverarbeitung gelten. OpenRouter bietet Einstellungen für Provider-Präferenzen, Fallback-Konfigurationen und Parameter-Unterstützung; diese Einstellungen verdienen Aufmerksamkeit, wenn eine Anwendung auf ein bestimmtes Feature angewiesen ist.
Halten Sie für eine erste Evaluierung den Provider und das Modell fest, damit Änderungen in den Ergebnissen leichter zu untersuchen sind. Testen Sie dann die beabsichtigte Fallback-Konfiguration, einschließlich Fehlern und Unterschieden in der Nutzungsberichterstattung. Gebühren für den Kreditkauf und eventuell anfallende BYOK-Kosten gehören ebenfalls in die Kostenschätzung.
Wählen Sie OpenRouter, wenn Routing-Kontrollen eine primäre Anforderung sind. Unser Vergleich von LLM-API-Providern erklärt, wie sich Gateways, verwaltete Plattformen und Inferenz-Spezialisten unterscheiden.
Welche OpenAI-API-Alternativen sind tatsächlich günstiger
Es gibt zwei getrennte Kostenentscheidungen. Sie können dasselbe Modell über einen anderen Zugangsanbieter beibehalten oder das Modell wechseln, das die Arbeit erledigt. Ersteres ermöglicht einen relativ direkten Vergleich der Token-Preise. Letzteres erfordert neben der Rechnung auch eine Qualitätsbewertung.
Das folgende Beispiel geht von 10 Millionen nicht zwischengespeicherten Eingabe-Token und 2 Millionen berechneten Ausgabe-Token pro Monat aus. Es handelt sich um ein berechnetes Nutzungsszenario, nicht um einen Benchmark für gleiche Aufgabenqualität. Die berechnete Ausgabe umfasst Reasoning-Token, sofern der Anbieter diese als Ausgabe in Rechnung stellt. Tool-Gebühren, Steuern, Cache-Schreibvorgänge und Batch-Rabatte sind ausgeschlossen.
| Modell und Zugangsweg |
Eingabe pro 1M |
Ausgabe pro 1M |
Beispielkosten |
| GPT-6.1 Sol via OpenAI Standard |
$2.00 |
$10.00 |
$40.00 |
| GPT-6.1 Sol via GPT Proto |
$1.60 |
$8.00 |
$32.00 |
| GPT-6 Luna via OpenAI Standard |
$0.10 |
$0.50 |
$2.00 |
| Haiku 5.5 direkt, Prompts bis zu 100K |
$0.10 |
$0.50 |
$2.00 |
| DeepSeek Flash direkt, Spitzenlast |
$0.30 |
$1.20 |
$5.40 |
| DeepSeek Flash direkt, außerhalb der Spitzenlast |
$0.15 |
$0.60 |
$2.70 |
| Gemini 3.1 Flash-Lite direkt, Standardtext |
$0.25 |
$1.50 |
$5.50 |
Die Raten stammen von der OpenAI-Preisseite, der Sol-Seite von GPT Proto sowie den oben verlinkten Preisseiten von Anthropic, DeepSeek und Google.
Das Sol-Beispiel spart bei dem angegebenen Token-Volumen 8 $ oder 20 %. Die Zeilen für leichtgewichtige Modelle zeigen, warum eine Alternative mit dem OpenAI-Modell verglichen werden sollte, das Sie tatsächlich benötigen. Ein kleines OpenAI-Modell kann weniger kosten als eine leistungsfähigere Alternative.
Die 100K-Grenze von Haiku gilt für die Eingabe jeder Anfrage, nicht für das monatliche Volumen. Die beiden DeepSeek-Zeilen gehen davon aus, dass die gesamte Nutzung innerhalb des angegebenen Preiszeitraums liegt; gemischter Datenverkehr führt zu einer gemischten Rechnung. Tokenizer, Reasoning-Aufwand und Wiederholungsversuche können ebenfalls beeinflussen, wie viele Token eine Aufgabe verbraucht. Vergleichen Sie für Agenten-Workloads erschwingliche LLM-APIs nach Aufgabeneignung und verfolgen Sie dann die Kosten pro akzeptiertem Ergebnis.
Wie viel von Ihrer OpenAI-Integration können Sie beibehalten
Beginnen Sie damit, die Schnittstellen und Verhaltensweisen zu identifizieren, die die Anwendung verwendet. Eine erfolgreiche Begrüßungsanfrage sagt nur sehr wenig über einen Agenten aus, der Tools verwendet.
| Bestehende Abhängigkeit |
Vor der Migration prüfen |
Mögliche Anwendungsänderung |
| Chat und Streaming |
Anfragefelder, Ereignisformat, Beendigung |
Client-Konfiguration oder Antwort-Parser |
| Tool-Aufrufe |
Argumente, Tool-Ergebnisse, Folgeanfragen |
Tool-Adapter und Validierung |
| Strukturierte Ausgabe |
Erzwungene Schema-Regeln und Fehlerfälle |
Schema-Änderungen und anwendungsseitige Prüfungen |
| Gespeicherte Konversationen |
Verlaufsspeicherung und -abruf |
Persistenz und Verlaufswiedergabe |
| Dateien oder integrierte Tools |
Äquivalente Funktion und Abrechnung |
Separater Abruf- oder Tool-Dienst |
Der Bericht eines Entwicklers über die Portabilität strukturierter Ausgaben beschreibt, wie Einschränkungen bei verschiedenen Anbietern unterschiedlich gehandhabt werden. Betrachten Sie dies als die Erfahrung eines Praktikers und überprüfen Sie dann Ihr genaues Schema anhand der aktuellen Dokumentation und Antworten.
Führen Sie repräsentative Anfragen durch die in Frage kommende Integration aus: normaler Datenverkehr, lange Eingaben, ein fehlgeschlagenes Tool und eine Ausgabe, die Ihr erwartetes Format verletzt. Protokollieren Sie akzeptierte Ergebnisse, abgerechnete Nutzung, Antwortzeit und Wiederholungsversuche. Führen Sie bei Programmier-Anwendungen die generierte Änderung auch durch die eigenen Prüfungen des Projekts aus.
Behalten Sie eine Möglichkeit bei, den Datenverkehr zur vorherigen Konfiguration zurückzuleiten, während Sie den Ersatz bewerten. Wenn Sie noch eine Gesamtplattform für ein neues Produkt auswählen, deckt der umfassendere KI-API-Leitfaden für Entwickler diese Entscheidung ab.
Alternativen zu OpenAI Realtime Assistants und Moderation APIs
OpenAI Realtime API-Alternativen
Gemini Live API ist ein Kandidat für Echtzeit-Sprach- und Bildinteraktion. Bewerten Sie die Handhabung von Unterbrechungen, Audioformate, Sitzungsverhalten und Sprachantwortzeit. Eine Pipeline, die Spracherkennung, ein LLM und Sprachsynthese kombiniert, ist eine weitere Architektur, aber ihre separaten Phasen erhöhen den Integrationsaufwand und die Latenz. Gewöhnlicher gestreamter Text ist kein gleichwertiger Ersatz für eine Live-Audiositzung.
Alternativen zur OpenAI Assistants API für Produktions-Agenten
Die Assistants API wurde laut OpenAIs Migrationsleitfaden am 26. August 2026 eingestellt. Teams, die bei OpenAI bleiben, sollten dessen Migrationspfad für Antworten folgen.
Für ein anbieterunabhängiges Design kombinieren Sie eine gewählte Modell-API mit einer Orchestrierungs-Runtime wie LangGraph. Deren Zustands- und Checkpointing-Komponenten können persistente Workflows unterstützen, aber Ihr Team muss weiterhin die Tool-Ausführung, den Abruf, die Speicherung und die Wiederherstellung implementieren. Das Wechseln des Modell-Endpunkts migriert diese Verantwortlichkeiten nicht und erstellt alte Threads nicht automatisch neu.
Alternativen zur OpenAI Moderation API für Chat-Anwendungen
Azure AI Content Safety bietet Text- und Bildanalysen für potenziell schädliche Inhalte. Vergleichen Sie unterstützte Kategorien, Sprachen, Schwellenwerte, Antwortzeiten und Fehlalarme anhand der Beispiele Ihrer Anwendung.
Die Moderation ist eine separate Auswahl vom Konversationsmodell. Für kreative Chats oder Rollenspiele befasst sich unser Vergleich von unzensierten LLM-APIs mit dem Modellverhalten; eine Anwendung muss dennoch eigene Entscheidungen darüber treffen, welche Inhalte zugelassen werden und wie diese durchgesetzt werden sollen.
So testen Sie OpenAI API-Alternativen auf GPT Proto
Beginnen Sie mit einem Arbeitsablauf, den Sie konsistent beurteilen können, wie z. B. die Beantwortung von Support-Fragen oder das Extrahieren von Feldern aus einem Dokument.
Wählen Sie ein Modell aus. Öffnen Sie den GPT Proto-Katalog und vergleichen Sie die relevanten Claude-, Gemini- oder DeepSeek-Optionen.
Öffnen Sie die Einrichtungsanweisungen des Modells. Verwenden Sie „Try This Model“ (Dieses Modell ausprobieren), sofern verfügbar, oder den Abschnitt zur API-Nutzung. Kopieren Sie die modellspezifischen Anweisungen in Ihren Coding-Assistenten oder folgen Sie dem angezeigten Beispiel.
Konfigurieren Sie die Integration. Erstellen Sie einen GPT Proto-API-Schlüssel und verwenden Sie die Modell-ID, den Endpunkt und das Anforderungsformat, die auf dieser Seite angezeigt werden. Bewahren Sie Anmeldeinformationen in der geheimen Konfiguration Ihrer Anwendung auf.
Werten Sie einen kleinen Anforderungssatz aus. Vergleichen Sie nützliche Ergebnisse, abgerechnete Nutzung und Antwortzeit, bevor Sie den Datenverkehr ausweiten. Testen Sie erforderliche Tools und strukturierte Ausgaben separat.