Die besten chinesischen LLM-Modelle auf einen Blick
| Rang |
Modell |
Empfohlene Verwendung |
Haupt-Kompromiss |
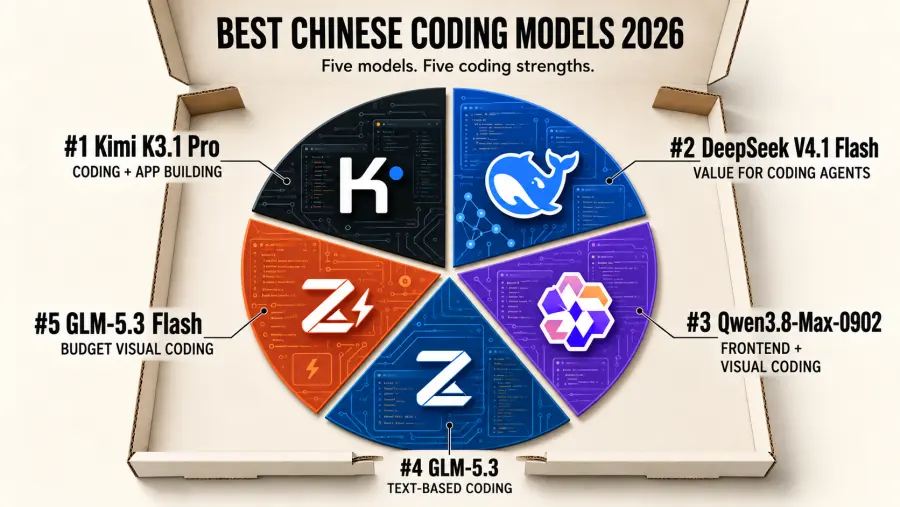
| 1 |
Kimi K3.1 Pro |
Anspruchsvolle Programmierung, App-Entwicklung und erweiterte Agenten-Aufgaben |
Höhere Token-Preise als bei den Budget-Kandidaten |
| 2 |
DeepSeek V4.1 Flash |
Kostenbewusste Coding-Agenten und wiederholte Implementierungsarbeiten |
Überprüfen Sie den bereitgestellten Checkpoint, bevor Sie die 1017-Benchmark-Ergebnisse anwenden |
| 3 |
Qwen3.8-Max-0902 |
Frontend-Implementierung und visuelles Debugging |
Höhere Token-Preise als bei DeepSeek und GLM Flash |
| 4 |
GLM-5.3 |
Textbasierte Repository-Untersuchung und Terminal-Aufgaben |
Native visuelle Nachweise erfordern einen anderen Weg |
| 5 |
GLM-5.3 Flash |
Budget-freundliches visuelles Programmieren und häufige Agenten-Teilaufgaben |
Testen Sie schwierige Aufgaben, bevor Sie es zum alleinigen Produktionsmodell machen |
Der Preisvergleich folgt unten. Die Trennung von Preis und Leistungsfähigkeit macht es einfacher zu erkennen, warum ein teureres Modell für eine bestimmte Aufgabe dennoch einen Test wert sein könnte.
Die Geschwindigkeitsmessungen stammen von der API des jeweiligen Modellerstellers, gemessen durch Artificial Analysis. Es handelt sich um nützliche Momentaufnahmen, nicht um Latenzgarantien für GPT Proto. Anbieterlast, Prompt-Länge, Reasoning-Aufwand, Cache-Verhalten und Ausgabelänge können die Produktionsleistung beeinflussen.
Die Modalitätsspalte beschreibt die von GPT Proto bereitgestellten Wege. Ein herunterladbarer Checkpoint und eine gehostete API mit ähnlichem Namen bieten möglicherweise nicht identische Funktionen.
Wie wir die chinesischen Coding-Modelle bewertet haben
Eine hohe Parameteranzahl oder ein Kontextfenster von einer Million Token sagt noch nichts darüber aus, ob ein Modell eine Repository-Aufgabe tatsächlich abschließen kann. Alle fünf Modelle in diesem Ranking befinden sich in etwa in derselben Klasse für lange Kontexte. Ihre praktischen Unterschiede zeigen sich an anderer Stelle.
Wir haben sechs Fragen berücksichtigt:
Wie schneidet das Modell in unabhängigen Bewertungen ab, anstatt nur in den Benchmark-Diagrammen des Entwicklers?
Kann es Multi-File-Coding, Terminal-Arbeit, Tool-Aufrufe sowie Planen-Ausführen-Überprüfen-Schleifen bewältigen?
Kann es Screenshots, Diagramme, Dokumente oder aufgezeichnete Produktabläufe untersuchen, wenn die Beweise nicht nur aus Text bestehen?
Was kostet eine realistische API-Aufgabe, wenn Output-Token, Reasoning und wahrscheinliche Wiederholungsversuche einbezogen werden?
Sind die Modellgewichte tatsächlich herunterladbar und welche Lizenz regelt den kommerziellen Einsatz?
Gibt es einen Live-GPT Proto-Weg, den Leser über dasselbe Konto und API-Format testen können?
Das aktuelle Artificial Analysis-Leaderboard listet Intelligence Index-Werte von 46 für Kimi K3.1 Pro, 34 für Qwen3.8 Max 0902 und jeweils 32 für DeepSeek V4.1 Flash 1017 bei maximalem Reasoning sowie GLM-5.3 bei maximalem Reasoning. Der Index ist ein breites Fähigkeitsmaß. Er misst nicht direkt die Kosten für die Behebung eines Fehlers in Ihrer Anwendung.
Diese Werte gehören zum Intelligence Index v5.0. Kombinieren Sie sie nicht mit früheren Index-Versionen und interpretieren Sie eine Änderung zwischen Bewertungsversionen nicht als Rückgang des Modells selbst. Wir vermeiden es auch, GLM-5.3 Flash einen alten Indexwert zuzuweisen, wenn das aktuelle Leaderboard keinen vergleichbaren Wert anzeigt.
Coding-Ergebnisse können in unterschiedliche Richtungen weisen. Im DeepSeek–GLM-Vergleich von Artificial Analysis führt GLM bei Terminal-Bench 4.0, während DeepSeek bei FrontierCode 2.0 führt. Diese Aufteilung ist der Grund, warum diese Shortlist aufgabenspezifische Empfehlungen enthält und den Kosten bei der Reihenfolge eine Rolle beimisst.
1. Kimi K3.1 Pro: Bester Allround-Kandidat für die Programmierung
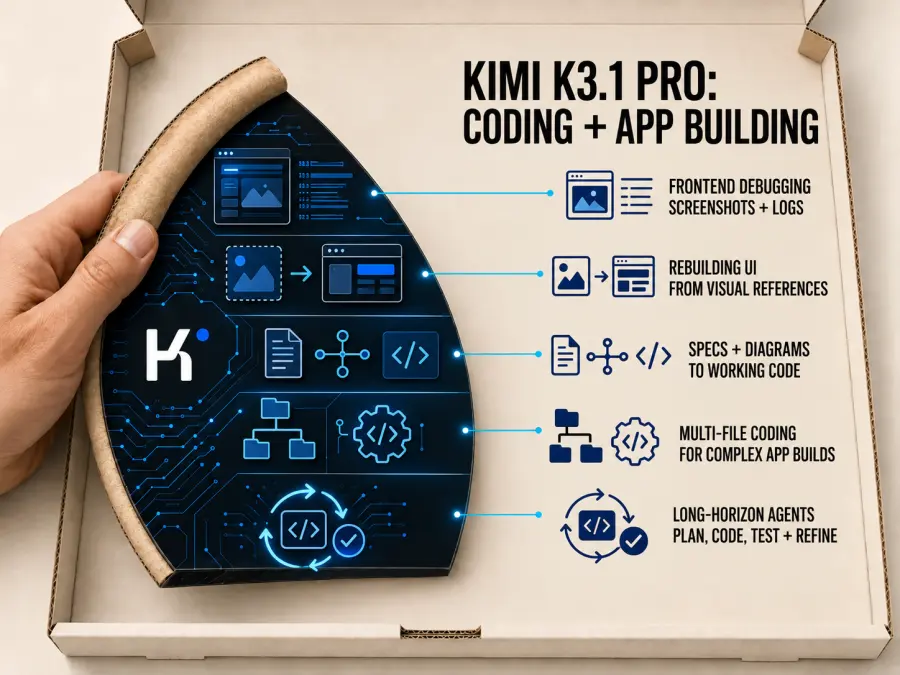
Kimi K3.1 Pro übernimmt den ersten Platz, da die neue Version stärkere Belege für schwierige, umfangreiche Softwareprojekte liefert. Der technische Blog von Moonshot berichtet von 65,7 % bei Terminal-Bench 4.0 und 61,2 % bei seinem internen Kimi Code Bench 3.0 Long-horizon, verglichen mit 55,95 % von K3 bei Letzterem. Dies sind vom Anbieter gemeldete Ergebnisse.
Es gibt auch ein unabhängiges Signal: Artificial Analysis verzeichnet etwa 67 % bei Terminal-Bench 4.0. Dieses Ergebnis stammt aus deren Evaluierungs-Setup; es sollte getrennt von den Zahlen von Moonshot betrachtet werden.
Ich würde K3.1 Pro zuerst testen, wenn ein Agent eine unbekannte Anwendung verstehen, mehrere zusammenhängende Dateien ändern und nach einem fehlgeschlagenen Test weiterarbeiten muss. Für App-Entwickler ist die entscheidende Frage, ob das Modell eine Funktion liefern kann, die nach Implementierung und Korrektur den Anforderungen entspricht.
Seine GPT Proto-Route akzeptiert Text- und Bildeingaben. Das macht es zu einem Kandidaten für Arbeiten, die Quellcode, eine Designvorlage und eine gerenderte Schnittstelle kombinieren. Es lohnt sich dennoch, mit einer begrenzten Aufgabe zu beginnen: Definieren Sie das erwartete Verhalten und geben Sie dem Agenten eine Möglichkeit, dieses zu verifizieren.
Die höhere Token-Rechnung ist der Kompromiss. Reservieren Sie es für Arbeiten, bei denen eine verbesserte Qualität der Vervollständigung die Kosten rechtfertigt. Halten Sie zudem den Bereitstellungsstatus präzise: Zum Zeitpunkt dieses Updates plant Moonshot die Veröffentlichung der vollständigen K3.1 Pro-Gewichte bis zum 4. November. Bestehende K3-Gewichte belegen nicht, dass K3.1 Pro bereits herunterladbar ist.
Fazit: Beginnen Sie mit Kimi K3.1 Pro für eine schwierige Funktion oder einen App-Build und vergleichen Sie dann die akzeptierten Änderungen und die Gesamtkosten mit einem günstigeren Kandidaten.
2. DeepSeek V4.1 Flash: Bestes Preis-Leistungs-Verhältnis für Coding-Agenten
DeepSeek verdient eine höhere Position, wenn das Ziel darin besteht, nützliche Programmierfähigkeiten innerhalb eines wiederholbaren Produktionsbudgets zu halten. Es ist ein Kandidat für Agenten, die Code lesen, Patches vorschlagen, Testausgaben prüfen und einen weiteren Versuch unternehmen.
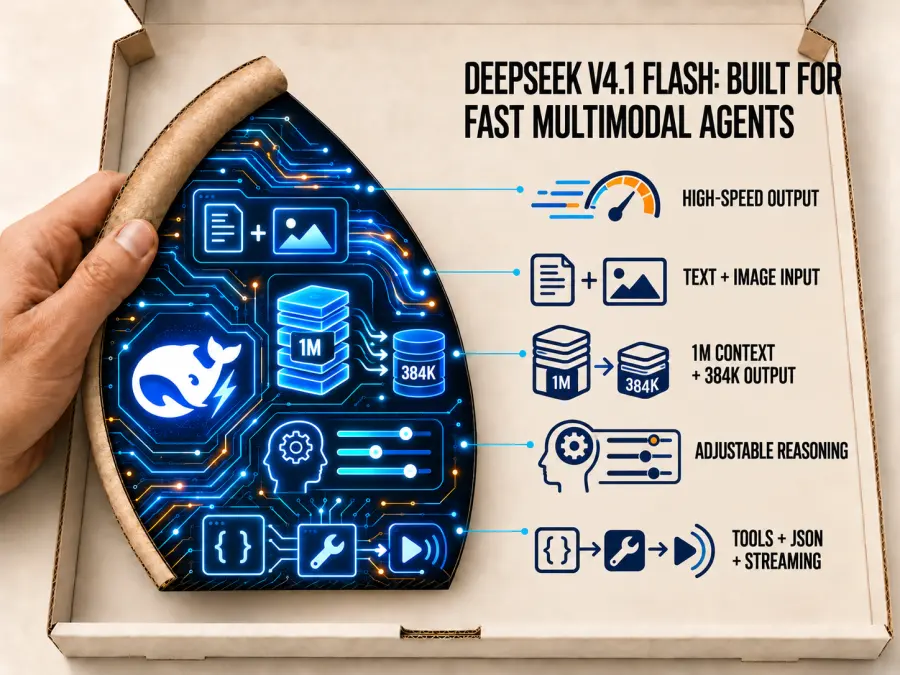
Die Modellkarte für DeepSeek V4.1 Flash 1017 berichtet von Verbesserungen gegenüber der früheren V4.1 Flash-Version: Terminal-Bench 4.0 steigt von 31,2 auf 42,3, DeepSWE v1.1 von 74,2 auf 77,0 und ProgramBench von 20,3 auf 29,1. Dies sind die von DeepSeek gemeldeten Evaluierungen und keine Reproduktion durch GPT Proto.
Dieses Update stärkt das Argument, DeepSeek in einen Coding-Test einzubeziehen. Es macht nicht jedes andere Modell überflüssig. Unabhängige Coding-Evaluierungen zeigen je nach Aufgabe immer noch unterschiedliche Gewinner, und ein Produktions-Agent muss anhand der Tools und Limits beurteilt werden, die er tatsächlich nutzen wird.
Halten Sie die Routenunterscheidung explizit. GPT Proto stellt DeepSeek Flash über deepseek-flash bereit; die öffentliche Seite beschreibt V4.1 Flash, ohne den 1017-Checkpoint zu identifizieren. Bestätigen Sie die bereitgestellte Revision, bevor Sie die neueren Ergebnisse als Beweis für genau diesen Endpunkt verwenden.
Fazit: Testen Sie DeepSeek als preisbewusstes Implementierungsmodell. Protokollieren Sie die Modellrevision zusammen mit Erfolgsrate, Wiederholungsversuchen, Latenz und Kosten, damit ein späteres Alias-Update den Vergleich nicht mehrdeutig macht.
3. Qwen3.8-Max-0902: Beste Wahl für Frontend und visuelles Debugging
Qwen bleibt eine nützliche Wahl, wenn eine Programmieraufgabe mit etwas Sichtbarem beginnt: einer Referenzseite, einem fehlerhaften Layout, einem Diagramm oder einer Abfolge von Schnittstellenzuständen. Die Qwen3.8-Max-0902-Route unterstützt multimodale Eingaben, wodurch eine Anwendung visuelles Material mit Code und Anweisungen kombinieren kann.
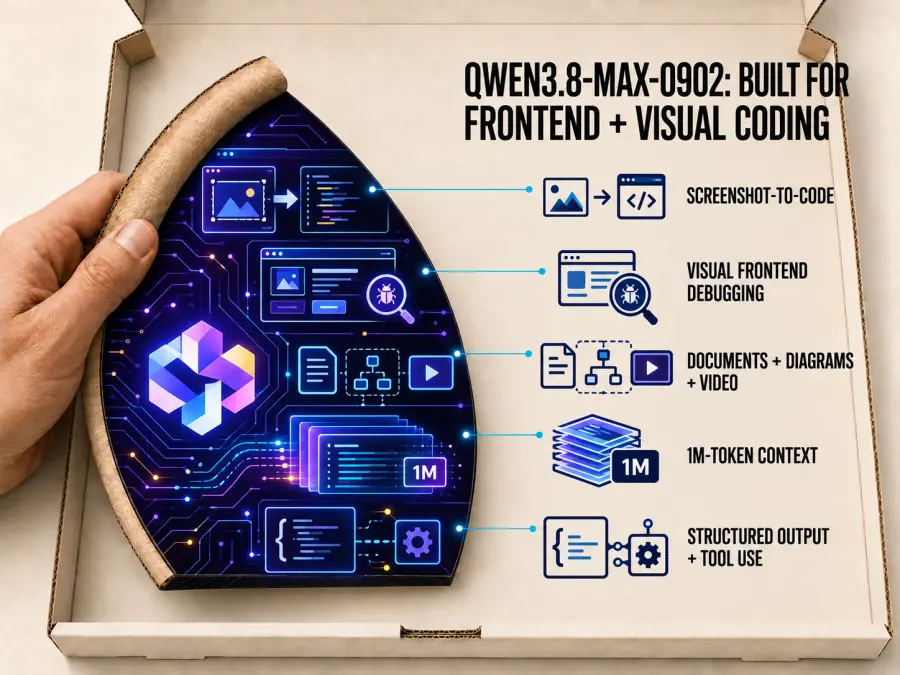
Geben Sie für eine Frontend-Bewertung dieselbe Designreferenz und denselben Repository-Zugriff wie bei den anderen Kandidaten vor. Bitten Sie den Agenten, die Seite zu implementieren, zu rendern, die wichtigen Zustände zu überprüfen und das Ergebnis zu korrigieren. Beurteilen Sie neben der Korrektheit des Codes auch Abstände, Hierarchie, Reaktionsfähigkeit und funktionierende Interaktionen.
Deshalb behält Qwen auch nach dem Upgrade von Kimi einen festen Platz hier. Eine Frontend-Auswahl erfordert visuelle Akzeptanzkriterien, und ein allgemeiner Intelligenzwert beschreibt diese Arbeit nur teilweise. Dies ist unsere Workflow-Empfehlung; es ist keine Behauptung, dass Qwen einen neuen Frontend-Test mit fünf Modellen gewonnen hat.
Der Kosten-Nutzen-Kompromiss ist eindeutig: Die angezeigten Token-Raten sind höher als bei DeepSeek und GLM Flash. Für einen kleinen, rein textbasierten Patch sollten Sie eine dieser günstigeren Routen in den Test einbeziehen. Halten Sie außerdem den exakten gehosteten 0902-Snapshot bei der Dokumentation von Funktionen von allen zugehörigen herunterladbaren Checkpoints getrennt.
Fazit: Setzen Sie Qwen auf die engere Wahl, wenn die Einhaltung eines visuellen Briefings entscheidend für den Erfolg der Implementierung ist.
4. GLM-5.3: Beste Wahl für textbasierte Repository-Arbeit
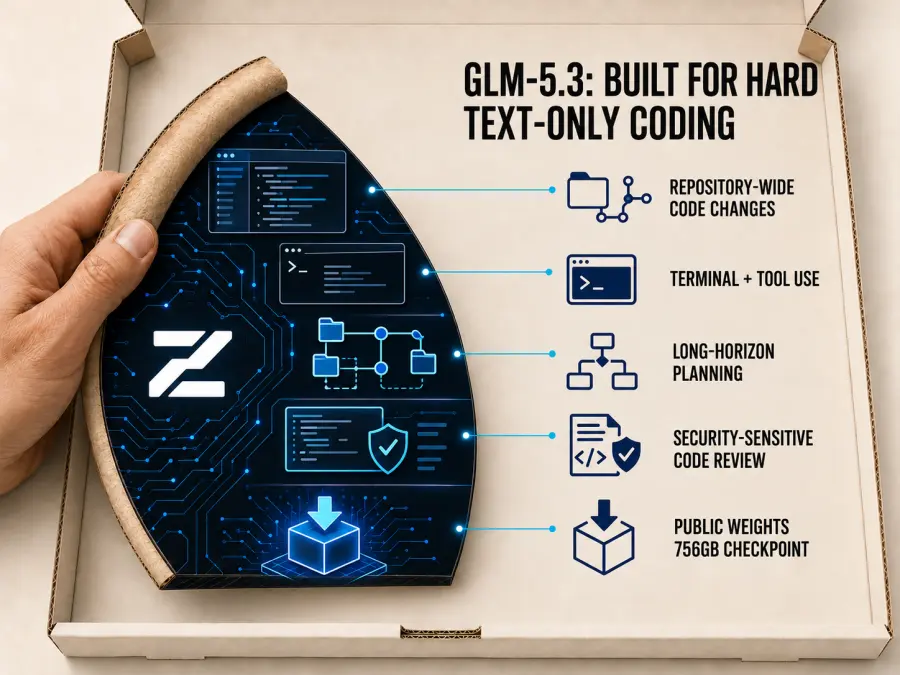
GLM-5.3 bleibt relevant für Code-Untersuchungen, Terminal-Aufgaben und Änderungen, deren Nachweise als Text vorliegen. Das aktualisierte Ranking gibt Kimi die allgemeine Empfehlung, während GLM als fokussierter Programmierkandidat beibehalten wird.
Der unabhängige DeepSeek–GLM-Vergleich verdeutlicht seine Position: GLM erreicht 42 % im Terminal-Bench 4.0 gegenüber 34 % bei DeepSeek 1017, während FrontierCode 2.0 DeepSeek mit 28 % zu 22 % bevorzugt. Diese Ergebnisse beschreiben das Setup des jeweiligen Evaluators und sollten daher nicht durch die unterschiedlich konfigurierten Testläufe der Anbieter ersetzt werden.
Ich würde GLM in einem Testlauf einsetzen, der eine fehlerhafte Backend-Integration, eine unbekannte Abhängigkeit oder eine Repository-Änderung beinhaltet, die mehrere Befehls- und Testzyklen erfordert. Die Akzeptanzkriterien sollten einen erfolgreichen Reproduktionstest und eine Erklärung der Änderungen umfassen.
Die GPT Proto GLM-5.3-Seite dokumentiert Texteingabe und Textausgabe. Wenn der Agent einen Screenshot direkt untersuchen muss, verwenden Sie für diesen Schritt eine visuelle Route. Aufgrund der höheren Token-Raten im Vergleich zu den Budget-Modellen lohnt es sich auch, wiederholte Versuche zu messen.
Fazit: Behalten Sie GLM-5.3 für Repository- und Terminal-Workflows bei, bei denen es Ihre Tests konsistent besteht. Vergleichen Sie es bei schwierigen Aufgaben mit Kimi und hinsichtlich der Kosten mit DeepSeek.
5. GLM-5.3 Flash: Der beste Kandidat für visuelle Programmierung mit kleinem Budget
GLM-5.3 Flash behauptet seinen Platz, da bei häufigen Agenten-Aufrufen die Token-Preise oft wichtiger sind als geringfügige Unterschiede in der allgemeinen Leistungsfähigkeit. In der unten stehenden Preisübersicht weist das Modell die niedrigsten Input- und Output-Preise unter diesen fünf GPT Proto-Einträgen auf.
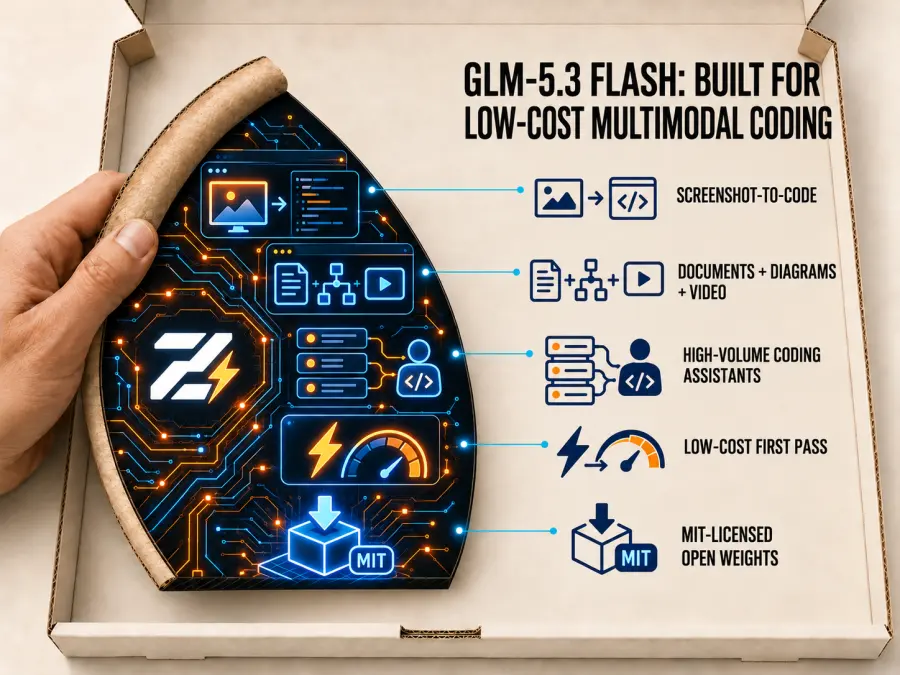
Die Modellseite dokumentiert die Eingabe von Text, Bildern, Videos und Dateien sowie die unter MIT-Lizenz stehenden Gewichte. Zudem wird erläutert, dass Flash eine andere multimodale Basis als das Standard-GLM-5.3 verwendet. Betrachten Sie die beiden bei der Erstellung einer Routing-Richtlinie als separate Kandidaten.
Eine praktische Evaluierung würde Flash ein begrenztes Problem, eine Prüfung des visuellen Layouts oder eine erste Implementierung zuweisen. Behalten Sie dieselben Abnahmetests bei, die Sie für die größeren Modelle verwenden. Wenn das Ergebnis fehlschlägt, rechnen Sie den fehlgeschlagenen Versuch und die Eskalation in die Gesamtkosten ein.
Niedrige Preise lassen Spielraum für Iterationen, aber wiederholte, erfolglose Versuche können diesen Vorteil zunichtemachen. Messen Sie, wie oft die Aufgabe erfolgreich abgeschlossen wird, bevor Sie das Modell als Standard festlegen. Reasoning ist bei dem dokumentierten Modell immer aktiviert; beziehen Sie daher die Nutzung von Reasoning-Token und die Antwortzeit in diese Prüfung mit ein.
Fazit: Testen Sie GLM-5.3 Flash als Budget-Standard für visuelle Programmierung und wiederkehrende Teilaufgaben, mit einem klaren Eskalationspfad für Fehler.
Erwähnenswerte Modelle
MiniMax M3.1 Flash
Der aktuelle Kandidat von MiniMax verdient mehr Aufmerksamkeit als der ältere M3-Eintrag. Die Veröffentlichung vom 19. Oktober meldet 73,7 % bei DeepSWE v1.1 und betont die kostengünstigere Agentenausführung. Das macht M3.1 Flash für dieselbe Budgetdiskussion relevant wie DeepSeek und GLM Flash.
Behalten Sie es auf der Forschungs-Shortlist, bis die genaue GPT Proto-Route, die Modell-ID, die Preise und die unterstützten Funktionen bestätigt sind. Ein bestehender MiniMax M3-Endpunkt sollte nicht ohne Überprüfung als M3.1 Flash bezeichnet werden.
Xiaomi MiMo-V2.6 und andere aufstrebende Modelle
MiMo-V2.6 bleibt beobachtenswert; Artificial Analysis führt MiMo-V2.6-Pro in seinen Auswertungen. Nehmen Sie ein neues Modell erst dann in die Hauptliste auf, nachdem Sie sowohl die Nachweise zur Aufgabenbewältigung als auch den tatsächlich empfohlenen Zugriffspfad überprüft haben.
Ältere Kimi K3- und DeepSeek V4 Pro-Bereitstellungen können weiterhin sinnvoll sein, wenn eine Anwendung auf validiertem Verhalten basiert. Testen Sie einen Ersatz für dieselben Aufgaben, bevor Sie bestehenden Traffic migrieren.
Modelle, die man im Auge behalten sollte
Step 5 Preview und die MiMo-V2.6-Familie von Xiaomi sind relevante neue chinesische Modelle, sie sind jedoch nicht im Hauptranking enthalten, da GPT Proto zum Zeitpunkt dieses Updates keine bestätigten Live-Routen für sie hatte. Fügen Sie sie erst dann zur Rangliste hinzu, wenn die genaue Modellseite, der API-String, der Preis und die unterstützten Request-Felder live und getestet sind.
Eine echte Programmieraufgabe, fünf verschiedene Optionen
Stellen Sie sich vor, Sie fügen einer bestehenden TypeScript-SaaS-Anwendung eine Abonnement-Abrechnung hinzu. Der Agent muss das aktuelle Benutzermodell verstehen, einen Checkout-Prozess implementieren, Webhook-Ereignisse sicher verarbeiten, Kontoberechtigungen aktualisieren und das Ergebnis verifizieren.
| Anforderung |
Zu evaluierender Kandidat |
Worauf zu achten ist |
| Implementierung des verbundenen Features über mehrere Dateien hinweg |
Kimi K3.1 Pro |
Korrekte Funktionsweise, kohärente Änderungen und Wiederherstellung nach fehlgeschlagenen Tests |
| Wiederholte Implementierungs- und Korrekturversuche durchführen |
DeepSeek V4.1 Flash |
Akzeptierte Korrekturen pro Dollar; Protokollierung der bereitgestellten Revision |
| Anpassung des Abrechnungs-Interfaces an eine Design-Referenz |
Qwen3.8-Max-0902 |
Visuelle Genauigkeit, responsives Verhalten und funktionierende Zustände |
| Diagnose von Backend- und Terminalfehlern |
GLM-5.3 |
Reproduktionsqualität, Befehlsnutzung und Testergebnisse |
| Kostengünstige Abwicklung begrenzter Implementierungen oder visueller Prüfungen |
GLM-5.3 Flash |
Fehlerrate, Wiederholungsversuche und Kosten inklusive Eskalationen |
Für dieses Beispiel ist ein gut aussehender Checkout-Button nur ein Teil des Ergebnisses. Der Webhook muss verifiziert werden, doppelte Ereignisse dürfen keine doppelten Vorteile gewähren und Abonnementänderungen müssen das korrekte Konto aktualisieren. Schreiben Sie diese Abnahmetests, bevor Sie die Modelle vergleichen.
Was würde dieselbe Programmieraufgabe kosten?
Für einen einfachen Token-Kostenvergleich nehmen wir 100.000 nicht zwischengespeicherte Eingabe-Token und 20.000 abrechenbare Ausgabe-Token pro Versuch an. Das Folgende basiert auf den angezeigten Preisübersichten von GPT Proto, geprüft am 29. Oktober 2026. Die Raten verstehen sich in USD pro Million Token; es werden keine Cache- oder Nebenzeiten-Einsparungen angenommen.
| Modell |
Eingabe / 1M |
Ausgabe / 1M |
Illustrative Token-Kosten |
| Kimi K3.1 Pro |
$2,00 |
$10,00 |
$0,4000 |
| DeepSeek Flash |
$0,24 |
$0,96 |
$0,0432 |
| Qwen3.8-Max-0902 |
$1,40 |
$4,20 |
$0,2240 |
| GLM-5.3 |
$1,19 |
$3,74 |
$0,1938 |
| GLM-5.3 Flash |
$0,1275 |
$0,425 |
$0,02125 |
Die Berechnung lautet 0,1 × Eingaberate + 0,02 × Ausgaberate. Die DeepSeek-Zeile bepreist die angezeigte GPT Proto-Route; sie legt nicht den Prüfpunkt fest, der unter diesem Alias bereitgestellt wird.
Dies sind illustrative Token-Gebühren. Die tatsächliche Ausgabe muss gegebenenfalls abrechenbare Überlegungen (Reasoning) enthalten, und eine vollständige Aufgabe kann mehr Durchläufe, Tool-Ergebnisse, Wiederholungsversuche oder ein anderes Modell beinhalten. Überprüfen Sie die Live-Preisübersicht bei der Ausgabenplanung.
Messen Sie die gesamten API-Ausgaben geteilt durch die Änderungen, die Ihre Abnahmetests bestehen. Das liefert einen nützlicheren Vergleich, als anzunehmen, dass jedes Modell die Aufgabe mit der gleichen Anzahl an Token abschließt.
Warum der Benchmark-Sieger möglicherweise nicht der beste Coding-Agent ist
Ihr Coding-Agent steuert, welche Dateien das Modell sieht, wie Tools aufgerufen werden, wann Tests ausgeführt werden und was nach einem Fehler passiert. Die Änderung dieses Setups kann das Ergebnis beeinflussen, selbst wenn das Modell gleich bleibt.
Bevor Sie Kandidaten vergleichen, halten Sie das Repository, die Aufgabenanweisungen, die Tools, die Abnahmetests und das Zeitlimit konstant. Ermöglichen Sie jedem Modell das von ihm benötigte Anfrageformat und protokollieren Sie seine Reasoning-Einstellungen. Messen Sie dann die abgeschlossenen Aufgaben, Regressionen, Wiederholungsversuche, die verstrichene Zeit und die API-Kosten.
Verwenden Sie für diese engere Auswahl Kimi, um die Leistungsobergrenze zu testen, DeepSeek und GLM Flash für die Wirtschaftlichkeit in der Produktion, Qwen für die visuelle Abnahme und GLM für die textbasierte Repository-Ausführung. Lassen Sie die Ergebnisse entscheiden, welche Phasen sich ein Modell teilen und welche einen anderen Weg erfordern.
Welches chinesische Coding-Modell sollten Sie verwenden?
Wählen Sie zuerst Kimi K3.1 Pro, wenn die Fertigstellung einer schwierigen Funktion oder App Priorität hat und Sie ein höheres Budget pro Token rechtfertigen können.
Wählen Sie DeepSeek V4.1 Flash, wenn wiederholte Agentenaufrufe die Kosten zu einem wichtigen Faktor machen. Bestätigen Sie die bereitgestellte Revision, bevor Sie einen Rollout auf Basis von 1017-spezifischen Nachweisen durchführen.
Wählen Sie Qwen3.8-Max-0902, wenn die Implementierung mit Screenshots, Layouts oder anderen visuellen Referenzen übereinstimmen muss.
Wählen Sie GLM-5.3, wenn sich Ihre Bewertung auf Quellcode, Terminalausgaben und Backend-Verhalten konzentriert.
Wählen Sie GLM-5.3 Flash, wenn Sie einen kostengünstigen Kandidaten für visuelles Coding suchen und Fehler erkennen können, bevor diese eskaliert werden.
Verwenden Sie für einen ersten Vergleich eine begrenzte Aufgabe, für die bereits ein zuverlässiger Abnahmetest vorliegt. Eine kleine, verifizierte Änderung liefert Ihnen nützlichere Bereitstellungsnachweise als eine große, generierte Anwendung, die niemand überprüft hat.
So rufen Sie diese chinesischen LLM-Modelle über eine einzige API auf
Öffnen Sie die Modellseite für den Kandidaten, den Sie ausprobieren möchten, und verwenden Sie dann Modell ausprobieren → Schnellstart. Erstellen oder wählen Sie einen GPT Proto-API-Schlüssel und verwenden Sie Markdown für KI kopieren, um Ihrem Coding-Assistenten die aktuellen Integrationsanweisungen zu geben.
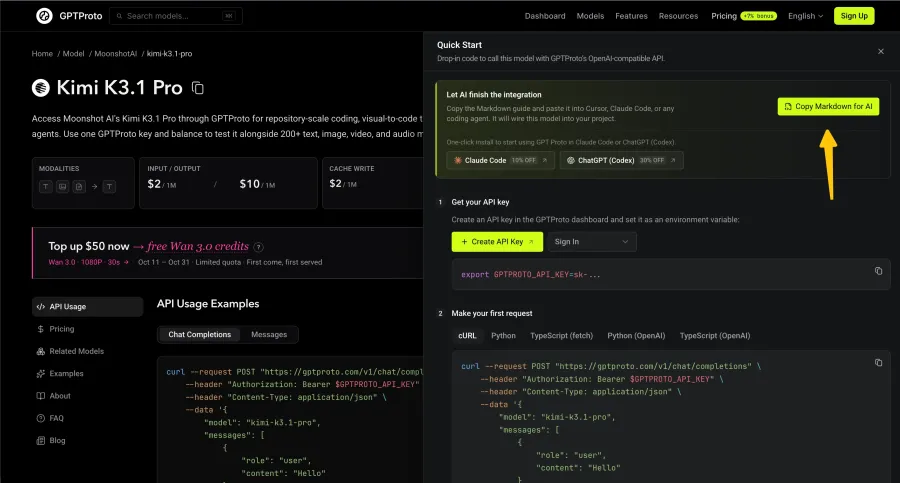
Bitten Sie ihn, Ihr Projekt zu untersuchen, den kopierten Endpunkt und die Anforderungsfelder zu übernehmen, den Schlüssel in der serverseitigen Konfiguration zu speichern und eine kleine Verbindungsprüfung hinzuzufügen. Konfigurieren Sie den echten Schlüssel lokal, anstatt ihn in einen öffentlichen Prompt oder ein Repository einzufügen.
Die unten aufgeführten Modell-IDs identifizieren die öffentlichen GPT Proto-Routen, die für dieses Update überprüft wurden:
| Modell |
GPT Proto Modell-ID |
| Kimi K3.1 Pro |
kimi-k3.1-pro |
| DeepSeek Flash |
deepseek-flash |
| Qwen3.8-Max-0902 |
qwen3.8-max-0902 |
| GLM-5.3 |
glm-5.3 |
| GLM-5.3 Flash |
glm-5.3-flash |
Verwenden Sie die Live-Anleitung auf der Modellseite für jede Route. Modelle können sich in Bezug auf Argumentationsfelder, die Handhabung von Tool-Aufrufen und das multimodale Anforderungsformat unterscheiden, daher ist das Ändern des Modell-Strings nur ein Teil einer Migration. Auf eine erfolgreiche Einzelanfrage sollte vor dem produktiven Einsatz ein Test mit mehreren Tool-Aufrufen folgen.
Das Verbinden einer Modell-API mit Ihrer Anwendung ist zudem eine separate Aufgabe vom Wechsel des Modells, das Ihren Coding-Assistenten antreibt. Überprüfen Sie für Letzteres das vom Client unterstützte Verbindungsformat.
Vergleichen Sie alle GPT Proto-Modelle, bevor Sie produktiven Traffic zuweisen. Ein API-Schlüssel und ein gemeinsames Guthaben können verwendet werden, um verschiedene unterstützte Modelle zu evaluieren, ohne für jeden Anbieter eine separate Integration und ein Prepaid-Konto pflegen zu müssen.
Öffnen Sie Kimi K3.1 Pro, um mit einer schwierigen Coding-Aufgabe zu beginnen, oder vergleichen Sie DeepSeek Flash und GLM-5.3 Flash, wenn die Kosten bei wiederholten Aufrufen Priorität haben. Nutzen Sie die Integrationsanleitung der Modellseite und verifizieren Sie eine kleine Änderung, bevor Sie die Arbeitslast erweitern.