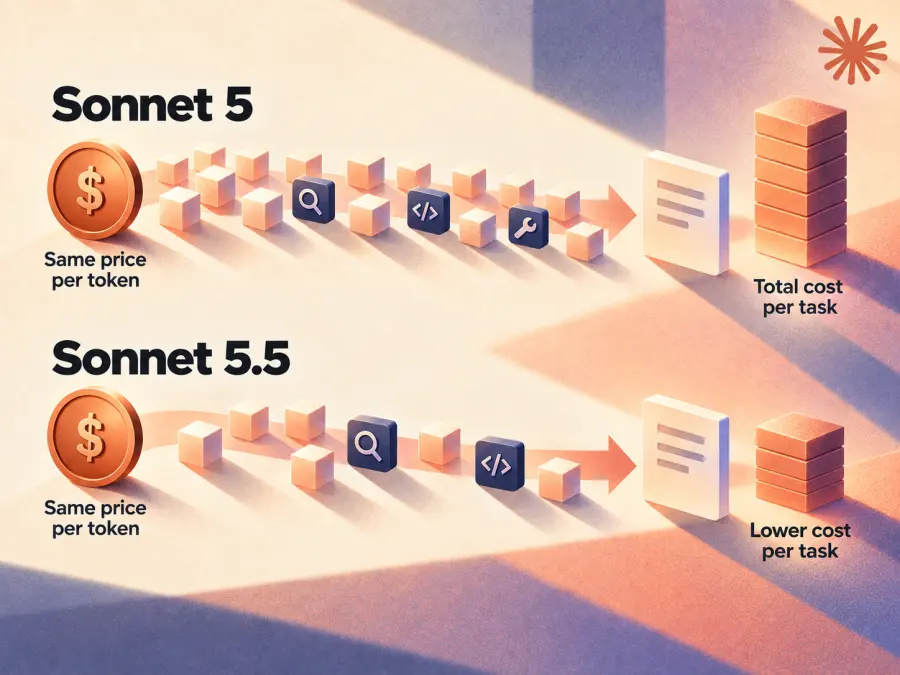
Claude Sonnet 5.5 hat denselben API-Preis pro Token wie Sonnet 5. Anthropic sagt dennoch, dass die Erledigung einer Aufgabe mit dem neuen Modell weniger kosten kann. Das klingt widersprüchlich, bis man den Preis pro Token von der Anzahl der Token und Tool-Aufrufe unterscheidet, die eine Aufgabe tatsächlich erfordert.
Die kurze Antwort: Claude Sonnet 5.5 ist das Update von Anthropic's Sonnet-Modell vom 28. September 2026 für Programmierung, Dokumentenarbeit und andere Aufgaben mit einem klaren Ziel. Es verarbeitet Text und Bilder, gibt Text aus und ist in Claude Code sowie über die Claude API verfügbar. Anthropic berichtet von einer schnelleren Ausgabe und besseren Ergebnissen als bei Sonnet 5 in mehreren Evaluierungen. Diese Ergebnisse sind gute Gründe, ein Upgrade zu testen, aber keine Garantie für jede Codebasis oder jeden Workflow. Auf der Claude Sonnet 5.5-Modellseite auf GPTProto kannst du die Verfügbarkeit auf der Plattform prüfen und das Modell ausprobieren, sobald es gelistet ist. Die Ankündigung von Anthropic beschreibt die Veröffentlichung und die damit verbundenen Behauptungen.
Was ist Claude Sonnet 5.5?
Sonnet ist die mittlere Leistungsstufe in der aktuellen Claude-Modellreihe. Sonnet 5.5 ist darauf ausgelegt, klar definierte, wiederholbare Aufgaben schnell zu erledigen: ein vorgegebenes Feature implementieren, einen Fehler beheben, ein Dokument anhand des Ausgangsmaterials prüfen oder aus einer Kurzbeschreibung eine Präsentation erstellen. Anthropic positioniert Opus 5.5 für anspruchsvollere, offene Aufgaben, die ein anhaltendes Urteilsvermögen erfordern. Dieser Unterschied ist wichtiger als die Versionsnummer. Ein hoher Wert in einem Codierungstest macht Sonnet nicht automatisch zur besseren Wahl für jede Architekturentscheidung.
| Spezifikationen |
Claude Sonnet 5.5 |
| Veröffentlichungsdatum |
28. September 2026 |
| Claude-API-Modell-ID |
claude-sonnet-5-5 |
| Kontextfenster |
1 Million Tokens |
| Maximale Ausgabe |
128.000 Tokens bei Standardanfragen |
| Modalitäten |
Text- und Bildeingabe; Textausgabe |
| Thinking |
Adaptiv, standardmäßig aktiviert |
Dies sind die von Anthropic veröffentlichten Spezifikationen. Ein Kontextfenster von 1 Million Tokens ist beträchtlich, aber kein neuer Vorteil gegenüber Sonnet 5, das ebenfalls 1 Million Tokens unterstützt. Ein großes Kontextfenster ist auch kein Beweis dafür, dass jedes Detail einer langen Eingabe korrekt verwendet wird. Sonnet 5.5 verwendet außerdem weiterhin den Tokenizer von Sonnet 5, sodass derselbe Text bei beiden Modellen gleich viele Tokens umfasst. In Anthropics Migrationsdokumentation wird dieser letzte Punkt ausdrücklich erwähnt.
Was hat sich gegenüber Sonnet 5 geändert?
Die entscheidende Verbesserung besteht darin, wie viel Arbeit Sonnet 5.5 in einer bestimmten Zeit mit einer bestimmten Rechenleistung erledigen kann. Laut Anthropic erzeugt es Ausgaben mehr als 30 % schneller als Sonnet 5. Bei der agentischen Codierungsbewertung Terminal-Bench 4.0 erzielte Sonnet 5.5 70,6 %, verglichen mit 10,3 % bei Sonnet 5. Anthropic berichtet außerdem, dass das neuere Modell Tool-Aufrufe häufiger bündelt und dadurch bei manchen Codierungsaufgaben weniger Schritte benötigt. Dies sind Ergebnisse von Anthropic, die in bestimmten Testszenarien gemessen wurden.
Es gibt auch eine externe Überprüfung, die allerdings eine andere Frage stellt. Bei CursorBench 4.0 erzielte Sonnet 5.5 mit hoher Anstrengungsstufe 47,8 % bei gemeldeten Kosten von 1,67 $ pro bewerteter Aufgabe; Sonnet 5 mit hoher Anstrengungsstufe erreichte 30,8 % bei 3,48 $. Das spricht für eine Verbesserung in der Codierungsumgebung von Cursor. Daraus lässt sich jedoch nicht ableiten, wie viel ein API-Kunde mit einem anderen Agenten, Prompt oder Repository genau einsparen wird.
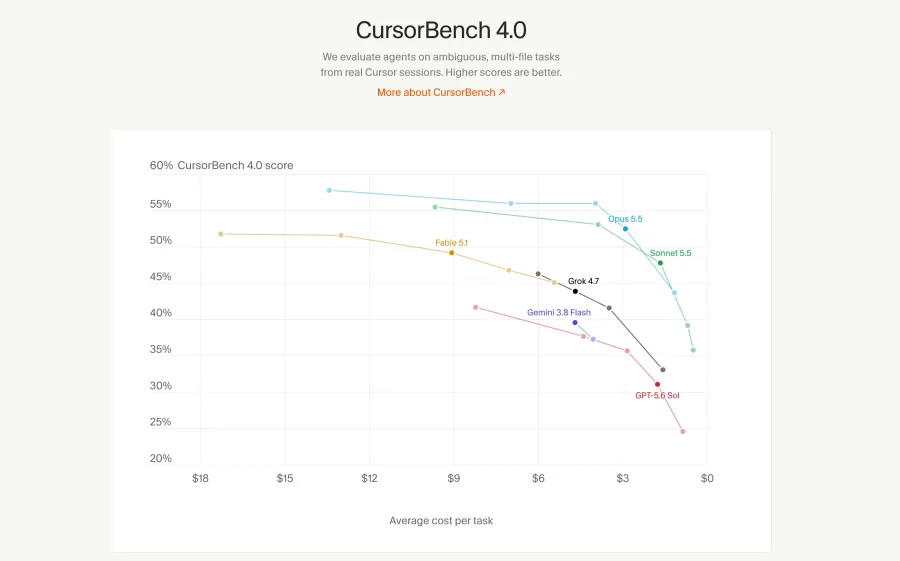
Für Codierungsteams ist das Upgrade daher interessanter als ein routinemäßiger Versionssprung. Allerdings muss ein starkes Benchmark-Ergebnis auch den eigenen Tests standhalten. Wenn Sie wissen möchten, wo das Vorgängermodell startete, lesen Sie unseren Leitfaden zu Sonnet 5 und die Sonnet-5-API-Seite.
Preise für Sonnet 5.5: gleicher Listenpreis, potenziell weniger Tokens pro Aufgabe
Laut den von Anthropic veröffentlichten API-Preisen kostet Sonnet 5.5 pro Million Tokens genauso viel wie Sonnet 5. Die Preise von GPT Proto für Sonnet 5.5 liegen 10 % unter diesen Eingabe- und Ausgabepreisen:
| Pro 1 Million Tokens |
Anthropic-Listenpreis |
GPT Proto Sonnet 5.5 |
| Eingabe |
$2.00 |
$1.80 |
| Ausgabe |
$10.00 |
$9.00 |
Anthropic berechnet für Cache-Lesevorgänge 0,20 $ pro Million Tokens; für Cache-Schreibvorgänge und andere Gebühren gelten eigene Preise. Prüfen Sie die aktuellen Abrechnungsdetails auf der GPT Proto-Modellseite, bevor Sie die Kosten einer zwischengespeicherten Arbeitslast schätzen. Die Anthropic-Preise und die Tatsache, dass sie denen von Sonnet 5 entsprechen, stammen aus der Veröffentlichungsankündigung. Die oben genannten GPT Proto-Preise für Eingabe und Ausgabe berücksichtigen den Modellrabatt von 10 %.
Hier ist eine bewusst einfache Berechnung. Wenn eine Anfrage 100.000 gewöhnliche Eingabe-Tokens und 20.000 Ausgabe-Tokens umfasst und keine Cache- oder Toolgebühren anfallen, betragen die Tokenkosten zu Anthropics Listenpreisen 0,40 $ und zu den angegebenen GPT Proto-Preisen 0,36 $. Dieser Vergleich gilt bei identischer Tokenanzahl. Unabhängig davon gibt Anthropic an, dass Sonnet 5.5 in den eigenen Tests typische Aufgaben mit weniger Tokens erledigte und dadurch die Kosten pro abgeschlossener Aufgabe um bis zu 30 % gegenüber Sonnet 5 senkte. Ihr Ergebnis hängt von der Aufgabe und der gewählten Anstrengungsstufe ab. Die 30 % sind keine Senkung des Tokenpreises und sollten nicht einfach zum 10-prozentigen Preisnachlass von GPT Proto addiert werden. Informationen zur Abrechnung auf Kontoebene finden Sie unter GPT Proto-Preise.
Eignet sich Sonnet 5.5 zum Programmieren und ist es in Claude Code verfügbar?
Ja. Im Modellleitfaden für Claude Code von Anthropic ist Sonnet 5.5 aufgeführt. Wählen Sie es in Claude Code mit /model aus oder starten Sie eine Sitzung mit claude --model claude-sonnet-5-5. Claude Code und die Claude-Apps verwenden für dieses Modell standardmäßig die mittlere Anstrengungsstufe; bei der Claude API ist standardmäßig die hohe Stufe eingestellt. Die Anstrengungsstufe bestimmt, wie lange das Modell an einem Problem arbeitet, und wirkt sich auf Qualität, Dauer und abgerechnete Ausgabe aus. Die Standardeinstellungen sind daher wichtig, wenn jemand einen bei maximaler Anstrengung erzielten Wert so zitiert, als würde er eine gewöhnliche Claude-Code-Sitzung beschreiben.
In einem frühen direkten Vergleich eines Entwicklers führte der Autor zehn persönliche Codierungsaufgaben je Konfiguration dreimal mit hoher Anstrengungsstufe in Claude Code und pi-agent aus. In diesem Setup benötigte Sonnet 5.5 weniger Durchläufe und Ausgabetokens als Sonnet 5. Der Autor merkte außerdem an, dass neuere Modelle bereits fast alle Aufgaben bewältigten, wodurch sich aus dem Test nur begrenzt Rückschlüsse auf schwierige Arbeit ziehen ließen. Das ist eine nützliche Beobachtung zum Arbeitsablauf, aber keine allgemeingültige Erfolgsquote.
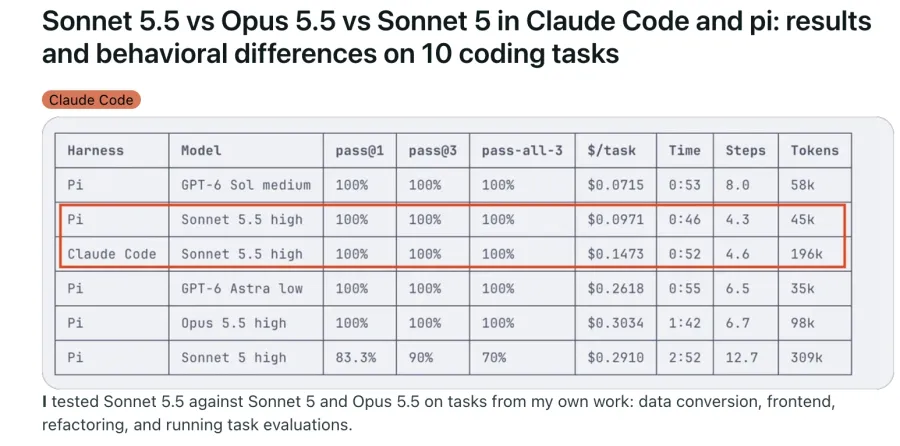
Bei klar spezifizierter Implementierung und Fehlerbehebung würde ich zuerst Sonnet 5.5 testen. Bei einer unklaren Architekturänderung oder einer Überprüfung, bei der ein übersehenes Detail kostspielig wäre, würde ich auch Claude Opus 5.5 testen. Anthropic sagt selbst, dass Opus bei komplexen, offenen Aufgaben weiterhin leistungsfähiger ist – trotz der hohen Ergebnisse von Sonnet 5.5 in einzelnen Benchmarks. In der Diskussion zur Veröffentlichung wird diese Abgrenzung klar dargestellt.
Sollten Sie eine bestehende Sonnet-5-Integration aktualisieren?
Wahrscheinlich, wenn Ihre eigenen Tests eine Verbesserung zeigen. Bei einer bestehenden API-Integration ist das Ändern der Modellzeichenfolge jedoch nur der erste Schritt. In Anthropics Migrationsleitfaden für Sonnet 5.5 werden Anfrageeinstellungen dokumentiert, die nach dem Wechsel einen 400-Fehler verursachen können:
| Wenn Ihre Sonnet-5-Integration Folgendes tut |
Vor dem Wechsel prüfen |
Sendet thinking: {"type":"disabled"} |
Sonnet 5.5 verwendet between_tools als niedrigste Thinking-Einstellung. |
Erzwingt ein bestimmtes Tool mit tool_choice |
Sonnet 5.5 weist erzwungene Auswahlmöglichkeiten für tool und any zurück. Prüfen Sie den dokumentierten Ansatz mit auto. |
| Verwendet eine ältere Version des Computer-Use-Tools |
Der unterstützte Werkzeugsatz unterscheidet sich je nach Plattform. Folgen Sie der Migrationstabelle für Ihre Plattform. |
| Geht davon aus, dass der erste Antwortblock Text enthält |
Lesen Sie die Blöcke anhand ihres Typs aus und erhalten Sie Thinking-Blöcke in Tool-Schleifen. |
Es gibt noch eine weniger offensichtliche Änderung: Die Anstrengungsstufen wurden neu kalibriert. Die hohe Stufe bei Sonnet 5.5 muss nicht denselben Arbeitsaufwand bedeuten wie die hohe Stufe bei Sonnet 5. Anthropic empfiehlt, eigene Tests zu Qualität, Latenz und Kosten erneut durchzuführen, statt eine frühere Einstellung einfach zu übernehmen. Das ist besonders relevant, wenn Ihr Agent wiederholt Tools aufruft oder Sie die Modellausgabe in einem festen Format verarbeiten.
Für eine einfache GPT Proto-Chat-Anfrage verwenden Sie auf der Modellseite die Aktion Dieses Modell ausprobieren und den Bereich API-Nutzung, um zu prüfen, ob Sonnet 5.5 aktiv ist und ob die angezeigte Modell-ID claude-sonnet-5-5 lautet. Sobald es aktiv ist, sieht eine standardmäßige GPT Proto-Chat-Completions-Anfrage so aus:
curl --request POST 'https://gptproto.com/v1/chat/completions' \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "claude-sonnet-5-5",
    "messages": [{"role": "user", "content": "Summarize the risks in this project brief in three sentences."}]
  }'
Legen Sie vor der Ausführung Ihren eigenen Schlüssel für GPTPROTO_API_KEY fest. GPT Proto zeigt dieses Anfrageformat auf den bestehenden Claude-Modellseiten. Die Modellseite von Sonnet 5.5 ist die maßgebliche Quelle für die aktuelle Modellzeichenfolge und Verfügbarkeit. Anbieterabhängige Optionen der Claude Messages API müssen separat auf Kompatibilität geprüft werden, wenn sie über einen OpenAI-kompatiblen Endpunkt verwendet werden.
Wie schneidet Sonnet 5.5 im Vergleich zu anderen Modellen ab?
Ein Erklärartikel kann nicht jede Vergleichssuche mit einer einzigen Bestenliste beantworten. Der Vergleich hängt von der Aufgabe, dem Agenten-Setup, der Anstrengungsstufe und dem betrachteten Preis ab. Diese drei Referenzpunkte sind hilfreich, aber jeweils nur begrenzt aussagekräftig:
| Frage |
Aussage eines vergleichbaren Tests |
Was sich daraus nicht ableiten lässt |
| Sonnet 5.5 im Vergleich zu GPT-6 Astra |
Bei der Code-Migration-Bewertung von Vals AI erzielte Sonnet 5.5 69,83 % und Astra 67,74 %. |
Welches Modell bei allen Codierungs-, Recherche- oder Schreibaufgaben besser ist. |
| Sonnet 5.5 im Vergleich zu GLM-5.3 |
Bei CursorBench 4.0 erzielte Sonnet 5.5 mit hoher Anstrengungsstufe 47,8 % und GLM-5.3 mit hoher Anstrengungsstufe 38,0 %. |
Leistung oder Kosten in Ihrem eigenen Agenten und Repository. |
| Sonnet 5.5 im Vergleich zu Claude Fable 5.1 |
Im Vals Index erzielte Sonnet 5.5 69,22 % und Fable 5.1 68,83 %. |
Ein verlässlicher Gesamtsieger lässt sich aus einem kleinen Abstand bei einem zusammengesetzten Wert nicht bestimmen. |
Die Astra- und Fable-Ergebnisse stammen aus der Bewertung von Vals AI, die angibt, bei den meisten Tests die maximale Anstrengungsstufe verwendet zu haben. Das GLM-Ergebnis stammt aus Cursors eigenem Benchmark. Kombinieren Sie die Ergebnisse dieser beiden Quellen nicht zu einer einzigen Rangliste. Wenn eine bestimmte Alternative günstiger ist oder bereits zu Ihrem Stack passt, kommt es darauf an, ob Sonnet 5.5 Ihre Aufgabe genauer oder mit geringeren Gesamtkosten erledigt.
Wer sollte Sonnet 5.5 ausprobieren?
Beginnen Sie mit Aufgaben, bei denen das Ziel klar erkennbar ist: eine klar definierte Codeänderung, ein Fehler mit einem fehlschlagenden Test, ein Dokument mit zugehörigen Quellen oder eine wiederholbare Analyse. Lassen Sie denselben kleinen Satz realer Aufgaben mit Sonnet 5 und 5.5 bei ausdrücklich festgelegten Anstrengungsstufen ausführen. Erfassen Sie, ob die Antwort korrekt ist, ob das Modell seine Arbeit überprüft hat, wie lange es gedauert hat und wie viele Tokens abgerechnet wurden. Das liefert eine wesentlich bessere Grundlage für die Entscheidung über ein Upgrade als der höchste Prozentwert vom Veröffentlichungstag.
Sonnet 5.5 ist ein starker Kandidat für solche klar begrenzten Aufgaben. Es ist jedoch nicht ratsam anzunehmen, dass ein einzelner Benchmark es bei offenen Aufgaben zu einem Ersatz für Opus macht oder dass sich die von Anthropic maximal angegebene Einsparung auf jeder Rechnung zeigt. Sobald die Sonnet-5.5-API-Seite auf GPT Proto verfügbar ist, können Sie es neben den anderen oben verlinkten Modellen mit demselben Konto testen und Ihre eigenen Ergebnisse vergleichen.