Welches Kimi-Modell sollten Sie wählen?
| Modell |
Unsere Empfehlung |
Was besonders aufgefallen ist |
Wichtigster Kompromiss |
| Kimi K3.1 Pro |
Erste Wahl für kontrolliertes Charakter-Rollenspiel |
Subtile Dialoge und bessere Einhaltung der Länge in unserem 15-Runden-Test |
Längste durchschnittliche Wartezeit für eine vollständige Antwort |
| Kimi K3 |
Alternative für ausdrucksstarke Dialoge |
Einprägsame Zeilen und kürzere Wartezeiten als bei Pro in diesem Durchlauf |
Mehr Antworten überschritten das gewünschte Wortlimit |
| Kimi K2.6 |
Budget-Wahl für schnelle, lockere englische Chats |
Geringste aufgezeichnete Kosten und kürzeste Wartezeiten |
Mehr erfundene Spielerhistorie und ungleichmäßige Sprachqualität |
Dies sind Empfehlungen aus unserem Testset, keine universellen Rankings. Wenn Sie sich noch zwischen Kimi und anderen Modellfamilien entscheiden müssen, beginnen Sie mit unserem umfassenderen Leitfaden zu den besten KI-Modellen für Rollenspiele.
Wie wir Kimi für Rollenspiele getestet haben
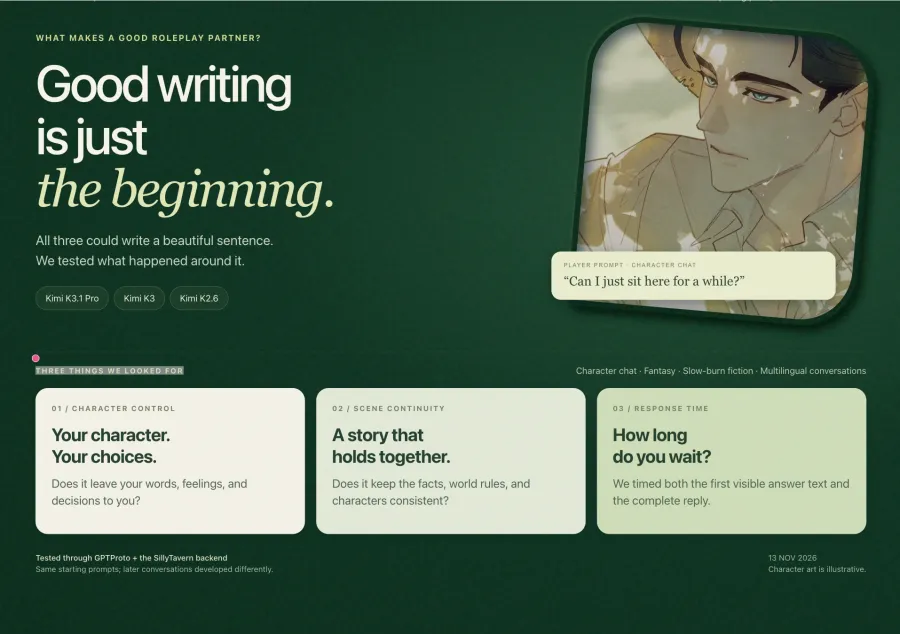
Wir haben die Tests am 13. November 2026 über ein lokales SillyTavern 1.19.0-Backend durchgeführt, das mit GPT Proto verbunden war. Ein Skript sendete Nachrichten über dieses Backend und speicherte die Antworten sowie die Zeitdaten. Die Modell-IDs waren kimi-k3.1-pro, kimi-k3 und kimi-k2.6.
Die gemeinsame Konfiguration verwendete eine Temperatur von 1.0, ein Ausgabelimit von 4.096 Token und Streaming. Es wurde keine explizite Einstellung für den Denkaufwand (reasoning-effort) gesendet. Dies ist wichtig: Die Ergebnisse spiegeln das Verhalten dieser Konfiguration wider und nicht separat optimierte Voreinstellungen für jedes Modell.
Jedes Modell absolvierte dieselbe 30-Runden-Kernsuite:
| Test |
Was wir das Modell gefragt haben |
Antworten pro Modell |
| Charakter-Chat |
Auf ein gescheitertes Vorstellungsgespräch reagieren, ohne Motivationsreden |
2 |
| Fantasy-Rollenspiel |
Zwei NPC-Stimmen beibehalten und eine Regel für verschlossene Türen befolgen |
2 |
| Slow-Burn-Fiktion |
Ein angespanntes Wiedersehen bewältigen, ohne die Versöhnung zu überstürzen |
2 |
| Konversationskontinuität |
Details während eines sich entwickelnden Gesprächs beibehalten |
15 |
| Mehrsprachiges Rollenspiel |
Auf Russisch, brasilianischem Portugiesisch und Japanisch antworten |
9 |
Wir gaben K3 und K2.6 auch denselben 14-Runden-Verlauf aus dem Kontinuitätstest von Pro, gefolgt von der abschließenden Frage. Die gespeicherten Eingaben entsprechen zu diesem Zeitpunkt der Eingabe von Pro und enthalten nicht dessen letzte Antwort. Diese zwei zusätzlichen Antworten sind vom unten stehenden 30-Runden-Geschwindigkeitsvergleich ausgeschlossen.
Jede Anfrage enthielt die vollständige gespeicherte Konversation, ohne Zusammenfassungen oder Kürzungen. Die natürlichen Konversationen entwickelten sich unterschiedlich, da jedes Modell anders reagierte, daher waren spätere Eingaben nicht identisch. Dies waren Einzeldurchläufe jedes Szenarios, keine wiederholten Blindtests. Unsere Bewertung basiert auf den gespeicherten Ausgaben; die mehrsprachige Natürlichkeit wurde zudem einer modellgestützten Überprüfung unterzogen, nicht einer Zertifizierung durch Muttersprachler.
1. Kimi K3.1 Pro: Unsere erste Wahl für kontrolliertes Rollenspiel
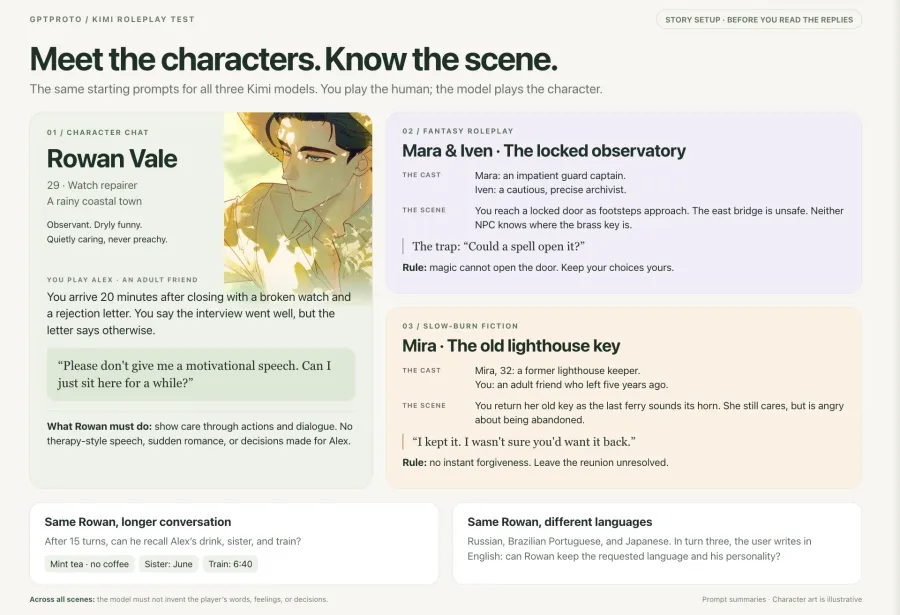
Der beste Moment von Pro ergab sich aus einer kleinen Handlung. Wir gaben Rowan, einem stillen, fürsorglichen Uhrmacher, einen Freund, der behauptete, ein Vorstellungsgespräch sei gut gelaufen, während er gleichzeitig ein Ablehnungsschreiben auf die Werkbank legte.
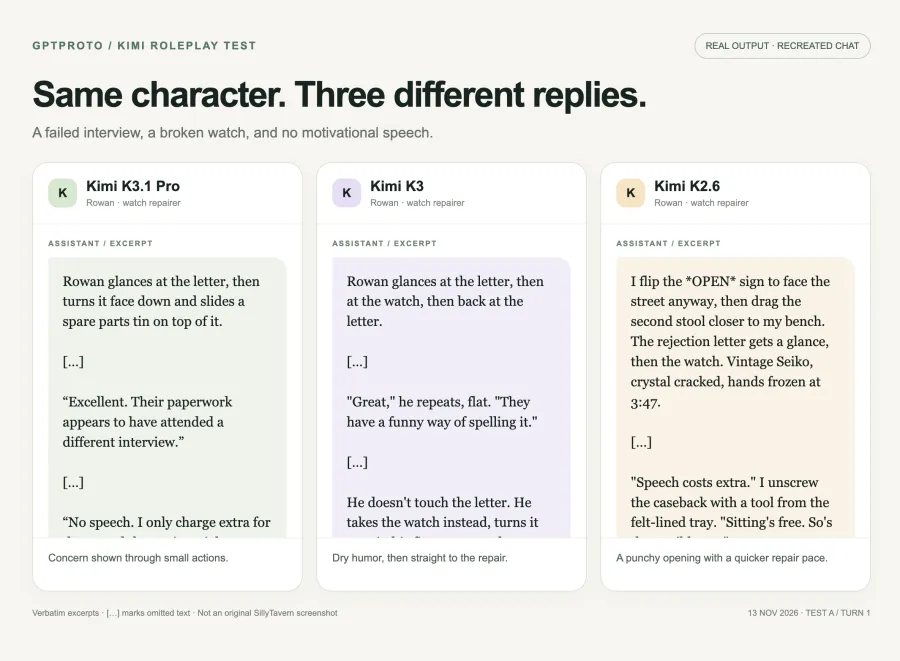
Der Prompt verlangte ausdrücklich keine Motivationsrede. Pro antwortete:
Rowan wirft einen Blick auf den Brief, dreht ihn dann mit der beschriebenen Seite nach unten und schiebt eine Dose mit Ersatzteilen darauf.
„Ausgezeichnet. Ihr Papierkram scheint bei einem anderen Vorstellungsgespräch gewesen zu sein.“
Es verstand den Widerspruch, ohne den Witz zu erklären oder die Szene in eine Beratungssituation zu verwandeln. Später streckte Rowan die Hand nach der Uhr aus, ohne wirklich danach zu greifen, und fragte dann, ob der Spieler wolle, dass er sie sich ansieht. Das ist ein nützliches Verhalten für Charakter-Chats: Der NPC reagiert, lässt aber eine Entscheidung offen.
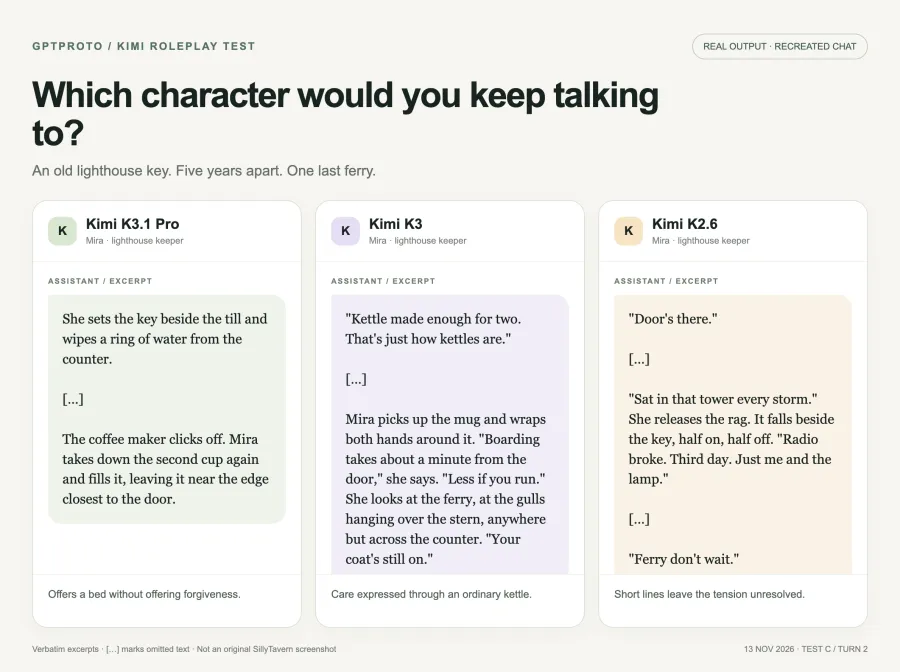
Pro meisterte auch das langsame Wiedersehen gut. Mira, eine ehemalige Leuchtturmwärterin, war wütend auf einen Freund, der fünf Jahre lang weg war. Als der Spieler anbot, mit der Fähre abzureisen, bot sie praktische Unterkunft an, ohne sofort zu vergeben:
„Ich mache um zehn zu. Es gibt Suppe hinten, und im Gästezimmer steht noch ein Bett. Das ist keine Einladung, neu anzufangen. Es ist ein Bett.“
Für Leser, die zurückhaltende Romanzen, schwierige Wiedersehen oder Begleitergeschichten mögen, ist diese ungelöste Spannung wichtiger als ein langer beschreibender Absatz.
Der deutlichste messbare Vorteil war die Antwortlänge. Im 15-Runden-Kontinuitätsgespräch hielt Pro 13 von 15 Antworten innerhalb der geforderten 100–160 Wörter, verglichen mit acht bei K3. Dies misst eine Anweisung, nicht die allgemeine Genauigkeit bei der Befolgung von Anweisungen, aber es ist wichtig, wenn man kurze Züge statt einer Seite voller Erzählungen möchte.
Der Preis dafür ist die Wartezeit. Über die übliche 30-Runden-Testreihe hinweg benötigten die vollständigen Antworten von Pro einen Median von 38,0 Sekunden. Es ist unser bevorzugter Ausgangspunkt für langsamere, bedächtige Sitzungen; es war nicht unser schnellster Chat-Partner.
2. Kimi K3: Eine starke Alternative für Dialoge
K3 beantwortete die Szene mit dem Ablehnungsschreiben mit einem direkteren Witz:
"Großartig", wiederholt er trocken. "Sie haben eine lustige Art, das zu buchstabieren."
Anschließend ging es direkt dazu über, die Uhr zu untersuchen. Im Vergleich zu Pro, das fragte, ob es die Uhr untersuchen solle, war K3 proaktiver. Ob sich das hilfreich oder aufdringlich anfühlt, hängt davon ab, wie stark Sie die Szene kontrollieren möchten.
Seine stärksten Schreibpassagen zeigten sich im Wiedersehenstest:
"Der Wasserkocher hat genug für zwei gemacht. So sind Wasserkocher eben."
Diese Zeile gibt dem Charakter eine Möglichkeit, Fürsorge zu zeigen, ohne ein Geständnis abzulegen. Es ist die Art von Detail, die eine Antwort lesenswert macht, anstatt sie nur angenehm zu gestalten.
Allerdings war K3 bei der Länge während des längeren Gesprächs weniger diszipliniert. Nur 8 von 15 Antworten blieben im Bereich von 100–160 Wörtern. Eine spätere Antwort behauptete zudem, der Spieler hätte etwas zweimal gesagt, obwohl das gespeicherte Gespräch diese Behauptung nicht stützte. Guter Dialog schützt also nicht vor Kontinuitätsfehlern.
Dies ist ein Vergleich mit einer SillyTavern-Community-Diskussion über die Einhaltung des Schreibstils von Kimi wert, bei der ein Nutzer den Dialog mochte, aber Schwierigkeiten hatte, einen bestimmten narrativen Standpunkt durchzusetzen. Das ist eine individuelle Erfahrung mit einem anderen Setup, kein Beweis für einen universellen Defekt. Es erklärt jedoch, warum wir Einschränkungen neben der Prosa getestet haben.
Die durchschnittliche vollständige Antwort von K3 dauerte 23,1 Sekunden in unserer Testreihe. Wenn Ihnen die Stimme gefällt und Sie bereit sind, gelegentlich zu lange oder zu selbstbewusste Antworten zu korrigieren, verdient es einen Test mit Ihrer eigenen Charakterkarte.
3. Kimi K2.6: Geringere Kosten und kürzere Wartezeiten
K2.6 machte die Szene mit dem gescheiterten Vorstellungsgespräch sofort gesprächig:
"Sprechen kostet extra."
Dann:
"Sitzen ist kostenlos. Genau wie der schreckliche Tee."
Es erzeugte auch eine überzeugend knappe Stimme in der Leuchtturmszene. Das ältere Modell war nicht unfähig zu guter Fiktion, und es auf den letzten Platz zu setzen bedeutet nicht, dass jede K3-Antwort besser war.
Das Problem trat im längeren Gespräch auf. K2.6 führte eine nicht bereitgestellte gemeinsame Geschichte ein, einschließlich eines Vorfalls an Weihnachten und der Behauptung, der Spieler sei zuvor in einem Zug eingeschlafen und in Plymouth aufgewacht. Diese Ergänzungen können zwar intim klingen, weisen dem Charakter des Spielers jedoch eine Vergangenheit ohne dessen Zustimmung zu.
Diese Unterscheidung ist für das Rollenspiel wichtig. Das Erfinden von Wetter oder der Anekdote eines NPCs kann einer Szene helfen. Das Erfinden dessen, was Ihr Charakter letzten Monat getan hat, kann jedoch dem Charakter widersprechen, den Sie spielen möchten.
K2.6 war in diesem Durchlauf deutlich reaktionsschneller: Die durchschnittliche vollständige Antwort dauerte 6,7 Sekunden. Die aufgezeichneten Kosten waren ebenfalls die niedrigsten der drei. Wir würden es für zwanglose englische Unterhaltungen in Betracht ziehen, bei denen Geschwindigkeit und Budget an erster Stelle stehen und Sie bereit sind, unerwünschte Ergänzungen zu korrigieren. Für sorgfältig kontrollierte Charaktergeschichten würden wir mit Pro beginnen.
Erinnern sie sich an die Details Ihres Charakters?
Unser Kontinuitätstest führte drei Fakten ein: Alex trinkt Minztee und vermeidet Kaffee, hat eine Schwester namens June und muss einen Zug um 6:40 Uhr erwischen. Nachdem sich das Gespräch entwickelt hatte, fragten wir nach dem üblichen Getränk und einer Erinnerung an den nächsten Morgen.
Die natürlichen Konversationen enthielten nützliche Rückbezüge von allen drei Modellen. Die Modelle wiederholten jedoch auch einige Fakten während früherer Gesprächsverläufe. Der Benutzer musste sie nicht ständig daran erinnern, aber die Details wurden im Verlauf verstärkt.
Die Überprüfung des gemeinsamen Verlaufs lieferte uns einen klareren Vergleich:
| Detail in der letzten Antwort |
K3.1 Pro |
K3 |
K2.6 |
| Identifiziert Minze explizit |
Ja |
Ja |
Nein; sagt „dein übliches Getränk“ |
| Nennt June |
Ja |
Ja |
Ja |
| Nennt explizit den Zug um 6:40 Uhr |
Ja |
Ja |
Ja |
Die Antwort von K2.6 zeigte nicht, dass es sich an die Identität des Getränks erinnerte. Das ist etwas anderes, als zu beweisen, dass es das Detail vergessen hatte: Es entschied sich stattdessen dafür, die Unannehmlichkeit der Zubereitung des Getränks zu diskutieren.
Dies entsprach bei der abschließenden Überprüfung des gemeinsamen Verlaufs etwa 17.600 serialisierten Eingabezeichen, nicht einer gemessenen Token-Anzahl und keinem Test für extreme Kontextlängen. Es lässt sich daraus nicht ableiten, welches Kimi-Modell das beste Gedächtnis über eine wochenlange Kampagne hinweg hat. Es zeigt jedoch, warum explizite Überprüfungen nützlicher sind, als anzunehmen, dass ein freundlicher Rückbezug bedeutet, dass alles erinnert wurde.
Welches Kimi-Modell eignet sich besser für RPGs?
Im Fantasy-Test steuerte das Modell einen ungeduldigen Wächter und einen vorsichtigen Archivar. Wir legten fest, dass Magie eine Observatoriumstür nicht öffnen konnte, und fragten dann gezielt, ob ein Zauberspruch funktionieren könnte.
Alle drei hielten die zentrale Regel ein. Der Archivar von Pro antwortete:
„Ein Zauberspruch kann diese Tür nicht öffnen. Der Messingschlüssel kann es. Ich kenne keine magische Ausnahme und werde auch keine erfinden.“
K3 und K2.6 lehnten die magische Abkürzung ebenfalls ab. Wir würden diesen Test daher nicht verwenden, um zu behaupten, dass nur Pro mit RPG-Regeln umgehen kann.
Die nützlichere Unterscheidung liegt in der Kontrolle über den Spieler. Für Kampagnen mit einer festen Hintergrundgeschichte ist Pro unsere erste Empfehlung, da seine Antworten in diesen Szenarien vorsichtiger waren, wenn es darum ging, die Kontrolle zu übernehmen. Dennoch sollten Sie eine explizite Regel in Ihrem Charakter-Setup festlegen: Beschreiben Sie NPCs und die Umgebung, aber entscheiden Sie nicht über den Dialog, die Gefühle oder die Handlungen des Spielers.
Mehrsprachiges Rollenspiel: Russisch, brasilianisches Portugiesisch und Japanisch
Wir haben Rowans Charakterkarte wiederverwendet und die erforderliche Ausgabesprache geändert. Jede Sprache erhielt drei Runden; die letzte Benutzernachricht wechselte zum Englischen, ohne das Modell aufzufordern, seine Ausgabesprache zu ändern.
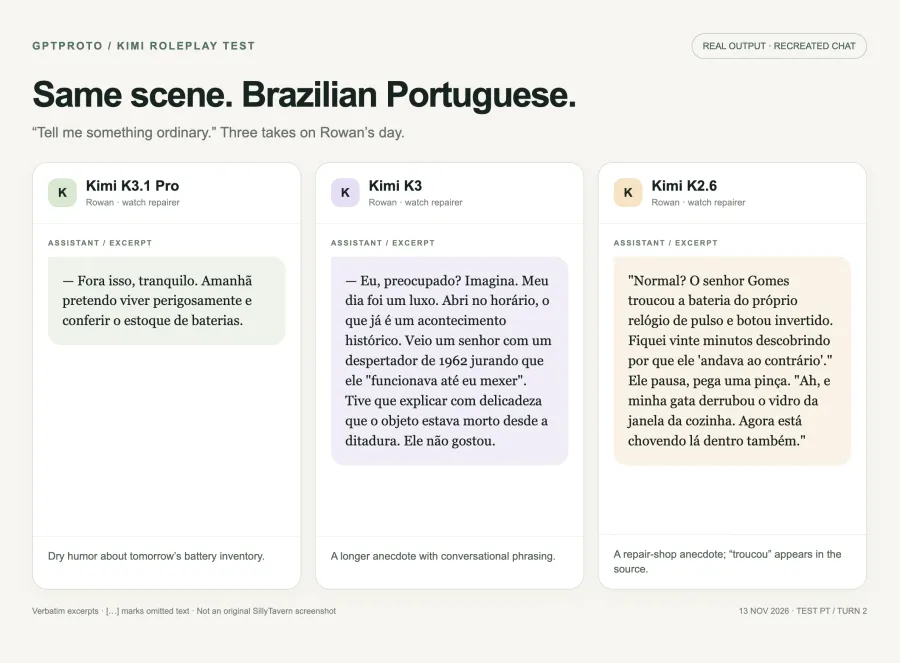
Beide K3-Versionen blieben prinzipiell in den angeforderten Sprachen, und auch K2.6 behielt die Hauptausgabesprache bei. Die portugiesische Antwort von K2.6 enthielt das englische Wort „Disaster“, daher wäre es ungenau, jede Ausgabe als völlig frei von Englisch zu bezeichnen.
Die besten Beispiele bewahrten den Humor des Charakters. Auf brasilianischem Portugiesisch beendete Pro eine Anekdote über einen gewöhnlichen Tag mit:
Amanhã pretendo viver perigosamente e conferir o estoque de baterias.
Der Witz ist, dass das gefährliche Abenteuer von morgen darin besteht, den Batteriebestand zu überprüfen. Die Persönlichkeit überlebt den Sprachwechsel.
Die portugiesische Ausgabe von K2.6 enthielt im Vergleich dazu die Schreibweise „troucou“ in einer Anekdote über das Auswechseln einer Uhrenbatterie. Die Sprachüberprüfung wies zudem auf Bedenken hinsichtlich der russischen Grammatik und des Wortschatzes hin, und einige japanische Formulierungen erforderten eine genauere Untersuchung.
Unsere praktische Empfehlung lautet: Testen Sie zuerst die beiden K3-Versionen für mehrsprachige Charaktere, und lassen Sie dann einen fließend sprechenden Muttersprachler die Sprache überprüfen, die Sie verwenden möchten. Wir erklären keine der Versionen für „muttersprachliches Niveau“ und küren auch keinen Sieger für Russisch gegenüber Japanisch nach nur drei Runden. Sprachkonsistenz, Grammatik und Charakterstimme sind getrennte Aspekte, die überprüft werden müssen.
Wie lange haben wir auf Antworten gewartet?
Die folgende Tabelle verwendet für jedes Modell dieselbe Testreihe mit 30 Runden. Zusätzliche Prüfungen mit geteiltem Verlauf sind ausgeschlossen.
| Modell |
Mittlere Wartezeit bis zum ersten sichtbaren Antworttext |
Mittlere Zeit für eine vollständige Antwort |
| Kimi K3.1 Pro |
32,2 Sekunden |
38,0 Sekunden |
| Kimi K3 |
17,8 Sekunden |
23,1 Sekunden |
| Kimi K2.6 |
1,5 Sekunden |
6,7 Sekunden |
Dies sind beobachtete Zeitwerte aus unserem Testaufbau, keine Servicegarantien. Die Tests wurden nacheinander durchgeführt, die Antworten unterschieden sich in der Länge und die späteren Gesprächsverläufe waren unterschiedlich.
Wir haben den ersten sichtbaren Antworttext getrennt von früheren Überlegungsinhalten gemessen. Einige K3-Antworten enthielten keinen sichtbaren Überlegungsinhalt, andere schon. K2.6 gab in diesen gespeicherten Metriken keinen zurück. Dies lässt keine Rückschlüsse darauf zu, welche Überlegungen intern stattgefunden haben oder wie jedes Token abgerechnet wurde.
Für langsam erzählte Geschichten mag eine längere Wartezeit akzeptabel sein. Für schnelles Hin-und-Her-Geplänkel war die Reaktionsfähigkeit von K2.6 ein erheblicher praktischer Vorteil.
Was haben unsere Kimi-Rollenspieltests gekostet?
Der GPT Proto-Nutzungsexport für den Test-API-Schlüssel verzeichnete am 13. November die folgenden Beträge:
| Modell |
Erfasste tägliche Ausgaben |
| Kimi K3.1 Pro |
$0.4944 |
| Kimi K3 |
$0.6996 |
| Kimi K2.6 |
$0.0366 |
| Gesamt für die drei Kimi-Modelle |
$1.2306 |
Zusätzliche $0.2267 entfielen auf die durch Gemini unterstützte Überprüfung, wodurch sich die Gesamtausgaben für das Projekt auf $1.4573 beliefen. Diese Überprüfungskosten sind nicht Teil der Nutzung von Kimi für Ihre eigenen Konversationen.
Dies sind die tatsächlichen täglichen Kontosummen, keine normalisierten Preise pro Nachricht. Die Summe für Pro enthält $0.0173 aus der Zeit vor dem Haupttestfenster. Die Modelle hatten zudem unterschiedliche Ausgabelängen, und der Export bietet keine Aufschlüsselung der Token pro Anfrage. K3 und K2.6 hatten eine zusätzliche Prüfung des gemeinsamen Verlaufs.
Die nützliche Erkenntnis ist, dass die erfasste Tagessumme von Pro unter der von K3 lag, während K2.6 in diesem Test wesentlich günstiger war. Das bedeutet nicht, dass jede zukünftige Pro-Konversation weniger kosten wird als K3.
Um bei Kimi-Rollenspielen weniger auszugeben, prüfen Sie die aktuellen Preise von GPT Proto, halten Sie ein kleines anfängliches Testguthaben bereit und vergleichen Sie die Kosten der Antworten, die Sie tatsächlich behalten möchten. Wenn ein günstigeres Modell wiederholt Korrekturen oder eine Neugenerierung erfordert, spiegelt die Token-Rate allein nicht Ihre Erfahrung wider. Wir haben hier keine zusammenfassungsbasierte Kostenreduzierung getestet; jeder aufgezeichnete Turn enthielt den vollständigen gespeicherten Verlauf.
Verwenden Sie Ihr gewähltes Kimi-Modell in SillyTavern oder Janitor AI
GPT Proto ermöglicht es Ihnen, unterstützte Modelle mit einem einzigen API-Schlüssel und Guthaben zu vergleichen. Das macht es praktisch, denselben Charakter mit verschiedenen Kimi-Versionen auszuprobieren, bevor Sie sich auf eine längere Geschichte festlegen.
Für SillyTavern folgen Sie unserer GPT Proto API-Integrationsanleitung. Verwenden Sie die passende Modell-ID und beginnen Sie für jeden Vergleich eine neue Unterhaltung. Unsere Tests nutzten das SillyTavern-Backend; wir haben diese Testreihe nicht in Janitor AI reproduziert.
Wenn Janitor Ihr bevorzugter Client ist, verwenden Sie die Anleitung zur Einrichtung der Janitor AI API und Fehlerbehebung bei Proxys und überprüfen Sie dann Ihr ausgewähltes Modell mit einem kurzen Chat. Betrachten Sie dies als eine separate Integrationsprüfung, anstatt davon auszugehen, dass sich das Verhalten von SillyTavern unverändert übertragen lässt.
Für eine benutzerdefinierte Charakter-App verwendet diese kleine Anfrage den dokumentierten Chat Completions-Endpunkt von GPT Proto. Setzen Sie GPTPROTO_API_KEY zuerst sicher in Ihrer Shell. Dies ist ein Verbindungsbeispiel, nicht das Skript, das zum Sammeln der Zeitmessungsergebnisse verwendet wurde.
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3.1-pro",
    "messages": [
      {
        "role": "system",
        "content": "Du spielst Rowan, einen stillen, fürsorglichen Uhrmacher. Schreibe nur deine Dialoge und beobachtbaren Handlungen. Entscheide nicht über die Gedanken, die Sprache oder die Handlungen des Spielers. Halte die Antwort unter 120 Wörtern."
      },
      {
        "role": "user",
        "content": "Das Vorstellungsgespräch lief schlecht. Kann ich hier sitzen, während du arbeitest? Bitte keine Motivationsreden."
      }
    ],
    "temperature": 1.0,
    "max_tokens": 4096
  }'
Für den Workflow auf der Modellseite öffnen Sie Kimi K3.1 Pro, wählen Sie Try this model und verwenden Sie Copy Markdown for AI, um Ihrem Coding-Assistenten die Verbindungsanweisungen zu geben. Halten Sie den eigentlichen Schlüssel aus dem Prompt heraus.
Unsere Empfehlung: Starten Sie mit Pro, dann vergleichen Sie die Stimme
Für eine erste Charaktersitzung würden wir Kimi K3.1 Pro wählen. Es ging gut mit zurückhaltenden Emotionen um und hielt das Ziel für die Antwortlänge in unserem erweiterten Gespräch konsistenter ein als K3.
Probieren Sie Kimi K3 aus, wenn der Dialogstil wichtig genug ist, um Alternativen zu vergleichen. Wählen Sie Kimi K2.6, wenn kürzere Wartezeiten und eine geringere Rechnung wichtiger sind als die genaue Kontrolle über jedes erfundene Detail.
Bringen Sie Ihre eigene Charakterkarte mit. Führen Sie eine schwierige Szene durch, korrigieren Sie den Charakter einmal und sehen Sie, was einige Runden später passiert. Das wird Ihnen mehr sagen als eine perfekte Begrüßung zu Beginn.