Überblick über Qwen 4 Max: Vom "Qoduck"-Blindtest bis zur 14-tägigen Vorschau
Wenn Sie einen praktischen Überblick über Qwen 4 Max wünschen, beginnen Sie mit den vier Tagen, bevor sein Name öffentlich wurde. Zwischen dem 7. und 10. November 2026 tauchte ein anonymes Modell mit dem Codenamen Qoduck in Qoder auf, einer agentenbasierten Coding-IDE. Entwickler, die Qoduck testeten, bemerkten ein ungewöhnliches Muster: Anstatt einen schnellen Code-Schnipsel im Einzeldurchlauf zurückzugeben und auf menschliches Feedback zu warten, verbrachte das Modell zehn bis fünfzehn Minuten damit, Shell-Prüfungen zu starten, benutzerdefinierte SVG-Assets von Grund auf neu zu schreiben und Komponententests gegen seine eigenen Diffs auszuführen, bevor es eine endgültige Antwort lieferte.
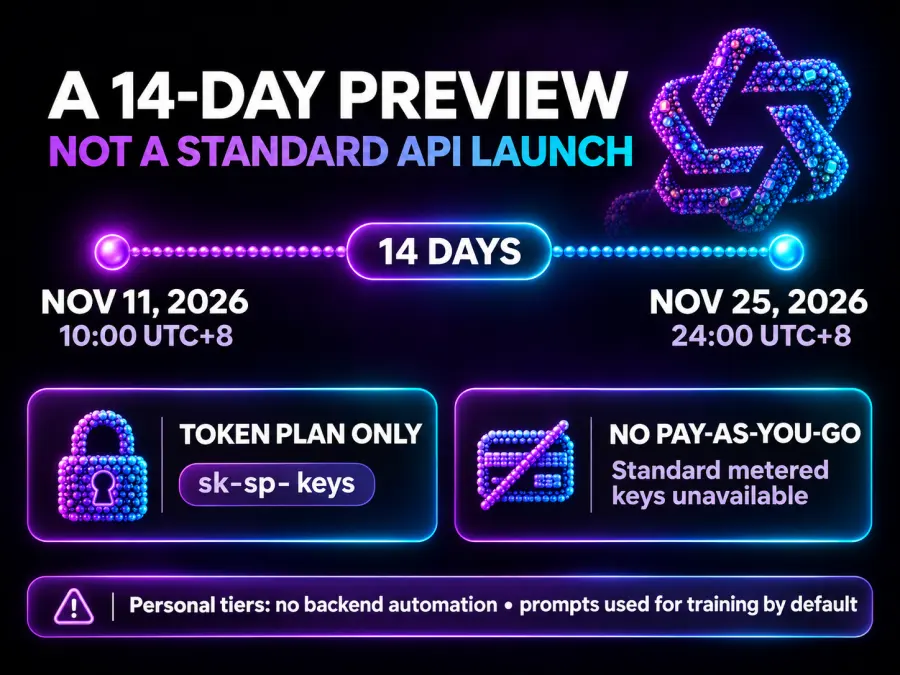
Am 11. November 2026 um 10:00 Uhr UTC+8 bestätigte Alibaba, dass Qoduck das neueste Qwen-Modell Qwen 4 Max war, und stellte es im Alibaba Cloud Model Studio unter dem Modell-String qwen4-max-preview (in ausgewählten Client-Konfigurationen als qwen4.0-max-preview bezeichnet) zur Verfügung. Anstatt einen vollständigen kommerziellen Start mit Listenpreisen pro Token zu veranstalten, gestaltete Alibaba die Einführung – in Entwicklerdokumentationen oft als Einführung von Qwen 4 Max über eine 14-tägige Qwen 4 Max-Vorschau beschrieben – so, dass agentenbasierte Workflows in Entwicklertools wie Claude Code, Cursor, Cline und Qoder einem Stresstest unterzogen werden.
| Spezifikation |
Bestätigter Status (qwen4-max-preview) |
Quelle / Technischer Hinweis |
| Offizielle Modell-ID |
qwen4-max-preview |
Alibaba Cloud Model Studio / Bailian-Dokumentation |
| Vorschauzeitraum |
11. Nov. 2026 (10:00) – 25. Nov. 2026 (24:00 UTC+8) |
Strikte 14-tägige begrenzte Vorschau |
| Kontextfenster |
1.000.000 Token (max. Eingabe: 967.000 Token) |
Verifiziert in CN- und internationalen Dokumenten |
| Maximale Ausgabe-Token |
393.216 insgesamt (131.072 endgültige Ausgabe + 262.144 Schlussfolgerung) |
max_tokens begrenzt kombiniertes Denken + Ausgabe |
| Eingabe- / Ausgabemodalitäten |
Eingabe: Text, Bild, Video · Ausgabe: Text |
Keine native Audioeingabe im Vorschaupfad |
| Steuerung der Schlussfolgerung |
reasoning_effort: low, medium, xhigh |
Denken standardmäßig aktiviert; Standardeinstellung ist xhigh |
| Unterstützte API-Protokolle |
OpenAI Chat Completions, Responses API, Anthropic Messages |
Erfordert dedizierten sk-sp- Token-Plan-Endpunkt |
| Parametergröße & Gewichte |
Nicht offengelegt (geschlossene kommerzielle Vorschau) |
2,4T / 95B-Zahlen online gehören zu Qwen3.8-Max |
| Offizielle Benchmark-Tabelle |
Nicht zum Start der Vorschau veröffentlicht |
Der kursierende 49.9 GameFeel-Score stammt von Qwen-4-Flash-Early |
Das Verständnis von qwen 4 max erklärt als generationeller Schritt hängt davon ab, wie es Rechenleistung zur Inferenzzeit aufwendet. Während frühere Versionen den Tool-Aufruf als optionalen Helfer behandelten, integriert das grundlegende qwen 4 max-Upgrade eine Selbstverifizierungsschleife in den standardmäßigen Schlussfolgerungspfad. Wenn das Modell aufgefordert wird, eine Webanwendung zu erstellen oder ein Befehlszeilen-Dienstprogramm zu patchen, verkettet es routinemäßig Dutzende von Tool-Aufrufen – es inspiziert Verzeichnisbäume, führt pytest oder lokale Headless-Browser aus, erkennt seine eigenen Syntax- oder Layout-Regressionen und schreibt die fehlerhaften Zeilen um, bevor der Benutzer die Ausgabe überhaupt sieht.
Architektur, Modellgröße und der Realitätscheck bei Benchmarks
Zwei Falschinformationen dominieren derzeit die Suchergebnisse für qwen 4 max size und qwen 4 max benchmark. Diese aufzuklären ist der schnellste Weg, um zu verstehen, was Alibaba tatsächlich veröffentlicht hat und was noch nicht bekannt gegeben wurde.
Erstens hat Alibaba weder die gesamte noch die aktive Parameteranzahl für alibaba qwen 4 max offengelegt. Mehrere Blogs von Drittanbietern führen es als ein Mixture-of-Experts (MoE)-Modell mit 2,4 Billionen Parametern und 95 Milliarden aktiven Parametern pro Token auf. Diese exakten Zahlen gehören zum vorherigen Flaggschiff, Qwen3.8-Max, das im September 2026 veröffentlicht wurde. Während Qwen 4 Max mit ziemlicher Sicherheit ein spärliches MoE-Backbone verwendet, um ein 1-Million-Token-Kontextfenster wirtschaftlich zu bedienen, ist jede spezifische Billionen-Parameter-Zahl, die Sie im November 2026 lesen, eine unbestätigte Übernahme aus der 3.8-Generation.
Was wir über die Architektur wissen, stammt aus Alibabas technischer Veröffentlichung von Qwen3.8-Flash-Next vom August 2026, das das Qwen-Team ausdrücklich als Testumgebung zur Validierung grundlegender Architektur-Upgrades für die Qwen 4-Serie bezeichnete. Dieser Vorläuferbericht dokumentierte vier strukturelle Änderungen, die erklären, wie qwen4-max-preview mit Millionen-Token-Workloads umgeht:
Hybride GDN + QSA Attention: Die Kombination von Gated DeltaNet (GDN) Linear-Attention-Layern mit Qwen Sparse Attention (QSA) reduzierte die Time-to-First-Token (TTFT) Prefill-Latenz bei einem Kontext von 1.000.000 Token um bis zu das 7,6-fache im Vergleich zur standardmäßigen Full Attention.
4-Stream Gated Residual Connections: Die Erweiterung der Breite des Residual-Streams mit gelernten Gates verbessert den Gradientenfluss und das Cross-Layer-Feature-Routing bei tiefem, mehrstufigem Reasoning.
N-Gram Embedding Layers: Das direkte Injizieren von lokalem Multi-Token-Kontext in der Embedding-Phase entlastet die frühen Attention-Blöcke vom lexikalischen Musterabgleich.
Muon Optimizer Training: Die Umstellung der groß angelegten Pretraining-Optimierung auf Muon verbesserte die Sample-Effizienz bei Code- und formalen Logik-Korpora.
Zweitens: Wenn Sie nach Ergebnissen für qwen 4 max benchmark suchen, werden Sie wahrscheinlich auf Behauptungen stoßen, dass Qwen 4 Max 49,9 Punkte im GameFeel Bench v1.4 erreicht hat und damit Claude Opus 5.5 mit 47,2 knapp übertrifft. Ich habe das Leaderboard und die zugrunde liegenden Commit-Logs überprüft: Dieser Wert von 49,9 wurde von einem frühen, leichtgewichtigen Test-Checkpoint namens Qwen-4-Flash-Early (interner Codename hawk) aufgezeichnet, nicht von qwen4-max-preview. Stand 13. November 2026 hat Alibaba keine offizielle MMLU-Pro-, SWE-bench Verified- oder AIME-Leaderboard-Tabelle für Qwen 4 Max veröffentlicht.
Was Sie jetzt sofort überprüfen können, ist die Mechanik des qwen 4 max context window und dessen Output-Budget – und genau hier stoßen migrierende Entwickler an ihre Grenzen. Während das Kontextfenster 1.000.000 Token fasst (mit einer dokumentierten Obergrenze von 967.000 Token für Prompts), ist der maximale Output auf dem internationalen Portal mit 393.216 Token angegeben, was sich auf dem inländischen Portal in 262.144 Reasoning-Token und 131.072 Token für die endgültige Antwort aufteilt.
Hier ist der Haken: Der API-Parameter max_tokens in qwen4-max-preview steuert die sum aus reasoning_content und content. Da das Modell standardmäßig auf reasoning_effort: "xhigh" eingestellt ist (die höchste von drei verfügbaren Einstellungen: low, medium und xhigh), kann ein komplexer Programmier-Prompt leicht 15.000 bis 40.000 Token innerhalb des verborgenen Denkblocks verbrauchen. Wenn Ihr bestehender Client-Code max_tokens: 4096 oder 8192 übergibt, wird das Modell sein gesamtes Kontingent mitten im Denkprozess ausschöpfen und einen leeren content-String zurückgeben. Um eine stille Kürzung zu vermeiden, erhöhen Sie entweder max_tokens auf über 65.536 oder setzen Sie reasoning_effort für Routineaufgaben explizit auf medium.
Praxistest Qwen 4 Max: Was Community- und Medientests tatsächlich zeigen
Da Alibaba auf eine klassische Pressemitteilung mit Benchmarks verzichtet hat, stammen die zuverlässigsten Daten zum qwen 4 max review von Engineering-Teams, die qwen4-max-preview in den ersten 48 Stunden der Vorschau in Live-Agenten-Umgebungen eingebunden haben. Ihre Protokolle zeigen ein klares Muster: Jeder Sprung in der Ausgabequalität geht mit einer spürbaren Latenz und höheren Token-Kosten einher.
Am 11. November veröffentlichte das japanische KI-Beratungsunternehmen WEEL eine dreiteilige Evaluierung, in der das Vorschau-Modell in den Bereichen Frontend-Synthese, Multi-Source-Recherche und Repository-Level-Debugging innerhalb von Claude Code getestet wurde:
908-zeilige benutzerdefinierte SVG-Landingpage (vs. Qwen 3.8 Max): Bei einem identischen Prompt zum Erstellen einer responsiven Landingpage für eine Physiotherapiepraxis mit Wald-Thema benötigte Qwen3.8-Max etwa 9,5 Minuten, zog jedoch zufällige externe Stockfotos, die das Raster zerstörten oder nicht geladen wurden. qwen4-max-preview benötigte etwa 17 Minuten – fast doppelt so lange. Anstatt fehleranfällige externe URLs zu verknüpfen, rief es Dutzende Male im Hintergrund seinen Code-Interpreter auf, um programmgesteuert benutzerdefinierte SVG-Illustrationen von Baumkronen, Klinikarchitektur und Mitarbeitersymbolen zu zeichnen, und lieferte eine 908-zeilige HTML-Datei ohne defekte Assets.
Autonomes CLI-Debugging in Claude Code (36/36 Tests bestanden): WEEL setzte Claude Code (betrieben durch qwen4-max-preview über den Anthropic-kompatiblen Endpunkt) auf eine lokale Python-Haushaltsbuch-CLI (kakeibo) an und bat darum, die Filter-Flags --export-csv und --month sowie Unit-Tests hinzuzufügen. Der Durchlauf dauerte 11 Minuten und 48 Sekunden. Nach dem Schreiben der ursprünglichen Implementierung führte das Modell pytest aus, fand 2 fehlerhafte Tests – einschließlich eines Grenzfalls, bei dem ein negativer Währungs-String wie -100日元 von Pythons argparse fälschlicherweise als Befehlszeilen-Flag interpretiert wurde – und korrigierte den Parser eigenständig. Ohne Aufforderung stellte es zudem einen utf-8-sig BOM-Header voran, damit japanische Schriftzeichen in Microsoft Excel nicht verstümmelt wurden, und maskierte führende =, +, - und @ Zeichen, um CSV-Formelinjektionen zu verhindern. Alle 36 Tests wurden bestanden, wobei nur 0,4 % des monatlichen Lite-Plan-Kontingents verbraucht wurden.
Selbstverifizierte Politikrecherche: Mit der Aufgabe betraut, eine Vergleichstabelle für japanische KMU-Subventionen für 2026 zu erstellen, verbrachte das Modell 2 Minuten damit, über ein Dutzend Webabfragen auf Ministeriumsportalen durchzuführen, und weitere 5 Minuten damit, grep und Python-Validierungsskripte auszuführen, um sicherzustellen, dass sich keine Markdown-Tabellenspalten verschoben, bevor das 8-minütige Ergebnis präsentiert wurde.
Zwei Tage später, am 13. November, führte die chinesische Tech-Publikation Silicon Star (GuiXingRen) einen visuellen und 3D-Engineering-Test gegen qwen4-max-preview durch. Als das Modell aufgefordert wurde, die klassische SVG-Animation „Pelikan auf einem Fahrrad“ zu generieren, artikulierte es den Pedaltritt und die Parallaxen-Baumschatten, während es ungefragt einen 0,5x–1,75x-Geschwindigkeitsregler und einen Tag/Dämmerung/Nacht-Themenwechsler hinzufügte. In einem schwierigeren Three.js-Test – dem Bau eines spielbaren 3D-Papierflieger-Spiels namens Paper Skies, bei dem das Flugzeug durch ein Schlafzimmerfenster in einen Garten fliegt – stellten die Rezensenten fest, dass die Physik und die Hindernisverarbeitung mit dem kreativitätsfokussierten Claude Fable 5.1 von Anthropic mithalten konnten, obwohl es beim Shader-Feinschliff noch hinter dem neueren Claude Fable 5.2 zurückblieb. Als das Modell gebeten wurde, die eigene responsive Homepage von Silicon Star neu zu gestalten, startete es einen lokalen Browser, erkannte, dass externe Artikel-Thumbnails 403-Hotlink-Fehler zurückgaben, ersetzte diese automatisch durch stilisierte SVG-Verlaufsplatzhalter und schloss eine zweite Runde redaktioneller Layout-Überarbeitungen in 5 Minuten ab.
Das Feedback von Entwicklern auf X (ehemals Twitter) und in japanischen Entwicklerforen verleiht jedem qwen 4 max-Feature-Highlight eine wichtige Nuance. Der Entwickler @round_boys demonstrierte, wie das Modell eine vollständige 3D-Szene mit Java und Three.js in einem einzigen Durchgang rendert, merkte jedoch an, dass der Vorgang etwa 69.000 Token verbrauchte. Andere Early Adopter, die den rohen Durchsatz maßen, berichteten von Streaming-Geschwindigkeiten von etwa 33 Token pro Sekunde unter der Standardeinstellung xhigh und bemerkten, dass die Trajektorien der Reinforcement Learning (RL)-Toolnutzung gelegentlich einfache Dateilesevorgänge überanalysieren – eine Erinnerung daran, dass das Suffix -preview wörtlich zu nehmen ist.
Qwen 4 Max Preise, Token-Plan-Regeln und Produktionshindernisse
Wenn Sie nach qwen 4 max pricing suchen und eine Standardtabelle mit "$X pro Million Eingabe-Token" erwarten, werden Sie nicht fündig. Alibaba bietet keine nutzungsbasierte Abrechnung für qwen4-max-preview an. Die einzige Möglichkeit, Anfragen zu senden, ist über ein aktives Alibaba Cloud Model Studio Token Plan-Abonnement (früher Coding Plan genannt), das in abstrakten monatlichen "Credits" statt in reinen Dollar pro Token abrechnet.
Auf dem internationalen QwenCloud-Portal ist der Token-Plan in persönliche und Team-Stufen unterteilt:
Lite-Plan (3 für den ersten Monat für neue Benutzer): Beinhaltet 20.000 Credits pro Monat, unterliegt einer strengen rollierenden Drosselung von 1.200 Credits pro 5-Stunden-Fenster und 9.000 Credits pro Woche.
Pro-Plan (15 für den ersten Monat): Beinhaltet 100.000 Credits pro Monat, begrenzt auf 6.000 Credits pro 5-Stunden-Fenster und 45.000 Credits pro Woche. (Auf Alibabas inländischem China-Portal werden Lite und Pro mit 39 RMB bzw. 199 RMB pro Monat gelistet, mit Angeboten zum halben Preis im ersten Monat für 19,5 RMB bzw. 99,5 RMB.)
14-Tage-Vorschau-Rabatt (11. Nov. – 25. Nov. 2026): Während des zweiwöchigen Vorschaufensters verbrauchen Anrufe tagsüber (08:00–22:00 UTC+8) nur 20% des Standard-Credit-Gewichts, während nächtliche Anrufe außerhalb der Spitzenzeiten (22:00–08:00 UTC+8) zusätzlich einen Rabatt von 80 % erhalten – wodurch der effektive Credit-Verbrauch auf nur 4% der normalen Raten sinkt.
Für einen einzelnen Entwickler, der nachts für 3 in einer IDE bastelt, ist diese Werberechnung schwer zu schlagen. Für ein Engineering-Team, das ein Produkt entwickelt oder automatisierte CI/CD-Agenten betreibt, führt der Token-Plan jedoch drei harte Produktionshindernisse ein:
Verbot von Backend-Automatisierung und API-Integration: Die Bedingungen des Alibaba Token-Plans beschränken persönliche Lite- und Pro-Schlüssel (sk-sp-) ausdrücklich auf menschlich ausgelöstes, interaktives Programmieren innerhalb unterstützter IDE-Plugins. Die Verwendung eines Abonnement-Schlüssels für ein automatisiertes Backend-Skript, eine kundenorientierte SaaS-Funktion oder eine Batch-Datenpipeline verstößt gegen die Nutzungsbedingungen und führt zur Kontosperrung.
Obligatorisches Datentraining bei persönlichen Stufen: Gemäß den Regeln des Token-Plans beziehen persönliche Lite- und Pro-Abonnements standardmäßig alle Prompts, Repository-Kontexte und Modellvervollständigungen in Alibabas Programm zur Verbesserung des Modelltrainings ein – und es gibt keinen Schalter, um dies zu deaktivieren. Nur der Enterprise-Team-Plan (40 pro Sitzplatz/Monat) bietet eine Garantie für keine Datenspeicherung / kein Training.
Rollierende 5-Stunden-Ratenbegrenzungen und das Ende am 25. November: Selbst wenn Ihr Workflow rein intern ist, kann eine rollierende 5-Stunden-Obergrenze von 1.200 Credits keine Bursts von mehreren Entwicklern abfangen, und der qwen4-max-preview-Endpunkt wird am 25. November 2026 um 24:00 UTC+8 geschlossen.
Direkter Vergleich: Qwen 4 Max vs. Qwen 3.8 Max, Kimi K3.1 Pro, GLM-5.3 und Claude Opus 5.5
Da Sie qwen4-max-preview derzeit nicht in ein Produktions-Backend integrieren können, lautet die praktische Frage hinter jedem Vergleich: Welches Pay-as-you-go-Flaggschiff deckt dieselbe agentische Arbeitslast mit 1 Mio. Kontext-Token ab, ohne an ein Abonnement gebunden zu sein oder Daten für das Training preiszugeben?
| Modell |
Abrechnung & Verfügbarkeit |
Kontextfenster |
Maximale Ausgabe |
Unterstützte Eingabemodalitäten |
GPT Proto-Tarif (Eingabe / Ausgabe pro 1 Mio.) |
Qwen4-Max-Preview (qwen4-max-preview) |
Nur 14-tägige Vorschau (endet am 25. Nov.); Token-Plan-Abonnement ($6–$30/Monat) |
1.000.000 |
393.216 (inkl. 262K CoT) |
Text, Bild, Video |
Nicht gehostet (keine getaktete Upstream-API) |
Qwen3.8 Max 0902 (qwen3.8-max-0902) |
Produktions-Pay-As-You-Go |
1.000.000 |
65.536+ |
Text, Bild, Video, Audio, Dokument |
4,20 (30 % unter der offiziellen Liste) |
Kimi K3.1 Pro (kimi-k3.1-pro) |
Produktions-Pay-As-You-Go |
1.048.576 (1,05 Mio.) |
131.072 |
Text, Bild, Dokument |
10,00 ($0,20 für zwischengespeicherte Eingaben) |
GLM-5.3 (glm-5.3) |
Produktions-Pay-As-You-Go |
1.050.000 (1,05 Mio.) |
128.000 |
Text, Bild, Dokument |
3,74 (15 % unter der offiziellen Liste) |
Claude Opus 5.5 (claude-opus-5-5) |
Produktions-Pay-As-You-Go |
1.000.000 |
128.000 |
Text, Bild, Dokument |
18,00 (10 % unter der offiziellen Liste) |
Qwen 4 Max vs. Qwen 3.8 Max
Bei der Bewertung von qwen 4 max vs qwen 3.8 max besteht der Kompromiss zwischen der Zeit für die autonome Verifizierung und der Produktionsstabilität sowie einer breiteren Unterstützung von Modalitäten. Wie der 17-minütige gegenüber dem 9,5-minütigen Landingpage-Test von WEEL zeigte, ist Qwen 4 Max bereit, die doppelte Zeit für die Ausführung von Python-Hintergrundprüfungen und die Synthese benutzerdefinierter SVGs aufzuwenden. Allerdings lässt qwen4-max-preview die native Audio- und Dokumenten-Dateianalyse in seiner Vorschauversion weg und kann nicht pro Token abgerechnet werden.
Wenn Ihre Pipeline bereits auf Alibabas Prompt-Formatierung, mehrsprachige Tokenisierung oder multimodale Vision angewiesen ist, ist qwen3.8-max-0902 das produktionsreife Flaggschiff, auf das Sie heute setzen sollten. Es bietet dasselbe 1.000.000-Token-Kontextfenster und akzeptiert Text-, Bild-, Video-, Audio- und Dokumenteingaben. Auf GPT Proto läuft qwen3.8-max-0902 zu 4,20 pro 1 Mio. Ausgabe-Token – 30 % unter dem offiziellen getakteten Listenpreis von Alibaba – und Sie können es zusammen mit kleineren Open-Weight-Geschwistern im Qwen-Modell-Hub vergleichen.
Qwen 4 Max vs. Kimi K3.1 Pro
Der Vergleich zwischen qwen 4 max vs kimi k3.1 pro wurde in den Blender-MCP- und WebGL-Benchmarks von Silicon Star vom 13. November direkt gegenübergestellt, und der Unterschied zwischen den beiden Modellen ist bemerkenswert deutlich: Qwen 4 Max denkt wie ein struktureller Maschinenbauingenieur, während Kimi K3.1 Pro wie ein Industriedesigner denkt.
Im Blender-Prompt („Jupiter Orbital Megaship Maintenance Dock“) und im WebGL-Tiefsee-Tor-Test („Gate of Ten Thousand Tides“) baute qwen4-max-preview dichtere interne tragende Rippen, komplexe Andockarme und einen funktionierenden UI-Schieberegler für den Gezeitenstand, der Wasserhöhe und Druckwerte dynamisch neu berechnete. Dennoch bewerteten die Tester kimi-k3.1-pro durchweg besser in Bezug auf visuelle Komposition, Shader-Beleuchtung des Wassers und Farbharmonie. Wenn Sie benutzerorientierte Frontends, interaktive 3D-Weberlebnisse oder Dokumenten-Agenten mit langem Kontext entwickeln, die heute ein Kontextfenster von 1.048.576 Token (1,05 Mio.) und 131.072 maximale Ausgabe-Token benötigen, ist Kimi K3.1 Pro auf GPT Proto für 10,00 pro 1 Mio. Ausgabetoken verfügbar (wobei zwischengespeicherte Eingaben auf 0,20 $ pro 1 Mio. sinken).
Qwen 4 Max vs. GLM-5.3
Entwickler, die nach qwen 4 max vs glm5.3 suchen, sind meist auf der Suche nach hoher Coding-Effizienz und Tool-Nutzung zu einem aggressiven Preis. Während das 3-Dollar-Lite-Angebot für den ersten Monat von Qwen 4 Max auf dem Papier günstig aussieht, machen das 5-Stunden-Guthabenlimit und das Verbot automatisierter Skripte es für Flotten von Hintergrund-Agenten unbrauchbar.
Z.ai's glm-5.3 löst genau dieses Problem über eine getaktete API. Es übertrifft Qwen 4 Max bei der gesamten Kontextkapazität sogar leicht – es bietet ein 1,05 Mio. Kontextfenster gepaart mit einem 128K-Ausgabe-Limit – und akzeptiert Text-, Bild- und Dokumenteneingaben. Mit 3,74 pro 1 Mio. Ausgabetoken auf GPT Proto (15 % unter dem offiziellen Tarif von Z.ai) ist GLM-5.3 das kostengünstigste Pay-as-you-go-Arbeitstier für automatisierte PR-Review-Bots, hochperformantes Tool-Routing und Multi-File-Code-Generierung.
Qwen 4 Max vs. Claude Opus 5.5
Alibaba hat die native Kompatibilität zur Anthropic Messages API in qwen4-max-preview integriert, speziell um Entwickler anzusprechen, die sich qwen 4 max vs claude opus 5.5 in Claude Code ansehen. Wie der Python-CLI-Test von WEEL bewies, kann Qwen 4 Max bereits eine 12-minütige pytest-Reparaturschleife ausführen und subtile argparse- und CSV-Injection-Fehler finden.
Wo claude-opus-5-5 einen entscheidenden Vorsprung behält, sind Trajektorieneffizienz, Streaming-Reaktionsfähigkeit und Zuverlässigkeit der Produktions-SLAs. Community-Tester stellten fest, dass das RL-Tuning im Frühstadium von Qwen 4 Max dazu führen kann, dass es bei xhigh-Reasoning redundante Shell-Prüfungen mit ca. 33 Token/s durchläuft. Wenn Sie geschäftskritische Produktions-Repositories refactoren, bei denen verschwendete Tool-Turns oder Datentraining auf persönlicher Ebene inakzeptabel sind, liefert Claude Opus 5.5 ein 1-Mio.-Kontextfenster und 128K maximale Ausgabe mit ausgereifter Befehlstreue. Über GPT Proto können Sie claude-opus-5-5 für 18,00 pro 1 Mio. Ausgabetoken aufrufen – 10 % unter den offiziellen Preisen von Anthropic.
So rufen Sie Produktionsalternativen über eine einheitliche API auf
Wenn Sie die vier oben genannten Flaggschiff-Produktionsmodelle nutzen möchten, ohne separate Anbieter-SDKs, Abonnement-Guthabenfenster oder sk-sp- regionale Endpunkte verwalten zu müssen, stellt GPT Proto alle diese Modelle über eine einzige OpenAI-kompatible Route bereit (https://gptproto.com/v1/chat/completions).
Ein Authentifizierungsdetail, das Sie vor dem Kopieren des Snippets beachten sollten: Wie in unserem Authentifizierungsleitfaden und auf unserer Schnellstartseite dokumentiert, übergeben Sie Ihren Schlüssel immer im Authorization-Header mit dem Präfix Bearer (Authorization: Bearer $GPTPROTO_API_KEY). Nachfolgend finden Sie ein dokumentationsbasiertes Beispiel, das zeigt, wie Sie qwen3.8-max-0902 aufrufen und durch Ändern einer einzigen Zeichenfolge direkt zu glm-5.3, kimi-k3.1-pro oder claude-opus-5-5 wechseln können:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max-0902",
    "messages": [
      {
        "role": "user",
        "content": "Überprüfen Sie diesen Python-CLI-Parser auf Kollisionen mit negativen Zahlen-Flags und Risiken durch CSV-Formel-Injection."
      }
    ]
  }'
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://gptproto.com/v1",
    api_key=os.environ["GPTPROTO_API_KEY"],
)

# Tauschen Sie die Modell-ID frei zwischen den Flaggschiffen mit 1M-Kontext aus:

# "qwen3.8-max-0902" ($1.40/$4.20) | "glm-5.3" ($1.19/$3.74)

# "kimi-k3.1-pro" ($2.00/$10.00)   | "claude-opus-5-5" ($3.60/$18.00)
response = client.chat.completions.create(
    model="qwen3.8-max-0902",
    messages=[
        {
            "role": "user",
            "content": "Überprüfen Sie diesen Python-CLI-Parser auf Kollisionen mit negativen Zahlen-Flags und Risiken durch CSV-Formel-Injection.",
        }
    ],
)

print(response.choices[0].message.content)