GPT-6.2 Astra auf einen Blick
| Frage |
Kurze Antwort |
| Was ist GPT-6.2 Astra? |
OpenAIs leistungsfähigstes GPT-6.2-Modell für komplexe Programmierung und professionelle Aufgaben |
| Veröffentlichungsdatum |
17. November 2026 |
| API-Modell-ID |
gpt-6.2-astra |
| Kontextfenster |
1,05 Millionen Token |
| Maximaler Input / Output |
922.000 / 128.000 Token |
| Modalitäten |
Text- und Bildeingabe; Textausgabe |
| OpenAI Standard-API-Preis |
8 $ Input, 0,40 $ gecachter Input und 40 $ Output pro 1 Mio. Token |
| GPT Proto-Preis |
6,40 $ Input, 0,32 $ gecachter Input und 32 $ Output pro 1 Mio. Token — 20 % Rabatt |
| Beste Eignung für den frühen Einsatz |
Komplexes Debugging, Code-Reviews, Migrationen, Datenanalyse, professionelle Dokumente, Wissenschaft, CAD und 3D-Workflows |
| Bessere Standardwahl für den Alltag |
GPT-6.2 Sol für Routine-Programmierung, Schreiben und kostengünstigere Aufgaben |
Die OpenAI-Modell-Dokumentation führt Unterstützung für Antworten und Chat-Vervollständigungen auf, sowie Tools wie Websuche, Dateisuche, Code-Interpreter, gehostete Shell, Computernutzung, MCP und Bildgenerierung. Das Modell selbst gibt Text zurück. Fertige Tabellenkalkulationen, Folien, Websites oder 3D-Assets hängen von den Tools und der Ausführungsumgebung ab, die es umgeben.
Worüber diskutieren frühe Anwender tatsächlich?
Bei der Einführung geht es nicht primär um Benchmark-Ergebnisse. Es geht um die Lücke zwischen reiner Leistungsfähigkeit und der Nutzbarkeit im Alltag.
1. Astra kann exzellent darin sein, bestehende Systeme zu überprüfen und zu reparieren
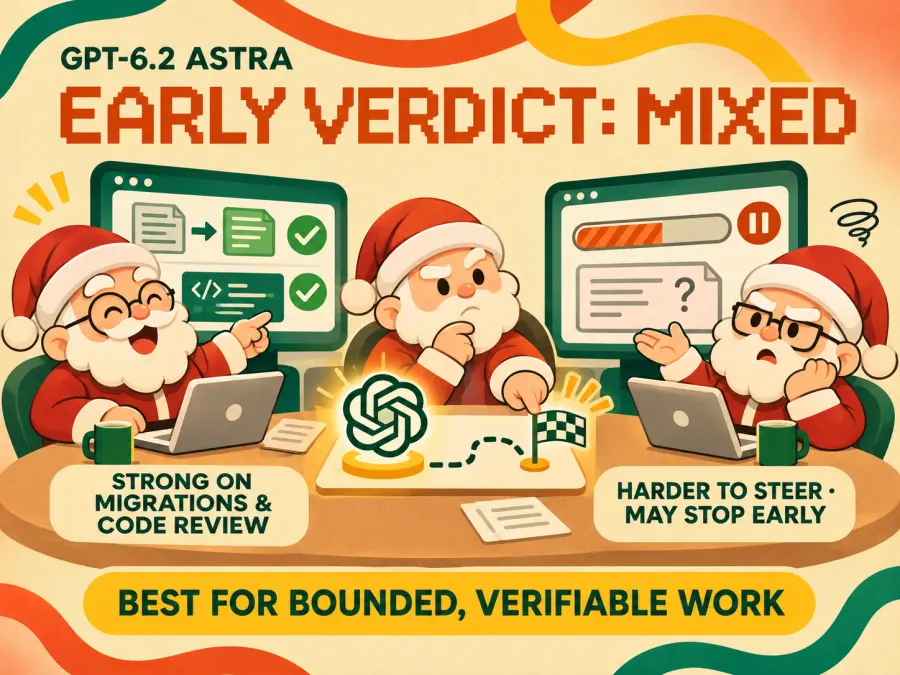
GitHubs frühe Copilot-Tests ergaben, dass GPT-6.2 Astra deutlich mehr reale Code-Review-Probleme erkannte als GPT-6 Astra, während es weniger Token verbrauchte. Das ist für ein Produktionsteam relevanter als eine weitere One-Shot-App-Demo: Die wertvolle Arbeit besteht oft darin, Fehler zu finden, das bestehende Verhalten zu bewahren und den Patch durch Tests zu belegen.
Der Ingenieur Tibor Blaho beschrieb den Einsatz von Astra bei alltäglichen Infrastruktur- und Softwareaufgaben, einschließlich Serververwaltung, Backups, Monitoring, Recherche, Administration, Debugging und Code-Review. Sein herausragendes Beispiel war die Aktualisierung einer Legacy-Anwendung mit mehreren Millionen Zeilen Code und deren alten Abhängigkeiten auf eine aktuelle Sprachversion. Er berichtete von einem lokal lauffähigen Ergebnis nach etwa drei Stunden und einem erfolgreichen Testlauf nach etwa sechs Stunden, wobei er anmerkte, dass noch weitere Arbeit ausstand.
Dies ist eine Anekdote, kein kontrollierter Benchmark. Dennoch ist es ein nützliches Beispiel, da es eine echte Codebasis, die verstrichene Zeit und einen Verifizierungsschritt beinhaltet. Es weist auch auf einen praktischen Workflow hin: Blaho nutzt Astra und Claude-Modelle, um die Arbeit des jeweils anderen zu recherchieren und zu überprüfen, anstatt davon auszugehen, dass ein Modell jeden Fehler findet.
2. Lange autonome Abläufe können frustrierend sein
Die negativen Berichte sind ebenfalls konkret. Dan Shippers erste Rezension besagte, dass Astra bei End-to-End-Coding-Builds oft zu früh stoppte und so prägnant sein konnte, dass seine Ausführungen schwer zu verfolgen waren. Ethan Mollick nannte es ungleichmäßig und schwieriger zu steuern: Es erstellte zwar erfolgreich eine ambitionierte Blender-und-Unity-Weltraumaufzug-Erfahrung, doch er griff dennoch nicht als tägliches Modell darauf zurück.
Der detaillierte Bericht des Entwicklers Theo ist ähnlich gespalten. Er lobte Astra als Code-Reviewer, sagte, es finde neuartige Lösungen und schrieb ihm ein Reverse-Proxy-Design zu, das seinem Unternehmen 25.000 US-Dollar pro Monat einsparen könnte. Er berichtete jedoch auch von langen Abläufen, die bei Fragen hängen blieben, die er nicht beantworten konnte, von Schleifen, die keine Fortschritte machten, und von Zusammenfassungen, die schwerer zu verstehen waren als die Codeänderungen selbst.
Diese Berichte beweisen nicht, dass jeder Astra-Durchlauf scheitern wird. Sie identifizieren dasselbe Risiko aus verschiedenen Blickwinkeln: Das Modell ist möglicherweise fähig genug, die Arbeit zu erledigen, aber schwierig zu beaufsichtigen, wenn das Ziel offen ist.
3. Prägnante Ausgabe bedeutet entweder Effizienz oder fehlenden Kontext
OpenAIs eigener GPT-6.2-Prompting-Leitfaden besagt, dass Astra standardmäßig prägnanter und direkter ist. Für eine Support-Antwort, eine Code-Review-Notiz oder eine Zusammenfassung für Führungskräfte kann das nützlich sein. Bei einer komplexen Erklärung kann es sich jedoch so anfühlen, als hätte das Modell die Argumentation übersprungen, die ein Leser benötigt.
Dies erklärt, warum frühe Reaktionen widersprüchlich sind. Leute, die ein eng gefasstes Ergebnis testen, sehen möglicherweise weniger Füllmaterial und weniger Token. Leute, die Astra als Mitarbeiter über ein langes Projekt hinweg nutzen, sehen möglicherweise abrupte Antworten, unerklärte Entscheidungen oder vorzeitige Übergaben.
4. Die eigentliche Frage ist die Art der Aufgabe, nicht ob Astra „intelligent“ ist
Die bisherigen Erkenntnisse deuten auf eine einfache Trennlinie hin:
| Art der Aufgabe |
Frühe Eignung für Astra |
| Klares Ziel, Werkzeuge, Tests und Ziellinie |
Starker Kandidat |
| Hochwertige Überprüfung, bei der übersehene Fehler teuer sind |
Starker Kandidat |
| Daten aus mehreren Quellen oder Dokumentenarbeit mit überprüfbarem Ergebnis |
Starker Kandidat |
| Routine-E-Mails, Besprechungsnotizen oder kleine Code-Änderungen |
Verwenden Sie normalerweise zuerst Sol |
| Offene Recherche, die Urteilsvermögen darüber erfordert, was wichtig ist |
Vergleichen Sie mit Fable 5.2 und behalten Sie die menschliche Überprüfung bei |
| Stundenlanger autonomer Build mit mehrdeutigen Entscheidungen |
Testen Sie sorgfältig, bevor Sie sich darauf verlassen |
Ist GPT-6.2 Astra für die tägliche Arbeit geeignet?
Ja, aber für die meisten alltäglichen Aufgaben ist es nicht erforderlich. Für Besprechungsnotizen, Routine-E-Mails, kurze Recherchen, kleine Code-Anpassungen oder einen ersten Entwurf ist GPT-6.2 Sol der natürlichere Ausgangspunkt. Es ist das Modell, das OpenAI für die tägliche Arbeit vorsieht, und seine Token-Preise liegen 75 % unter denen von Astra. GPT Proto gewährt auf beide Modelle denselben Rabatt von 20 %, sodass dieser Preisunterschied unverändert bleibt.
Astra wird dann nützlich, wenn eine gewöhnliche Arbeitskategorie zu einer schwierigen, hochwertigen Aufgabe wird. „Überprüfe diesen Pull Request“ passt vielleicht zu Sol; „verfolge diesen intermittierenden Fehler über drei Dienste hinweg, behebe ihn und führe die betroffenen Workflows aus“ ist eine Aufgabe für Astra. „Fasse diese CSV zusammen“ ist Routine; „finde die Probleme bei der Datenqualität, erkläre die statistischen Fallen und erstelle eine bearbeitbare Entscheidungsarbeitsmappe“ gibt Astra mehr Spielraum, um seine Kosten zu rechtfertigen.
Zu den bisher gemeldeten praktischen täglichen Einsatzmöglichkeiten gehören Debugging, Serverbetrieb, Überwachung, Backups, Code-Reviews, rechercheübergreifende Analysen und Büroadministration. Der gemeinsame Nenner ist nicht der Beruf. Es ist die Tatsache, dass die Aufgabe komplex genug ist, um von tieferem logischem Denken zu profitieren, und strukturiert genug, um das Ergebnis zu verifizieren.
Wofür ist GPT-6.2 Astra gut geeignet?
Code-Review, Ursachenanalyse und Modernisierung von Altsystemen
Dies ist der klarste praktische Anwendungsfall. Geben Sie Astra den fehlerhaften Workflow, die relevanten Protokolle, das Repository und die Testbefehle. Bitten Sie es, den Fehler über Dienste hinweg zu verfolgen, die präziseste sichere Korrektur zu implementieren und die betroffenen Tests auszuführen. Dies entspricht OpenAIs eigenem empfohlenen Astra-Workflow sowie den positiven Berichten von GitHub und frühen Ingenieuren.
Upgrades von Altsystemen könnten besonders gut geeignet sein, da die Aufgabe schwierig, aber überprüfbar ist. Das Modell kann alte Abhängigkeiten untersuchen, Code schrittweise aktualisieren und wiederholt einen sauberen Build ausführen. Der Mensch muss weiterhin Kompatibilitätsanforderungen definieren und die Migration überprüfen. „Alle Tests bestanden“ ist nur dann ein Beweis, wenn die Testsuite die relevanten Verhaltensweisen abdeckt.
Für normale Pull-Request-Reviews oder kleine Überarbeitungen reicht GPT-6.2 Sol möglicherweise aus. OpenAI empfiehlt Sol ausdrücklich für die tägliche Programmierung, und es kostet ein Viertel der Standard-Input- und Output-Raten von Astra.
Datenanalyse, Dashboards und bearbeitbare Arbeitsmappen
Astras Wert liegt hier nicht nur im Schreiben einer SQL-Abfrage. Es kann Daten untersuchen, Qualitätsprobleme erkennen, Annahmen formulieren, Analysen durchführen und die Ergebnisse in eine Arbeitsmappe, ein Diagramm oder ein Dashboard umwandeln, das eine andere Person überprüfen kann.
Ein unabhängiger Plotly-Datenanalysetest liefert ein nützliches Beispiel für eine reale Aufgabe. Astra beantwortete 41 von 43 Fragen richtig, erkannte alle eingebauten Datenqualitätsprobleme, vermied alle fünf statistischen Fallen und schloss den Durchlauf für 4,11 $ ab. Die mittlere Bearbeitungszeit pro Frage betrug 12,4 Sekunden, gegenüber 26,9 Sekunden bei GPT-6 Astra. Der Kompromiss ist wichtig: Es übersah zwei versteckte Muster, und GPT-6.1 Sol erreichte in diesem Test für 2,61 $ eine perfekte Punktzahl. Astra war schnell und leistungsfähig, aber nicht automatisch die günstigste oder genaueste Option.
OpenAIs Alderfen-Bewertungsbeispiel zeigt die Dokumentenseite derselben Fähigkeit. Astra erstellte eine bearbeitbare DCF-Arbeitsmappe, die den Umsatz bis 2031 prognostizierte, drei Finanzberichte abglich, den Wert pro Aktie berechnete und die wichtigsten Treiber neben der Sensitivitätstabelle platzierte. Betrachten Sie dies als eine Anbieter-Demo, nicht als unabhängigen Beweis. Es ist dennoch eine nützliche Vorlage für einen Test, den Sie mit Ihrer eigenen Tabellenkalkulation reproduzieren können.
Finanzwesen, Buchhaltung, Rechtsangelegenheiten und professionelle Dokumente
GPT-6.2 Astra wurde darauf trainiert, professionelle Konventionen in Präsentationen, Tabellenkalkulationen, Memos und Dokumenten einzuhalten. OpenAI berichtet von Fortschritten in den Bereichen Finanzen, Buchhaltung, Beratung, Vertrieb und juristische Arbeitsabläufe. Zu den Kundenergebnissen auf der Startseite gehören weniger Überarbeitungsschleifen bei Apps, Dashboards und Präsentationen sowie kürzere Bearbeitungszeiten für langfristige Buchhaltungsaufgaben. Da es sich hierbei um vom Anbieter ausgewählte Ergebnisse handelt, sollten sie eher als vielversprechende Anwendungsfälle und nicht als garantierte Ergebnisse betrachtet werden.
Die besten Anwendungen sind überprüfbare Ergebnisse:
Ein Finanzmodell, dessen Formeln sich abgleichen lassen und korrekt reagieren, wenn sich Annahmen ändern.
Ein juristisches Memo, dessen Behauptungen auf die bereitgestellten Autoritäten und Quelldokumente zurückgeführt werden können.
Eine Präsentation, die einer bestehenden Vorlage folgt und jeden Titel in eine belegte Schlussfolgerung umwandelt.
Ein Compliance-Tracker, der jede Anforderung mit einem Nachweis, einem Verantwortlichen und einem Status verknüpft.
Unabhängige Nachweise fallen bei ergebnisoffenen Arbeiten weniger schmeichelhaft aus. In Epoch AIs realistischer Arbeitsplatzbewertung erreichte kein getestetes Modell den Mitarbeiterstandard von Epoch bei irgendeiner Aufgabe. GPT-6.2 Astra erzielte durchschnittlich 65 %, 17 Punkte hinter Claude Fable 5.2. Epoch stellte fest, dass Astra gegenüber GPT-6 Astra beim prägnanten Schreiben, Grafikdesign und der Forschung in Rechenzentren verbessert wurde, aber zu vorsichtig sein konnte und Schlussfolgerungen ausließ, die durch die verfügbaren Beweise gestützt wurden.
Dieser scheinbare Widerspruch ist der Punkt. Astra kann sehr stark sein, wenn die Kriterien und die Ausgabe explizit sind. Wenn die Arbeit erfordert zu entscheiden, was wichtig ist, kalibrierte Annahmen zu treffen und einen unsicheren Forschungsplan zu iterieren, sind die Modellwahl und die menschliche Aufsicht wichtiger.
Wissenschaftliche Analyse und technische Forschung
OpenAI positioniert die Wissenschaft als einen der wichtigsten Anwendungsfälle für Astra und berichtet von führenden Ergebnissen bei terminalbasierten wissenschaftlichen Arbeitsabläufen. Ein weiteres frühes Nutzersignal kommt von dem biomedizinischen Forscher Derya Unutmaz, der Astra für Wissenschaft und langfristiges Programmieren bevorzugte, während er Opus 5.5 weiterhin für Designgeschmack und emotionale Intelligenz vorzog. Er beschrieb seine eigene biomedizinische Forschungserfahrung mit Astra ebenfalls als stark.
Dies bedeutet nicht, dass Astra unabhängig publikationsreife Forschung produzieren kann. Die Epoch-Bewertung ergab, dass Frontier-Modelle immer noch bestehende Ideen wiederverwendeten, sich zu sehr auf erste Versuche verließen und Schwierigkeiten hatten, die wichtigsten Erkenntnisse zu identifizieren. Nutzen Sie Astra zum Suchen, für Code-Analysen, zum Vergleichen von Quellen, zum Testen einer aufgestellten Hypothese oder zum Hinterfragen eines Entwurfs. Behandeln Sie ein selbstbewusstes Forschungsnarrativ nicht als Validierung.
CAD, Simulation, 3D-Design und visuelle Prototypen
Hier sind die Beispiele zur Markteinführung interessanter als die Spiele. OpenAI zeigte, wie Astra Fahrzeugkomponenten modellierte, einen Python-Solver für Fahrwerksdynamik schrieb, das Ergebnis in Blender animierte und eine Montageanleitung sowie einen Teilekatalog für einen ferngesteuerten Buggy erstellte. Diese Beispiele kombinieren visuelles Denken, Code, Computernutzung und Dokumentation in einem Arbeitsablauf.
Diese Kombination kann bei der frühen technischen Erkundung helfen: Referenzbilder und Handbücher in ein bearbeitbares Modell umwandeln, eine Überarbeitung in der Simulation testen und eine visuelle Erklärung für einen Prüfer erstellen. Ein physisches Design benötigt immer noch eine technische Validierung. Eine plausible Animation ist kein Beweis dafür, dass Lasten, Toleranzen, Materialien oder Sicherheitsanforderungen korrekt sind.
Kann GPT-6.2 Astra Spiele entwickeln?
Ja. Meridian Sound Racing ist eine spielbare Browser-Demo, und Ethan Mollicks Weltraumlift-Projekt kombinierte Blender, Unity, eine Browser-Erfahrung und simulierte Schwerelosigkeitsphysik.
Aber „kann ein Spiel bauen“ ist nicht die beste Zusammenfassung für Astra. Diese Projekte sind der Beweis dafür, dass das Modell Code, 3D-Assets, Tools und Interaktionen über einen großen Build hinweg koordinieren kann. Dieselben Fähigkeiten sind nützlich für Simulationen, Trainingserfahrungen, digitale Zwillinge, Produktkonfiguratoren und interaktive Datengeschichten.
Kreative Konsistenz muss ebenfalls getestet werden. Frühe Nutzer berichteten von starken visuellen Standardinstinkten, aber auch von wiederkehrenden Designmustern und einer schwächeren Kontrolle über den Stil. Geben Sie Astra eine visuelle Referenz, Typografie, Zielgruppe, Interaktionsregeln und explizite Nicht-Ziele vor. Beurteilen Sie dann die zweite Überarbeitung, nicht nur den ersten Screenshot.
So erzielen Sie bessere Ergebnisse mit GPT-6.2 Astra
Die Beschwerden aus der Community deuten darauf hin, dass Astra ein expliziteres Betriebsbriefing benötigt als ein normaler Chat-Prompt. Der Leitfaden von OpenAI warnt zudem, dass das Modell bei unklarer Absicht einen nächsten Schritt vorschlagen und warten könnte.
Verwenden Sie eine Prompt-Struktur wie diese:
Ziel:
Fertigstellung von [spezifisches Ergebnis].

Erledigt, wenn:

1. [Abnahmeprüfung]

2. [Test oder Nachweis]

3. [Erforderliches Ausgabeformat]

Autonomie:
Treffen Sie vernünftige, umkehrbare Annahmen und fahren Sie fort, ohne zu warten.
Fragen Sie nur, wenn eine Entscheidung das Ergebnis wesentlich verändern oder eine irreversible Aktion verursachen würde.

Einschränkungen:

- [Bestehendes Verhalten oder Stil] beibehalten.

- [Nicht zum Umfang gehörenden Bereich] nicht ändern.

- [Tools, Dateien, Quellen oder Konventionen] verwenden.

Überprüfung:
[Tests oder Prüfungen] ausführen. Melden Sie explizit jede fehlende Datei, jedes fehlgeschlagene Tool, jede nicht unterstützte Annahme oder jeden unvollständigen Schritt.

Abschlussübergabe:
Fassen Sie zusammen, was geändert wurde, was überprüft wurde, welche Risiken verbleiben und wie hoch die Gesamtnutzung/Kosten sind.
Behalten Sie bei API-Arbeiten mit mehreren Durchläufen das frühere Prompt-Präfix bei und fügen Sie neue Anweisungen hinzu. OpenAI gibt an, dass dies das logische Schlussfolgern bewahrt und die Wiederverwendung des Prompt-Caches verbessert. Geben Sie für Front-End- oder visuelle Arbeiten eine echte Referenz an und benennen Sie die gewünschte Typografie und Bildsprache. „Mach es modern“ ist kein Designsystem.
Wie viel kostet GPT-6.2 Astra pro Aufgabe?
Diese Preise verstehen sich in USD pro Million Token für Anfragen bis zu 272.000 Eingabe-Token. Die GPT Proto-Zeilen wenden den aktuellen Rabatt von 20 % auf die Standardpreise von OpenAI an.
Für eine Anfrage mit 20.000 nicht zwischengespeicherten Eingabe-Token und 5.000 berechneten Ausgabe-Token betragen die Standard-Token-Kosten $0.36 bei GPT-6.2 Astra, $0.45 bei GPT-6 Astra und $0.09 bei GPT-6.2 Sol. Zu den aktuellen Preisen von GPT Proto kosten dieselben Token-Mengen $0.288 bei Astra oder $0.072 bei Sol. Eine echte Agentenaufgabe kann wiederholte Modellaufrufe tätigen, zwischengespeicherten Kontext wiederverwenden, fehlgeschlagene Tools erneut versuchen oder ein wesentlich längeres Ergebnis erzeugen.
Bei mehr als 272.000 Eingabe-Token in einer Anfrage verdoppeln sich die Eingabe- und Cache-Raten von Astra, und die Ausgabekosten betragen das 1,5-fache der Kurzkontext-Rate für die gesamte Anfrage. Das 1,05-M-Kontextfenster ist nützlich, aber eine beiläufige Nutzung kann zu einer hohen Rechnung führen. Messen Sie die Kosten pro abgeschlossener Aufgabe, nicht nur den Preis pro Million Token.
Der Plotly-Lauf liefert ein konkretes Beispiel: 43 Analysefragen kosten 4,11 $ mit GPT-6.2 Astra, verglichen mit 19,97 $ mit GPT-6 Astra. Dennoch kostete GPT-6.2 Sol nur 1,22 $ und hat nur eine Frage weniger abgeschlossen. Das Upgrade von Astra ist real; das günstigere Modell kann für routinemäßigen Produktionstraffic dennoch wirtschaftlicher sein.
Beide rabattierten Routen sind jetzt live. Überprüfen Sie die GPT-6.2 Astra Modellseite oder die GPT-6.2 Sol Modellseite auf die aktuelle Modell-ID und das Anfrageformat, bevor Sie Produktionstraffic senden. Die OpenAI Modellsammlung listet die restlichen verfügbaren OpenAI-Modelle auf.
Ist GPT-6.2 Astra besser als Claude Fable 5.2?
Nicht bei jeder Art von Arbeit.
OpenAI berichtet, dass Astra die strikte Erfolgsquote von Fable 5.2 bei einem Benchmark für Rechts-Agenten bei etwa einem Sechstel der Kosten mehr als verdoppelt hat. In Cognitions FrontierCode 2.0 erzielte Fable 5.2 jedoch bessere Ergebnisse bei Änderungen an bestehenden Codebasen. Auch die ergebnisoffene Arbeitsplatz-Bewertung von Epoch bevorzugte Fable 5.2 um 17 Punkte.
| Wählen Sie GPT-6.2 Astra, wenn… |
Wählen Sie Claude Fable 5.2, wenn… |
| Code-Review, Debugging, Tool-Nutzung oder ein überprüfbares technisches Ergebnis im Mittelpunkt stehen |
Die Aufgabe ergebnisoffen ist und ein starkes Urteilsvermögen darüber erfordert, was wichtig ist |
| Sie CAD, Simulation, 3D oder Computer-Nutzungs-Workflows benötigen |
Der Kollaborationsstil und lesbare, ausführliche Erklärungen wichtiger sind |
| Die Kosten für wiederholte Aufgaben und die Cache-Effizienz wichtig sind |
Ihre eigenen repräsentativen Tests weniger Eingriffe oder eine bessere Fertigstellung zeigen |
| Sie ein zweites Modell zur Überprüfung der Arbeit eines anderen Agenten wünschen |
Sie ein zweites Modell wünschen, das die Annahmen und Patches von Astra hinterfragt |
Die praktischste Antwort könnte sein, beide zu verwenden. Der von Tibor Blaho beschriebene frühe Cross-Review-Workflow ist glaubwürdiger, als einen universellen Gewinner zu erklären: Lassen Sie ein Modell implementieren oder recherchieren und das andere dann nach übersehenen Fehlern und nicht unterstützten Annahmen suchen.
Für einen kreativen Vergleich verwenden Sie erneut das interaktive Aquarell-Briefing aus unserem Claude Fable 5.2-Test. Geben Sie beiden Modellen dasselbe bestehende Projekt und bitten Sie um eine neue Steuerung, ohne die aktuellen zu beschädigen. Vergleichen Sie die Korrektheit beim ersten Durchlauf, die Anzahl der Überarbeitungen, die Qualität der Erklärungen, die Gesamtzahl der Token und die Kosten für die abgeschlossene Aufgabe. Sie finden den Zugang zu Fable auf der Claude Fable 5.2 API-Seite.
Wo können Sie GPT-6.2 Astra verwenden?
ChatGPT Work: GPT-6.2 Astra ist in Work verfügbar, nicht im regulären ChatGPT Chat. Der Zugriff hängt vom Plan, den Workspace-Einstellungen und dem Rollout-Status ab.
Codex: Ja. Wählen Sie Astra in der Codex-App oder verwenden Sie /model im CLI. Es ist die von OpenAI empfohlene Option, um schwierige Fehler über Dienste hinweg zu verfolgen und die Fehlerbehebung sowie Tests abzuschließen.
Claude Code: Es gibt keine native GPT-6.2 Astra-Option. Die LLM-Gateway-Dokumentation von Anthropic besagt, dass das Routing von Claude Code zu Nicht-Claude-Modellen über ein Gateway außerhalb des Supports liegt.
OpenAI API: Verwenden Sie die offizielle Modell-ID gpt-6.2-astra. OpenAI empfiehlt die Responses API für Workflows mit Tool-Aufrufen.
GPT Proto: Sowohl GPT-6.2 Astra als auch GPT-6.2 Sol sind zu 20 % unter den Standard-API-Token-Preisen von OpenAI live. Wählen Sie Astra für komplexes logisches Denken und überprüfbare professionelle Ergebnisse; wählen Sie Sol für Routine-Programmierung, Schreiben und Workloads mit höherem Volumen. Die frühere GPT-6.2 Astra-Rollout-Timeline dokumentiert die Sichtungen von Codex vor der Markteinführung.
Die folgende Anfrage verwendet die Live-Astra-Modell-ID. Sie können den neuesten Integrations-Snippet direkt von der Modellseite kopieren.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  --header "Authorization: Bearer ${GPTPROTO_API_KEY}" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "gpt-6.2-astra",
    "messages": [
      {
        "role": "user",
        "content": "We sold 12 units at $25 each. Each unit cost $10. Return revenue and gross profit in USD as JSON using the keys revenue and gross_profit."
      }
    ]
  }'
Der Umsatz sollte 300 $ und der Bruttogewinn 180 $ betragen. Für einen günstigeren Routine-Durchlauf wechseln Sie zur exakten Modell-ID, die auf der GPT-6.2 Sol-Seite angezeigt wird. Sie können auch die OpenAI-Modellsammlung nach anderen verfügbaren Modellen durchsuchen.
Fazit
Der überzeugendste Vorteil von GPT-6.2 Astra ist nicht, dass es ein Spiel bauen kann. Es ist die Fähigkeit, logisches Denken, Code, Tools, Dateien und Computernutzung bei Aufgaben zu kombinieren, die ein messbares Ziel haben: ein behobener und getesteter Fehler, eine Migration, die sauber erstellt wird, eine Arbeitsmappe, die sich abgleicht, oder eine Analyse, die ihre Annahmen offenlegt.
Die Einschränkung ist ebenso praktisch. Frühe Nutzer beschreiben wiederholt ein Modell, das bei der Aufgabe brillant sein kann, aber bei einem langen Lauf dennoch schwer zu steuern oder zu verstehen ist. Verwenden Sie Sol für Routinearbeiten. Verwenden Sie Astra, wenn die Aufgabe schwierig genug ist, um dies zu rechtfertigen, definieren Sie „erledigt“ präzise, überprüfen Sie das Ergebnis und vergleichen Sie es mit Fable 5.2 bei Aufgaben, bei denen es auf Forschungsurteil und Kollaborationsstil ankommt.