GLM-5.2 vs. Kimi K3 auf einen Blick
| Kategorie |
GLM-5.2 |
Kimi K3 |
Praktischer Gewinner |
| Architektur |
MoE mit 753 Mrd. Parametern, etwa 40 Mrd. pro Token aktiv |
MoE mit 2,8 Bio. Parametern, 16 von 896 Experten aktiviert |
Kimi K3 beim Maßstab; die Größe allein beweist keine Qualität |
| Kontextfenster |
1 Mio. Token |
1 Mio. Token |
Unentschieden |
| Maximale Ausgabe |
128.000 Token |
Bis zu 1 Mio. Token bei expliziter Konfiguration |
Kimi K3 |
| Eingabe |
Text |
Text, Bilder und Videos |
Kimi K3 |
| Steuerung des Reasonings |
Mehrere Modi; High und Max auf GPT Proto |
Immer aktives Denken mit geringem, hohem und maximalem Aufwand; standardmäßig maximal |
Hängt vom Endpunkt und von der Aufgabe ab |
| Entwicklerfunktionen |
Function Calling, JSON, Caching, MCP |
Function Calling, JSON, Caching, dynamisches Laden von Tools, Vision |
Kimi K3 für multimodale Agenten; ansonsten ausgeglichen |
| Offene Gewichte |
Jetzt unter MIT verfügbar |
Unter der eigenen Kimi-K3-Lizenz verfügbar |
GLM für eine permissive Lizenz und einen geringeren Ressourcenbedarf; Kimi für die höhere Leistungsobergrenze |
| Offizieller API-Preis pro 1 Mio. Token |
$1,40 Eingabe, $0,26 gecachte Eingabe, $4,40 Ausgabe |
$3 Eingabe, $0,30 gecachte Eingabe, $15 Ausgabe |
GLM-5.2 |
| Am besten geeignet für |
Routine-Code-Reviews, Repository-Refactoring, Automatisierung in großem Umfang, Self-Hosting |
Schwierige agentische Aufgaben, visuelles Debugging, Frontend-, 3D- und Spieleentwicklung |
Hängt von der Aufgabe ab |
| Ressourcenbedarf beim Self-Hosting |
753 Mrd. insgesamt / etwa 40 Mrd. aktiv |
2,8 Bio. insgesamt / 104 Mrd. aktiv; etwa 1,56 TB; mindestens 64 Beschleuniger empfohlen |
GLM-5.2 für die meisten privaten Bereitstellungen |
Die Spezifikationen stammen aus der GLM-5.2-Dokumentation und der Model Card sowie aus der veröffentlichten Kimi-K3-Model-Card, der Lizenz und dem technischen Bericht. Beide Modelle veröffentlichen inzwischen ihre Gewichte. Der praktische Unterschied besteht nicht mehr zwischen offen und geschlossen, sondern zwischen MIT und einer eigenen Lizenz sowie zwischen einem 753-Mrd.-Modell und einem 2,8-Bio.-Modell mit deutlich höherem Bereitstellungsaufwand.
Coding-Benchmarks sprechen für Kimi K3 – aber beachte die Fußnoten
Der von Moonshot veröffentlichte Vergleich zeigt Kimi K3 bei den für Agenten relevantesten Coding-Benchmarks deutlich vorn:
| Benchmark |
Kimi K3 |
GLM-5.2 |
Differenz |
| DeepSWE |
67.5 |
46.2 |
+21.3 K3 |
| Terminal-Bench 2.1 |
88.3 |
82.7 |
+5.6 K3 |
| Program Bench |
77.8 |
63.7 |
+14.1 K3 |
| FrontierSWE |
81.2 |
67.3 |
+13.9 K3 |
| SWE-Marathon |
42.0 |
13.0 |
+29.0 K3 |
| Kimi Code Bench 2.0 |
72.9 |
64.2 |
+8.7 K3 |
Diese Zahlen wurden vom Anbieter veröffentlicht und stammen nicht aus einem kontrollierten direkten Vergleich eines unabhängigen Labors. Moonshots eigene Benchmark-Hinweise besagen, dass die Modelle teilweise unter unterschiedlichen Agent-Frameworks liefen, darunter Kimi Code, Claude Code und Codex. Die FrontierSWE-Werte wurden außerdem aus Rohdaten neu berechnet. Das macht die Ergebnisse nicht wertlos, bedeutet aber, dass ein Abstand von zehn Punkten nicht allein dem Basismodell zugeschrieben werden kann.
Unabhängige Belege weisen in dieselbe Richtung, führen aber zu einer kleineren und glaubwürdigeren Schlussfolgerung. Artificial Analysis bewertet Kimi K3 auf seinem Intelligence Index mit 57, gegenüber 51 für GLM-5.2 Max. Außerdem schätzt die Analyse einen gemischten Preis von $2,31 pro Million Token für K3 und $0,90 für GLM, basierend auf einer Mischung von 7:2:1 aus gecachtem Input, frischem Input und Output.
Meine Einschätzung: Kimi K3 ist der Leistungsgewinner. Die Belege sind nicht eindeutig genug, um zu behaupten, dass es immer besser ist, aber sie sind konsistent genug, dass ich K3 bei einer ungewöhnlich schwierigen Coding-Aufgabe zuerst einsetzen würde. Das Gegenargument für GLM-5.2 ist wirtschaftlicher, nicht akademischer Natur.
Ein echter 3D-Spieltest macht den Unterschied sichtbar
Coding-Bewertungen sind abstrakt. Eine 3D-Szene ist es nicht. Sie zeigt, ob das Modell Layout, Kameraverhalten, Beleuchtung, Interaktion, Zustand und visuelle Iteration koordinieren kann, anstatt lediglich syntaktisch gültige Dateien zu erzeugen.
Ein öffentlicher X-Vergleich gab Kimi K3, GLM-5.2 und Claude Opus 4.8 denselben Prompt für eine 3D-Welt und zeigte die Ergebnisse zur Bewertung ohne Kenntnis der Modelle. Dies ist eine qualitative Demonstration, kein Benchmark: ein Prompt, ein Durchlauf und eine Agent-Konfiguration, die das Ergebnis beeinflussen kann. Der Wert liegt darin, dass Leser die tatsächlichen Welten inspizieren können, statt einer Punktzahl zu vertrauen.
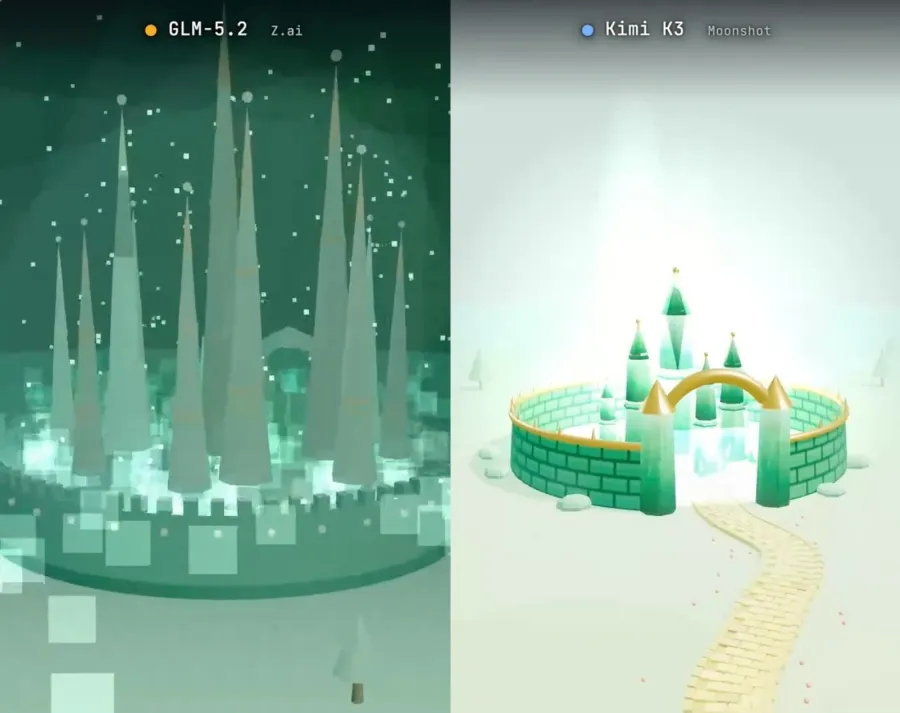
K3 hat bei dieser Art von Arbeit einen strukturellen Vorteil. Es akzeptiert Bilder und Videos nativ, sodass ein Agent die Szene rendern, den Screenshot an das Modell zurückgeben und es auffordern kann, Clipping, Abstände, Kontrast oder den Bildausschnitt der Kamera zu korrigieren. Moonshot bezeichnet dies in seinem technischen K3-Blog als Vision-in-the-Loop-Workflow. GLM-5.2 ist textbasiert. Ein externes Browser-Tool kann Screenshots beschreiben oder Protokolle bereitstellen, fügt jedoch eine weitere Komponente und eine zusätzliche Stelle hinzu, an der Informationen verloren gehen können.
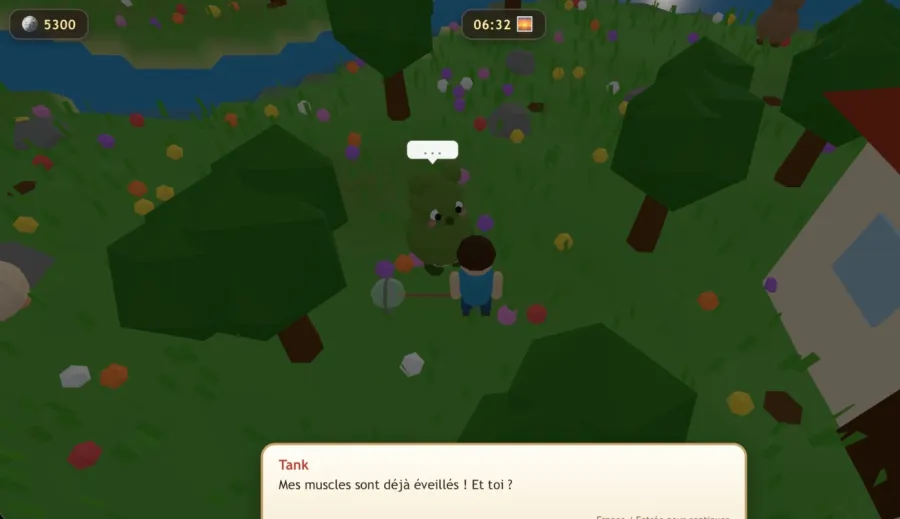
GLM sollte allerdings nicht als Modell für Spieleprogrammierung abgeschrieben werden. In einem Community-Beitrag auf Reddit begann ein Entwickler mit einem leeren Ordner und bat GLM-5.2, das über den Planmodus von Claude Code lief, ein Spiel im Stil von Animal Crossing in HTML, JavaScript und Three.js zu erstellen. Das Ergebnis umfasste ungefähr 2.800 Zeilen und verband Bewegung, NPC-Dialoge, Angeln, eine Wirtschaft, einen Laden, ein Museum, Wohnraum, Möbel und LocalStorage. Der gemeldete Durchlauf verwendete etwa 11,7 Millionen Eingabe-Token und 138.000 Ausgabe-Token, mit 29 Minuten und 43 Sekunden API-Zeit sowie 1 Stunde und 21 Minuten Echtzeit.
Der Autor berichtete außerdem von Bugs und Problemen bei der Spielbalance. Gut so. Diese Unvollkommenheit macht das Beispiel nützlicher als ein poliertes Werbevideo des Anbieters. Es zeigt, dass GLM-5.2 einen kohärenten Prototyp zusammenstellen kann; es zeigt nicht, dass der Code produktionsreif ist oder K3 übertrifft.
Für Spielcode, interaktives 3D oder frontendbasierte Arbeit mit Screenshots würde ich Kimi K3 wählen. Für eine textbeschriebene Gameplay-Schleife, bei der Kosten wichtiger sind als visuelle Iteration, bleibt GLM-5.2 eine überzeugende Option.
Welches Modell ist besser für Code-Reviews und Bugfixing?
Direkte öffentliche A/B-Tests von GLM-5.2 und Kimi K3 für Code-Reviews sind noch rar. Das sollte man klar sagen. Benchmark-Tabellen testen die Fehlerbehebung und Agent-Ausführung, sagen uns aber nicht, ob eines der Modelle den Autorisierungsfehler in deinem Pull Request findet, ohne das Review mit Kommentaren zu Stilfragen zu überfluten.
Für schwieriges Bugfixing sprechen die Belege stärker für K3. Sein Vorsprung bei DeepSWE, Program Bench und SWE-Marathon deutet auf eine bessere Leistung hin, wenn ein Modell eine Codebasis untersuchen, einen Plan erstellen, Dateien bearbeiten, Tools ausführen und sich von fehlgeschlagenen Versuchen erholen muss. Native Vision ist ebenfalls relevant, wenn der Fehler in einem Browser, auf einem mobilen Bildschirm, in einem Diagramm oder in einem CAD-Viewport sichtbar ist.
Für alltägliche Reviews würde ich mit GLM-5.2 beginnen. Z.ai empfiehlt es ausdrücklich für Projektaudits, Refactoring über lange Planungshorizonte, API-Migrationen sowie Arbeiten mit Vorgaben durch Linter-, Build-, Test- und Abhängigkeitsregeln. Der offizielle Leitfaden empfiehlt Entwicklern, Grenzen wie “keine Abhängigkeiten einführen” und “keine API-Verträge ändern” zu formulieren und anschließend Build-, Lint- und Testprüfungen zu verlangen. Das entspricht ziemlich genau einem realen Review-Workflow.
Die Kosten sprechen ebenfalls dafür. Die meisten Pull Requests sind keine SWE-Marathon-Probleme. Für das Umbenennen einer Methode, das Hinzufügen von Tests oder das Review einer gewöhnlichen CRUD-Änderung ist es schwer zu rechtfertigen, den Aufpreis für K3 zu zahlen. Leite gewöhnliche Reviews an GLM weiter und eskaliere nur unklare Fehler, visuelle Defekte oder hartnäckige Probleme über mehrere Dateien an K3.
API-Preise: Ist Kimi K3 den Aufpreis gegenüber GLM-5.2 wert?
Zu den offiziellen Listenpreisen kostet GLM-5.2 $1,40 pro Million frischer Eingabe-Token, $0,26 für gecachte Eingaben und $4,40 für Ausgaben. Kimi K3 kostet jeweils $3, $0,30 und $15. Frische Eingaben sind bei Kimi etwa 2,1-mal so teuer, Ausgaben etwa 3,4-mal.
Betrachten wir einen aggregierten Coding-Auftrag, der über seine Agent-Schleife 1 Million frische Eingabe-Token und 100.000 Ausgabe-Token verbraucht:
| Arbeitslast |
GLM-5.2 |
Kimi K3 |
| 1 Mio. frische Eingabe + 100.000 Ausgabe |
$1,84 |
$4,50 |
| 1 Mio. gecachte Eingabe + 100.000 Ausgabe |
$0,70 |
$1,80 |
Diese Schätzungen schließen Wiederholungsversuche, Gebühren für externe Tools und Steuern aus. Außerdem wird vorausgesetzt, dass der Anbieter das wiederholte Präfix als cachefähig erkennt. Moonshot berichtet bei Coding-Workloads von Cache-Trefferraten über 90 Prozent, doch dein Ergebnis hängt von stabilen Prompts und einem erhaltenen Gesprächsverlauf ab.
Ist K3 den Unterschied wert? Bei einer schwierigen Aufgabe, bei der ein fehlgeschlagener Versuch einen Entwickler zwei Stunden kostet, lautet die Antwort ja. Für kontinuierliche Code-Reviews oder die Wartung großer Repositorys meistens nicht. Ein unabhängiger Vorsprung von sechs Punkten bei der Intelligenz rechtfertigt nicht automatisch einen 2,6-mal höheren gemischten Tokenpreis.
API-Funktionen, die Entwickler tatsächlich bemerken werden
Beide Modelle bieten ein Kontextfenster von 1 Mio. Token, Function Calling, Streaming, strukturierte Ausgaben und Kontext-Caching. Beide können hinter einem OpenAI-kompatiblen Client betrieben werden. Die Unterschiede zeigen sich im Betrieb.
Kimi K3 akzeptiert über seinen gehosteten Dienst Text, Bilder und Videos, unterstützt dynamisches Laden von Tools und kann sehr lange Ausgaben zurückgeben. Es denkt immer, doch die aktuelle Model Card dokumentiert inzwischen die Reasoning-Aufwände `low`, `high` und `max`, wobei `max` der Standard ist. Agenten müssen zwischen den Durchläufen weiterhin die vollständige Assistentennachricht einschließlich des Denkverlaufs bewahren; der Wechsel zu einem anderen Modell und anschließend zu K3 mitten in einer Sitzung kann die Ausgabe destabilisieren.
K3 kann außerdem zu proaktiv sein. Moonshot empfiehlt strengere Systemanweisungen oder eine AGENTS.md-Datei, wenn das Modell keine Entscheidungen außerhalb eines definierten Rahmens treffen darf. Diese Warnung ist in der Produktion wichtig. Ein Modell, das ohne Erlaubnis angrenzende Probleme behebt, kann in einer Demo gewissenhaft wirken und in einem regulierten Repository zur Belastung werden.
GLM-5.2 lässt sich einfacher budgetieren. Entwickler können Reasoning-Modi auswählen, anstatt bei jeder Anfrage für maximales Denken zu zahlen. Das Modell unterstützt MCP und wird bereits unter einer MIT-Lizenz angeboten, sodass Teams die Gewichte heute untersuchen, feinabstimmen oder selbst hosten können. Der Nachteil ist die fehlende Multimodalität: Das Basismodell akzeptiert nur Text. Wenn dein Coding-Workflow von Screenshots abhängt, benötigst du eine weitere Vision-Komponente oder entscheidest dich für K3.
Bereitstellung offener Gewichte: MIT vs. Kimi-K3-Lizenz
Beide Modelle können inzwischen heruntergeladen werden, bieten jedoch nicht dieselben Bedingungen für die Bereitstellung.
GLM-5.2 nutzt MIT. Kimi K3 verwendet eine eigene Lizenz, die eine weitgehende Nutzung, Änderung, Feinabstimmung, Bereitstellung und Weiterverteilung erlaubt, aber Bedingungen für große Model-as-a-Service-Unternehmen und sehr große kommerzielle Produkte hinzufügt. Ein Startup, das einen internen Coding-Assistenten entwickelt, und eine umsatzstarke Inferenzplattform müssen die K3-Lizenz nicht auf dieselbe Weise bewerten.
Der Hardwareunterschied ist ebenso wichtig. GLM-5.2 verfügt über insgesamt 753 Mrd. Parameter, von denen etwa 40 Mrd. pro Token aktiv sind. Kimi K3 hat insgesamt 2,8 Bio. Parameter, 104 Mrd. aktive Parameter und ein offizielles Repository von etwa 1,56 TB. Moonshot empfiehlt mindestens 64 Beschleuniger. K3 bietet die höhere Leistungsobergrenze; GLM ist für die meisten Teams das praktischere Self-Hosting-Projekt.
Das ändert das Urteil, nicht aber die Routing-Strategie. Verwende GLM für routinemäßige, kostensensitive oder private Coding-Workloads. Eskaliere zu K3, wenn visuelles Reasoning oder die Schwierigkeit der Aufgabe die höheren API-Kosten oder den größeren Infrastrukturbedarf rechtfertigt.
GLM-5.2-vs.-Kimi-K3-Coding-API-Vergleich auf GPT Proto
GPT Proto stellt beide Modelle über einen OpenAI-kompatiblen Endpunkt bereit. Du kannst die GLM-5.2-Modellseite, die Kimi-K3-Modellseite oder den vollständigen Modellkatalog öffnen. Der praktische Vorteil ist kein neuer Coding-Agent, sondern die Möglichkeit, dieselbe Anfrage mit einem Schlüssel über zwei Modelle laufen zu lassen und die Ausgaben zu vergleichen, bevor du Routing-Regeln festlegst.
Installiere das aktuelle OpenAI-Python-SDK, exportiere deinen Schlüssel und führe dieses Skript aus:
python3 -m pip install --upgrade "openai>=1.0"
export GPTPROTO_API_KEY="your-key-here"
import os
from pathlib import Path

from openai import OpenAI


client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://api.gptproto.com/v1",
)

task = """Review this Python function for correctness and security.
Return: (1) confirmed bugs, (2) a corrected implementation, and
(3) three pytest tests. Do not report style-only issues.

from pathlib import Path

def read_user_file(root: str, filename: str) -> str:
    path = Path(root) / filename
    return path.read_text(encoding="utf-8")
"""

models = ["glm-5.2", "kimi-k3.0"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "system",
                "content": (
                    "You are a senior application-security reviewer. "
                    "State uncertainty and avoid speculative findings."
                ),
            },
            {"role": "user", "content": task},
        ],
    )
    output = response.choices[0].message.content or ""
    Path(f"review-{model}.md").write_text(output, encoding="utf-8")
    print(f"Saved review-{model}.md")
Das Beispiel ist nach dem Setzen von GPTPROTO_API_KEY direkt ausführbar. Es fordert beide Modelle auf, das Risiko eines Pfad-Traversal-Angriffs zu finden und Tests zu erstellen, und speichert anschließend separate Markdown-Reviews. Sollte sich eine Modell-ID während der Einführung ändern, kopiere die aktuelle ID von der GPT Proto-Modellseite.
Wähle für die Produktion nicht anhand eines einzigen Prompts einen Gewinner. Erstelle aus deinen eigenen Repositorys einen Satz von 20 bis 50 Aufgaben, entferne Geheimnisse und bewerte bestätigte Befunde, falsch-positive Ergebnisse, die Erfolgsrate der Tests, die Gesamtzahl der Token und die Laufzeit. Die GPT Proto-Startseite ist der Ausgangspunkt für die Erstellung des gemeinsamen API-Schlüssels.
Welches Modell solltest du wählen?
Wähle Kimi K3, wenn deine Aufgabe Coding mit Screenshots oder Videos verbindet, wenn du ein Frontend oder eine 3D-Erfahrung entwickelst oder wenn ein schwieriger mehrstufiger Fehler mehr kostet als die zusätzlichen Token. Wähle die Gewichte nur, wenn dein Team die Infrastruktur unterstützen kann und die Kimi-K3-Lizenz geprüft hat.
Wähle GLM-5.2 für routinemäßige Code-Reviews, Repository-Audits, Refactoring, Migrationen und Coding-Automatisierung in großem Umfang. Es bleibt die bessere Standardlösung für Self-Hosting, wenn MIT-Lizenzierung, ein geringerer Ressourcenbedarf und planbare Kosten wichtiger sind als K3s höhere Leistungsobergrenze.
Bei einem gemischten Workload solltest du routen, statt dich einem Modell zu verschreiben: zuerst GLM-5.2, Kimi K3 bei Eskalationen. Die Veröffentlichung der K3-Gewichte bringt mehr Kontrolle über die Bereitstellung, beseitigt aber nicht GLMs wirtschaftlichen und operativen Vorteil.