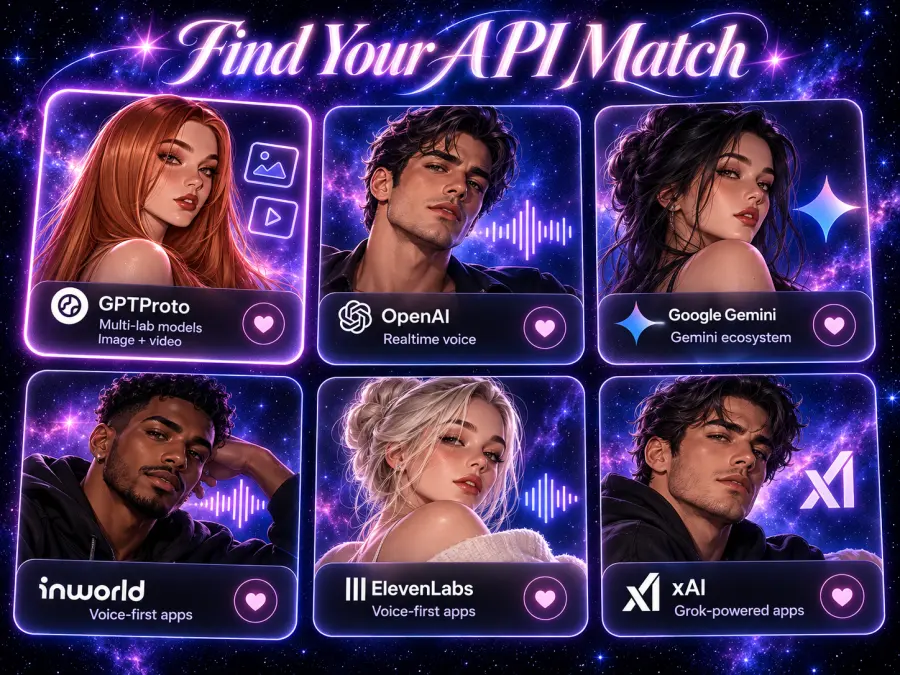
Die besten API-Anbieter für KI-Begleiter-Apps auf einen Blick
| Anbieter |
Beste Eignung |
Zu bewertende Funktionen |
Haupt-Kompromiss |
| GPT Proto |
Kombination von Modellen verschiedener Labore mit visuellen Inhalten |
Unterstützte Chat-, Bild- und Videomodelle unter einem Schlüssel und Guthaben |
Ihre App verwaltet weiterhin den Charakterstatus und das dauerhafte Gedächtnis |
| OpenAI |
Direkte Integration mit den Echtzeit-Sprachmodellen von OpenAI |
Text, Bildgenerierung, Sprache und Echtzeit-Audiointeraktion |
Der Zugriff auf andere Modellfamilien erfordert zusätzliche Integrationen |
| Google Gemini API |
Produkte, die das KI-Ökosystem von Google nutzen |
Gemini-Chat, Live-Interaktion, Bildgenerierung und Videomodelle |
Live-Eingabe und generierte Medien nutzen unterschiedliche Modellfähigkeiten |
| Inworld |
Konfigurierbare Echtzeit-Spracherlebnisse |
STT, wählbare LLMs, TTS sowie Bild- und Video-Inferenz |
Sitzungsübergreifendes Gedächtnis erfordert Anwendungsspeicherung und -wiederherstellung |
| ElevenLabs |
Sprachgesteuerte Produkte, die auch visuelle Inhalte benötigen |
Agenten, konfigurierbare Stimmen sowie APIs zur Bild-/Videogenerierung |
Der Zugriff auf die Medien-API erfordert ein Abonnement |
| xAI |
Produkte, die auf Grok basieren |
Chat, Imagine-Bild-/Videogenerierung und Sprach-APIs |
Jede Funktion hat ihre eigenen Anforderungen an Anfragen und Abrechnung |
Wie wir diese API-Anbieter ausgewählt haben
Dies ist ein dokumentationsbasierter Auswahlleitfaden, geprüft am 27. Oktober 2026. Die Empfehlungen spiegeln die verfügbaren Funktionen, Integrationsanforderungen und veröffentlichten Abrechnungsstrukturen wider. Sie stellen kein gemessenes Ranking der Dialogqualität oder Antwortgeschwindigkeit dar.
Ich habe Anbieter priorisiert, die ein Entwickler für ein Begleitprodukt bewerten könnte, und dann die Modellauswahl, Medienunterstützung, den Anwendungsaufwand und die Kosten berücksichtigt. Ein nützlicher Vergleich muss erklären, ob ein Dienst Modellinferenz, eine Sprachkonversations-Pipeline oder zusätzliche Produktinfrastruktur bereitstellt.
Echte Projekte zeigen, warum diese Unterscheidung wichtig ist. Das Open-Source-Projekt Utsuwa companion project konfiguriert LLM- und Text-to-Speech-Anbieter separat. Die Anwendung ruft den Konversationsverlauf ab, fügt relevante Erinnerungen ein und passt den Kontext an das ausgewählte Modell an. Die Auswahl des Anbieters ist nur ein Teil dieses Systems.
Weitere Beispiele finden Sie in den Character-Chat-Apps und deren Modellnutzung von GPT Proto. Nutzen Sie die Auflistungen, um Anwendungsmuster und Modellauswahlen zu untersuchen. Sie legen nicht fest, welcher Anbieter für Ihre eigene App am besten geeignet ist.
6 API-Anbieter, die Sie für Ihre Begleiter-App in Betracht ziehen sollten
1. GPT Proto zur Kombination von Chat-, Bild- und Videomodellen
GPT Proto ist der stärkste Ausgangspunkt auf dieser Shortlist, wenn Sie verschiedene Modellfamilien vergleichen und generierte visuelle Inhalte über dasselbe Konto hinzufügen möchten. Die KI-API für Rollenspiele bietet Ihnen die Möglichkeit, Charakter-Prompts zu bewerten und unterstützte Modelle zu vergleichen, bevor Sie sich für eines entscheiden.
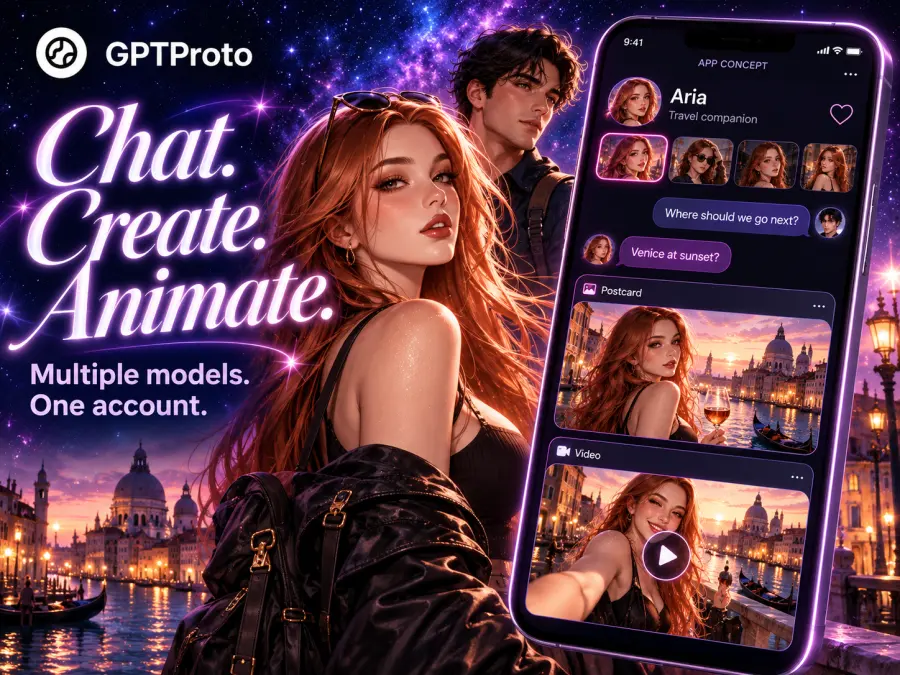
Stellen Sie sich einen fiktiven Reisebegleiter vor: Ein Chat-Modell schreibt die Konversation, ein Bildmodell erstellt eine Postkarte des Charakters und ein Videomodell animiert eine Szene. Diese Aufgaben können unterschiedliche Modelle erfordern. GPT Proto bietet dedizierte Seiten für Optionen wie Nano Banana 2.1 Bildgenerierung und Kling 4.0 Videogenerierung, inklusive modellspezifischer Anfragebeispiele.
Der gemeinsame Zugriff reduziert die Anzahl der Konten und Guthaben, die Ihr Team verwalten muss. Die Integration erfordert dennoch eine separate Handhabung für jede Aufgabe. Eine Chat-Completions-Anfrage und ein asynchroner Video-Job haben unterschiedliche Lebenszyklen.
Als konkrete Budgetreferenz: GPT-6 Luna auf GPT Proto listet 0,08 $ pro Million Input-Token und 0,40 $ pro Million Output-Token. Das macht es zu einem Kandidaten für kostengünstige Chat-Experimente; die Charakterqualität erfordert jedoch eine eigene Bewertung.
Wählen Sie GPT Proto, wenn Modellflexibilität und visuelle Funktionen Priorität haben. Integrieren Sie Speicher, Benutzerberechtigungen und Charakterstatus in Ihre Anwendung und verifizieren Sie erforderliche Echtzeit-Sprachfunktionen separat.
2. OpenAI für den direkten Zugriff auf Echtzeit-Sprachmodelle
OpenAI ist eine praktische Wahl, wenn sich Ihre Produktanforderungen auf deren Modelle und Echtzeit-Sprachinteraktion konzentrieren. Die Realtime API verarbeitet Audio direkt, verwaltet den Konversationsstatus und unterstützt Tools. Der dokumentierte Browser-Ablauf verwendet ein ephemeres Client-Secret und WebRTC; Serververbindungen können WebSockets nutzen.
Dies ist nützlich für einen Sprachbegleiter, der Unterbrechungen handhaben oder während des Gesprächs ein Tool aufrufen muss. Sie können direkt mit der ursprünglichen API und deren SDKs entwickeln, wobei weniger Zwischenservices untersucht werden müssen, wenn sich eine modellspezifische Funktion unerwartet verhält.
Die Einschränkung liegt in der Modellauswahl über verschiedene Anbieter hinweg. Wenn Ihr Produkt später den Dialogstil eines anderen Labors oder ein anderes Bildmodell benötigt, müssen Sie diese Integration selbst hinzufügen. Der gespeicherte Konversationsstatus erfordert zudem ein explizites Design für den Benutzerverlauf und den Abruf von Erinnerungen.
Überprüfen Sie bei Videoanwendungen sorgfältig die aktuelle Verfügbarkeit. Der Deprecation-Hinweis von OpenAI listet die Abschaltung der Videos API und der Sora 2 API für den 24. September 2026 auf. Ein zugängliches älteres Tutorial ist kein ausreichender Beweis dafür, dass der Endpunkt weiterhin verfügbar bleibt.
Wählen Sie OpenAI, wenn der direkte Zugriff auf die Echtzeit-Funktionen schwerer wiegt als die Notwendigkeit, zwischen Modellfamilien zu wechseln.
3. Google Gemini API für Apps, die auf Google AI basieren
Google ist eine Überlegung wert, wenn Sie bereits deren Entwickler-Ökosystem nutzen und Konversationen, visuelle Eingaben, generierte Bilder sowie Videofunktionen innerhalb dieser Umgebung evaluieren möchten.
Die Gemini Live API unterstützt Streaming-Interaktionen mit Frontend- oder Backend-WebSocket-Verbindungen. Google empfiehlt kurzlebige Tokens für Client-Verbindungen in der Produktion. Dies kann für einen Begleiter geeignet sein, der auf gesprochene Eingaben sowie Informationen von einer Kamera oder einem geteilten Bildschirm reagiert.
Generiertes Video ist eine separate Auswahl. Der aktuelle Gemini-Videoleitfaden verweist Entwickler auf Gemini Omni Flash und unterscheidet dies von den eingestellten Veo 3.1 Preview-Endpunkten. Wenn ein Charakter eine kurze animierte Nachricht senden soll, evaluieren Sie ein Generierungsmodell, anstatt davon auszugehen, dass die Live-Videoeingabe diese Ausgabe liefert.
Die praktische Arbeit besteht darin, die richtigen Modelle für jede Funktion auszuwählen und zu testen. Ein Produkt erfordert möglicherweise unterschiedliche Einstellungen, Nutzungslimits und Abrechnungsberechnungen für Chat, Sprache und Medien. Halten Sie diese Kosten in Ihrer Prognose getrennt.
Wählen Sie Google, wenn das Ökosystem zu Ihrer App passt und Sie sich damit wohlfühlen, verschiedene Modelle für unterschiedliche Interaktionen auszuwählen.
4. Inworld für konfigurierbare Echtzeit-Sprachpipelines
Inworld verdient einen genaueren Blick, wenn gesprochene Konversationen für das Erlebnis zentral sind. Die Realtime API kombiniert Spracherkennung (Speech-to-Text), das von Ihnen gewählte LLM und Sprachsynthese (Text-to-Speech), während sie gleichzeitig die Erkennung von Gesprächsbeiträgen und Unterbrechungen über WebSocket oder WebRTC handhabt.
Es bietet zudem eine breitere Medienabdeckung. Inworld Inference stellt Text-, Bild- und Videomodelle bereit, sodass die Beschreibung der Plattform als reiner Sprachdienst nur einen Teil des Angebots erfassen würde.
Die wichtige Grenze ist der persistente Speicher. Die Dokumentation zum Langzeitgedächtnis erklärt, dass Echtzeitsitzungen temporär sind. Ihr Client muss den Speicher extern sichern und für eine zukünftige Sitzung wiederherstellen. Dies ist eine konkrete Anwendungsaufgabe, die in Entwicklungsschätzungen einbezogen werden muss.
Für die Kostenevaluierung sollten Sie Spracherkennung, LLM-Verbrauch und generierte Sprache separat verfolgen und dann die Mediennutzung addieren. Ein niedriger TTS-Stückpreis bestimmt nicht den Preis einer gesamten Konversation.
Wählen Sie Inworld, wenn konfigurierbare Sprachinteraktion eine Kernanforderung ist und Sie weniger Orchestrierungsaufwand wünschen. Planen Sie den Datenbank- und Speicherwiederherstellungsfluss parallel zur Sprachintegration.
5. ElevenLabs für sprachgesteuerte Apps mit visuellen Funktionen
ElevenLabs ist ein Kandidat, wenn Sie Sprachkonfiguration und Konversationssteuerung als Teil der Plattform wünschen, die Sie erwerben. ElevenAgents unterstützt die Auswahl von Sprachmodellen, Gesprächsführung, Unterbrechungen sowie die Bereitstellung über Web- und Mobilintegrationen.
Das Bild- und Videoangebot verändert den Vergleich. Der Image & Video API-Leitfaden dokumentiert separate asynchrone Generierungs-Endpunkte, deren Ergebnisse über Webhooks oder Polling abgerufen werden. Der Zugriff erfordert einen Pro-Plan oder höher sowie die entsprechenden API-Berechtigungen.
Diese Abonnementanforderung ist für einen kleinen Prototyp von Bedeutung. Vergleichen Sie Ihre erwartete Funktionsnutzung mit den Diensten, die im geplanten Tarif verfügbar sind. Mediengenerierungen verbrauchen Credits basierend auf dem ausgewählten Modell, den Einstellungen und den Eingaben; ein Sprachkontingent sollte nicht als unbegrenztes Medienbudget betrachtet werden.
Es gibt einen weiteren Kostenunterschied: Die Dokumentation zum Agentenmodell rechnet die Nutzung von LLMs durch Dritte separat ab. Kalkulieren Sie die Konversationskonfiguration, die Sie tatsächlich bereitstellen werden, anstatt den beworbenen Sprachpreis als Gesamtsumme anzusehen.
Wählen Sie ElevenLabs, wenn Sprachkonfiguration und Agenten-Tools die Plattformanforderungen rechtfertigen. Überprüfen Sie den Medienzugriff, bevor Sie Charakter-Bild- oder Videofunktionen darum herum entwerfen.
6. xAI für Apps, die auf Grok-Modellen basieren
xAI ist relevant, wenn Sie gezielt Grok als Konversationsmodell einsetzen und die damit verbundenen Medien- und Sprachfunktionen evaluieren möchten.
Die Imagine-Dokumentation deckt die Bildgenerierung und -bearbeitung sowie die Videogenerierung ab. Dies bietet Entwicklern einen Weg, Charakterkonversationen und generierte visuelle Inhalte innerhalb desselben Anbieter-Ökosystems zu testen.
Sprachfunktionen sollten anhand der eigenen Voice API-Dokumentation bewertet werden. Betrachten Sie Sprachinteraktion, Text-Chat und generierte Clips als separate Integrations- und Budgetposten, auch wenn sie dasselbe Konto nutzen.
Sie entwickeln immer noch das Companion-Produkt. Eine Modell-API liefert nicht automatisch die Charakter-Assets, den persistenten Beziehungsstatus oder die Benutzeroberfläche, die in einer Consumer-Companion-App zu finden sind. Überprüfen Sie die tatsächlichen Eingaben, Ausgaben und Steuerelemente der API anhand der Funktionen in Ihrer Spezifikation.
Wählen Sie xAI, wenn Grok selbst Teil der Produktentscheidung ist. Wenn Ihre Priorität darin liegt, viele Modellfamilien zu vergleichen, beziehen Sie auch einen Multi-Modell-Dienst in die Evaluierung mit ein.
Was kostet eine KI-Begleiter-App eigentlich?
Ein Token-Angebot wird erst dann nützlich, wenn Sie es mit einer definierten Arbeitslast verknüpfen. Lange Konversationen können bei jeder Anfrage Charakteranweisungen, abgerufene Erinnerungen und den kürzlichen Verlauf erneut senden. Messen Sie den Input, den Ihre Anwendung sendet.
Hier ist eine hypothetische reine Text-Arbeitslast: 1.000 Sitzungen, 50 Antworten pro Sitzung, durchschnittlich 2.000 Input-Token pro Anfrage und 200 berechnete Output-Token pro Antwort. Das ergibt 100 Millionen Input-Token und 10 Millionen Output-Token.
| Gleiches Modell und gleiche Arbeitslast |
GPT Proto GPT-6 Luna |
OpenAI GPT-6 Luna |
| Input-Preis pro Million Token |
$0,08 |
$0,10 |
| Output-Preis pro Million Token |
$0,40 |
$0,50 |
| Kosten für 100 Millionen Input-Token |
$8 |
$10 |
| Kosten für 10 Millionen Output-Token |
$4 |
$5 |
| Gesamtschätzung der Text-Inferenz |
$12 |
$15 |
Die Preise stammen von der Modellseite von GPT Proto und der Dokumentation zum OpenAI GPT-6 Luna Modell. Diese Berechnung verwendet Standard-Texttarife ohne Caching und geht davon aus, dass keine Reasoning-Ausgabe über die angegebene Token-Zulage hinaus erfolgt. Sie schließt Kosten für Cache-Schreibvorgänge, Wiederholungsversuche, Medien, Speicherverarbeitung, Speicherung und Steuern aus. Es handelt sich um eine Veranschaulichung der Anschaffungskosten, nicht um einen gemessenen Vergleich der Begleiter-Qualität.
Für ein multimodales Produkt fügen Sie der Prognose die folgende Nutzung hinzu:
| Funktion |
Was zu messen ist |
| Persistenter Speicher |
Extraktions- oder Zusammenfassungsaufrufe, verwendete Embeddings, Abruf und Speicherung |
| Charakterbilder |
Angefragte Bilder, Auflösung, Referenz-Inputs und wiederholte Generierungen |
| Kurze Videos |
Generierte Dauer, Auflösung, Input-Assets, Audio-Einstellungen und berechnete Wiederholungsversuche |
| Gesprochene Konversation |
Erkennung, LLM-Nutzung, Sprachausgabe sowie alle Plattform- oder Verbindungsgebühren |
Die Latenz gehört ebenfalls zur Produktbewertung. In einem Entwicklungskonto für Desktop-Begleiter kombinierte der Autor Cloud-Inferenz mit lokalem Sprach- und Datenbank-Speicher und berichtete dann über Verzögerungen durch Tool-Aufrufe. Es handelt sich um eine individuelle Erfahrung, aber sie veranschaulicht, warum ein schnelles Textmodell allein nicht die Wartezeit bestimmt, die Benutzer erleben.
Verbinden Sie ein Chat-Modell und planen Sie Ihren Medien-Workflow
Beginnen Sie mit einer kurzen Charakter-Konversation. Erstellen Sie einen GPT Proto-API-Schlüssel, laden Sie Guthaben auf und setzen Sie die Umgebungsvariable GPTPROTO_API_KEY auf Ihrem Server. Die GPT-6 Luna Modellseite bietet ein Beispiel für die aktuelle API-Nutzung.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "gpt-6-luna",
    "messages": [
      {
        "role": "system",
        "content": "You are Mira, a fictional travel companion. Be warm and concise."
      },
      {
        "role": "user",
        "content": "I have one free afternoon in Kyoto and prefer quiet places."
      }
    ]
  }'
Lesen Sie die Antwort von choices[0].message.content. Diese Anfrage liefert eine Charakteranweisung und eine Nachricht. Für eine fortlaufende Unterhaltung muss Ihr Backend für jeden Aufruf die relevante Konversation und die Erinnerungen zusammenstellen. Bewahren Sie den permanenten API-Schlüssel nicht im Browser-Code oder in mobilen Bundles auf.
Wählen Sie als Nächstes ein Bild- oder Videomodell von dessen eigener Seite aus. Verwenden Sie die API-Nutzungsanweisungen der Modellseite, wenn Sie Ihren Coding-Assistenten bitten, die Integration zu erstellen. Behalten Sie den dokumentierten Endpunkt, die Authentifizierung, die Parameter und den Ablauf der Ergebnisverarbeitung bei.
Eine asynchrone Medienaufgabe erfordert eine gespeicherte Job-ID und einen Abschluss-Handler. Ihre Benutzeroberfläche kann ein ausstehendes Bild oder Video anzeigen, während der Chat fortgesetzt wird. Das Verbinden jeder Aufgabe mit dem Chat-Completions-Endpunkt wird diese separaten Funktionen nicht reproduzieren.
Welchen API-Anbieter sollten Sie wählen?
| Ihr erster Produkt-Meilenstein |
Shortlist |
Was vor der Entscheidung zu validieren ist |
| Text-Begleiter MVP |
GPT Proto oder eine direkte Modell-API |
Charakterverhalten, Kosten pro Konversation, Speicherverwaltung |
| Chat plus Charakterbilder und Clips |
GPT Proto, Google, Inworld, ElevenLabs oder xAI |
Genaue Modellverfügbarkeit, Medienzugriff, Referenzen und Ablauf der Aufgabenabwicklung |
| Echtzeit-Sprachbegleiter |
OpenAI, Inworld, ElevenLabs oder Gemini Live |
Unterbrechungen, erste hörbare Antwort, Stimmkonsistenz und Gesamtkosten der Sitzung |
| Produkt speziell für Grok entwickelt |
xAI |
Erforderliche API-Funktionen und der Anwendungsaufwand jenseits des Modellzugriffs |
Für ein Team, das noch sein Dialogmodell und seine visuellen Funktionen erforscht, würde ich mit GPT Proto und einer kleinen, wiederholbaren Evaluierung beginnen. Verwenden Sie dieselben Charakteranweisungen und den Konversationsverlauf und vergleichen Sie dann die unterstützten Modelle, bevor Sie den Rest des Produkts um eines davon herum aufbauen.
Die Modellauswahl verdient einen separaten Durchgang. Unser Leitfaden zu den besten KI-Modellen für Rollenspiele konzentriert sich auf die zugrunde liegenden Dialogmodelle. Nutzen Sie ihn, um die Kandidaten einzugrenzen, und testen Sie dann Ihre eigenen Charaktere und Sitzungsmuster.
Beginnen Sie mit GPT Protos KI-API für Rollenspiele, um eine Charakter-Konversation zu vergleichen, und fügen Sie die visuelle Generierung hinzu, sobald das Chat-Erlebnis Ihren Anforderungen entspricht.