Wenn Sie sich heute zwischen GPT 6.1 Terra und Sonnet 5.5 entscheiden müssen, finden Sie hier die kurze Entscheidungsregel, die ich vor der Durchführung eines Benchmarks anwende:
Wählen Sie GPT-6.1 Terra, wenn Ihre Pipeline hochvolumige Screenshot-Prüfungen, Formular- und Rechnungsautomatisierung, UI-Layout-Debugging oder begrenzte Programmieraufgaben ausführt, bei denen eine Token-Rate von 0,80 $/4,00 $ und eine dreimal schnellere Aufgabenausführung wichtiger sind als die maximale Tiefe bei der autonomen Refaktorierung – und Ihre Eingaben pro Anfrage bei oder unter 272.000 Token liegen.
Bleiben Sie bei Claude Sonnet 5.5, wenn Ihr Agent Repository-Migrationen über mehrere Dateien hinweg durchführt, tiefgreifendes Terminal-Debugging betreibt, bei dem eine verpasste Bearbeitung teurer ist als die Token-Rechnung, oder wenn Sie Single-Pass-Prompts zwischen 300.000 und 900.000 Token verwenden, bei denen der Langkontext-Aufschlag von OpenAI den Preisvorteil von Terra bei der Eingabe zunichtemacht.
Sie können die aktuellen Katalogpreise überprüfen oder Ihr monatliches Token-Volumen über den GPT Proto-Modellvergleichs-Hub laufen lassen, bevor Sie sich für einen der beiden Wege entscheiden. Alles, was folgt, ist ein auf Dokumentation und Benchmarks basierender Vergleich, der am 5. November 2026 verifiziert wurde; von Anbietern gemeldete Benchmarks sind separat von unabhängigen Messungen durch Artificial Analysis und frühem Entwickler-Feedback gekennzeichnet.
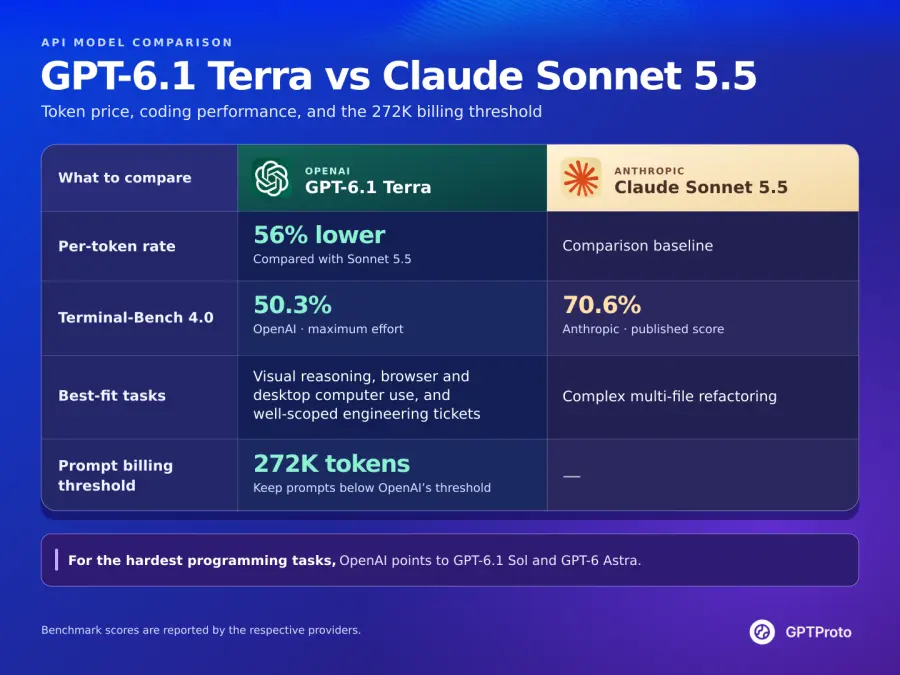
GPT-6.1 Terra vs. Claude Sonnet 5.5 im Überblick
Entwickler, die nach einem Vergleich zwischen ChatGPT 6.1 Terra und Sonnet 5.5 oder Anthropic Claude Sonnet 5.5 und GPT 6.1 Terra suchen, stoßen oft auf widersprüchliche Datenblätter, da die beiden Anbieter ihre Reasoning-Steuerungen, Tool-Endpunkte und Aufschläge für lange Kontexte unterschiedlich strukturieren. Die folgende Tabelle stellt beide Modelle der offiziellen gpt-6.1-terra-Dokumentation von OpenAI, der Übersicht zu Claude Sonnet 5.5 von Anthropic und den aktuellen GPT Proto-Katalogpreisen gegenüber.
| Spezifikation |
GPT-6.1 Terra (gpt-6.1-terra) |
Claude Sonnet 5.5 (claude-sonnet-5-5) |
| Anbieter |
OpenAI |
Anthropic |
| Veröffentlichungsdatum |
26. Oktober 2026 |
28. September 2026 |
| Offizieller Standard-Input / -Output (pro 1 Mio. Token) |
$1,00 / $5,00 |
$2,00 / $10,00 |
| GPT Proto Input / Output (pro 1 Mio. Token) |
$0,80 / $4,00 (−20 % ggü. offiziell) |
$1,80 / $9,00 (−10 % ggü. offiziell) |
| Offizielles Caching Input Read (pro 1 Mio. Token) |
$0,05 (5 % des Basis-Inputs) |
$0,10 (reduziert von $0,20 am 7. Okt. 2026) |
| Offizielles Cache Write (pro 1 Mio. Token) |
$1,25 (30 Min. TTL) / $2,50 (12 Std. TTL) |
$2,50 (5 Min. TTL) |
| GPT Proto Cache Read / Write (pro 1 Mio. Token) |
$0,04 / $1,00 |
$0,09 / $2,25 (Live-Modellseite prüfen) |
| Kontextfenster |
1.050.000 Token |
1.000.000 Token |
| Preisregel für lange Kontexte |
>272K Input wird voll mit 2x Input/Cache und 1,5x Output berechnet |
Pauschalpreis über das gesamte 1M-Kontextfenster |
| Maximale Output-Token |
128.000 Token |
128.000 Token |
| Input / Output Modalitäten |
Text, Bild, Dokument in → Text aus |
Text, Bild, Dokument in → Text aus |
| Wissensstichtag |
1. Juni 2026 |
Anfang bis Mitte 2026 (behält Sonnet 5 Tokenizer bei) |
| Reasoning / Effort-Steuerung |
none, low, medium (Standard), high, xhigh, max |
Adaptives Denken standardmäßig aktiviert; medium, high (API-Standard), max, between_tools |
| Erforderlicher Endpunkt für Tool-Aufrufe |
/v1/responses gemäß OpenAI-Dokumentation erforderlich |
/v1/messages (nativ) oder OpenAI-kompatibel /v1/chat/completions |
| Client- & IDE-Verfügbarkeit |
ChatGPT Work & Codex (nicht regulärer Chat), GitHub Copilot, Claude Code (via API) |
Claude.ai, Claude Code, GitHub Copilot, Cursor |
| AA Intelligence Index (v4.3.2) |
41 (medium) / 48 (max) |
56 (max, Standard-Fallback) |
| AA durchschnittliche Kosten pro Evaluierungsaufgabe |
$0,10 (`medium`) / $0,40 (max) |
$5,46 (max, Standard-Fallback) |
| Terminal-Bench 4.0 (vom Anbieter gemeldet) |
50,3 % (max Aufwand) |
70,6 % |
Drei Zeilen in dieser Tabelle leisten den Großteil der Arbeit, wenn Sie eine Anwendung budgetieren. Erstens: Bei Standardanfragen unter 272K Token ist GPT-6.1 Terra auf GPT Proto sowohl für Input als auch für Output um 56 % günstiger pro Token, sodass lange Vervollständigungen das Kostenranking nicht verändern. Zweitens: Sonnet 5.5 hat einen Vorsprung von 20,3 Prozentpunkten bei Terminal-Bench 4.0, was eng damit korreliert, wie sich die beiden Modelle bei ungesteuerten Repository-Bearbeitungen verhalten. Drittens: Im Gegensatz zu GPT-6.1 Sol stellt GPT-6.1 Terra die Unterstützung für reasoning.effort: "none" wieder her und bietet OpenAI-Entwicklern damit wieder einen echten, schnellen Pfad ohne Reasoning.
Preis- und Kostenaufschlüsselung: Was ist teurer und was ist kosteneffizienter?
Wenn Entwickler nach "GPT 6.1 Terra vs Sonnet 5.5 was ist teurer" oder "was ist kosteneffizienter" suchen, versuchen sie meist, zwei verschiedene Zahlen in Einklang zu bringen: den Tarif pro Million Token auf der Preisseite und die tatsächlichen Dollar-Kosten einer abgeschlossenen Agenten-Aufgabe. Diese beiden Verhältnisse sind nicht identisch.
Auf der Ebene pro Token ist Claude Sonnet 5.5 das deutlich teurere Modell. Die offiziellen Preise von Anthropic liegen bei 2,00 $ pro Million Input-Token und 10,00 $ pro Million Output-Token – das Doppelte des Listenpreises von OpenAI von 1,00 $/5,00 $ für Terra. Da GPT Proto einen Rabatt von 20 % auf GPT-6.1 Terra (0,80 $ Input / 4,00 $ Output) und einen Rabatt von 10 % auf Claude Sonnet 5.5 (1,80 $ Input / 9,00 $ Output) gewährt, kostet Sonnet 5.5 auf der Plattform pro Token 2,25-mal so viel. Beide Anbieter berechnen für gecachte Input-Lesevorgänge inzwischen 5 % des Basis-Inputs (offiziell 0,05 $ für Terra gegenüber 0,10 $ für Sonnet 5.5 nach Anthropic die Cache-Lesepreise für Sonnet im Oktober 2026 halbiert hat), und beide berechnen für Standard-Cache-Schreibvorgänge das 1,25-fache des Basis-Inputs (offiziell 1,25 $ gegenüber 2,50 $). Beachten Sie, dass ein einmalig verwendeter langer Prompt, der in den Cache geschrieben wird, bei beiden Modellen einen Aufschlag von 25 % verursacht, wenn Sie dieses Präfix nie ein zweites Mal lesen.
Auf der Ebene pro Aufgabe wird die Lücke deutlich größer. Im Intelligence Index v4.3.2 von Artificial Analysis (veröffentlicht am 26.–27. Oktober 2026) verzeichnete die getestete Claude Sonnet 5.5-Konfiguration (max Aufwand mit Standard-Fallback) gewichtete Durchschnittskosten von 5,46 $ pro Evaluierungsaufgabe. In derselben Evaluierungssuite kostete [GPT-6.1 Terra bei `max` Aufwand](https://artificialanalysis.ai/models/gpt-6-1-terra) durchschnittlich 0,40 $ pro Aufgabe, und GPT-6.1 Terra bei medium Aufwand kostete durchschnittlich nur 0,10 $ pro Aufgabe. Das ist ein 13,6-facher Unterschied bei max Aufwand und ein 54,6-facher Unterschied beim Vergleich der höchsten Einstellung von Sonnet mit der standardmäßigen medium Einstellung von Terra.
Warum wird aus einem 2-fachen Unterschied pro Token eine Kostenlücke von 13x bis 54x? Reasoning-Modelle berechnen Denk-Token als Output-Token. Wenn Sonnet 5.5 bei hohem oder maximalem Aufwand für einen offenen Benchmark läuft, generiert es lange Reasoning-Ketten zu 10,00 $ pro Million Token (9,00 $ bei GPT Proto). Die Ankündigung von Terra weist auch darauf hin, dass Terra bei maximalem Aufwand im „Agents' Last Exam“ weniger als ein Drittel der Token verbrauchte wie Claude Opus 5.5. Noch wichtiger ist die Pareto-Frontier-Erkenntnis von Artificial Analysis: Für GPT-6.1 Terra sind die Einstellungen low und medium Pareto-optimal in Bezug auf Intelligenz versus Kosten. Das Hochstellen von Terra auf max hebt den Score von 41 auf 48, was gleichzieht mit GPT-6.1 Sol bei medium Aufwand – außer dass Sol medium 0,21 $ pro Aufgabe kostet, während Terra `max` 0,40 $ kostet. Kurz gesagt: Wenn Sie das kosteneffizienteste Setup für Terra wünschen, belassen Sie es bei low oder medium; wenn eine Aufgabe schwierig genug ist, um max Aufwand zu erfordern, sollten Sie bereits Sol oder Sonnet 5.5 testen.
Kalkulation der Arbeitskosten: Zwei reale Produktionsszenarien
Um zu sehen, wo sich die günstigeren Token-Preise tatsächlich auszahlen – und wo sie nach hinten losgehen –, führen wir die genaue Rechnung mit den Live-Katalogpreisen von GPT Proto durch ($0,80/$4,00 für Terra; $1,80/$9,00 für Sonnet 5.5), unter der Annahme von nicht zwischengespeicherten Anfragen unter 272K Token.
Szenario A ist eine 20-stufige Agenten-Schleife für visuelle Qualitätssicherung und Formularextraktion. Jeder Schritt sendet einen Screenshot und einen DOM-Ausschnitt mit insgesamt 15.000 Eingabe-Token und generiert 1.500 Ausgabe-Token (einschließlich medium Reasoning-Token). Über 20 Schritte hinweg verbraucht ein einzelner Workflow 300.000 Eingabe-Token (0,3 Mio.) und 30.000 Ausgabe-Token (0,03 Mio.):
GPT-6.1 Terra auf GPT Proto: (0,3 * $0,80) + (0,03 * $4,00) = $0,24 + $0,12 = $0,36 pro Workflow.
Claude Sonnet 5.5 auf GPT Proto: (0,3 * $1,80) + (0,03 * $9,00) = $0,54 + $0,27 = $0,81 pro Workflow.
Bei 10.000 Workflows pro Monat kostet Terra $3.600 gegenüber $8.100 bei Sonnet – eine monatliche Ersparnis von $4.500. Selbst wenn Terra bei 20 % seiner Durchläufe die Validierung nicht besteht und diese 2.000 Workflows von Grund auf neu starten muss (was $720 kostet), beläuft sich Ihre Gesamtrechnung auf $4.320, was immer noch eine Ersparnis von $3.780 pro Monat gegenüber einem Sonnet-Durchlauf ohne Wiederholungen bedeutet.
Szenario B ist ein Backend-Refactoring mehrerer Dateien in einem aktiven Pull Request. Angenommen, jeder Versuch liest 80.000 Eingabe-Token und gibt 10.000 Ausgabe-Token aus. Ein sauberer Durchlauf mit Sonnet 5.5 kostet (0,08 * $1,80) + (0,01 * $9,00) = $0,234. Ein Durchlauf mit Terra kostet (0,08 * $0,80) + (0,01 * $4,00) = $0,104. Sie sparen 13 Cent beim API-Aufruf. Der Haken ist: Wenn Terra eine Abhängigkeit zwischen Modulen übersieht – was mit der Lücke von 50,3 % zu 70,6 % im Terminal-Bench übereinstimmt – und drei Wiederholungen sowie 12 Minuten Arbeitszeit eines Senior-Entwicklers zu $90/Stunde ($18,00 an Arbeitskosten) erzwingt, hat Sie diese 13-Cent-Ersparnis bei den Token gerade $18,18 gekostet. Kurz gesagt: Terra gewinnt bei wiederholbaren, maschinell überprüfbaren Schleifen haushoch, während Sonnet 5.5 seinen höheren Tarif immer dann rechtfertigt, wenn eine fehlerhafte Bearbeitung Zeit für menschliche Überprüfungen verschlingt.
Kontextfenster (1,05 Mio. vs. 1 Mio.): Warum das Überschreiten von 272.000 Token die Rechnung verändert
Auf dem Papier sieht der Vergleich zwischen GPT 6.1 Terra und Sonnet 5.5 Kontextfenster wie ein Kopf-an-Kopf-Rennen mit einem leichten Vorteil für OpenAI aus: Terra akzeptiert 1.050.000 Eingabe-Token und gibt bis zu 128.000 Ausgabe-Token aus, während Claude Sonnet 5.5 1.000.000 Eingabe-Token akzeptiert und bis zu 128.000 Ausgabe-Token ausgibt. Die meisten Vergleichstabellen enden hier.
Wenn man jedoch die Dokumentation zum Modell gpt-6.1-terra von OpenAI liest, gibt es bei 272.000 Eingabe-Token eine Abrechnungsgrenze, die die Wirtschaftlichkeit bei langem Kontext grundlegend verändert. Sobald ein Prompt auf GPT-6.1 Terra 272.000 Eingabe-Token überschreitet, berechnet OpenAI die gesamte Anfrage – nicht nur die Token über 272.000 – mit dem Doppelten der Eingabe- und Cache-Raten sowie dem 1,5-Fachen der Ausgaberate.
Hier ist, was mit dem offiziellen Tarif pro Million Token passiert, sobald Ihr Prompt die Grenze von 272.000 auf 272.001 Token überschreitet:
| Kontextbereich |
GPT-6.1 Terra (Offizieller Tarif) |
Claude Sonnet 5.5 (Offizieller Tarif) |
Verhältnis der Eingabepreise |
| Standard-Prompt (≤272K Eingabe-Token) |
1,00 $ Eingabe / 5,00 $ Ausgabe / 0,05 $ Cache-Lesezugriff |
2,00 $ Eingabe / 10,00 $ Ausgabe / 0,10 $ Cache-Lesezugriff |
Terra ist 50 % günstiger bei Eingabe und Ausgabe |
| Langkontext-Prompt (>272K bis 1M+ Eingabe-Token) |
2,00 $ Eingabe / 7,50 $ Ausgabe / 0,10 $ Cache-Lesezugriff |
2,00 $ Eingabe / 10,00 $ Ausgabe / 0,10 $ Cache-Lesezugriff |
Eingabe- und Cache-Lese-Raten sind identisch (2,00 $ / 0,10 $). |
Im Gegensatz zu Anthropics kleinerem Modell Haiku 5.5 (das einen Aufschlag von 5x über 100K Token erhebt), behält Claude Sonnet 5.5 eine einheitliche Preisgestaltung über das gesamte 1.000.000-Token-Kontextfenster bei.
Rechnen wir das für ein Repository-Audit mit 400.000 Token durch, das 10.000 Ausgabe-Token zu offiziellen Listenpreisen erzeugt:
GPT-6.1 Terra (löst die >272K 2x/1,5x-Regel aus): (0,4 * 2,00 $) + (0,01 * 7,50 $) = 0,80 $ + 0,075 $ = 0,875 $.
Claude Sonnet 5.5 (Pauschalpreis): (0,4 * 2,00 $) + (0,01 * 10,00 $) = 0,80 $ + 0,10 $ = 0,900 $.
Sobald Ihr Prompt 272.000 Token überschreitet, verschwindet Terras 50%-Eingaberabatt vollständig, was bei einem Aufruf mit 400.000 Token einen Gesamtdifferenzbetrag von 0,025 $ hinterlässt. Meine Empfehlung ist eindeutig: Senden Sie niemals monolithische Prompts mit >272K Token an GPT-6.1 Terra in der Erwartung, von der halben Preisgestaltung zu profitieren. Entweder stückeln/abrufen Sie Ihren Kontext unter 272.000 Token, damit Terra in seiner 1,00 $-Klasse (0,80 $ GPT Proto) bleibt, oder leiten Sie Repository-Dumps von 300K–900K direkt an Claude Sonnet 5.5 weiter, wo Sie denselben offiziellen Eingabetarif zahlen und eine stärkere Code-Verständnis bei langen Kontexten erhalten. (Bevor Sie Prompts mit >272K in der Produktion über GPT Proto ausführen, bestätigen Sie mit dem Plattform-Support, wie die vorgelagerte 272K-Tarifanpassung auf Ihrem Kontostand ausgewiesen wird.)
Benchmarks und Community-Feedback: Programmierung, Frontend und agentische Arbeit
Zusammenfassende Gesamtwerte verschleiern, wo die einzelnen Modelle tatsächlich erfolgreich sind. Im Artificial Analysis Intelligence Index v4.3.2 erreicht Claude Sonnet 5.5 (max, Standard-Fallback) 56 Punkte, GPT-6.1 Sol (max) erreicht 52 Punkte und GPT-6.1 Terra erreicht 48 Punkte bei max Aufwand sowie 41 Punkte bei medium Aufwand. (Auf dem Index-Snapshot vom 3. November 2026, der auf der Vergleichskarte von GPT Proto angezeigt wird, verzeichnet Sonnet 5.5 54,2 Punkte und Terra max verzeichnet 51 – ein geringerer Abstand von 3,2 Punkten, der jedoch immer noch zugunsten von Sonnet ausfällt.) Um eine praktische Routing-Entscheidung für Code, Frontend-UI oder Agenten-Schleifen zu treffen, müssen wir diese Aggregate nach Aufgabentyp aufschlüsseln und sie mit dem vergleichen, was Entwickler in der Praxis berichten.
1. Backend- und Terminal-Programmierung (GPT 6.1 Terra vs. Sonnet 5.5 für Code)
Für reine Softwareentwicklung über die Befehlszeile hat Anthropic weiterhin einen klaren Vorteil. Auf dem Terminal-Bench 4.0 meldet Anthropic 70,6 % für Claude Sonnet 5.5 (ein Anstieg von 10,3 % bei Sonnet 5), während OpenAI 50,3 % für GPT-6.1 Terra bei maximalem Aufwand meldet (ein Anstieg von 21,5 % bei GPT-5.6 Terra). Im kürzlich veröffentlichten Coding Agent Index v2.0 von Artificial Analysis erreicht Terra 48 Punkte – 17 Punkte vor dem leichtgewichtigen GPT-6 Luna (31), aber 6 Punkte hinter GPT-6.1 Sol (54). Artificial Analysis merkt zudem an, dass die geringen und sehr hohen Aufwandseinstellungen von Terra an der Grenze der Kosteneffizienz liegen, während andere Aufwandseinstellungen zurückbleiben.
Erste Praxistests zeigen die genaue Grenze zwischen den beiden Modellen auf:
Das Changelog des GitHub Copilot-Releases vom 26. Oktober 2026 berichtete, dass GPT-6.1 Terra in ersten internen Tests spürbar mehr Terminal- und C#-Programmieraufgaben löste als GPT-5.6 Terra, und fügte eine entscheidende Verhaltensbeobachtung hinzu: „Es arbeitet in fokussierten, konsolidierten Schritten bei klar abgegrenzten Aufgaben.“ GitHub veröffentlichte in dieser Notiz keine rohen Erfolgsquoten, daher sollte dies eher als qualitative Plattform-Erkenntnis denn als kontrollierter Benchmark betrachtet werden.
Auf der Seite von Claude ergab ein früher direkter Entwicklertest auf r/ClaudeAI (bei dem zehn persönliche Programmieraufgaben dreimal pro Konfiguration bei hohem Aufwand in Claude Code und pi-agent ausgeführt wurden), dass Sonnet 5.5 Implementierungen konsistent in weniger Konversationsschritten und mit weniger Output-Tokens abschloss als sein Vorgänger, hauptsächlich weil Sonnet 5.5 parallele Tool-Aufrufe aggressiver bündelt. Ähnlich verhält es sich bei Cursors externer CursorBench 4.0-Evaluierung, wo Sonnet 5.5 bei hohem Aufwand 47,8 % bei 1,67 $ pro Aufgabe erzielte.
Das Fazit für Backend-Entwickler: Wenn das Ticket klar definiert ist – das Schreiben einer C#-Servicemethode, das Hinzufügen eines Unit-Tests oder das Korrigieren eines isolierten CLI-Skripts –, wird Terra bei geringem oder mittlerem Aufwand dies schnell und zu weniger als dem halben Token-Preis erledigen. Wenn das Ticket das Nachverfolgen von Zuständen über zehn Dateien hinweg erfordert, bei denen eine zusätzliche Wiederholungsschleife den Arbeitsablauf stört, rechtfertigt die 70,6%ige Terminal-Kompetenz von Sonnet 5.5 den höheren Preis. Wo wissenschaftliches Rechnen involviert ist, berichtet OpenAI zudem, dass Terra auf dem Terminal-Bench-Science 0.1 (z. B. beim Schreiben von Code zur Verfolgung von Zellteilungen in Zeitraffer-Videos) bei maximalem Aufwand tatsächlich GPT-6.1 Sol übertrifft und bis auf fünf Punkte an Claude Opus 5.5 herankommt, bei weniger als einem Fünftel der geschätzten Kosten.
2. GPT-6.1 Terra vs. Sonnet 5.5 für Frontend-Programmierung
Die Suche nach GPT 6.1 Terra vs. Sonnet 5.5 für Frontend-Programmierung verdient eine eigene Antwort, da Frontend-Engineering aus zwei verschiedenen, miteinander verbundenen Aufgaben besteht: visuelle/DOM-Layout-Arbeit und Zustands-/Architekturlogik.
Als OpenAI den 50,3%-Score von GPT-6.1 Terra im Terminal-Bench 4.0 vorstellte, war das einzige konkrete Programmierbeispiel, das in der Ankündigung hervorgehoben wurde, ein Frontend-Fehler: „Behebung einer Webseite, deren Layout sich beim Laden verschiebt“ (Cumulative Layout Shift oder CLS). Gleichzeitig berichtete OpenAI, dass GPT-6.1 Terra bei MMMU-Pro – einem Benchmark für visuelles Schlussfolgern anhand von Diagrammen, Screenshots und komplexen Layouts – GPT-5.6 Terra über alle Schwierigkeitsgrade hinweg übertrifft und fast das Niveau der Spitzenmodelle GPT-6 Astra und GPT-6.1 Sol zu einem Bruchteil des Preises erreicht. Im Launch-Thread im OpenAI Developer Community-Forum fasste eine der ersten Entwicklerreaktionen Terra als „ein tolles Preis-Leistungs-Verhältnis, besonders wenn es um visuelles Verständnis geht. Auch bei der Programmierung ordentlich.“
Diese Aufteilung bietet Frontend-Teams eine klare Arbeitsteilung:
Verwenden Sie GPT-6.1 Terra für visuelle und UI-Layer-Frontend-Arbeiten: Umwandlung von Figma-Screenshots oder Wireframes in erstes Tailwind/HTML-Markup, Vergleich von gerenderten Playwright-Screenshots mit Design-Spezifikationen, um überlappende DOM-Knoten oder Regressionen bei mobilen Breakpoints zu erkennen, sowie die Diagnose von CSS-Layout-Verschiebungen. Da Terra Bilder nativ verarbeitet, über 3x schneller als GPT-6.1 Sol und Astra bei Benchmarks für visuelle Aktionen läuft und auf GPT Proto 0,80 $/4,00 $ kostet, kann es sich Ihre CI-Pipeline leisten, bei jedem Commit visuelle Regressionsprüfungen durchzuführen.
Verwenden Sie Claude Sonnet 5.5 für logikintensive Frontend-Architektur: Refactoring komplexer React/Next.js Server-Action-Zustandsbäume, Auflösung komplizierter TypeScript-Generic-Constraints oder Migration eines Legacy-Redux-Stores ohne Unterbrechung der Hydration. Wenn kein Screenshot zu prüfen ist und die Schwierigkeit rein in der Kohärenz des Zustands über mehrere Dateien hinweg liegt, bleibt Sonnet 5.5 die sicherere Wahl.
3. Agentische Arbeit, Computernutzung und Faktizität (für agentische Arbeit)
Wenn Ihre Definition von GPT 6.1 Terra vs Sonnet 5.5 für agentische Arbeit sich auf GUI-Automatisierung, Dokumenten-Parsing und Back-Office-Computernutzung konzentriert, ist GPT-6.1 Terra wohl OpenAIs wertvollste Veröffentlichung des Jahres 2026.
In OpenAIs herstellerseitig gemeldeten Bewertungen zum Agents' Last Exam v1 (der mehrstufige professionelle Workflows testet, wie das Umwandeln architektonischer Zeichnungen in ein 3D-Modell oder das Protokollieren von Timecodes für jeden Shot in einem Animationsfilm), erzielte GPT-6.1 Terra bei mittlerem Aufwand 15 Prozentpunkte mehr als GPT-5.6 Terra bei etwa einem Drittel der Kosten und entsprach damit dem Flaggschiff GPT-6 Astra bei einem Zehntel des Token-Preises. Bei maximalem Aufwand berichtet OpenAI, dass Terra über 3x token-effizienter als Claude Opus 5.5 ist und nur ein Viertel des Preises pro Token kostet, was zu etwa 9x niedrigeren Kosten pro Aufgabe führt, während Workflows über 3x schneller abgeschlossen werden als mit GPT-6 Astra und GPT-6.1 Sol.
Bei OSWorld 2.1 (Desktop-Anwendungssteuerung) berichtet OpenAI, dass Terra bei mittlerem Aufwand das beste Ergebnis von GPT-5.6 Terra zu einem Bruchteil der Kosten pro Aufgabe übertrifft. Um dies ausgewogen zu betrachten: Anthropics veröffentlichter OSWorld 2.1 (Offline)-Wert für Claude Sonnet 5.5 liegt bei sehr hohen 83,9 % (offengelegt in Anthropics Haiku 5.5 Benchmark-Tabelle vom Oktober 2026). Beide Modelle sind erstklassige Engines für die Computernutzung; der Unterschied besteht darin, dass Screen-Scraping-Agenten bei jedem Klick einen neuen Screenshot senden, was Input-Token schnell verbraucht und Terras GPT Proto-Input-Rate von 0,80 $/M bei Skalierung wesentlich nachhaltiger macht.
Ebenso wichtig für autonome Agenten ist es zu wissen, wann das Modell etwas nicht weiß. Im unabhängigen AA-Omniscience-Benchmark von Artificial Analysis sank die Halluzinationsrate von GPT-6.1 Terra (wie oft das Modell rät, wenn ihm Wissen fehlt) um 50 Prozentpunkte – von 88 % bei GPT-5.6 Terra auf 38 % – während gleichzeitig die Gesamtgenauigkeit um 2 Punkte stieg. Diese unabhängige Messung untermauert OpenAIs interne Faktizitätsbewertung (weiter detailliert in der GPT-6.1 Terra System Card), bei der die Fehlerraten bei geringem Aufwand für schwierige Prompts von 53,6 % auf 16,7 % (und bei maximalem Aufwand auf 4,3 %) fielen. Niedrigere Halluzinationsraten bedeuten weniger fehlerhafte Tool-Aufrufe nachgelagert.
Entwicklererfahrung und API-Fallstricke (GPT 6.1 Terra vs. Sonnet 5.5 für Entwickler)
Der Wechsel zwischen gpt-6.1-terra und claude-sonnet-5-5 in der Produktion ist selten mit einem einfachen String-Austausch getan. Wenn Sie die Ergonomie von GPT 6.1 Terra vs. Sonnet 5.5 für Entwickler bewerten, werden vier API-Ebenen-Einschränkungen Ihre Integrationsarbeit bestimmen.
Erstens: GPT-6.1 Terra unterstützt reasoning.effort: "none", während GPT-6.1 Sol dies nicht tut. Als OpenAI am 29. September 2026 GPT-6.1 Sol einführte, wurden die Reasoning-Stufen none und minimal entfernt, wodurch jede Anfrage auf low oder höher gezwungen wurde, was temperature und top_p durchgehend außer Kraft setzte. Laut OpenAIs offiziellem gpt-6.1-terra Prompting- und Migrationsleitfaden unterstützt Terra das gesamte Spektrum: none, low, medium (Standard), high, xhigh und max. Wenn Sie reasoning_effort: "none" festlegen, läuft Terra ohne die Generierung versteckter Reasoning-Token und erlaubt Standard-Sampling-Parameter. Sobald Sie jedoch low, medium, high, xhigh oder max verwenden, müssen Sie temperature, top_p, top_logprobs und logprobs aus Ihrer Request-Payload entfernen, da die API den Aufruf sonst mit einem HTTP 400-Fehler ablehnt.
Zweitens: OpenAI erfordert die Responses API (/v1/responses) für Tool-Aufrufe bei GPT-6.1 Terra. Während einfache Text- und Bild-Prompts über /v1/chat/completions funktionieren, besagt OpenAIs Modelldokumentation ausdrücklich, dass Tool-Aufrufe /v1/responses erfordern. Sobald Sie die Responses API nutzen, unterstützt Terra alle neun nativen, integrierten Tools von OpenAI – Web-Suche, Dateisuche, Bildgenerierung, Code-Interpreter, Hosted Shell, apply_patch, Skills, Computer-Nutzung, MCP und Tool-Suche – sowie async: true bei benutzerdefinierten Funktionstools, damit das Modell weiterdenken kann, während ein langsames Hintergrund-Tool ausgeführt wird. Darüber hinaus unterstützt Terra das Senden eines configuration_update-Eingabeelements mitten im Gespräch, um reasoning.effort bei einem schwierigen Schritt zu erhöhen oder zu verringern, ohne das Prompt-Präfix neu schreiben oder Ihren 30-minütigen Prompt-Cache (prompt_cache_options.ttl: "30m") ungültig machen zu müssen.
Drittens: Claude Sonnet 5.5 hat seine eigenen strikten 400-Fehler-Fallen. Laut Anthropics Sonnet 5.5-Migrationsleitfaden verwendet Sonnet 5.5 standardmäßig adaptives Denken (standardmäßig high Effort über die API und medium in Claude Code, wie in Anthropics Claude Code-Konfigurationsdokumentation vermerkt). Wenn Ihre bestehende Claude-Integration thinking: {"type": "disabled"} sendet, müssen Sie dies für die niedrigste Denkeinstellung auf between_tools aktualisieren. Noch wichtiger ist, dass Sonnet 5.5 erzwungene Tool-Auswahlen (tool_choice: {"type": "any"} oder ein erzwungenes benanntes Tool) bei aktivem adaptivem Denken mit einem 400-Fehler ablehnt; Sie müssen auto verwenden und die Tool-Auswahl im Prompt steuern. Sie müssen außerdem Antwort-Inhaltsblöcke nach type parsen, anstatt davon auszugehen, dass content[0] Text ist, da der erste Block häufig ein thinking-Block ist.
Viertens: Die IDE- und CLI-Integration ist bereits für beide vorkonfiguriert. Beachten Sie, dass die Release-Notes von OpenAI für Endkunden-Abonnements bestätigen, dass GPT-6.1 Terra für ChatGPT Work und Codex (für Plus-, Pro-, Business-, Enterprise- und Edu-Pläne) eingeführt wurde, nicht jedoch für die Standard-ChatGPT-Chat-Oberfläche. Zudem wird die Datenresidenz in den VAE nicht unterstützt (obwohl der Fast-Modus die EU-Datenresidenz unterstützt). Für Entwickler, die in lokalen Terminals arbeiten, können beide Modelle über GPT Proto mit Claude Code und OpenAI Codex verbunden werden. Auf der Modellseite von GPT-6.1 Terra öffnet ein Klick auf Try this model ein Quick-Start-Panel, in dem Sie unter Let AI finish the integration die Option Claude Code oder ChatGPT (Codex) auswählen können, oder klicken Sie auf Copy Markdown for AI, damit Ihr Coding-Assistent die Umgebungsvariablen automatisch einrichtet.
Apps erstellen: So routen Sie beide Modelle mit einem API-Schlüssel
Wenn Teams nach GPT 6.1 Terra vs. Sonnet 5.5 für die App-Entwicklung fragen, ist die beste Architektur fast nie, sich für 100 % des Traffics auf ein einziges Modell festzulegen. Da beide Modelle unter einem einzigen Prepaid-Guthaben bei GPT Proto laufen, können Sie nach Schritt statt nach Anbieter routen: Senden Sie hochfrequente visuelle Inspektionen, Screenshot-Klassifizierungen und begrenzte UI-Korrekturen an gpt-6.1-terra zu $0,80/$4,00 und eskalieren Sie die dateiübergreifende Codesynthese an claude-sonnet-5-5 zu $1,80/$9,00.
1. Erster cURL-Check (OpenAI-kompatible Chat-Completions)
Beide Modelle können für Text- und Bildanalysen über den einheitlichen, OpenAI-kompatiblen /v1/chat/completions-Endpunkt von GPT Proto unter Verwendung eines Standard-Bearer-Tokens aufgerufen werden. Der Wechsel zwischen ihnen erfordert lediglich die Änderung des "model"-Strings:
# Aufruf 1: GPT-6.1 Terra ($0,80 Input / $4,00 Output pro 1 Mio. Token bei GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [
      {
        "role": "user",
        "content": "Untersuche diese CSS-Regel und erkläre in zwei Sätzen, warum sie auf Mobilgeräten einen Layout-Shift auslöst: .hero-banner { width: 100%; height: auto; }"
      }
    ]
  }'

# Aufruf 2: Claude Sonnet 5.5 ($1,80 Input / $9,00 Output pro 1 Mio. Token bei GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "messages": [
      {
        "role": "user",
        "content": "Schreibe einen TypeScript-Helfer, der Webhook-Signaturen mithilfe der Web Crypto API mit einem Vergleich in konstanter Zeit validiert."
      }
    ]
  }'
2. Python-Schritt-Router-Beispiel für Frontend- & App-Pipelines
Hier ist ein praktisches Python-Muster, das das Standard-openai-SDK verwendet, das auf https://gptproto.com/v1 verweist. In diesem Workflow verwendet Schritt 1 gpt-6.1-terra, um einen UI-Fehlerbericht zu triagieren (wobei das Token-Volumen hoch und die visuelle/DOM-Diagnose kostengünstig ist), und Schritt 2 routet den eigentlichen Code-Patch dynamisch entweder an gpt-6.1-terra (für isolierte CSS-Korrekturen einzelner Komponenten) oder an claude-sonnet-5-5 (wenn die Triage eine dateiübergreifende Zustandsänderung signalisiert oder wenn der Prompt sich der 272K-Grenze nähert):
import os
import json
from openai import OpenAI

# Ein API-Schlüssel und geteiltes Guthaben für OpenAI- und Anthropic-Modelle
client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

def triage_and_patch_ui_issue(dom_snapshot: str, screenshot_url: str, approx_tokens: int) -> dict:
    # Schritt 1: Führen Sie immer eine visuelle/DOM-Triage auf GPT-6.1 Terra durch ($0,80 / $4,00 pro 1 Mio.)
    triage_response = client.chat.completions.create(
        model="gpt-6.1-terra",
        messages=[
            {
                "role": "system",
                "content": (
                    "Du bist ein Frontend-QA-Triage-Agent. Untersuche den Screenshot und das DOM. "
                    "Gib JSON mit den Schlüsseln 'root_cause', 'scope' ('isolated_css' oder 'multi_file_state') "
                    "und 'target_files' (Array von Strings) zurück."
                ),
            },
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": f"DOM-Snapshot: {dom_snapshot}"},
                    {"type": "image_url", "image_url": {"url": screenshot_url}},
                ],
            },
        ],
        response_format={"type": "json_object"},
    )

    triage_data = json.loads(triage_response.choices[0].message.content)

    # Schritt 2: Routing nach Aufgabenbereich UND der 272K-Long-Context-Abrechnungsgrenze
    # Wenn der Fix den Multi-File-Status betrifft ODER 272K Eingabe-Token überschreitet, eskaliere auf Sonnet 5.5
    if triage_data.get("scope") == "multi_file_state" or approx_tokens > 272_000:
        selected_model = "claude-sonnet-5-5"
    else:
        selected_model = "gpt-6.1-terra"

    patch_response = client.chat.completions.create(
        model=selected_model,
        messages=[
            {
                "role": "user",
                "content": (
                    f"Triage-Diagnose: {json.dumps(triage_data)} | "
                    f"Erstelle einen minimalen, produktionsreifen Patch für das DOM/die Komponente: {dom_snapshot}"
                ),
            }
        ],
    )

    return {
        "triage": triage_data,
        "routed_to": selected_model,
        "patch": patch_response.choices[0].message.content,
    }

if __name__ == "__main__":
    sample_dom = "<div class='card-grid'><img src='/hero.webp' /><h2>Checkout</h2></div>"
    result = triage_and_patch_ui_issue(
        dom_snapshot=sample_dom,
        screenshot_url="https://example.com/cls-regression-frame.png",
        approx_tokens=12_000,
    )
    print(f"Patch weitergeleitet an: {result['routed_to']}")
    print(result["patch"])
Hinweis vor der Bereitstellung (Smoke-Test erforderlich): Überprüfen Sie die exakten Modell-Strings (gpt-6.1-terra und claude-sonnet-5-5) anhand der Live-API-Nutzungs-Panels auf den jeweiligen GPT Proto-Modellseiten, bevor Sie abrechenbare Schleifen bereitstellen. Wenn Ihr Agent auf den nativen Responses-API-Tools von OpenAI (apply_patch, Hosted Shell oder async: true Funktionsaufrufe) oder den nativen /v1/messages adaptiven Denkparametern von Anthropic (output_config.effort) basiert, führen Sie einen schnellen Smoke-Test gegen die jeweiligen nativen Endpunkte von GPT Proto (/v1/responses und /v1/messages) durch, um die Parameter-Weiterleitung auf Ihrer Route zu bestätigen.
Fazit: Welches Modell sollten Sie verwenden?
Wenn Sie eine einzige Tabelle für Ihr Architektur-Review-Dokument benötigen, richten Sie Ihren primären Workload nach dem Fehlermodus und der Abrechnungsgrenze aus, die für Sie am wichtigsten sind:
| Workload / Szenario |
Empfohlenes Modell |
Empfohlene Einstellung |
Warum es gewinnt |
| High-Volume Screenshot-QA, Rechnungs-/Formularlesung & Computer-Nutzung per Browser |
GPT-6.1 Terra |
low oder medium effort |
56 % niedrigere GPT Proto-Token-Rate ($0,80/$4,00), >3x schnellere Aufgabenerledigung als Sol/Astra und Vision-Fähigkeiten auf Astra-Niveau (MMMU-Pro). |
| Frontend-UI-Debugging (CLS-Layout-Verschiebungen, Figma-zu-CSS, visuelle Regressionen) |
GPT-6.1 Terra |
medium effort |
Entwickelt für visuelle Inspektion und DOM-Prüfung; explizit auf die Behebung von Layout-Verschiebungen bei Webseiten ausgelegt. |
Klassifizierung mit geringer Latenz, Routing oder JSON-Extraktion, bei der temperature benötigt wird |
GPT-6.1 Terra |
reasoning.effort: "none" |
Stellt die Non-Reasoning-Stufe none wieder her, die GPT-6.1 Sol gestrichen hat, und hält Latenz sowie Output-Token-Anzahl minimal. |
| Backend-Refactoring über mehrere Dateien & komplexe TypeScript/React-Statusänderungen |
Claude Sonnet 5.5 |
medium oder high effort |
70,6 % gegenüber 50,3 % bei Terminal-Bench 4.0; bündelt Tool-Aufrufe in weniger Schritten, was wertvolle Zeit bei der Entwicklerprüfung spart. |
| Repository-Analyse mit langem Kontext in einer einzigen Anfrage (300.000 bis 900.000 Input-Token) |
Claude Sonnet 5.5 |
medium oder high effort |
Terra löst oberhalb von 272.000 Token einen Aufschlag von 2x Input / 1,5x Output aus (Anstieg auf $2,00 offiziellen Input), wodurch der Preisvorteil entfällt. |
Tiefgreifendes OpenAI-natives Terminal-Coding, wenn Terra max nicht ausreicht |
GPT-6.1 Sol |
medium effort |
Erreicht 54 gegenüber 48 von Terra im AA Coding Agent Index v2.0, und Sol medium ($0,21/Aufgabe) ist pro Aufgabe tatsächlich günstiger als Terra `max` ($0,40/Aufgabe). |
Um das Fazit ohne Umschweife zusammenzufassen: Starten Sie jeden wiederholbaren visuellen, computergestützten und begrenzten Coding-Schritt mit GPT-6.1 Terra bei low oder medium effort, um die Rate von $0,80/$4,00 zu nutzen. Behalten Sie Claude Sonnet 5.5 für Coding-Schritte über mehrere Dateien und Prompts mit >272.000 Token bei, bei denen sich die höhere Genauigkeit im ersten Durchlauf und die pauschale Preisgestaltung für 1 Mio. Kontext auszahlen. Um Ihre eigenen monatlichen Input- und Output-Verhältnisse einzugeben, öffnen Sie den GPT Proto Vergleichsrechner und testen Sie beide Modelle direkt nebeneinander.