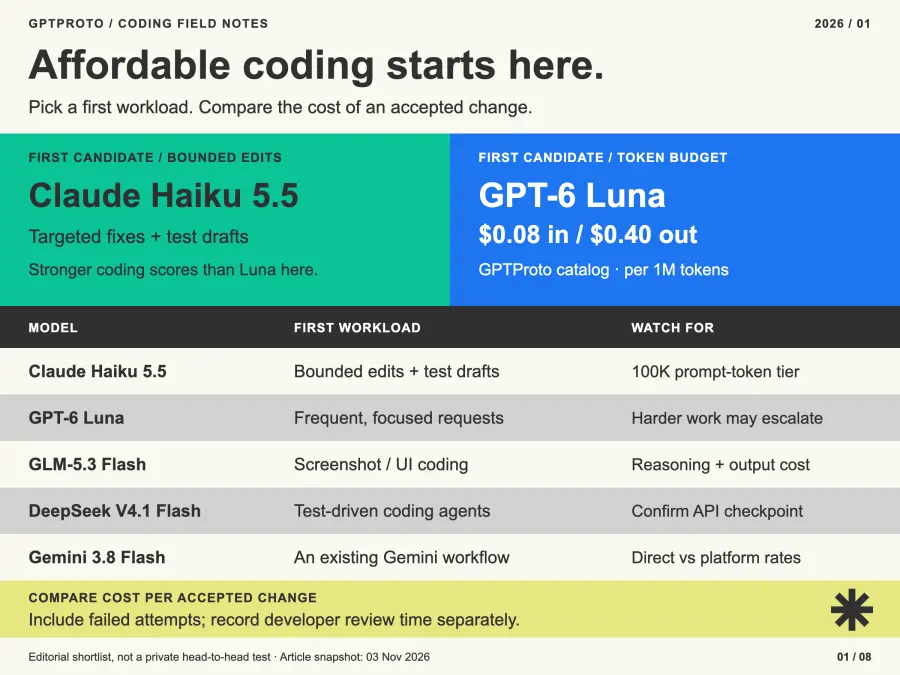
한눈에 보는 가성비 코딩 LLM
| 모델 |
평가할 첫 번째 워크로드 |
주요 트레이드오프 |
| Claude Haiku 5.5 |
제한된 코드 수정, 테스트 초안 작성 및 코딩 하위 작업 |
10만 프롬프트 토큰을 초과하면 저가 요금제 혜택이 종료됨 |
| GPT-6 Luna |
빈번하고 범위가 좁은 코딩 요청 |
더 복잡한 리포지토리 작업은 상위 모델이 필요할 수 있음 |
| GLM-5.3 Flash |
스크린샷이나 UI 참조가 포함된 코딩 작업 |
추론 노력과 출력 길이에 따라 비용이 달라짐 |
| DeepSeek V4.1 Flash |
테스트 및 재시도 제한이 있는 코딩 에이전트 |
API 별칭으로 제공되는 체크포인트 확인 필요 |
| Gemini 3.8 Flash |
기존 Gemini 워크플로우 내에서의 코딩 |
직접 제공업체의 프로모션 요금은 플랫폼 견적과 다를 수 있음 |
모델뿐만 아니라 공급업체까지 선택해야 하는 경우, 당사의 개발자를 위한 AI API 플랫폼 비교 문서를 통해 액세스, 결제, 통합 및 프로덕션 제어에 관한 더 폭넓은 질문에 대한 답을 확인하세요.
비용과 코딩 능력을 비교하는 방법
가성비 좋은 LLM 코딩 모델은 토큰 가격이 의미를 가지려면 먼저 해당 작업에 충분한 능력을 갖추어야 합니다. 당사는 코딩 관련 증거를 우선시한 다음, 워크로드 비용, 컨텍스트 계층, 도구 호환성 및 사용 가능한 GPT Proto 모델 페이지를 확인합니다.
다음 결과는 Artificial Analysis에서 가져온 것입니다. Terminal-Bench 4.0은 에이전트 코딩 및 터미널 사용을 평가하며, FrontierCode 2.0은 오픈 소스 리포지토리에서의 소프트웨어 엔지니어링을 평가합니다. 구성에 따라 결과가 달라질 수 있으므로 평가된 설정은 각 모델 옆에 표시됩니다.
| 평가된 모델 |
Terminal-Bench 4.0 |
FrontierCode 2.0 |
| Claude Haiku 5.5 Max |
33% |
35% |
| GPT-6 Luna Max |
13% |
25% |
| GLM-5.3 Flash (목록 기준) |
33% |
18% |
| DeepSeek V4.1 Flash 1017 Max |
34% |
28% |
| Gemini 3.8 Flash High |
20% |
19% |
기본 비교 대상은 Haiku 대 Luna, DeepSeek 대 GLM Flash, 그리고 Haiku 대 Gemini입니다. 이 백분율은 해당 평가를 설명하는 것이며, 귀하의 리포지토리에서 예상되는 성공률을 의미하지 않습니다. 또한 GPT Proto의 지연 시간이나 가동 시간을 보장하지도 않습니다.
아래의 가격 추정치는 결제 산식을 보여주기 위해 토큰 사용량을 일정하게 유지한 것입니다. 실제 모델은 특히 추론이 활성화된 경우 동일한 프롬프트에 대해 서로 다른 토큰 수를 사용할 수 있습니다.
최고의 가성비 코딩 LLM 5선
1. Claude Haiku 5.5: 제한된 코딩 작업용
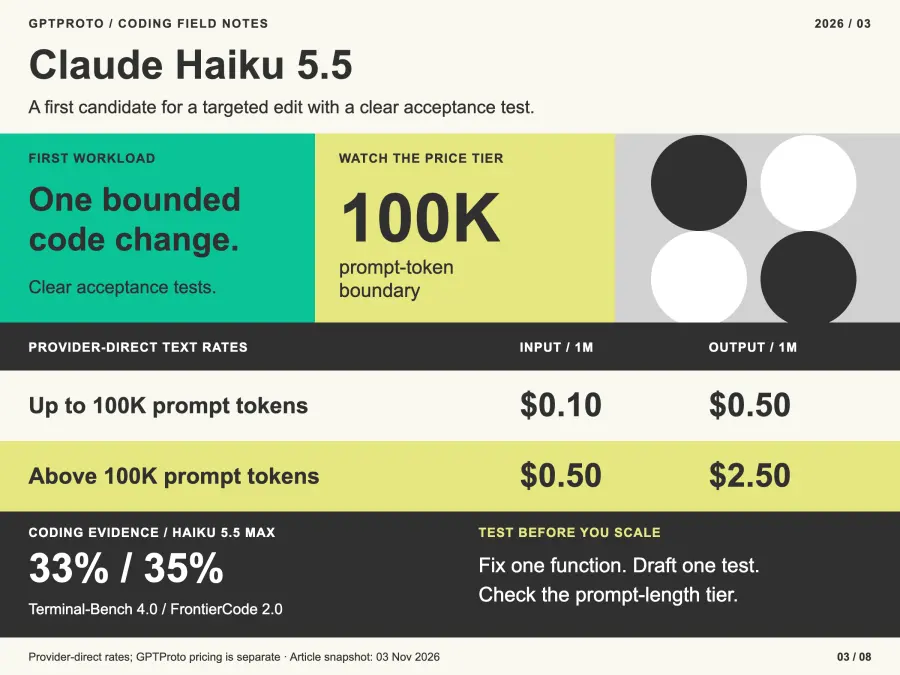
Claude Haiku 5.5는 명확한 승인 테스트가 있고 프롬프트가 100K 토큰 미만인 타겟팅된 수정 작업을 위한 첫 번째 후보입니다. 이 모델의 코딩 결과는 더 큰 Claude 모델에 비용을 지불하기 전에 평가해 볼 가치가 있습니다.
Anthropic의 출시 발표는 Haiku를 Sonnet 및 Opus와 함께 반복적인 작업 및 코딩 하위 작업을 위한 모델로 포지셔닝합니다. 이는 함수 하나 수정하기, 테스트 초안 작성하기, 또는 포함된 오류 조사하기와 같은 실용적인 시작 범위를 제안합니다.
중요한 비용 경계는 프롬프트 길이입니다. 업스트림 입력/출력 요금은 100K 프롬프트 토큰을 초과할 경우 백만 토큰당 $0.10/$0.50에서 $0.50/$2.50으로 상승합니다. 큰 컨텍스트 창이라고 해서 가장 저렴한 계층을 전체 창에서 사용할 수 있는 것은 아닙.
2. GPT-6 Luna: 빈번하고 집중적인 요청용
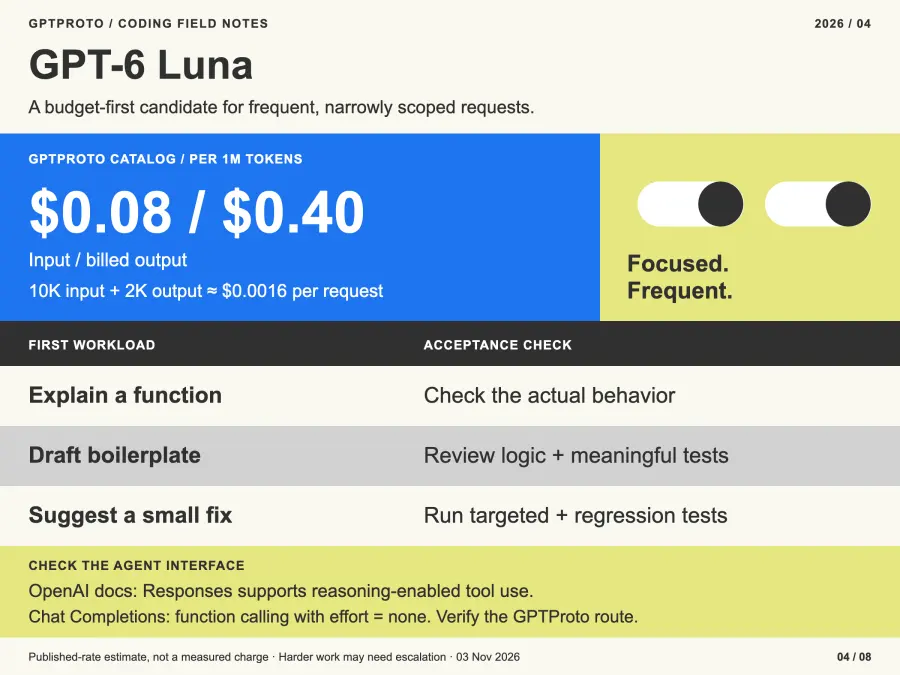
GPT-6 Luna는 반복적이고 제한된 요청(함수 설명, 상용구 초안 작성, 또는 기존 테스트로 판단 가능한 작은 수정 제안)을 위한 예산 우선 후보입니다.
공개된 GPT Proto 카탈로그 요금은 백만 토큰당 입력 $0.08, 출력 $0.40입니다. 공개된 코딩 점수가 Haiku보다 낮으므로, 작업별 평가를 통해 Luna가 더 폭넓은 역할을 수행하도록 해야 합니다.
에이전트를 구축할 때는 통합 표면을 확인하십시오. OpenAI 모델 문서는 응답을 통한 추론 활성화 도구 사용을 명시하고 있으며, Chat Completions는 추론 노력을 '없음'으로 설정하여 함수 호출을 허용합니다. 모델 전환을 단순한 구성 변경으로 취급하기 전에 GPT Proto 경로가 무엇을 노출하는지 확인하십시오.
3. GLM-5.3 Flash: 예산 친화적 시각적 코딩용
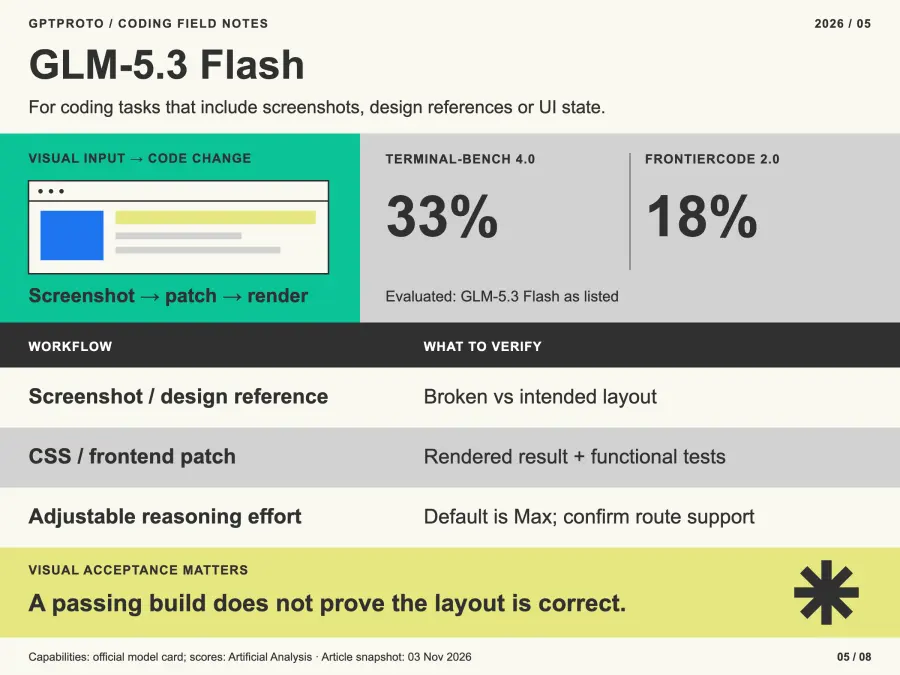
GLM-5.3 Flash는 코딩 작업에 스크린샷, 디자인 참조 또는 렌더링된 인터페이스가 포함될 때 고려해야 할 후보입니다. 예를 들어, 프론트엔드 어시스턴트는 CSS 변경을 제안하기 전에 깨진 레이아웃과 의도된 상태를 비교해야 할 수 있습니다.
공식 GLM-5.3 Flash 모델 카드는 멀티모달 입력, 오픈 가중치 및 조정 가능한 추론 노력을 문서화합니다. 게시된 기본 노력 설정은 최대입니다. 호스팅된 경로가 이를 어떻게 지원하는지 확인한 후에만 다른 설정을 사용하십시오.
이 모델의 두 가지 코딩 점수는 상당히 다릅니다. 이것이 하나의 터미널 벤치마크를 보편적인 코드 편집 순위로 취급하기보다 작업 혼합을 테스트해야 하는 이유입니다. 시각적 수정은 렌더링된 비교도 필요합니다. 컴파일만으로는 레이아웃이 올바른지 확인할 수 없습니다.
4. 테스트 주도 코딩 에이전트를 위한 DeepSeek V4.1 Flash
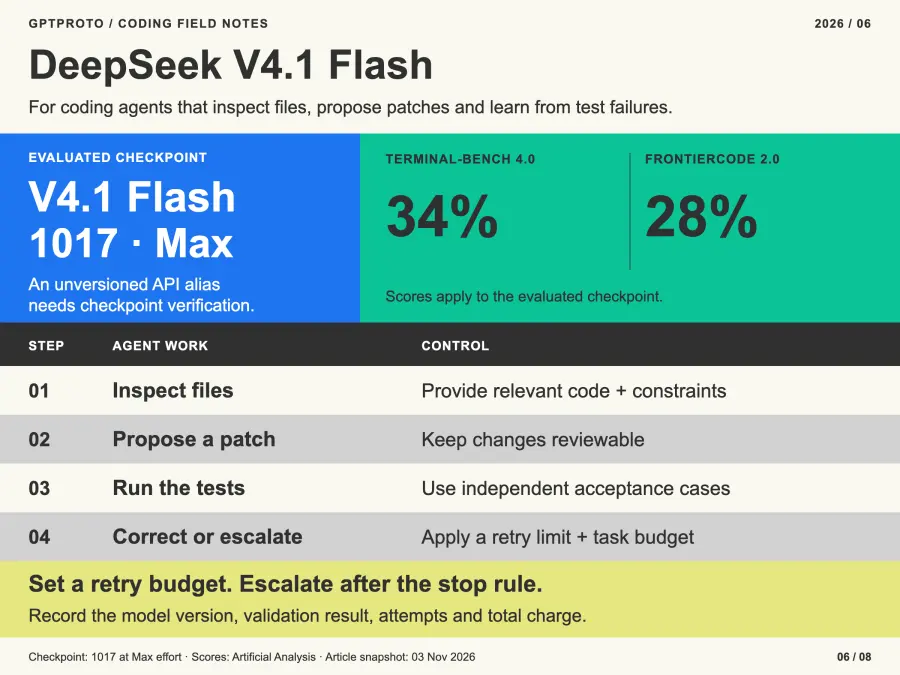
DeepSeek Flash는 파일을 검사하고, 변경 사항을 제안하며, 테스트 실패를 확인하고, 정해진 예산 내에서 다시 시도하는 에이전트를 평가할 때 고려할 가치가 있습니다.
10월 17일 릴리스 발표에서는 코딩 성능, 작업 완료 속도 및 출력 길이의 개선 사항을 설명합니다. 표에 기재된 독립적인 결과는 특히 Max effort(최대 노력) 설정의 V4.1 Flash 1017 버전을 참조합니다. 버전이 지정되지 않은 별칭만으로는 해당 플랫폼이 특정 체크포인트를 제공한다고 보장할 수 없으므로, 가능한 경우 해결된 버전을 기록하십시오.
DeepSeek, GLM, Qwen 및 Kimi에 대한 더 넓은 관점은 코딩을 위한 중국 LLM 비교에서 확인하십시오. 어려운 저장소 변경 작업으로 인해 예산 경로가 소진될 경우를 대비하여 더 강력한 후보 모델을 확보해 두십시오.
5. 기존 Gemini 워크플로우를 위한 Gemini 3.8 Flash
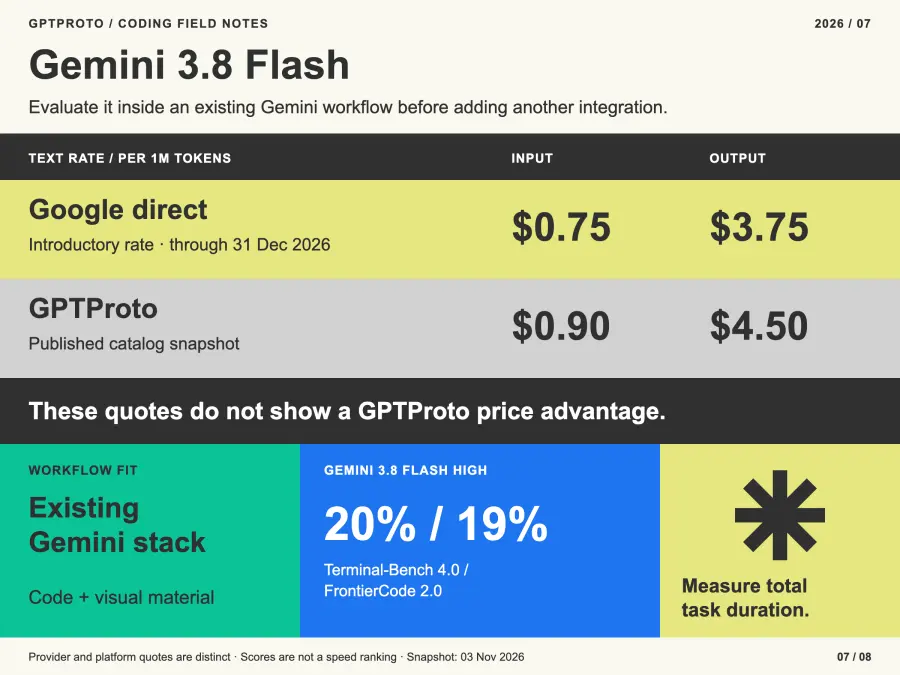
Gemini 3.8 Flash는 애플리케이션에서 이미 Gemini를 사용 중이거나 코드와 시각적 자료를 결합하는 경우 고려할 수 있는 후보입니다. 다른 공급자별 통합을 추가하기 전에 기존 워크플로우에서 먼저 평가해 보십시오.
Google의 모델 업데이트는 조정 가능한 사고 기능과 2026년 12월 31일까지 백만 토큰당 입력 $0.75/출력 $3.75의 도입부 직접 공급자 요금을 명시하고 있습니다. 게시된 GPT Proto 카탈로그 스냅샷은 $0.90/$4.50입니다. 이러한 수치는 GPT Proto가 Google의 현재 프로모션보다 저렴하다는 주장을 뒷받침하지 않습니다.
Gemini는 워크플로우 적합성을 위해 포함하는 것이지, Flash라는 이름 때문에 속도 타이틀을 부여하는 것은 아닙니다. 귀하의 프롬프트에서 사용 가능한 답변까지 걸리는 시간과 총 작업 시간을 측정해 보십시오.
코딩 LLM API 가격 비교
이 표는 GPT Proto 청구 요금이 아닌 명시된 조건 하의 공급자 직접 공개 텍스트 요금을 사용합니다. 소스와 작업량을 명확히 함으로써 비교의 재현성을 보장합니다.
소규모 요청에는 10K 입력 토큰과 2K 청구 대상 출력 토큰이 포함됩니다. 저장소 기준선에는 200K 입력 토큰과 20K 청구 대상 출력 토큰이 포함됩니다. 두 경우 모두 캐시 적중이 없다고 가정하며, 청구 대상 출력에는 해당되는 경우 추론 토큰이 포함되어야 합니다.
| 모델 및 가격 조건 |
100만 토큰당 입력 / 출력 |
소규모 요청 |
저장소 기준선 |
| 최대 100K 프롬프트 토큰의 Haiku 5.5 |
$0.10 / $0.50 |
$0.0020 |
다음 티어 사용 |
| 100K 프롬프트 토큰 초과 시 Haiku 5.5 |
$0.50 / $2.50 |
해당 없음 |
$0.1500 |
| 기본 컨텍스트 티어 내의 GPT-6 Luna |
$0.10 / $0.50 |
$0.0020 |
$0.0300 |
| 공개된 표준 요금의 GLM-5.3 Flash |
$0.15 / $0.50 |
$0.0025 |
$0.0400 |
| 업스트림 피크 요금의 DeepSeek Flash |
$0.30 / $1.20 |
$0.0054 |
$0.0840 |
| 도입부 직접 요금의 Gemini 3.8 Flash |
$0.75 / $3.75 |
$0.0150 |
$0.2250 |
요금 근거는 링크된 모델 문서와 위의 독립적인 비교 자료에서 가져왔습니다. DeepSeek의 릴리스 노트는 비피크 시간대 토큰 요금이 피크 요금의 절반임을 확인해 줍니다. Luna는 272K 입력 토큰을 초과하는 전체 요청에 대해 더 높은 요금을 적용합니다. Gemini의 도입부 요금은 2026년에 종료됩니다. 예산을 책정하기 전에 적용 가능한 경로와 날짜를 확인하십시오.
GPT Proto 액세스의 경우, 링크된 모델 페이지의 실시간 가격 패널을 사용하십시오. 저가 티어에서 Luna는 $0.08/$0.40, Haiku는 $0.09/$0.45인 두 가지 명확한 카탈로그 예시가 있습니다. 동일한 소규모 요청은 각각 $0.0016 및 $0.0018로 추정됩니다. 이는 측정된 청구액이 아닌 공개 요금 계산 결과입니다.
매달 10,000건의 소규모 요청을 수행하는 소규모 애플리케이션의 경우, 업스트림 Luna 또는 저가 티어 Haiku 예시는 재시도 및 기타 비용을 제외하고 총 $20가 됩니다. 이 추정치는 애플리케이션이 다른 양의 컨텍스트를 보내거나 훨씬 더 긴 출력을 생성하는 경우 유용하지 않게 됩니다.
캐싱은 별도의 계산이 필요합니다: 캐시되지 않은 입력, 캐시 읽기, 캐시 쓰기 또는 저장소, 그리고 청구 대상 출력을 합산해야 합니다. 안정적인 저장소 접두사가 도움이 될 수 있지만, 프롬프트를 변경하거나 캐시를 놓치면 절감 효과가 달라집니다.
개발자 Simon Willison의 Haiku 5.5 테스트는 노력 설정에 따라 시간과 비용이 어떻게 달라지는지에 대한 구체적인 예를 제공합니다. 또한 토크나이저 변경 사항에 대해서도 논의합니다. 예산 책정을 위한 교훈은 모든 모델이 동일한 텍스트에 대해 동일한 수의 토큰을 청구한다고 가정하기보다 실제 사용량을 측정하는 것입니다.
어떤 모델이 코딩 작업에 적합할까
| 작업 |
초기 후보군 |
수락 검사 |
| 단일 코드 수정 또는 버그 수정 |
Haiku 5.5 및 Luna |
타겟 테스트 및 기존 회귀 테스트 |
| 단위 테스트 또는 상용구 코드 작성 |
Luna 및 Haiku 5.5 |
어설션 검토 및 의미 있는 실패 사례 확인 |
| 시각적 프론트엔드 수정 |
GLM-5.3 Flash 및 Gemini 3.8 Flash |
렌더링 비교 및 기능 테스트 |
| 다단계 코딩 에이전트 |
DeepSeek Flash 및 Haiku 5.5 |
완료된 작업, 유효한 도구 호출, 재시도 횟수 및 총 비용 |
이들은 평가를 위한 시작점입니다. 모델의 잘못된 가정을 단순히 반복하는 생성된 테스트는 통과할 수 있지만, 기능은 여전히 잘못된 상태일 수 있습니다. 독립적인 수락 사례를 유지하고 테스트 자체의 변경 사항을 검사하세요.
문서 검색, 요청 분류 또는 지원 작업을 수행하는 에이전트의 경우, AI 에이전트를 위한 저렴한 LLM API 가이드에서 더 광범위한 워크로드 조합을 다룹니다.
프리미엄 코딩 모델이 가치 있는 경우
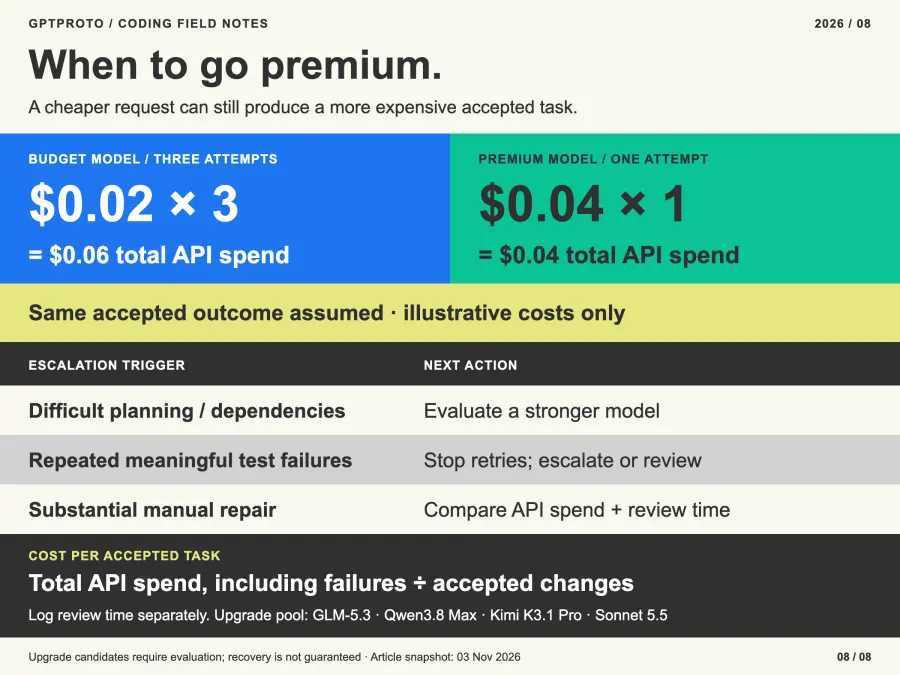
작업에 어려운 계획이 필요하거나, 의미 있는 테스트에서 반복적으로 실패하거나, 상당한 수동 복구가 필요한 경우 상위 모델로 전환하세요. GLM-5.3, Qwen3.8 Max, Kimi K3.1 Pro, 그리고 Claude Sonnet 5.5는 해당 작업을 위한 별도의 평가 풀을 구성할 수 있습니다. 이들의 포함은 조사해 볼 만한 업그레이드 경로일 뿐, 실패한 저예산 모델 작업을 항상 복구할 수 있다는 보장은 아닙니다.
수락된 작업당 비용을 사용하세요: 평가 전체에 걸친 총 API 지출을 수락된 변경 횟수로 나눈 값입니다. 실패한 시도에 대한 지출도 포함하세요. 낮은 API 비용 때문에 값비싼 개발자 수정 작업이 가려지지 않도록 검토 시간을 별도로 기록하세요.
예를 들어, 0.02달러짜리 시도 3번은 총 0.06달러가 듭니다. 동일한 작업을 즉시 완료하는 0.04달러짜리 시도가 전체적으로는 더 저렴할 수 있습니다. 측정된 성공률에 따라 이러한 트레이드오프가 유효한지 결정하세요.
끝없는 재시도 없이 저예산 모델을 사용하는 방법
첫 번째 요청 전에 수락 검사 및 중단 규칙을 설정하세요. 실용적인 초기 정책은 1회 초기 시도, 테스트 실패를 활용한 1회 수정, 그 후 상위 모델로 전환하거나 사람이 검토하는 것입니다. 관찰된 결과와 작업 예산에 따라 이 정책을 조정하세요.
애플리케이션은 모델 및 체크포인트, 추론 설정, 토큰 사용량, 경과 시간, 검증 결과 및 총 비용을 기록해야 합니다. 모델이 패치를 제안하면 러너가 테스트를 실행하고, 라우팅 로직이 다음 단계를 결정합니다.
다중 모델 API는 액세스 및 청구를 간소화합니다. 테스트 통과, 예산 인식 라우팅 및 자동 전환을 위해서는 검증된 플랫폼 기능이나 애플리케이션 로직이 여전히 필요합니다. 개발자를 위한 AI 게이트웨이 가이드에서 다양한 액세스 및 제어 계층을 비교해 보세요.
GPT Proto를 통해 저렴한 코딩 모델 사용해 보기
후보 모델 페이지를 열고 이 모델 사용해 보기를 선택한 다음, 현재 퀵 스타트 가이드와 가격을 검토하세요. API 키와 잔액을 준비합니다. 패널에서 AI용 마크다운 복사를 제공하는 경우, 해당 가이드를 작업 및 수락 기준과 함께 코딩 어시스턴트에게 전달하세요. 실제 키는 로컬 환경이나 서버 보안 저장소에 보관하세요.
재현 가능한 첫 번째 연습으로 다음 페이지네이션 함수를 수정해 보세요. 페이지는 1부터 시작하며, page와 per_page는 정수여야 합니다. 1보다 작은 값이 입력되면 ValueError를 발생시켜야 하며, 입력된 리스트는 변경되지 않아야 합니다.
다음 내용을 새 작업 폴더에 request_patch.py로 저장하세요. 이 코드는 파이썬 표준 라이브러리를 사용하여 후보 함수를 요청하고, 구문을 확인한 뒤 검토를 위해 저장합니다. 반환된 코드를 직접 실행하지는 않습니다.
import ast
import json
import os
import time
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.request import Request, urlopen

key = os.environ.get("GPTPROTO_API_KEY")
if not key:
    raise SystemExit("환경 변수에 GPTPROTO_API_KEY를 설정하세요.")

source = """def paginate(items, page, per_page):
    start = page * per_page
    return items[start:start + per_page]
"""
task = (
    "Fix paginate. Pages are one-based. page and per_page are "
    "integers; raise ValueError if either is below 1. Return an "
    "empty list beyond the last page. Do not mutate items. Keep "
    "the signature. Return only the function, without Markdown "
    "or explanations.\n\n" + source
)
payload = {
    "model": os.environ.get("GPTPROTO_MODEL", "gpt-6-luna"),
    "messages": [{"role": "user", "content": task}],
}
request = Request(
    "https://gptproto.com/v1/chat/completions",
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Authorization": f"Bearer {key}",
        "Content-Type": "application/json",
    },
    method="POST",
)
started = time.perf_counter()
try:
    with urlopen(request, timeout=60) as response:
        result = json.load(response)
except HTTPError as exc:
    raise SystemExit(f"API가 HTTP {exc.code} 오류를 반환했습니다.") from exc
except (URLError, TimeoutError) as exc:
    raise SystemExit("요청 실패 또는 시간 초과.") from exc

try:
    code = result["choices"][0]["message"]["content"]
except (KeyError, IndexError, TypeError) as exc:
    raise SystemExit("API 응답에 후보 텍스트가 없습니다.") from exc
if not isinstance(code, str) or not code.strip():
    raise SystemExit("응답에 파이썬 코드가 포함되어 있지 않습니다.")
code = code.strip()
try:
    ast.parse(code)
except SyntaxError as exc:
    raise SystemExit("응답을 검토하세요. 올바른 파이썬 코드가 아닙니다.") from exc

Path("candidate.py").write_text(code + "\n", encoding="utf-8")
print("candidate.py가 저장되었습니다. 테스트를 실행하기 전에 검토하세요.")
print("소요 시간(초):", round(time.perf_counter() - started, 2))
print("사용량:", json.dumps(result.get("usage", {})))
다음 수락 테스트를 test_candidate.py로 저장하세요:
import unittest
from candidate import paginate


class PaginationTests(unittest.TestCase):
    def test_pages(self):
        items = [0, 1, 2, 3, 4]
        self.assertEqual(paginate(items, 1, 2), [0, 1])
        self.assertEqual(paginate(items, 2, 2), [2, 3])
        self.assertEqual(paginate(items, 3, 2), [4])
        self.assertEqual(paginate(items, 4, 2), [])
        self.assertEqual(items, [0, 1, 2, 3, 4])

    def test_empty_input(self):
        self.assertEqual(paginate([], 1, 2), [])

    def test_invalid_values(self):
        for page, per_page in [(0, 2), (-1, 2), (1, 0), (1, -1)]:
            with self.subTest(page=page, per_page=per_page):
                with self.assertRaises(ValueError):
                    paginate([0, 1], page, per_page)


if __name__ == "__main__":
    unittest.main()
환경 키가 구성되면 python request_patch.py를 실행하세요. candidate.py를 검토한 다음 python -m unittest -v test_candidate.py를 실행합니다. 구문 검사는 Python이 출력을 구문 분석할 수 있는지 여부만 확인하며, 테스트는 명시된 동작을 평가합니다. 이 작은 연습은 리포지토리 규모의 벤치마크가 아닙니다.
GPTPROTO_MODEL를 통해 다른 문서화된 모델 ID로 반복하세요. 실패와 성공 사례를 모두 기록하고, 반환된 사용량과 적용 가능한 요금을 사용하여 비용을 비교하세요. 타임아웃이나 실패한 시도도 평가 기록에 포함해야 합니다.
하나의 좁은 작업을 선택하고, 해당 작업의 수락 검사를 고정한 상태에서 두 후보를 비교하세요. Claude Haiku 5.5 API 페이지 또는 GPT-6 Luna API 페이지를 열어 현재 가격을 검토하고 첫 번째 코딩 요청을 시작하세요.