如果您今天正在 GPT 6.1 Terra 與 Sonnet 5.5 之間做選擇,以下是我在進行基準測試前使用的簡易決策準則:
若您的工作流程涉及高容量螢幕截圖檢查、表單與發票自動化、UI 版面除錯,或是受限的編碼任務,且您更看重 $0.80/$4.00 的 Token 費率與快上 3 倍的任務執行速度,而非頂尖的自主重構深度,且單次請求輸入量在 272K Token 以內,請選擇 GPT-6.1 Terra。
若您的代理程式需要執行多檔案儲存庫遷移、深度終端除錯(其中編輯錯誤的代價高於 Token 費用),或是單次提示詞介於 300K 到 900K Token 之間(此時 OpenAI 的長文本附加費會抵銷 Terra 的輸入價格優勢),請繼續使用 Claude Sonnet 5.5。
在決定採用哪種方案之前,您可以查看即時目錄費率,或透過 GPT Proto 模型比較中心 運行您每月的 Token 使用量。以下所有內容均為基於文件與基準測試的比較,並於 2026 年 11 月 5 日完成驗證;廠商提供的基準測試與 Artificial Analysis 的獨立測量結果及早期開發者回饋已分開標註。
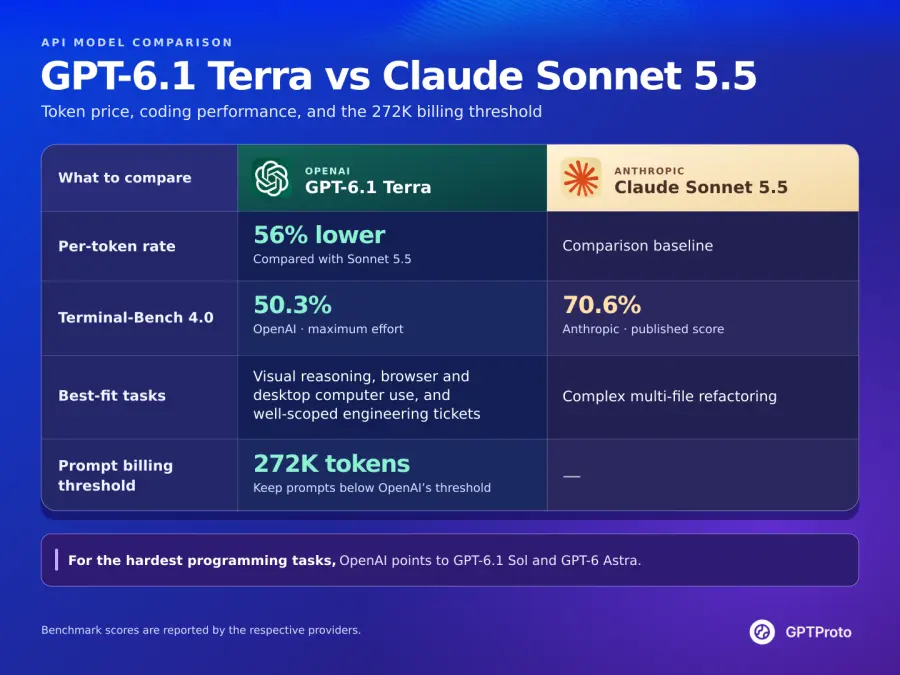
GPT-6.1 Terra 與 Claude Sonnet 5.5 快速比較
開發者在搜尋 ChatGPT 6.1 Terra 與 Sonnet 5.5 或 Anthropic Claude Sonnet 5.5 與 GPT 6.1 Terra 的比較時,經常會遇到相互矛盾的規格表,這是因為兩家供應商在推理控制、工具端點和長上下文附加費用的結構上有所不同。下表將這兩款模型與 OpenAI 官方的 gpt-6.1-terra 文件、Anthropic 的 Claude Sonnet 5.5 概覽以及即時的 GPT Proto 目錄費率進行了對齊。
| 規格 |
GPT-6.1 Terra (gpt-6.1-terra) |
Claude Sonnet 5.5 (claude-sonnet-5-5) |
| 供應商 |
OpenAI |
Anthropic |
| 發布日期 |
2026 年 10 月 26 日 |
2026 年 9 月 28 日 |
| 官方標準輸入 / 輸出(每 100 萬 token) |
$1.00 / $5.00 |
$2.00 / $10.00 |
| GPT Proto 輸入 / 輸出(每 100 萬 token) |
$0.80 / $4.00(較官方便宜 20%) |
$1.80 / $9.00(較官方便宜 10%) |
| 官方快取輸入讀取(每 100 萬 token) |
$0.05(基礎輸入的 5%) |
$0.10(2026 年 10 月 7 日從 $0.20 下調) |
| 官方快取寫入(每 100 萬 token) |
$1.25 (30 分鐘 TTL) / $2.50 (12 小時 TTL) |
$2.50 (5 分鐘 TTL) |
| GPT Proto 快取讀取 / 寫入(每 100 萬 token) |
$0.04 / $1.00 |
$0.09 / $2.25(請查閱即時模型頁面) |
| 上下文視窗 |
1,050,000 tokens |
1,000,000 tokens |
| 長上下文定價規則 |
超過 272K 輸入的請求將按 2 倍輸入/快取及 1.5 倍輸出計費 |
整個 100 萬上下文視窗採用統一費率 |
| 最大輸出 token |
128,000 tokens |
128,000 tokens |
| 輸入 / 輸出模態 |
文字、圖像、文件輸入 → 文字輸出 |
文字、圖像、文件輸入 → 文字輸出 |
| 知識截止日期 |
2026 年 6 月 1 日 |
2026 年初至年中(保留 Sonnet 5 分詞器) |
| 推理 / 努力程度控制 |
none、low、medium(預設)、high、xhigh、max |
預設開啟自適應思考;medium、high(API 預設)、max、between_tools |
| 工具呼叫所需的端點 |
/v1/responses(OpenAI 文件要求) |
/v1/messages(原生)或相容 OpenAI 的 /v1/chat/completions |
| 用戶端與 IDE 支援 |
ChatGPT Work 與 Codex(非一般 Chat)、GitHub Copilot、Claude Code(透過 API) |
Claude.ai、Claude Code、GitHub Copilot、Cursor |
| AA 智慧指數 (v4.3.2) |
41 (medium) / 48 (max) |
56 (max,預設備援) |
| AA 平均評估任務成本 |
$0.10 (`medium`) / $0.40 (max) |
$5.46 (max,預設備援) |
| Terminal-Bench 4.0(供應商報告) |
50.3% (max 努力程度) |
70.6% |
在規劃應用程式預算時,該表中的三行數據至關重要。首先,在低於 272K token 的標準請求中,GPT-6.1 Terra 在 GPT Proto 上的輸入和輸出成本均比官方便宜 56%,因此長篇完成任務不會改變成本排名。其次,Sonnet 5.5 在 Terminal-Bench 4.0 上領先 20.3 個百分點,這與兩款模型在無引導儲存庫編輯中的表現密切相關。第三,與 GPT-6.1 Sol 不同,GPT-6.1 Terra 恢復了對 reasoning.effort: "none" 的支援,讓 OpenAI 開發者再次擁有了真正的非推理快速路徑。
定價與成本分析:哪款模型費用較高,哪款更具成本效益?
當開發者搜尋「GPT 6.1 Terra 與 Sonnet 5.5 哪個比較貴」或「哪個更具成本效益」時,他們通常是在試圖調和兩個不同的數字:定價頁面上每百萬 token 的費率,以及完成一項代理任務的實際美元成本。這兩個比例並不相同。
在單一 token 層級上,Claude Sonnet 5.5 的定價明顯較高。Anthropic 的官方定價為每百萬輸入 token 2.00 美元,每百萬輸出 token 10.00 美元,是 OpenAI 為 Terra 設定的 1.00 美元/5.00 美元定價的兩倍。由於 GPT Proto 對 GPT-6.1 Terra 提供 20% 的折扣(輸入 0.80 美元 / 輸出 4.00 美元),並對 Claude Sonnet 5.5 提供 10% 的折扣(輸入 1.80 美元 / 輸出 9.00 美元),因此在平台上 Sonnet 5.5 的單位 token 成本是 Terra 的 2.25 倍。兩家供應商目前對快取輸入讀取的定價均為基礎輸入價格的 5%(Terra 官方為 0.05 美元,而 Sonnet 5.5 在 Anthropic 於 2026 年 10 月將 Sonnet 的快取讀取價格減半後為 0.10 美元),且兩者對標準快取寫入的收費均為基礎輸入價格的 1.25 倍(官方分別為 1.25 美元與 2.50 美元)。請注意,如果您從未第二次讀取該前綴,那麼寫入快取的單次使用長提示詞實際上會對任一模型增加 25% 的附加費用。
在單一任務層級上,差距變得更加懸殊。在 Artificial Analysis 的 Intelligence Index v4.3.2(發布於 2026 年 10 月 26-27 日)中,經測試的 Claude Sonnet 5.5 配置(max 努力程度搭配預設回退機制) 記錄的加權平均成本為每項評估任務 5.46 美元。在同一評估套件中,[GPT-6.1 Terra 在 `max` 努力程度下](https://artificialanalysis.ai/models/gpt-6-1-terra) 平均每項任務成本為 0.40 美元,而 GPT-6.1 Terra 在 medium 努力程度下 平均每項任務僅需 0.10 美元。這在 max 努力程度下有 13.6 倍的差異,而當比較 Sonnet 的最高設定與 Terra 的預設 medium 設定時,差異高達 54.6 倍。
為什麼 2 倍的單位 token 差異會變成 13 倍到 54 倍的帳單差距?推理模型會將思考過程產生的 token 計入輸出 token。當 Sonnet 5.5 在開放式基準測試中以高或最高努力程度運行時,它會產生長篇推理鏈,費用為每百萬 token 10.00 美元(在 GPT Proto 上為 9.00 美元)。Terra 的公告也指出,在 Agents' Last Exam 的最高努力程度測試中,Terra 使用的 token 數量不到 Claude Opus 5.5 的三分之一。更重要的是 Artificial Analysis 的帕累托前沿(Pareto-frontier)發現:對於 GPT-6.1 Terra 而言,low 與 medium 努力程度設定在智慧與成本之間達到了帕累托最優。將 Terra 調至 max 會使其分數從 41 提升至 48,這與 GPT-6.1 Sol 在 medium 努力程度下的分數持平——但 Sol 的 medium 設定每項任務成本僅 0.21 美元,而 Terra 的 `max` 設定則需 0.40 美元。簡而言之,如果您想在 Terra 上獲得最具成本效益的設定,請保持在 low 或 medium;如果任務難度高到需要 max 努力程度,您應該已經在測試 Sol 或 Sonnet 5.5 了。
實際運作成本計算:兩個真實生產場景
為了了解更便宜的 Token 費率在何處真正發揮效益,以及在何處適得其反,讓我們以 GPT Proto 的即時目錄費率(Terra 為 $0.80/$4.00;Sonnet 5.5 為 $1.80/$9.00)進行精確計算,假設為 272K Token 以下的未快取請求。
場景 A 是一個包含 20 個步驟的視覺化 QA 與表單提取代理迴圈。每個步驟發送一張螢幕截圖與 DOM 片段,總計 15,000 個輸入 Token,並生成 1,500 個輸出 Token(包含 中等 推理 Token)。在 20 個步驟中,單個工作流程消耗 300,000 個輸入 Token(0.3M)與 30,000 個輸出 Token(0.03M):
若每月執行 10,000 個工作流程,Terra 的成本為 $3,600,而 Sonnet 為 $8,100,每月節省 $4,500。即使 Terra 在 20% 的執行中驗證失敗,且必須從頭重試這 2,000 個工作流程(增加 $720),您的總帳單為 $4,320,與零重試的 Sonnet 執行相比,每月仍節省 $3,780。
場景 B 是活躍 Pull Request 中的多檔案後端重構。假設每次嘗試讀取 80,000 個輸入 Token 並輸出 10,000 個輸出 Token。在 Sonnet 5.5 上執行一次的成本為 (0.08 * $1.80) + (0.01 * $9.00) = $0.234。在 Terra 上執行一次的成本為 (0.08 * $0.80) + (0.01 * $4.00) = $0.104。您在 API 呼叫上節省了 13 美分。問題在於,如果 Terra 遺漏了跨模組的型別依賴(這與其 50.3% 對 70.6% 的 Terminal-Bench 差距相符),並迫使您進行三次重試,加上資深工程師 12 分鐘的時間(以每小時 $90 計算,即 $18.00 的人力成本),那 13 美分的 Token 節省反而讓您的團隊付出了 $18.18 的代價。總結一句話:Terra 在可重複、機器可驗證的迴圈中具有壓倒性優勢,而當失敗的編輯消耗人工審核時間時,Sonnet 5.5 的高額費用便顯得物有所值。
視窗上下文(1.05M 對比 1M):為何超過 272K 會導致費用翻倍
從紙面上看,GPT 6.1 Terra 與 Sonnet 5.5 視窗上下文的比較看起來勢均力敵,OpenAI 略佔優勢:Terra 接受 1,050,000 個輸入 Token 並輸出最多 128,000 個 Token,而 Claude Sonnet 5.5 接受 1,000,000 個輸入 Token 並輸出最多 128,000 個 Token。大多數比較表到此為止。
然而,如果您閱讀 OpenAI 的 gpt-6.1-terra 模型文件,會發現存在一個 272,000 個輸入 Token 的計費分界線,這徹底改變了長上下文的經濟效益。每當 GPT-6.1 Terra 的提示詞超過 272K 輸入 Token 時,OpenAI 會對整個請求(而不僅僅是超過 272K 的部分)收取 2 倍的輸入和快取費率,以及 1.5 倍的輸出費率。
以下是當您的提示詞從 272,000 個 Token 增加到 272,001 個 Token 時,官方每百萬 Token 定價會發生的變化:
| 上下文區間 |
GPT-6.1 Terra(官方費率) |
Claude Sonnet 5.5(官方費率) |
輸入價格關係 |
| 標準提示詞(≤272K 輸入 Token) |
$1.00 輸入 / $5.00 輸出 / $0.05 快取讀取 |
$2.00 輸入 / $10.00 輸出 / $0.10 快取讀取 |
Terra 在輸入和輸出上便宜 50% |
| 長上下文提示詞(>272K 至 1M+ 輸入 Token) |
$2.00 輸入 / $7.50 輸出 / $0.10 快取讀取 |
$2.00 輸入 / $10.00 輸出 / $0.10 快取讀取 |
輸入和快取讀取費率相同($2.00 / $0.10) |
與 Anthropic 較小的 Haiku 5.5 模型(在超過 100K Token 時會收取 5 倍附加費)不同,Claude Sonnet 5.5 維持統一定價,涵蓋其整個 1,000,000 個 Token 的上下文視窗。
以官方定價計算一次 400,000 個 Token 的儲存庫審計(產生 10,000 個輸出 Token)的費用:
一旦您的提示詞超過 272K Token,Terra 的 50% 輸入折扣就會完全消失,在 400K Token 的呼叫中僅剩下 $0.025 的總差額。我的建議很簡單:永遠不要向 GPT-6.1 Terra 發送超過 272K Token 的單體提示詞並期望獲得半價經濟效益。要麼將您的上下文分塊/檢索至 272K Token 以下,讓 Terra 保持在 $1.00(GPT Proto 為 $0.80)的區間內;要麼將 300K–900K 的儲存庫轉儲直接路由至 Claude Sonnet 5.5,在那裡您支付相同的官方輸入費率,並獲得更強大的長視角程式碼理解能力。(在透過 GPT Proto 在生產環境中執行 >272K 的提示詞之前,請與平台支援確認上游 272K 層級調整如何反映在您的帳戶餘額中。)
基準測試與社群回饋:程式編寫、前端開發與代理工作
總體綜合評分往往掩蓋了各個模型真正的優勢所在。在 Artificial Analysis Intelligence Index v4.3.2 上,Claude Sonnet 5.5 (max,預設回退) 得分為 56,GPT-6.1 Sol (max) 得分為 52,而 GPT-6.1 Terra 在 max 運算強度下得分為 48,在 medium 運算強度下得分為 41。(根據 GPT Proto 比較卡片上顯示的 2026 年 11 月 3 日索引快照,Sonnet 5.5 記錄為 54.2,而 Terra max 記錄為 51——差距縮小至 3.2 分,但仍由 Sonnet 領先。)為了針對程式編寫、前端 UI 或代理迴圈做出實際的路由決策,我們必須將這些總體數據按任務類型進行拆解,並與開發者在實際應用中的回饋進行對比。
1. 後端與終端編碼 (GPT 6.1 Terra 與 Sonnet 5.5 的程式碼能力對比)
對於純粹的命令列軟體工程而言,Anthropic 仍保有明顯優勢。在 Terminal-Bench 4.0 測試中,Anthropic 報告 Claude Sonnet 5.5 的得分為 70.6%(高於 Sonnet 5 的 10.3%),而 OpenAI 報告 GPT-6.1 Terra 在 max(最大)努力程度下的得分為 50.3%(高於 GPT-5.6 Terra 的 21.5%)。在 Artificial Analysis 新發布的 Coding Agent Index v2.0 中,Terra 得分為 48 分,領先輕量級 GPT-6 Luna(31 分)17 分,但落後 GPT-6.1 Sol(54 分)6 分。Artificial Analysis 也指出,針對編碼代理(coding agents)而言,Terra 的 low(低)與 xhigh(超高)努力程度設定處於成本效益前沿,而其他努力程度設定則相對落後。
早期的實際測試指出了這兩款模型之間的明確界線:
給後端開發者的建議:如果工單範圍明確(例如編寫 C# 服務方法、新增單元測試或修復獨立的 CLI 腳本),Terra 在 low(低)或 medium(中)努力程度下,能以不到一半的 Token 價格快速完成任務。如果工單需要跨十個檔案追蹤狀態,且額外的重試迴圈會破壞工作流程,那麼 Sonnet 5.5 的 70.6% 終端能力則值得較高的費用。在涉及科學運算時,OpenAI 也報告稱,在 Terminal-Bench-Science 0.1 測試中(例如編寫程式碼來追蹤縮時攝影中的細胞分裂),Terra 在 max(最大)努力程度下,其實際表現超越了 GPT-6.1 Sol,且與 Claude Opus 5.5 的差距不到五分,而成本卻不到其估計成本的五分之一。
2. GPT-6.1 Terra 與 Sonnet 5.5 在前端編碼上的對決
搜尋 GPT 6.1 Terra 與 Sonnet 5.5 在前端編碼上的對決 值得一個專屬的答案,因為前端工程本質上是兩項結合在一起的工作:視覺/DOM 佈局工作與狀態/架構邏輯。
當 OpenAI 介紹 GPT-6.1 Terra 在 Terminal-Bench 4.0 上獲得 50.3% 的分數時,其公告中強調的唯一具體編碼範例是一個前端錯誤:「修復網頁載入時佈局偏移的問題」(累積佈局偏移,即 CLS)。同時,OpenAI 報告稱,在 MMMU-Pro(一個針對圖表、螢幕截圖和密集佈局進行視覺推理的基準測試)上,GPT-6.1 Terra 在所有努力程度下均優於 GPT-5.6 Terra,並且以極低的價格幾乎追平了前沿模型 GPT-6 Astra 和 GPT-6.1 Sol。在 OpenAI 開發者社群論壇的發布日討論串中,開發者們的第一反應之一將 Terra 總結為 「性價比極高,尤其是在視覺理解方面。編碼能力也不錯。」
這種分工為前端團隊提供了明確的職責劃分:
將 GPT-6.1 Terra 用於視覺和 UI 層的前端工作:將 Figma 螢幕截圖或線框圖轉換為初始的 Tailwind/HTML 標記,將渲染後的 Playwright 螢幕截圖與設計規範進行比較以發現重疊的 DOM 節點或行動裝置斷點回歸,以及診斷 CSS 佈局偏移。由於 Terra 原生處理圖像,在視覺動作基準測試上的執行速度比 GPT-6.1 Sol 和 Astra 快 3 倍以上,且在 GPT Proto 上的成本僅為 $0.80/$4.00,您的 CI 管線完全有能力在每次提交時執行視覺回歸檢查。
將 Claude Sonnet 5.5 用於邏輯密集型的前端架構:重構複雜的 React/Next.js 伺服器動作狀態樹、解決複雜的 TypeScript 泛型約束,或在不破壞水合作用(hydration)的情況下遷移舊版 Redux 儲存庫。當沒有螢幕截圖可供檢查,且難點純粹在於多檔案狀態的一致性時,Sonnet 5.5 依然是更穩妥的選擇。
3. 代理工作、電腦操作與事實準確性 (針對代理工作)
如果您對 GPT 6.1 Terra 與 Sonnet 5.5 針對代理工作 的定義集中在 GUI 自動化、文件解析和後台電腦操作上,那麼 GPT-6.1 Terra 可以說是 OpenAI 在 2026 年最具價值的發布。
在 OpenAI 針對 Agents' Last Exam v1 的供應商報告評估(該測試涵蓋多步驟專業工作流程,例如將建築圖紙轉換為 3D 模型,或記錄動畫電影中逐鏡頭的時間碼)中,GPT-6.1 Terra 在 中等 努力程度下的得分比 GPT-5.6 Terra 高出 15 個百分點,成本卻僅為其約三分之一,且以十分之一的 Token 價格與旗艦級 GPT-6 Astra 持平。在 最大 努力程度下,OpenAI 報告稱 Terra 的 Token 效率是 Claude Opus 5.5 的 3 倍以上,且每個 Token 的價格僅為其四分之一,這使得每個任務的成本降低了約 9 倍,同時完成工作流程的速度比 GPT-6 Astra 和 GPT-6.1 Sol 快 3 倍以上。
在 OSWorld 2.1(桌面應用程式控制)方面,OpenAI 報告稱,Terra 在 中等 努力程度下的表現,以極低的單任務成本擊敗了 GPT-5.6 Terra 的最佳得分。為了保持平衡,Anthropic 公佈的 Claude Sonnet 5.5 在 OSWorld 2.1(離線)中的得分高達 83.9%(披露於 Anthropic 2026 年 10 月的 Haiku 5.5 基準測試表)。這兩款模型都是頂級的電腦操作引擎;不同之處在於,螢幕抓取代理會在每次點擊時發送新的螢幕截圖,這會迅速消耗輸入 Token,而 Terra 每百萬 GPT Proto 輸入 Token 僅需 0.80 美元的費率,使其在大規模應用下更容易維持。
對於自主代理而言,同樣重要的是知道模型在何時 不 了解某件事。在 Artificial Analysis 獨立的 AA-Omniscience 基準測試 中,GPT-6.1 Terra 的幻覺率(模型在缺乏知識時進行猜測的頻率)下降了 50 個百分點——從 GPT-5.6 Terra 的 88% 降至 38%——同時整體準確度提升了 2 個點。該獨立測量結果支持了 OpenAI 的內部事實準確性評估(詳見 GPT-6.1 Terra 系統卡),其中在困難提示詞下的低努力程度事實錯誤率從 53.6% 降至 16.7%(在 最大 努力程度下更降至 4.3%)。較低的幻覺率意味著下游的錯誤工具調用將會減少。
開發者體驗與 API 陷阱 (GPT 6.1 Terra 與 Sonnet 5.5 開發者對比)
在生產環境中切換 gpt-6.1-terra 與 claude-sonnet-5-5 絕非單行字串替換那麼簡單。如果您正在評估 GPT 6.1 Terra 與 Sonnet 5.5 開發者 的人體工學,四個 API 層級的限制將決定您的整合工作。
首先,GPT-6.1 Terra 支援 reasoning.effort: "none",而 GPT-6.1 Sol 則不支援。 當 OpenAI 於 2026 年 9 月 29 日推出 GPT-6.1 Sol 時,它移除了 none 與 minimal 推理層級,強制所有請求使用 low 或更高級別,這導致 temperature 與 top_p 全面失效。根據 OpenAI 官方的 gpt-6.1-terra 提示詞與遷移指南,Terra 支援完整範圍:none、low、medium(預設)、high、xhigh 以及 max。如果您設定 reasoning_effort: "none",Terra 將在不產生隱藏推理 Token 的情況下執行,並允許標準採樣參數。然而,一旦您使用 low、medium、high、xhigh 或 max,您必須從請求負載中移除 temperature、top_p、top_logprobs 與 logprobs,否則 API 將會以 HTTP 400 錯誤拒絕該呼叫。
其次,OpenAI 要求在 GPT-6.1 Terra 上使用 Responses API (/v1/responses) 進行工具呼叫。 雖然純文字與圖片提示詞可在 /v1/chat/completions 上運作,但 OpenAI 的模型文件 明確指出工具呼叫需要 /v1/responses。一旦使用 Responses API,Terra 支援 OpenAI 九種原生內建工具中的所有功能——網頁搜尋、檔案搜尋、圖片生成、程式碼解釋器、託管 Shell、apply_patch、技能、電腦使用、MCP 與工具搜尋——並在自訂函式工具上支援 async: true,讓模型在執行緩慢的背景工具時仍能持續推理。此外,Terra 支援在對話中途傳送 configuration_update 輸入項目,以便在困難的轉折點提高或降低 reasoning.effort,而無需重寫提示詞前綴或使您的 30 分鐘提示詞快取 (prompt_cache_options.ttl: "30m") 失效。
第三,Claude Sonnet 5.5 有其專屬的嚴格 400 錯誤陷阱。 根據 Anthropic 的 Sonnet 5.5 遷移指南,Sonnet 5.5 預設使用自適應思考(API 預設為 high 努力程度,Claude Code 中則為 medium,如 Anthropic 的 Claude Code 設定文件 中所述)。如果您的舊版 Claude 整合傳送了 thinking: {"type": "disabled"},您必須將其更新為 between_tools 以獲得最低的思考設定。更重要的是,當啟用自適應思考時,Sonnet 5.5 會拒絕強制工具選擇(tool_choice: {"type": "any"} 或強制指定工具),並回傳 400 錯誤;您必須使用 auto 並在提示詞中引導工具選擇。您還需要透過 type 來解析回應內容區塊,而不是假設 content[0] 就是文字,因為第一個區塊通常是 thinking 區塊。
第四,IDE 和 CLI 整合已為兩者完成串接。 請注意,在消費者訂閱方案中,OpenAI 的發布說明 確認 GPT-6.1 Terra 已推送到 ChatGPT Work 和 Codex(適用於 Plus、Pro、Business、Enterprise 和 Edu 方案),而非標準的 ChatGPT 聊天介面,且它不支援阿拉伯聯合大公國(UAE)的推論駐留(儘管快速模式支援歐盟數據駐留)。對於在本地終端工作的開發者,這兩個模型皆可透過 GPT Proto 連接到 Claude Code 和 OpenAI Codex。在 GPT-6.1 Terra 模型頁面 上,點擊 Try this model 會開啟一個快速入門面板,您可以在 Let AI finish the integration 下選擇 Claude Code 或 ChatGPT (Codex),或者點擊 Copy Markdown for AI 讓您的程式設計助手自動設定環境變數。
建構應用程式:如何使用單一 API 金鑰路由兩種模型
當團隊詢問關於 GPT 6.1 Terra 與 Sonnet 5.5 在建構應用程式時的選擇時,最佳架構幾乎從來不是將 100% 的流量都交給單一模型。由於這兩種模型在 GPT Proto 上都共用同一個預付餘額,您可以按步驟而非按供應商進行路由:將高頻率的視覺檢查、螢幕截圖分類以及受限的 UI 修復發送到 gpt-6.1-terra(價格為 $0.80/$4.00),並將多檔案程式碼合成任務升級至 claude-sonnet-5-5(價格為 $1.80/$9.00)。
1. 首次呼叫 cURL 檢查(相容 OpenAI 的 Chat Completions)
這兩種模型都可以透過 GPT Proto 統一且相容 OpenAI 的 /v1/chat/completions 端點,使用標準的 Bearer 權杖進行文字與視覺分析呼叫。在兩者之間切換只需更改 "model" 字串:
# 呼叫 1:GPT-6.1 Terra(在 GPT Proto 上每 100 萬個 token 為 $0.80 輸入 / $4.00 輸出)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [
      {
        "role": "user",
        "content": "檢查此 CSS 規則,並用兩句話解釋為什麼它會在行動裝置上觸發版面位移: .hero-banner { width: 100%; height: auto; }"
      }
    ]
  }'

# 呼叫 2:Claude Sonnet 5.5(在 GPT Proto 上每 100 萬個 token 為 $1.80 輸入 / $9.00 輸出)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "messages": [
      {
        "role": "user",
        "content": "編寫一個 TypeScript 輔助函式,使用 Web Crypto API 並透過恆定時間比較來驗證 Webhook 簽章。"
      }
    ]
  }'
2. 適用於前端與應用程式管線的 Python 步驟路由範例
這是一個實用的 Python 模式,使用指向 https://gptproto.com/v1 的標準 openai SDK。在此工作流程中,步驟 1 使用 gpt-6.1-terra 來篩選 UI 錯誤報告(此時 token 數量較大且視覺/DOM 診斷成本較低),步驟 2 則動態將實際的程式碼修補任務路由至 gpt-6.1-terra(針對單一元件的隔離 CSS 修復)或 claude-sonnet-5-5(當篩選結果顯示涉及跨檔案狀態變更,或提示詞接近 272K 限制時):
import os
import json
from openai import OpenAI

# 單一 API 金鑰,在 OpenAI 與 Anthropic 模型間共用餘額
client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

def triage_and_patch_ui_issue(dom_snapshot: str, screenshot_url: str, approx_tokens: int) -> dict:
    # 步驟 1:始終在 GPT-6.1 Terra 上執行視覺/DOM 分流(每 100 萬 token $0.80 / $4.00)
    triage_response = client.chat.completions.create(
        model="gpt-6.1-terra",
        messages=[
            {
                "role": "system",
                "content": (
                    "你是一位前端 QA 分流代理。請檢查截圖與 DOM。"
                    "返回包含以下鍵的 JSON:'root_cause'、'scope' ('isolated_css' 或 'multi_file_state'),"
                    "以及 'target_files' (字串陣列)。"
                ),
            },
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": f"DOM 快照:{dom_snapshot}"},
                    {"type": "image_url", "image_url": {"url": screenshot_url}},
                ],
            },
        ],
        response_format={"type": "json_object"},
    )

    triage_data = json.loads(triage_response.choices[0].message.content)

    # 步驟 2:根據任務範圍與 272K 長上下文計費邊界進行路由
    # 如果修復涉及多檔案狀態或輸入 token 超過 272K,則升級至 Sonnet 5.5
    if triage_data.get("scope") == "multi_file_state" or approx_tokens > 272_000:
        selected_model = "claude-sonnet-5-5"
    else:
        selected_model = "gpt-6.1-terra"

    patch_response = client.chat.completions.create(
        model=selected_model,
        messages=[
            {
                "role": "user",
                "content": (
                    f"分流診斷:{json.dumps(triage_data)} | "
                    f"為 DOM/元件產生最小化且可投入生產的修補程式:{dom_snapshot}"
                ),
            }
        ],
    )

    return {
        "triage": triage_data,
        "routed_to": selected_model,
        "patch": patch_response.choices[0].message.content,
    }

if __name__ == "__main__":
    sample_dom = "<div class='card-grid'><img src='/hero.webp' /><h2>結帳</h2></div>"
    result = triage_and_patch_ui_issue(
        dom_snapshot=sample_dom,
        screenshot_url="https://example.com/cls-regression-frame.png",
        approx_tokens=12_000,
    )
    print(f"已路由修補程式至:{result['routed_to']}")
    print(result["patch"])
部署前注意事項(需進行冒煙測試): 在部署計費迴圈之前,請先對照 GPT Proto 模型頁面上的即時 API 使用量面板,驗證確切的模型字串(gpt-6.1-terra 與 claude-sonnet-5-5)。如果您的代理依賴 OpenAI 的原生 Responses API 工具(apply_patch、託管 shell 或 async: true 函式呼叫)或 Anthropic 的原生 /v1/messages 自適應思考參數(output_config.effort),請針對 GPT Proto 各自的原生端點(/v1/responses 與 /v1/messages)執行快速冒煙測試,以確認您的路由參數傳遞正確。
結論:您應該使用哪一個?
如果您需要一張表格貼入架構審查文件,請根據您最在意的失敗模式與計費邊界,將您的主要工作負載與模型進行匹配:
| 工作負載 / 場景 |
推薦模型 |
推薦設定 |
勝出原因 |
| 高流量螢幕截圖 QA、發票/表單讀取與瀏覽器電腦操作 |
GPT-6.1 Terra |
low 或 medium effort |
GPT Proto 代幣費率降低 56% ($0.80/$4.00),任務完成速度比 Sol/Astra 快 3 倍以上,並具備 Astra 等級的 MMMU-Pro 視覺能力。 |
| 前端 UI 除錯(CLS 版面位移、Figma 轉 CSS、視覺回歸) |
GPT-6.1 Terra |
medium effort |
專為視覺與 DOM 檢查而建;明確針對網頁版面位移修復進行了基準測試。 |
低延遲分類、路由或需要 temperature 的 JSON 提取 |
GPT-6.1 Terra |
reasoning.effort: "none" |
恢復了 GPT-6.1 Sol 取消的非推理 none 層級,將延遲與輸出代幣數量保持在最低限度。 |
| 多檔案後端重構與複雜的 TypeScript/React 狀態變更 |
Claude Sonnet 5.5 |
medium 或 high effort |
在 Terminal-Bench 4.0 上得分為 70.6% 對 50.3%;能以較少的輪次批次處理工具呼叫,節省昂貴的開發人員審查時間。 |
| 單次請求長上下文儲存庫分析(300K 至 900K 輸入代幣) |
Claude Sonnet 5.5 |
medium 或 high effort |
Terra 在超過 272K 代幣時會觸發 2 倍輸入 / 1.5 倍輸出的附加費(官方輸入費用跳升至 $2.00),抵銷了其價格優勢。 |
當 Terra max 不足時,進行最深度的 OpenAI 原生終端編碼 |
GPT-6.1 Sol |
medium effort |
在 AA Coding Agent Index v2.0 上得分 54(Terra 為 48),且 Sol medium ($0.21/任務) 的單任務成本實際上比 Terra `max` ($0.40/任務) 更便宜。 |
總結來說,若不留後路:請將每個可重複的視覺、電腦操作與有界限的編碼步驟,以 GPT-6.1 Terra 的 low 或 medium effort 設定開始,以獲取 $0.80/$4.00 的費率;並將 Claude Sonnet 5.5 用於多檔案編碼步驟與 >272K 代幣的提示詞,因為其較高的首次通過準確率與 1M 上下文固定定價更具成本效益。若要輸入您自己的每月輸入與輸出比例,請開啟 GPT Proto 比較計算機,並在單一基準上測試這兩個模型。