SillyTavern 最佳模型快速指南
此列表根據角色扮演(RP)表現與實際適用性進行排序,而非單純的基準測試表:Gemini 4 Argon、Gemini 3.8 Flash 和 Claude Opus 5.5 部分參考了較新的社群回饋,因為它們未包含在九月份的基準測試中。
| 排名 |
模型 |
SillyTavern 最佳用途 |
角色扮演表現 |
GPT Proto 輸入與輸出價格(每百萬 Token) |
100 次回覆預估成本 |
主要缺點 |
| 1 |
Kimi K3 |
綜合表現最佳與陪伴型 RP |
角色扮演指數 86.3,綜合排名第一 |
$2.55 / $12.75 |
$2.68 |
隨著對話歷史增加,成本較高 |
| 2 |
Gemini 4 Argon |
沉浸式場景與複雜世界觀 |
近期社群回饋強勁;未包含在九月份基準測試中 |
$2.40 / $12.00 |
$2.52 |
對預設設定敏感且價格相對較高 |
| 3 |
GLM-5.3 |
劇情導向 RP 與品質平衡 |
角色扮演指數 85.1,綜合排名第二 |
$1.19 / $3.74 |
$1.14 |
在浪漫場景中可能會過長或出現重複內容 |
| 4 |
DeepSeek V4.1 Flash |
經濟實惠的長對話與嚴謹的回覆 |
角色扮演指數 84.4,綜合排名第三 |
$0.24 / $0.96 |
$0.24 |
文筆個性化程度不如頂級模型 |
| 5 |
GLM-5.3 Flash |
高 CP 值遊戲主持人與嚴格的角色語氣 |
角色扮演指數 83.3,綜合排名第四 |
$0.1275 / $0.425 |
$0.12 |
對於偏離主題的提示詞恢復能力較弱 |
| 6 |
Gemini 3.8 Flash |
快速日常 RP 與大型世界觀提示詞 |
強大的社群基準測試與使用者回饋 |
$0.90 / $4.50 |
$0.95 |
輸出品質與拒絕回應的情況不穩定 |
| 7 |
Claude Opus 5.5 |
頂級文筆與世界觀構建 |
社群回饋褒貶不一但細節豐富 |
$3.60 / $18.00 |
$3.78 |
成本最高且對預設設定極度敏感 |
| 8 |
GPT-6 Luna |
超低價、規則嚴格、結構化 RP |
角色扮演指數 71.1,通過 20 項檢測中的 19 項 |
$0.08 / $0.40 |
$0.08 |
沉浸感、文筆與角色評分較低 |
100 次回覆的預估值假設每次請求固定為 8,000 個輸入 Token 與 500 個輸出 Token,且未計算快取、隱藏推理 Token、重試或價格促銷。實際的長對話通常成本更高,因為輸入歷史會隨著每一輪對話而增加。
我們如何為 SillyTavern 評選模型
主要依據是 2026 年 9 月 AI 角色扮演基準測試 (AI Roleplay Bench),該測試針對 14 款官方模型進行了 10 個類別的評估,並對 840 條回覆進行了評分。其類別涵蓋了陪伴聊天、遊戲主持人 (Game Master) 行為、嚴格的角色語氣、反派角色、穩健性、成人主題以及安全邊界。Kimi K3、GLM-5.3 和 DeepSeek V4.1 Flash 之間的差距不到兩分,因此基準測試本身建議將它們視為平手,而非將小數點後的差異視為決定性勝負。
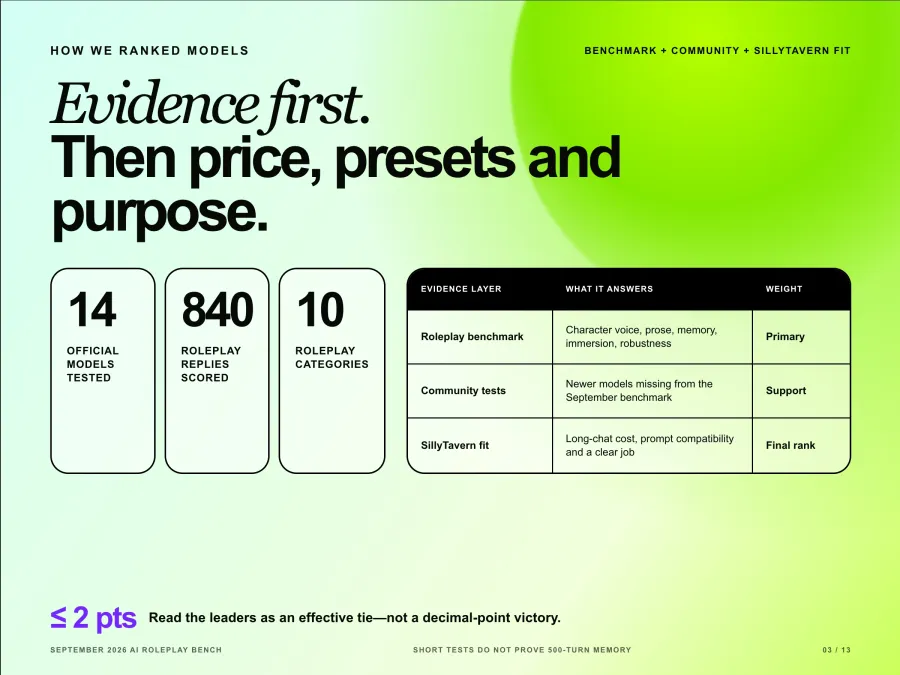
該基準測試也有其局限性。其 已發布的方法論 使用了簡短的多輪場景,無法衡量數百條訊息後的「漂移」現象,且排除了社群微調模型。像 Gemini 4 Argon 這樣較新的發布版本是在該測試之後才推出的。對於這些模型,我使用社群比較作為輔助證據,並將推薦標記為確定性較低。
最終排名增加了三個 SillyTavern 特有的因素:
長對話的經濟性。 輸入 Token 通常在對話後期佔主導地位,因為 SillyTavern 會重複發送角色卡、指令、相關背景設定和對話歷史記錄。
提示詞與預設集的相容性。 聊天補全 (Chat Completion)、文字補全 (Text Completion)、指令模板、採樣器和推理控制並非通用。
每個模型都有明確的定位。 一款較便宜的模型只有在具備實用價值時才能佔有一席之地,而不僅僅是因為價格低廉。
8 款最適合 SillyTavern 角色扮演的 AI 模型
1 Kimi K3:SillyTavern 整體表現最佳模型
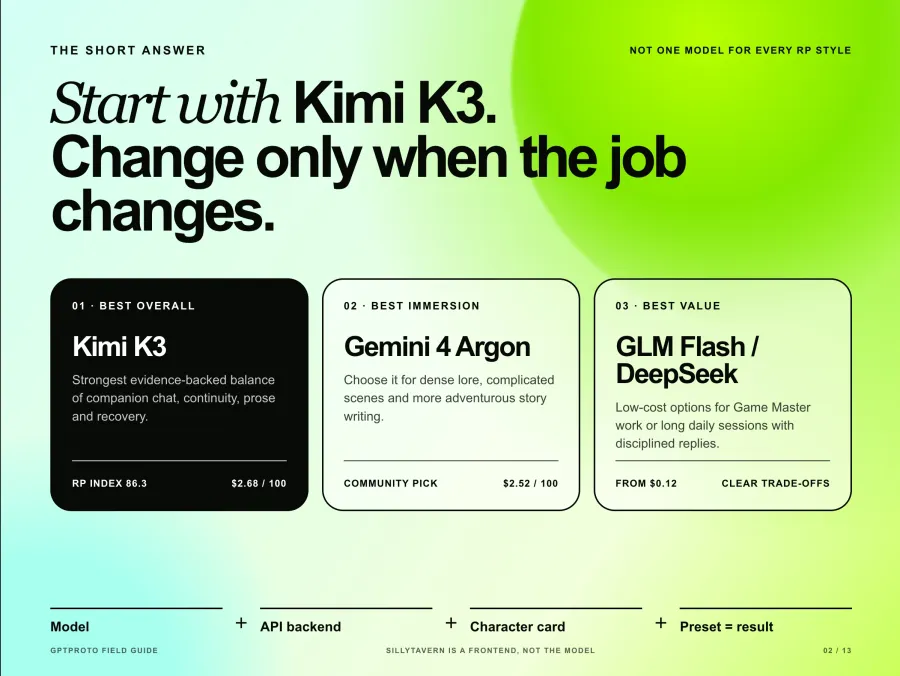
Kimi K3 是當您還不確定自己偏好哪種角色扮演風格時,最穩妥的首選。它在 角色扮演基準測試 中獲得了 總分 86.3、陪伴類 90.0 以及 穩健性 88.3 的成績。它在角色塑造、文筆、記憶力和沉浸感方面的評分也領先於基準測試中的其他模型。
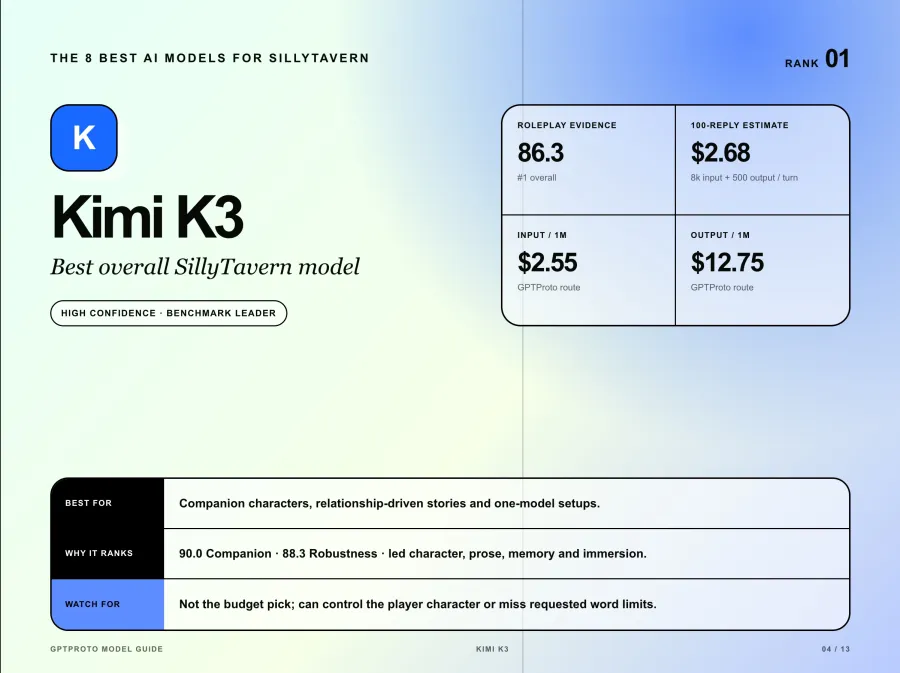
在 SillyTavern 中,這種平衡比單一亮眼的回覆更重要。Kimi 能處理用戶的單詞訊息,記住埋下的細節,並保持角色活躍,而不是變成一個通用的助理。它的缺點很具體:有時會像遊戲主持人一樣控制玩家的角色,且未能遵守要求的字數限制。
最佳適用場景: 陪伴型角色、以關係為導向的故事,以及希望用一個模型應對多種角色扮演風格的用戶。SillyTavern 入門建議: 使用 Chat Completion,選擇正確的 kimi-k3 模型 ID,並在添加更複雜的預設規則前,先使用適中的回覆長度。其價格為每百萬 Token 輸入 2.55 美元、輸出 12.75 美元,並非預算型選擇。
2 Gemini 4 Argon 最適合沉浸式角色扮演
Gemini 4 Argon 是近期社群公認最強大的模型,特別適合處理深厚背景設定、複雜場景以及長篇故事寫作。SillyTavern 的使用者稱讚它在處理大型提示詞時的精確度,以及它能為場景增添實用細節,而不僅僅是改寫角色卡內容。一篇關於長篇故事應用的詳細社群討論指出,當故事在其他模型上變得乏味時,換用此模型後有顯著改善。
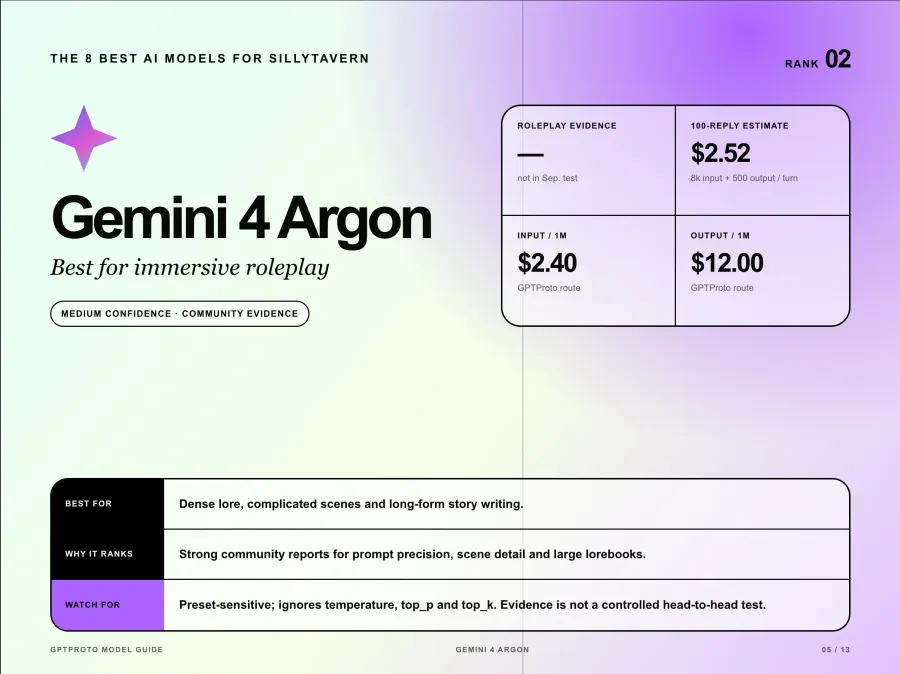
由於 Argon 未被納入九月份的角色扮演基準測試,其信心水準低於 Kimi 或 GLM。社群的熱情固然是參考指標,但這並非受控的對比測試。
Argon 也需要專屬的預設設定。它的 API 會忽略 temperature、top_p 和 top_k,因此複製舊有的 Gemini 採樣器預設設定只會產生「可控」的錯覺,實際上並未改變這些數值。建議在進行一對一角色對話時從中等思考(medium thinking)開始,僅在規則繁重的 RPG 或大型背景設定集(lorebooks)中測試高階思考(high thinking)。缺點是成本:其每百萬 token 輸入 2.40 美元、輸出 12 美元的費率,意味著在歷史紀錄擴展前,進行 100 次固定回覆測試的成本約為 2.52 美元。
3 GLM 5.3 最平衡的故事模型
GLM-5.3 是 Kimi K3 最具說服力的替代方案,特別是當您希望模型能主導更多故事發展時。它在基準測試中獲得了總分 85.1、嚴格語氣(Strict Voice)92.5 以及 穩健性(Robustness)85.8 的成績。基準測試將其描述為特別適用於故事驅動的角色扮演、黑暗小說和冒險類機器人。
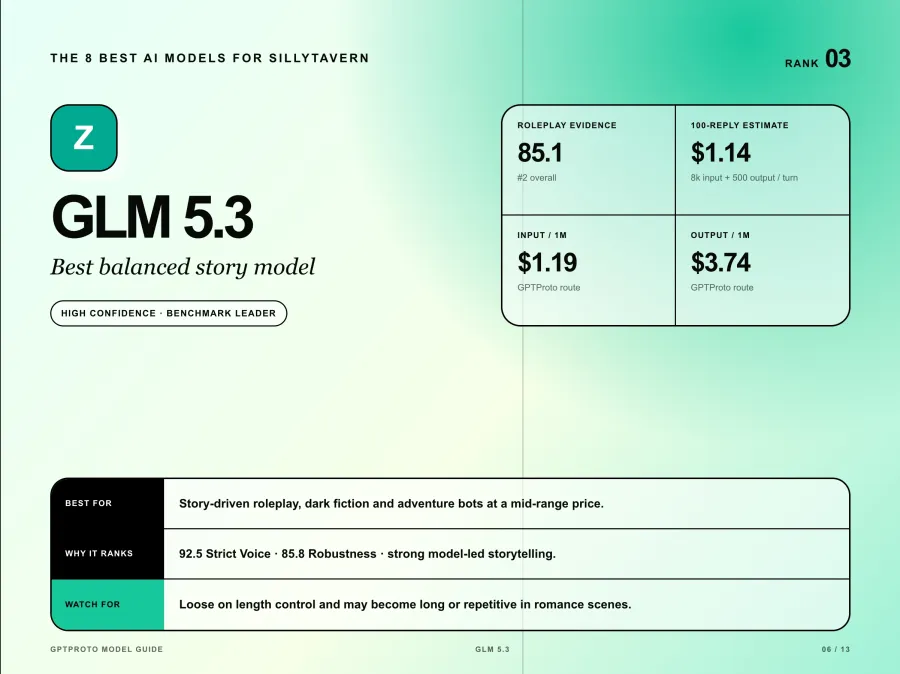
其代價是對長度和節奏的控制力。GLM-5.3 是領先模型中對字數限制最寬鬆的,在基準測試的浪漫場景中表現較差,回覆變得冗長且重複。雖然設定嚴格的最大回覆長度和明確的歷史紀錄後指令有所幫助,但無法保證輸出一定簡潔。
以每百萬 token 輸入 1.19 美元、輸出 3.74 美元的價格計算,GLM-5.3 在 100 次固定回覆的範例中成本不到 Kimi K3 的一半。請使用模型 ID glm-5.3。對於希望在不支付高昂頂級模型費用的情況下,仍能獲得出色角色扮演品質的使用者來說,這是一個明智的預設選擇。
4 DeepSeek V4.1 Flash:高性價比長對話的最佳選擇
DeepSeek V4.1 Flash 提供了榜單中性價比最優的選擇。它的總體評分為 84.4 分,在所有 28 次核心角色扮演回覆中均未超出字數限制,並在「反派」類別中並列第一。其輸入價格為 $0.24,輸出價格為 $0.96,這使得 100 次回覆的固定範例成本約為 $0.24.
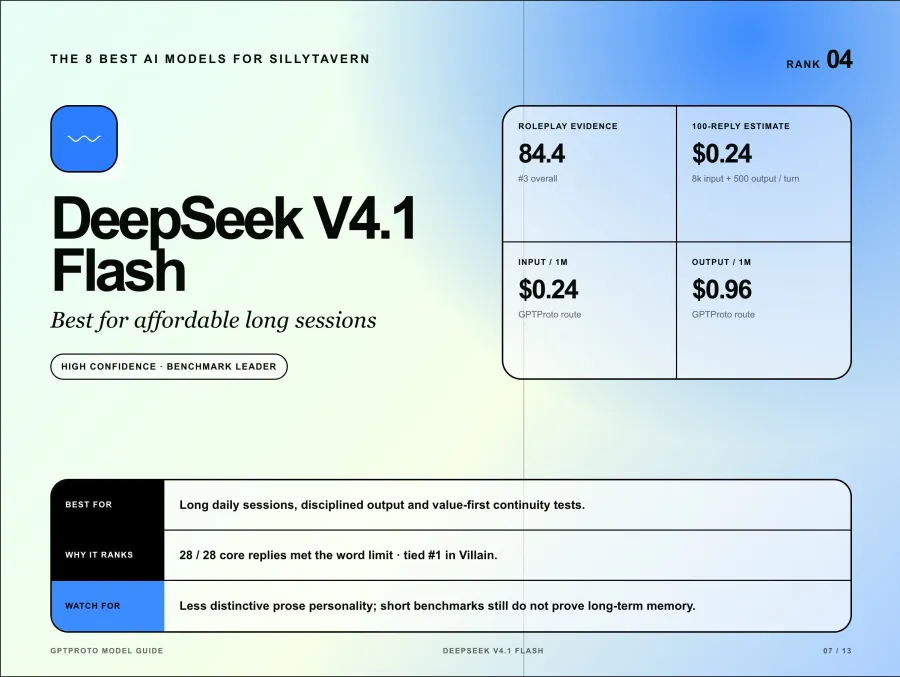
作為文風風格,該模型不如 Kimi、Argon 或 Opus 那樣具有鮮明特色。當角色卡本身已經具備強烈的語氣時,這反而是一個優點:模型較不容易用其自身的預設風格覆蓋掉角色設定。此外,當您預期會有長時間的日常對話,並希望將更昂貴的模型留給關鍵場景時,它也非常實用。
在 SillyTavern 中使用 deepseek-flash。我的判斷是,對於長期運行的聊天來說,這是最佳的初步價值測試,但基準測試仍採用了較短的情境。在將其低廉的價格視為長期記憶能力的證明之前,您應該先進行自己的 30 到 50 輪連續性測試。
5 GLM 5.3 Flash:最佳平價遊戲主持人
GLM-5.3 Flash 是預算型專家。它在「遊戲主持人」類別中獲得了 89.2 分,在「嚴格語氣」類別中獲得了 98.3 分,這是九月基準測試中單項類別的最高分。每百萬 token 輸入價格為 $0.1275,輸出為 $0.425,100 次回覆的固定範例成本約為 $0.12.
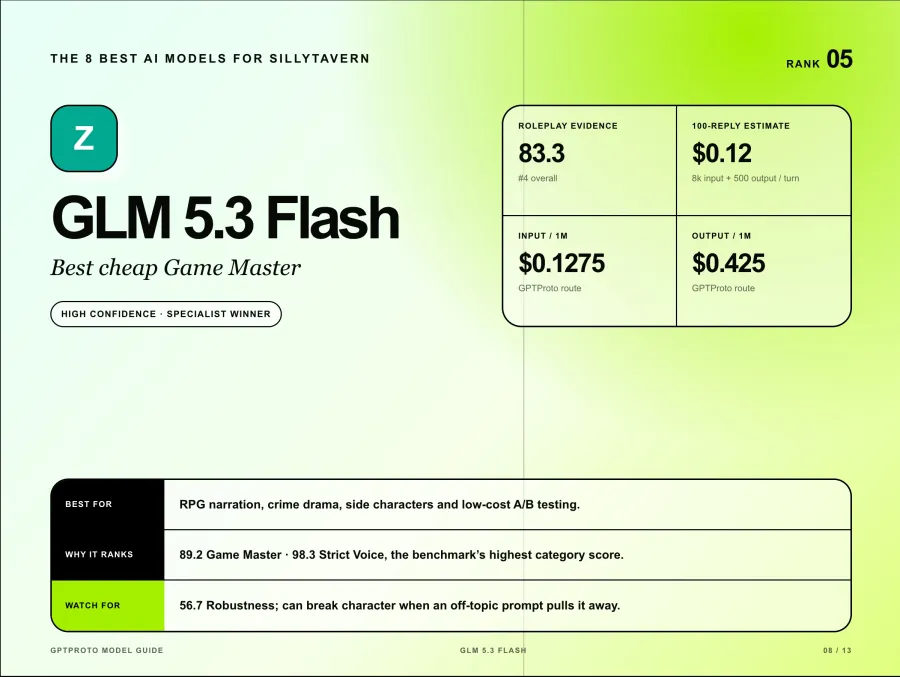
它的缺點同樣重要。GLM-5.3 Flash 在「穩健性」方面僅獲得 56.7 分,因為它會跳脫角色去回答像通用助手那樣的離題請求。它在核心角色扮演的字數限制方面也比其他領先模型遺漏得更多。
選擇它用於 RPG 敘事、犯罪劇、配角扮演或低成本的 A/B 測試。不要假設低廉的價格就意味著它是最好的陪伴模型。在 SillyTavern 中,請將角色規則放在提示詞的末尾附近,並在進行長期聊天之前先測試其是否會刻意脫離角色。模型 ID 為 glm-5.3-flash.
6 Gemini 3.8 Flash 最佳日常快速模型
Gemini 3.8 Flash 在此列表中應佔有一席之地,而不僅僅是順帶一提。最近一項 社群角色扮演基準測試 針對八個章節對每個模型進行了多達 64 次回應測試,給予 Gemini 3.8 Flash 91.9 的品質評分。該測試將寫作偏好權重設為 75%,穩健性權重設為 25%。這是有用的證據,但由於提示詞和評分方法不同,其分數無法與 AI Roleplay Bench 直接比較。
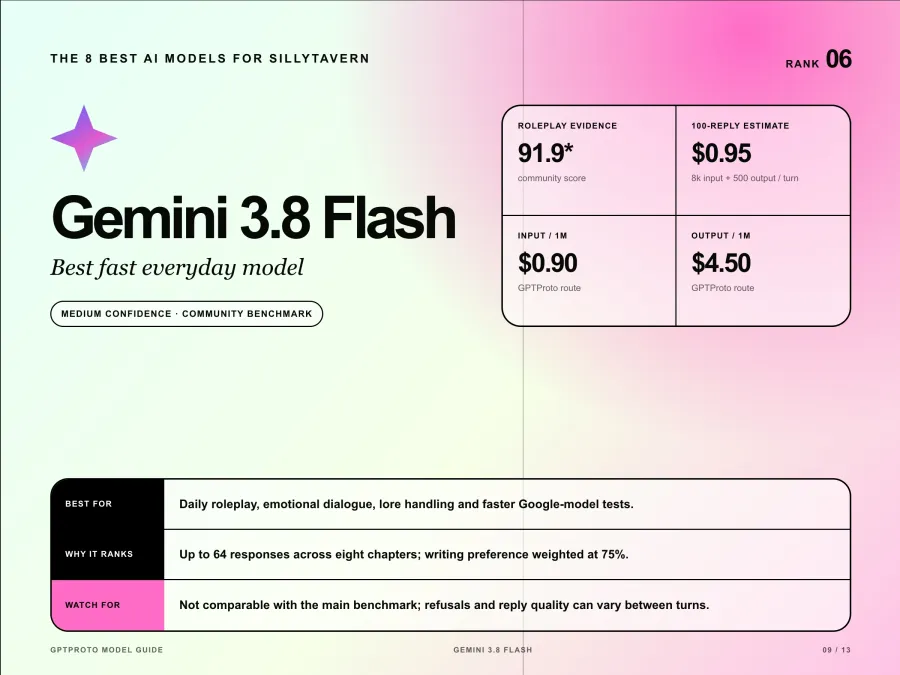
社群報告也稱讚其情感對話、背景知識處理和對話節奏。其缺點在於一致性:一些用戶反映,即使在前後對話順暢的情況下,仍會出現隨機拒絕或回應不穩定的情況。
使用 gemini-3.8-flash 並從中等思考模式開始。其每百萬 token 輸入 0.90 美元和輸出 4.50 美元的價格使其比 Argon 便宜得多,儘管固定的 100 次回覆範例成本仍約為 0.95 美元。當您想要一個適合日常使用的 Google 模型,但不需要在每次對話中都使用 Argon 的進階推理能力時,請選擇它。
7 Claude Opus 5.5 最佳進階文筆模型
Claude Opus 5.5 是進階文筆的首選,而非全能冠軍。喜歡它的用戶指出其在空間感知、世界觀知識、節奏感以及讓場景變得生動的能力方面表現出色。一份詳細的 SillyTavern 社群報告 建議將其用於一般故事角色扮演,並在場景需要不同內容處理時切換模型。
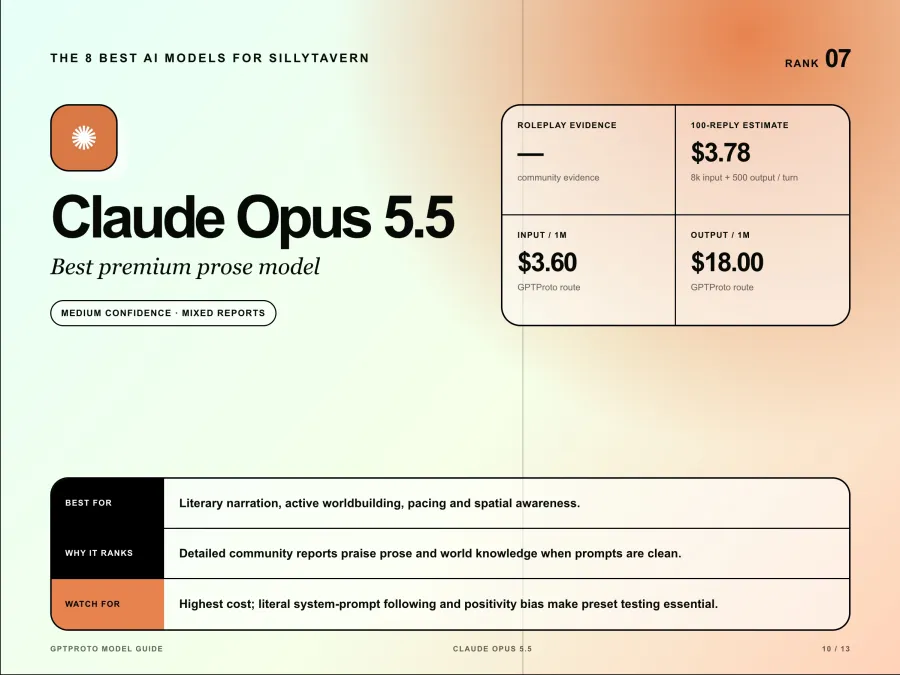
其他用戶反映,Opus 對大型系統提示詞的執行過於死板,以至於角色卡或預設中的衝突指令可能會扭曲角色設定。正面偏見是另一個反覆出現的抱怨。這種分歧解釋了為什麼在未測試具體角色卡的情況下,我不會將其排名高於基準測試的領先者。
價格是最明顯的缺點:每百萬 token 輸入 3.60 美元,輸出 18 美元,在固定的 100 次回覆範例中約為 3.78 美元。使用 claude-opus-5-5 時,請從乾淨的提示詞開始,並移除您無法解釋的繼承預設規則。Opus 值得在文學敘事方面進行測試。但對於休閒的高頻對話來說,很難證明其價格合理。
8 GPT 6 Luna 最優質的超平價 GPT 模型
GPT-6 Luna 是為什麼 GPT 不應在 SillyTavern 指南中缺席的原因,儘管它並非整體表現最好的角色扮演模型。Luna 的總分為 71.1 分,遠低於四個基準測試的領先者,其中 Companion(夥伴)得分 68.3,Strict Voice(嚴格語音)得分 60.0,以及 Robustness(穩健性)得分 54.2。它過於謹慎的特性多次使其脫離了虛構情境。
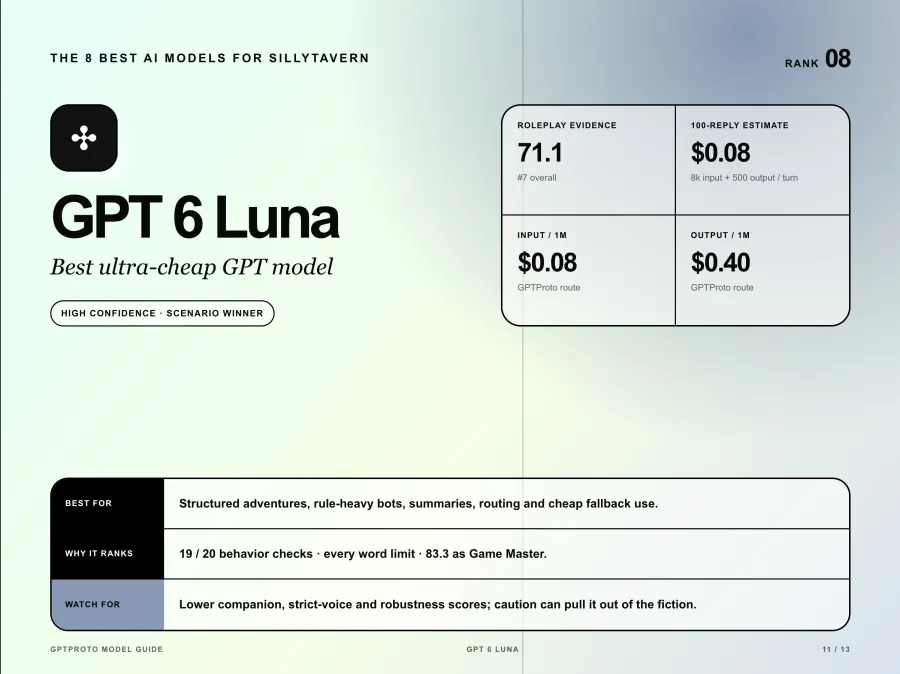
結果的另一半則很有參考價值。GPT-6 Luna 通過了 20 項行為檢查中的 19 項,遵守了所有測試的字數限制,並在 Game Master(遊戲管理員)項目中獲得 83.3 分。以每百萬 token 輸入 0.08 美元、輸出 0.40 美元的價格計算,固定的 100 次回覆範例成本約為八美分。
請將 gpt-6-luna 用於結構化冒險、規則繁重的機器人、摘要、路由或作為廉價的備選方案。當情感沉浸感是主要目標時,請勿選擇它,而應選擇 Kimi、GLM 或 Gemini。這是一個特定場景下的贏家,並非暗示這個基準測試排名第七的模型是整體表現最好的。
為什麼沒有更多 GPT、Claude 和 Gemini 模型
一份有用的排名不應為每個供應商保留相同的空間。每個額外的模型都需要強有力的角色扮演證據或明確不同的用途。
| 模型系列 |
主列表選擇 |
值得測試的其他模型 |
為什麼替代模型沒有單獨排名 |
| GPT |
GPT-6 Luna |
GPT-6.1 Terra,價格為 $0.80 / $4.00 |
Terra 具有吸引人的定價和通用的寫作能力,但目前尚無可比較的角色扮演基準測試數據 |
| Claude |
Claude Opus 5.5 |
Claude Sonnet 5.5,價格為 $1.80 / $9.00 |
這是一個更便宜的 Claude 選項,但目前針對角色扮演的證據太少,不足以將其列為單獨的贏家 |
| Claude |
Claude Opus 5.5 |
Claude Haiku 5.5,價格為 $0.09 / $0.45 |
Haiku 定位於高容量、輕量級工作;僅憑低價格並不能證明其具有強大的文筆或長對話的一致性 |
| Gemini |
Gemini 4 Argon 與 3.8 Flash |
Gemini Flash Lite 變體 |
較便宜的 Lite 模型缺乏同樣針對角色扮演的社群證據 |
| Kimi |
Kimi K3 |
Kimi K3.1 Pro,價格為 $2.00 / $10.00 |
它更新且更有潛力,但在專業基準測試中尚未取代 K3 |
這也是為什麼 GPT-6 Luna 排在第八位而不是消失的原因。它有針對特定狹窄用途的證據。Terra 未來可能會超越它,但現在就下此定論會將通用能力與經過測試的角色扮演表現混為一談。
SillyTavern 最佳本地模型(按 VRAM 分類)
在本地運行 SillyTavern 並不代表語言模型本身就是本地的。前端介面本身對硬體要求不高,但本地推理需要足夠的 GPU 記憶體來存放模型權重和上下文快取。SillyTavern 官方概覽建議本地推理至少需要 6 GB 的 VRAM 作為起點。
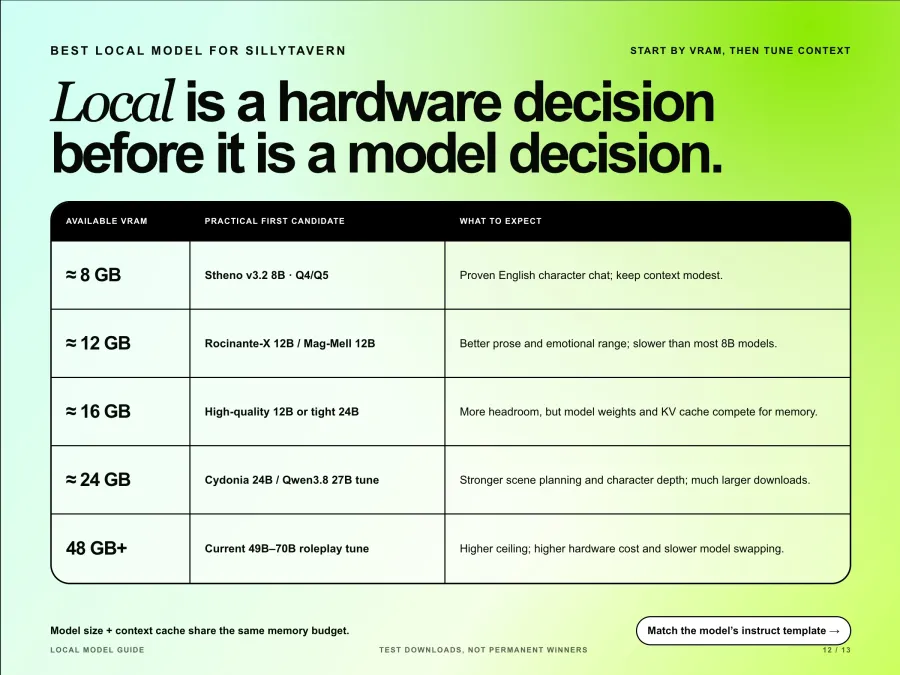
本地模型的推薦標準變化很快,因此請將這些視為測試用的首選下載項目,而非永久的最佳選擇。目前的 Hugging Face 角色扮演模型目錄包含數千種具有不同模板和量化方式的社群變體。
| 可用 VRAM |
實用的首選候選模型 |
預期效果 |
| 約 8 GB |
Stheno v3.2 8B (Q4 或 Q5 量化) |
經過驗證的英語角色對話入門選擇,但上下文長度必須保持適中 |
| 約 12 GB |
Rocinante-X 12B 或 Mag-Mell 12B |
比大多數 8B 模型具備更好的文筆與情感表現,但生成速度較慢 |
| 約 16 GB |
更高品質的 12B 量化模型,或具備短上下文與部分卸載功能的 24B 模型 |
擁有更多品質提升空間,但模型檔案能放入 VRAM 並不保證大型 KV 快取也能放入 |
| 約 24 GB |
Cydonia 24B 或 Qwen3.8 27B 角色扮演微調版 |
更好的場景規劃與角色深度,但下載檔案體積大得多 |
| 48 GB 及以上 |
當前的 49B 至 70B 角色扮演微調版 |
上限更高,但硬體成本高昂且模型切換速度慢得多 |
對於 8 GB 顯示卡,核心權衡很簡單:模型大小與上下文長度會爭奪相同的記憶體。請從較小的上下文開始,確認角色語氣,然後在觀察 VRAM 使用量與生成速度的同時逐步提高限制。
對於本地文字補全後端,請選擇模型實際的指令模板 (Instruct Template)。SillyTavern 的 指令模式說明文件警告稱,所選模板必須與模型預期的格式相符。一個強大的微調模型如果使用了錯誤的模板,效果可能會比配置正確的小型模型更差。
長期角色扮演的最佳模型
Kimi K3 是目前在長期角色連續性方面證據最充分的選擇,而當對話歷史變得昂貴時,DeepSeek V4.1 Flash 則是更經濟的選擇。Gemini 4 Argon 對於大型設定集(lorebooks)很有吸引力,但請勿將百萬級的 Token 視窗與可靠的記憶力混為一談。
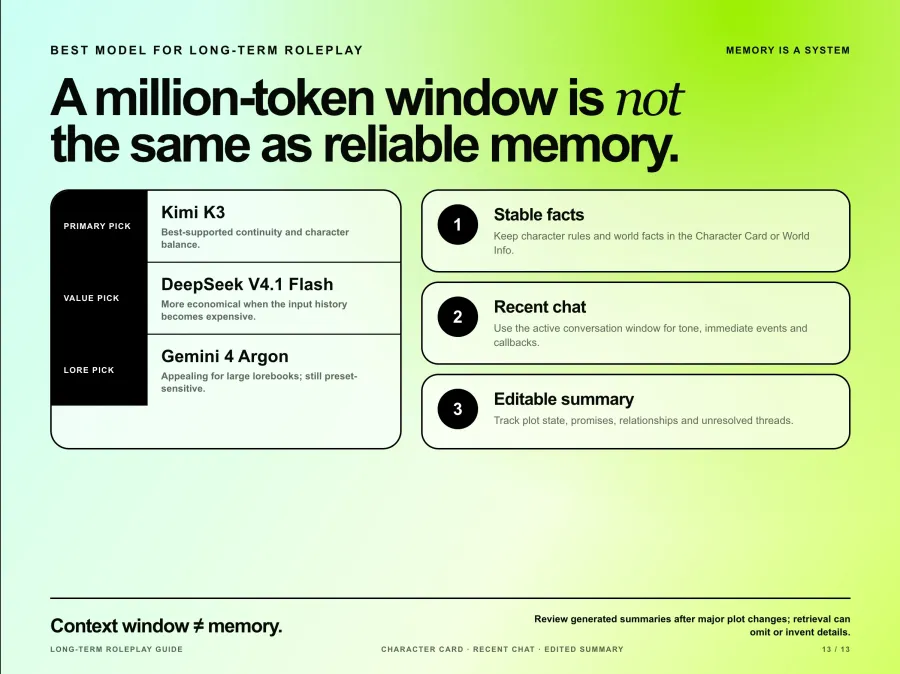
SillyTavern 的 上下文文件 解釋說,只有活動上下文範圍內的訊息才會發送給模型。角色資訊、系統提示詞、世界觀資訊(World Info)、摘要以及回應空間都會消耗相同的預算。一旦舊訊息超出此範圍,除非您重新注入相關事實,否則模型將無法回憶起它們。
請使用三個層次,而不是僅僅依賴上下文大小:
將穩定的角色事實和世界規則保留在角色卡或世界觀資訊中。
使用最近的聊天記錄來維持語氣和即時事件。
維護一個簡短、可編輯的摘要,用於記錄劇情狀態、關係、承諾和未解決的線索。
「摘要(Summarize)」擴充功能可以自動化第三層,但其文件警告說,模型生成的摘要可能會遺漏細節或憑空捏造。在重大劇情變更後,請務必檢查摘要。聊天向量化(Chat Vectorization)仍處於實驗階段,且 可能會降低檢索效果,因此應先進行測試,而非盲目啟用。
如何在 SillyTavern 中切換模型
切換模型不會刪除聊天記錄,但可能會改變語氣、格式、拒絕行為以及對早期訊息的解讀方式。請為每個模型系列保存單獨的預設設定,而不是在 GPT、Claude、Gemini 和本地文字補全模型之間強行使用同一個預設。
對於 GPT Proto,簡短的設定步驟如下:
在 SillyTavern 中開啟 API 連線(API Connections)。
選擇 聊天補全(Chat Completion) 和 自訂 OpenAI 相容(Custom OpenAI compatible)。
將基礎 URL(Base URL)設定為 https://gptproto.com/v1。請勿附加 /chat/completions;SillyTavern 會自動添加。
貼上 API 金鑰並輸入精確的模型 ID,例如 kimi-k3、glm-5.3-flash 或 gemini-3.8-flash。
將提示詞後處理(Prompt Post-Processing)設定為 無(None),進行連線,然後執行 測試訊息(Test Message)。
圖文並茂的 SillyTavern API 整合指南 涵蓋了安裝、角色卡、截圖以及常見的連線錯誤。
如果您想在 SillyTavern 之外驗證相同的金鑰和模型,此請求使用了完全相同的 OpenAI 相容路由:
export GPTPROTO_API_KEY="YOUR_KEY"

curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3",
    "messages": [
      {"role": "user", "content": "Reply in character with one short sentence."}
    ],
    "max_tokens": 120
  }'
切換後,請使用同一個角色卡測試至少五個回合。包含一個簡短回覆、一個離題提示、一個關於回覆長度的指令,以及一個對早期細節的回顧。這比單純判斷開場訊息更能發現問題。
您應該選擇哪款 SillyTavern 模型
若您想要一個有實證支持的預設選擇,請選擇 Kimi K3。
若您需要處理複雜的背景設定與沉浸式場景開發,且願意接受較高的成本與較低的基準測試確定性,請選擇 Gemini 4 Argon。
若您想要一款中等價位且敘事能力強的模型,請選擇 GLM-5.3。
若您需要負擔得起的長對話與嚴謹的輸出,請選擇 DeepSeek V4.1 Flash。
若您需要預算友善的 RPG 敘事與嚴格的角色語氣,請選擇 GLM-5.3 Flash。
若您想要一款更快、更便宜且有社群測試支持的 Gemini 模型,請選擇 Gemini 3.8 Flash。
若您認為文筆品質值得支付相應費用,請選擇 Claude Opus 5.5。
若您需要最便宜的結構化角色扮演、摘要或備用路由,請選擇 GPT-6 Luna。
若隱私、離線使用與無限制生成對您而言比設定時間及雲端模型品質更重要,請選擇 本地角色扮演微調模型。
您可以在 GPT Proto SillyTavern 模型頁面比較當前的用量訊號與模型價格,然後透過 角色扮演 API 測試場在不同模型間測試相同的角色與對話紀錄。
最終結論
如果您想要一個支援度最好的全能選擇,請從 Kimi K3 開始。如果您最在意沉浸感,請同時測試 Gemini 4 Argon;當長對話的成本成為主要考量時,請準備好 DeepSeek V4.1 Flash 或 GLM-5.3 Flash。
模型只是其中一個層面。匹配的提示詞格式、乾淨的角色卡、模型專屬預設以及編輯過的記憶摘要,對結果的影響往往比在列表中向下移動一個名次還要大。請在兩到三個候選模型上運行相同的五輪測試,然後選擇一個能在您可負擔的價格內保持角色完整性的模型。