一個預約頁面看起來完成了,直到有人輸入無效日期、重新整理瀏覽器或在手機上嘗試使用時,問題才會浮現。這正是 AI 程式碼比較變得有趣的地方。能產出最美觀首張截圖的模型,可能會讓你在應用程式真正可用之前,面臨更多後續工作。
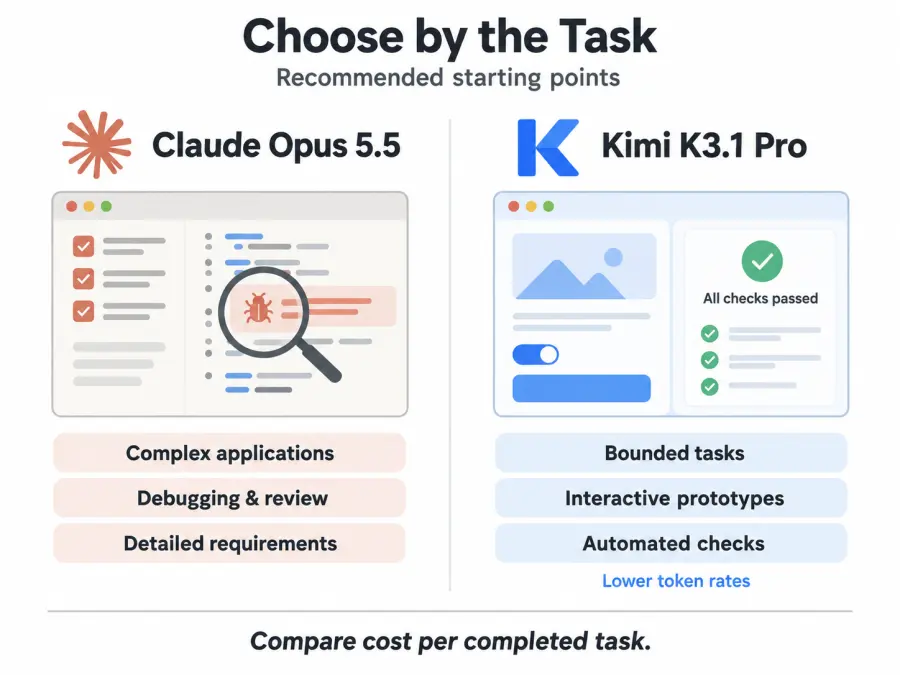
我的初步建議是,對於需要除錯、精確需求和審查時間的複雜應用程式開發,選擇 Claude Opus 5.5。Kimi K3.1 Pro 則值得在受限的實作任務、互動式原型以及可自動檢查的工作負載中進行早期試用。其較低的 Token 費率讓實驗更容易編列預算;至於是否能降低最終帳單,則取決於它所完成的工作量。
因此,有意義的比較是逐項進行的:前端保真度、互動行為以及在現有專案中的開發表現。已發布的基準測試建立了基準,而開發者的實際案例則展示了這些基準在實務中呈現的樣貌。
Kimi K3.1 Pro 與 Opus 5.5 概覽
| 項目 |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| 官方每百萬 tokens 輸入/輸出價格 |
$2 / $10 |
$4 / $20 |
| GPT Proto 每百萬 tokens 輸入/輸出價格 |
$2 / $10 |
$3.60 / $18 |
| 上下文視窗 |
約 100 萬 tokens |
100 萬 tokens |
| 模型輸入/輸出 |
文字與圖片 / 文字 |
文字與圖片 / 文字 |
| 原生 API 預設推理強度 |
最大 (Max) |
中等 (Medium) |
| 我的首次試用建議 |
具有明確檢查點的限定任務 |
複雜開發與最終審核 |
價格檢查日期為 2026 年 10 月 29 日。官方規格來自 Kimi API 文件 與 Claude 模型文件。GPT Proto 費率列於 Kimi K3.1 Pro API 頁面 與 Claude Opus 5.5 API 頁面。快取操作及其他適用費用需另行計算。
如需快速目錄比較,請使用 Kimi K3.1 Pro 與 Claude Opus 5.5 比較頁面。關於此次 Kimi 發布的背景,請參閱 Kimi K3.1 Pro 的變更內容。
基準測試告訴我們關於程式設計的資訊及其局限性
Moonshot 的 公開發布比較 報告顯示,在 Terminal-Bench 4.0 測試中,Kimi K3.1 Pro 為 65.7%,Opus 5.5 為 66.4%。這些是供應商發布的數據,尚待對該特定比較進行獨立驗證。這些數據支持將 Kimi 用於終端相關工作,但並不代表兩者在應用程式開發方面具有同等效能。
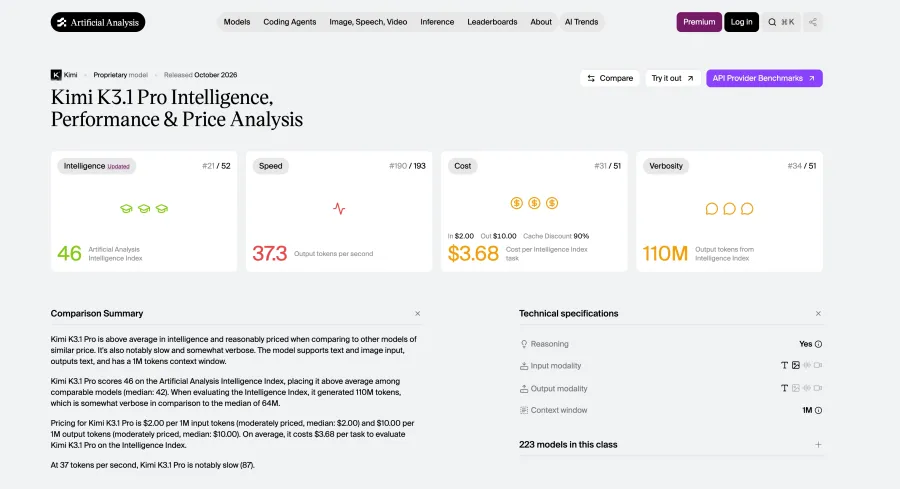
更廣泛的獨立觀點則有所不同。在 10 月 29 日,Artificial Analysis Intelligence Index v5.0 模型頁面顯示 Kimi 為 46,而 Opus 為 58,後者標記為「最大 (Max) 搭配預設回退機制」。這些指數點並非百分比或程式設計成功率。請務必將指數版本與配置與比較結果一併參考。
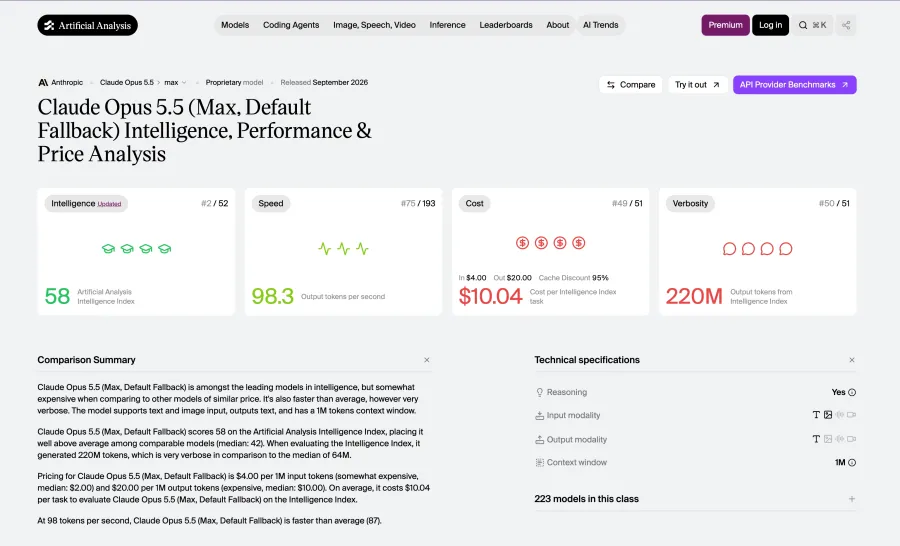
我會將 Opus 視為高要求工作的初始品質基準,然後測試 Kimi 是否能以更低的成本達到相同的驗收標準。終端基準測試無法告訴您預訂表單是否保留了狀態,或儀表板在行動裝置上是否依然易讀。這些必須由您的應用程式測試來回答。
前端編碼:從截圖到可運作的介面
對於「從截圖到介面」的任務,請將外觀與行為分開處理。一個忠實的版面配置仍需要具備可運作的導覽、表單狀態、鍵盤存取功能以及可用的行動裝置版本。接著再要求進行變更。在不破壞現有版面的情況下新增篩選器,與生成一個全新的頁面是完全不同的測試。
這裡有一個實用的開發者範例。在 Melvynx 發布的比較 中,他更偏好 Opus 對時區檢查器的視覺處理。這屬於對單一建構結果的審美判斷,而非衡量前端開發的勝率。
對於行銷網站或客戶端儀表板,當設計需要獨特性與反覆優化時,我的首選會是 Opus。Kimi 是內部介面且擁有明確設計系統時的合理候選,特別是當您可以在發布前檢查結果時。其代價是需要花時間修正初始提示詞所遺留的問題。
以預訂介面作為評估簡報。給予兩個模型相同的參考圖片、現有的元件庫,以及關於日期選擇、不可選時段、驗證與確認的需求。要求兩者將介面連接到同一個模擬 API。接著引入一個失敗請求,並檢查使用者是否能在不遺失表單資料的情況下進行恢復。
最後這個步驟使其成為應用程式層級的比較。它能揭示一個美觀的頁面是否也能處理客戶的下一步操作。
互動式應用與 3D:視覺品質、邏輯與執行效能
Kimi 在互動式視覺作品上的表現變得更有趣。Melvynx 的 熔岩燈範例 包含了燈光與色彩控制。他認為 Opus 投入更多心力的結果最好,同時也發現 Kimi 的材質與玻璃效果相當令人信服。他報告的執行成本分別為:Kimi High 為 2.30 美元,Max 為 4.16 美元;而 Opus Medium 為 4.35 美元,Extra High 為 6.39 美元。
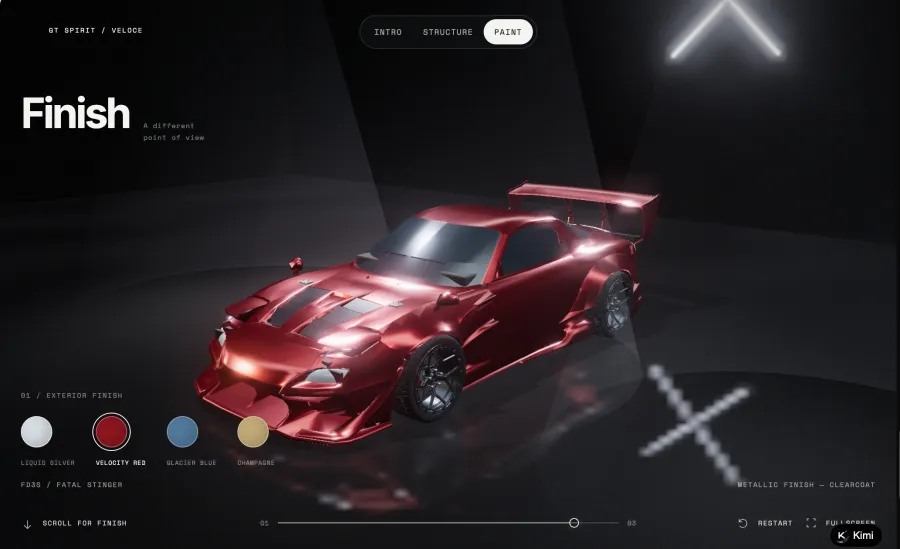
同一篇評論描述了一個在 Kimi High 上比 Max 表現更好的崩潰模擬。作者揭露了其包含 Kimi 的聯盟行銷連結,且使用的是共享、非隔離的工作空間。這些範例是實用的觀察結果,但需考量上述限制。
我的解讀是,Kimi 值得在產品配置器、教育演示與視覺原型上進行測試。自動選擇更高強度的設定會錯過這些範例中實用的經驗教訓。請從明確的需求開始,並檢查產出的成品。
對於家具配置器,請定義當使用者選擇材質、切換攝影機視角或重置設計時,哪些部分必須變更。檢查顯示的價格是否與選擇相符。重新載入頁面。在手機上測試控制項。一個視覺上吸引人的椅子只是交付成果的一部分。
技術準確性需要獨立的檢查。Moonshot 的 BenchCAD 結果 報告顯示,在使用幾何重建指標的情況下,Kimi 為 92.7%,Opus 為 96.2%。該廠商發布的結果解決的問題,與場景看起來是否美觀是兩回事。一個令人信服的動畫在用於教學物理或呈現工程流程之前,仍需要獨立的驗證。
對於原型,我會先試用 Kimi。對於精度敏感的應用,我會從 Opus 開始,並要求無論哪個模型產出程式碼,都必須進行領域特定的檢查。
代理開發:模型能否完成多步驟任務?
在儲存庫中運作的代理必須理解現有行為、選擇要修改的檔案、執行工具、解讀錯誤並決定何時停止。錯誤可能會在這些步驟之間累積。
兩家供應商都發布了擴展工作的範例。Moonshot 描述了 Kimi 在重新訓練步行控制器之前診斷並修正模擬器的過程。Anthropic 的 Opus 5.5 發布報告 描述了 Web 應用程式的改進,包括在 40 次試驗中成功完成 39 次的載入時間任務。這些是個別供應商的範例,而非共享的直接對比測試。
對於現有的發票應用程式,一個有用的比較是增加 CSV 匯入功能。這需要欄位對應、無效列處理、重複偵測、預覽以及涵蓋現有行為的測試。讓每個模型從相同的儲存庫快照開始工作,並檢查兩個修補程式。一份寫著「所有測試通過」的摘要背後,必須有測試日誌作為支撐。
對於這類跨檔案變更,Opus 會是我的預設起點。Kimi 在工作的有限部分(例如根據約定的架構實作驗證)更容易評估。在測試確認它能處理周邊應用程式後,再擴大其範圍。
配置也很重要。Kimi 的 工具使用指南 要求在對話輪次中保留完整的助理訊息。Claude 的 Opus 文件 描述了模型特定的思考與工具行為。請在您選擇的路徑上驗證這些細節;僅僅符合基本的請求格式並不能建立相同的代理行為。
定價與成本:被接受的結果實際成本為何?
Kimi K3.1 Pro 擁有較低的標準輸入與輸出費率。更難的問題是您的任務需要多少次呼叫、重試與審核週期。
以下是使用 GPT Proto 列出費率的規劃範例。假設每次嘗試使用 100 萬個未快取的輸入 Token 與 20 萬個計費輸出 Token。這些是假設的量,而非觀察到的應用程式結果。
| 規劃情境 |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| 上述用量的一次嘗試 |
$4.00 |
$7.20 |
| 兩次嘗試,每次用量相同 |
$8.00 |
$14.40 |
在這些假設下,需要兩次嘗試的 Kimi 結果在 Token 成本上比一次就通過的 Opus 結果更高。實際重試很少會重複完全相同的 Token 用量,因此請使用您的使用記錄進行實際計算。
快取會再次改變比較結果。兩家供應商都在其 Kimi 與 Claude 文件中列出了每 100 萬個 Token 0.20 美元的官方快取讀取費用。具有大量快取命中的長代理會話,其成本比例將與全新請求不同。請同時檢查快取寫入費用、輸出使用量以及您供應商的實際費率。
對於團隊而言,我會追蹤每個已接受任務的成本,以及經過的時間與審核人員的時間。當檢查過程快速時,較便宜的草稿可能具有良好的價值。但如果開發人員必須在信任代理之前重新建構它所做的變更,那麼它的吸引力就會降低。
如何透過 GPT Proto 在您的應用程式中比較這兩個模型
請使用一個具備可觀察結果的小型應用程式變更。比起無限制地要求「建立一些令人印象深刻的東西」,預約表單、CSV 匯入器或產品配置器能為您提供更有用的證據。
開啟 Kimi 模型頁面 與 Opus 模型頁面。使用「試用此模型」與「快速入門」來取得整合指南,然後將 Markdown 指令複製到您的程式設計助理中。請將您的 API 金鑰保留在本地環境變數或伺服器端配置中。
在評估開發品質之前,請先檢查兩個模型路由是否皆有回應。此連線範例遵循模型頁面上發布的 Chat Completions 格式。在執行前請先在本地設定 GPTPROTO_API_KEY;請求將會消耗付費代幣。
for model in kimi-k3.1-pro claude-opus-5-5; do
  curl --fail-with-body --silent --show-error --max-time 180 \
    https://gptproto.com/v1/chat/completions \
    -H "Authorization: Bearer $GPTPROTO_API_KEY" \
    -H "Content-Type: application/json" \
    --data "{
      \"model\": \"$model\",
      \"messages\": [{\"role\": \"user\",
        \"content\": \"Return only: API connection OK\"}]
    }"
done
這僅檢查連線能力,而非程式碼品質。原生 API 具有不同的預設推理設定;在進行應用程式比較之前,請先配置並記錄支援的努力程度設定。API 回應還需要圍繞它的代理程式或應用程式來編輯檔案、執行工具並檢查瀏覽器。
進行開發試驗時,請從同一個專案的乾淨副本開始執行每個模型。提供相同的任務、權限、相依性與驗收測試。記錄模型路由、努力程度、計費使用量、完成時間以及所需的手動變更。在將微小的差異設為生產環境預設值之前,請重複執行該任務。
如果端點傳回驗證錯誤,請檢查金鑰與授權標頭。如果選用參數被拒絕,請將其與目前的模型頁面指南進行比較。在擴大工作規模之前,請確認成功的回應包含預期的模型輸出。
你應該選擇哪種模型?
| 您的工作負載 |
我的首選 |
保留該模型的條件 |
| 需要反覆修改設計的客戶端前端開發 |
Opus 5.5 |
產出品質較高,值得其成本 |
| 互動式原型或視覺化實驗 |
Kimi K3.1 Pro |
控制項運作正常且產出物易於檢查 |
| 現有應用程式中的複雜變更 |
Opus 5.5 |
儲存庫測試與審查結果支持此選擇 |
| 針對固定規格進行重複實作 |
Kimi K3.1 Pro |
自動化檢查能保持較低的修正成本 |
| 對精度敏感的程式碼或模擬 |
以 Opus 作為初始基準 |
無論使用哪種模型,都需要外部驗證 |
如果團隊要將大量應用程式工作交給 AI 代理處理,我會選擇 Opus 5.5 作為初始預設模型。更廣泛的評估證據支持從這裡開始,而實際的儲存庫表現將決定其溢價是否值得。
Kimi K3.1 Pro 是降低明確定義工作成本的實用選擇。從您可以檢查或測試的任務開始,衡量被接受的結果,並隨著證據的增加賦予其更多責任。這比單一基準測試中微小的差距更適合作為切換模型的理由。
請嘗試將一個小型任務帶到 Kimi K3.1 Pro API 和 Claude Opus 5.5 API 頁面,使用整合指南,並比較您的應用程式所能接受的結果。