역할극을 위해 어떤 ChatGPT 모델을 선택해야 할까요?
가장 철저하게 테스트된 GPT 옵션을 원하신다면 GPT-6.1 Sol로 시작하세요. 빠른 응답이 가장 중요하다면 GPT-6 Sol을, 비용 효율적인 중간 지점을 원하신다면 Terra를, 비용 절감이 최우선이라면 Luna를 선택하세요.
| 모델 |
추천 이유 |
평균 응답 완료 시간 |
테스트된 응답 수 |
기록된 테스트 비용 |
| GPT-6.1 Sol |
통제된 캐릭터 상호작용을 위한 종합 추천 |
7.85초 |
39 |
$0.0785 |
| GPT-6 Sol |
빠른 대화형 응답 |
4.09초 |
13 |
$0.0290 |
| GPT-6.1 Terra |
비용 효율적인 중간 지점 |
4.88초 |
13 |
$0.0148 |
| GPT-6 Luna |
이번 테스트 중 최저 비용 |
6.37초 |
13 |
$0.0022 |
표본 크기가 다릅니다: Sol은 선별 과정 이후 추가 실행을 거쳤습니다. 따라서 총 비용은 이 표 전체에 걸친 동일 조건의 가격 비교가 아닙니다. 이는 기록된 단기 세션 비용이며, 구독 가격이나 향후 대화에 대한 견적이 아닙니다.
네 가지 모델 모두 선별 단계에서 주요 사실 확인을 통과했습니다. 순서는 창의적 능력의 큰 격차가 아닌, 실용적인 권장 사항을 반영한 것입니다.
다른 모델 제품군도 고려 중이시라면, 역할극을 위한 최고의 AI 모델에 대한 당사의 포괄적인 가이드에서 별도로 확인하실 수 있습니다.
모델 테스트 방법
롤플레잉에는 유창한 문장 이상의 것이 필요합니다. 캐릭터는 고유한 목소리를 가져야 하고, 방금 일어난 일을 기억해야 하며, 대화의 주도권을 사용자에게 넘겨줄 줄 알아야 합니다.
이러한 차이는 커뮤니티 피드백에서도 나타납니다. 긴 인터랙티브 스토리와 관련된 한 토론에서, 한 플레이어는 캐릭터가 지나치게 유해지고 로맨틱한 플롯이 정체된다고 설명했습니다. 캐릭터 붕괴에 관한 또 다른 토론에서는 원치 않는 안심시키기(reassurance)에 대한 불만과 성공적인 장기 RPG 세션에 대한 보고가 모두 포함되었습니다. 이러한 경험들은 질문의 틀을 잡는 데 도움이 되었지만, 테스트된 버전들이 실제로 어떻게 작동하는지를 확정 짓는 것은 아닙니다.
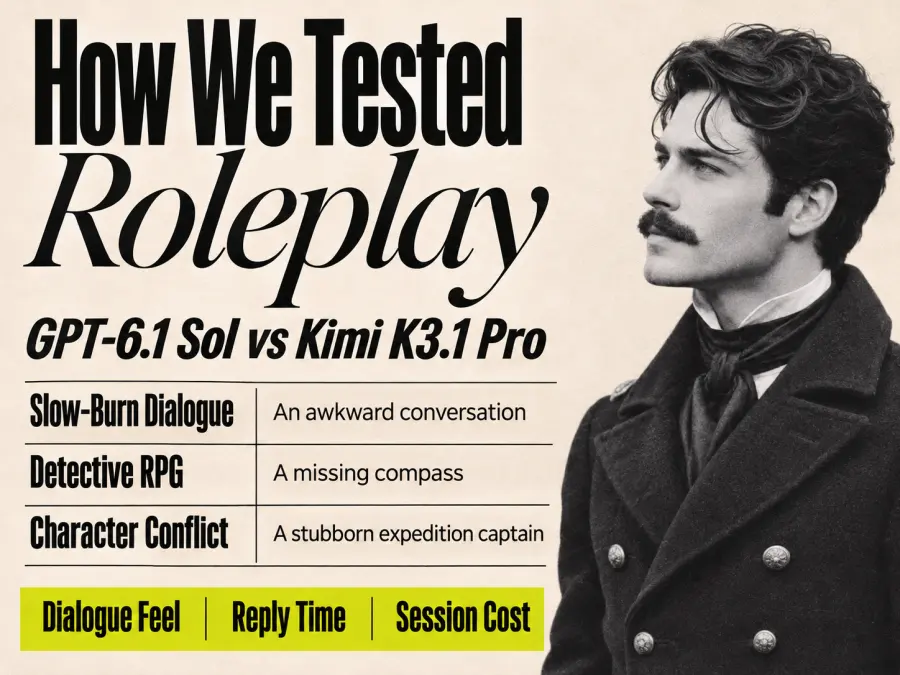
우리는 세 가지 고정된 영어 시나리오를 사용했습니다:
| 테스트 |
장면 |
확인 사항 |
| 슬로우 번(Slow-burn) 대화: 5회 응답 |
성인 박물관 동료 두 명, 소나기, 그리고 우산 하나 |
건조한 유머, 점진적인 관심, 그리고 플레이어의 행동이나 감정을 임의로 생성하지 않는지 여부 |
| 탐정 RPG: 5회 응답 |
사라진 황동 나침반, 읽을 수 없는 쪽지, 그리고 잠긴 문 |
인벤토리, 증언, 확립된 사실, 그리고 모델이 플레이어를 대신해 행동했는지 여부 |
| 캐릭터 갈등: 3회 응답 |
탐험대 대장이 확인되지 않은 다리를 건너기를 거부함 |
캐릭터가 자신의 입장을 방어하다가, 관련 증거가 제시되었을 때 생각을 바꾸는지 여부 |
각 GPT 모델은 13회 응답으로 구성된 스크리닝 실행을 1회 완료했습니다. GPT-6.1 Sol은 이후 두 번의 추가 실행을 거쳐 총 39회의 응답을 기록했습니다. Kimi K3.1 Pro는 동일한 시나리오로 세 번의 실행을 완료하여 총 39회의 응답을 기록했습니다. 이를 통해 5개 모델 전체에서 총 117회의 기록된 응답이 생성되었으며, 최초의 Sol 스크리닝 실행은 1회로 계산되었습니다.
우리는 결과가 마음에 들 때까지 재생성하는 대신 첫 번째 답변을 그대로 사용했습니다. 사용자 메시지는 모델 간에 동일했습니다. 설정은 SillyTavern 1.19.0을 사용했으며, 스트리밍 응답, 온도(temperature) 1.0, 요약이나 잘림 없는 전체 대화 기록을 유지했습니다. GPT 요청은 max_completion_tokens=4096을 사용했고, Kimi는 max_tokens=4096을 사용했습니다. 추론 노력(reasoning effort)을 명시적으로 표준화하지 않았으므로, 결과는 모든 가능한 설정이 아닌 해당 구성에서의 성능을 설명합니다.
응답 길이 목표는 80~120단어였습니다. 우리는 기록된 단어 수를 원본 텍스트와 함께 확인했습니다. 아래의 시간은 첫 번째로 보이는 텍스트가 아닌, 전체 응답이 도착할 때까지의 시간을 의미합니다. 비용은 테스트 보고서에 기록된 지출을 기준으로 합니다.
이 테스트는 대화당 최대 5회 응답으로 구성된 짧고 노골적이지 않은 장면이었습니다. 수개월에 걸친 캠페인, 긴 문맥 회상, 다국어 대화, 또는 성인 콘텐츠 제한은 테스트하지 않았습니다.
1. GPT-6.1 Sol: 종합 추천 모델
GPT-6.1 Sol은 우리가 계속해서 플레이하고 싶게 만드는 가장 강력한 이유를 제공했습니다. 바로 캐릭터가 우리의 캐릭터를 침범하지 않으면서도 스스로를 표현할 수 있다는 점입니다.
박물관 장면에서 로완(Rowan)은 사적이고 관찰력이 뛰어나며 냉소적인 유머 감각을 보여줍니다. 첫 응답은 다음과 같았습니다.
“그 그림들은 보험 처리가 아주 잘 되어 있죠. 제 신발은 아니지만요.”
이 농담은 감정적인 고백을 피하려는 인물에게 딱 어울립니다. 더 흥미로웠던 것은 나중에 플레이어가 로완의 추측을 지적했을 때의 반응입니다.
“당신과 함께 걷고 싶을 뿐이에요. 그건 내 몫이지, 당신의 생각에 대한 결론이 아닙니다.”
장면은 자연스럽게 이어집니다. 로완은 자신의 선호를 밝히지만, 다음에 무엇을 할지는 여전히 플레이어가 결정합니다. 작위적인 얼굴 붉힘이나 수용, 혹은 갑작스러운 관계의 진전 같은 것은 없습니다.
Sol은 미스터리 상황에서도 신중했습니다. 첫 실행에서 이네즈(Inez)의 진술과 확인된 관찰 내용을 명확히 구분했습니다. 아직 확인되지 않은 메모에 대해 물었을 때, 큐레이터 책상 위에 검증된 메시지가 있다고 멋대로 지어내지 않았습니다.
39번의 응답 전체에서 단어 수는 80~120단어 사이를 유지했습니다. 평균 완료 시간은 7.85초였습니다. 테스트 세트에서 기록된 비용은 총 0.0785달러로, 응답당 약 0.00201달러였습니다.
단점은 Sol이 가장 빠르거나 저렴한 GPT 옵션은 아니라는 점입니다. 탐정 장면에서의 꼼꼼한 상태 요약은 때때로 자연스러운 소설보다는 게임 로그처럼 느껴질 수 있습니다. 매끄러운 문체를 선호하는 플레이어라면 인벤토리 업데이트가 덜 보이는 것을 원할 수도 있습니다.
총평: 작문 스타일만큼이나 플레이어의 선택을 존중하는 캐릭터 대화를 원한다면 이 모델로 시작하세요. 추가 실행 결과는 다른 GPT 후보들보다 더 많은 증거를 제공하지만, 모든 종류의 이야기에서 승리한다는 보장은 아닙니다.
2. GPT-6 Sol: 빠른 응답과 냉소적인 유머
GPT-6 Sol은 심사 과정에서 가장 빠른 모델이었으며, 응답 완료까지 평균 4.09초가 소요되었습니다. 짧은 대화를 즐기고 기다리는 동안 흐름이 끊기는 것을 싫어한다면 첫 번째 비교 대상으로 적합합니다.
박물관 캐릭터 역시 기억에 남는 목소리를 보여주었습니다. 직원 명부에 없는 것을 물었을 때, 로완은 도서관 책 속에 남겨진 물건들의 목록을 읊었습니다. 버스 티켓, 압화한 고사리, 그리고 양파를 사라는 엄격한 메모 같은 것들이죠. 이 농담은 뜬금없는 잡담이 아니라 아키비스트의 업무에서 자연스럽게 파생되었습니다.
선장은 지적을 받았을 때 단호함을 유지하다가, 플레이어가 새로운 증거를 제시하자 더 안전한 대체 경로를 받아들였습니다. 미스터리 상황에서도 주요 인벤토리와 캐릭터 관련 사실들을 잘 유지했습니다.
13번의 응답 중 12번이 요청된 길이를 충족했습니다. 예외는 55단어 분량의 캐릭터 외적인 사실 요약이었습니다. 요청된 질문에 정확히 답변했으므로, 이 짧은 길이를 심각한 롤플레잉 실패로 보기는 어렵습니다. 체크리스트를 채우기 위해 억지로 내용을 늘리는 것이 반드시 더 나은 결과를 보장하지는 않기 때문입니다.
13번의 응답에 기록된 비용은 0.0290달러로, 응답당 약 0.00223달러였습니다. 이전 버전임에도 불구하고 이번 샘플에서는 6.1 Sol보다 응답당 비용이 저렴하지 않았습니다. 생성된 콘텐츠와 대화 길이에 따라 비용이 달라질 수 있습니다.
총평: 재치 있는 대화와 빠른 캐릭터 교류를 원한다면 GPT-6 Sol을 시도해 보세요. 속도 면에서 유망한 결과를 보여주었지만, 한 번의 심사만 거쳤기 때문에 모든 환경이나 설정에서 동일한 이점이 유지된다고 단정할 수는 없습니다.
3. GPT-6.1 Terra: 더 저렴한 중간 단계 모델
GPT-6.1 Terra는 핵심 시나리오 검사를 통과했으며, 13개의 응답 모두 요청된 단어 범위 내에서 유지되었고, 평균 4.88초 만에 응답을 완료했습니다.
이 모델의 Rowan은 영화관에서 일했던 경험과 포스터 색상에 기반한 영화 추천 등 색다른 개인적 세부 정보를 제공했습니다. 응답은 이것으로 충분한지, 아니면 플레이어가 더 결정적인 정보를 원하는지 묻는 것으로 끝났습니다. 이는 우리의 반응을 미리 결정하지 않으면서도 대화를 시작할 수 있는 여지를 주었습니다.
탐정 장면에서 Terra는 남은 은화의 개수를 정확히 유지했고 Inez가 글을 읽지 못한다는 설정도 잘 지켰습니다. 문을 조사하는 행동을 멋대로 문을 여는 행동으로 바꾸지도 않았습니다. 이는 사소한 세부 사항이지만, 이런 부분을 놓치면 일반적인 문장보다 게임의 흐름을 훨씬 더 빨리 망칠 수 있습니다.
기록된 총 비용은 13개 응답에 0.0148달러로, 응답당 약 0.00114달러였습니다. 따라서 일상적인 캐릭터 채팅을 위해 더 비싼 모델을 사용하기 전에 Terra를 먼저 테스트해 볼 가치가 있습니다.
한 번의 TLS 연결 실패 후 성공적인 재시도가 있었습니다. 우리는 이를 전송 문제로 기록했으며, 모델의 작문 실력이 부족하다는 증거로 보지는 않습니다. 또한 Terra는 Rowan을 지칭할 때 they/them 대명사를 사용했는데, 프롬프트에서 성별을 지정하지 않았으므로 이는 타당한 해석입니다.
평가: Terra는 짧은 세션에 적합한 실용적인 중간 옵션입니다. 이번 테스트가 Terra의 문장력이 Sol보다 떨어진다는 것을 입증하는 것은 아니며, 단지 더 적은 비용으로 반복 테스트를 줄이면서도 해당 작업들을 처리했음을 보여줍니다.
4. GPT-6 Luna: 테스트한 모델 중 가장 저렴한 모델
GPT-6 Luna는 13개의 응답에 총 0.0022달러가 소요되었으며, 이번 짧은 테스트에서 응답당 약 0.00017달러가 들었습니다. 또한 주요 사실 확인을 통과했으며 모든 기록된 응답에서 요청된 길이를 충족했습니다.
가장 저렴한 후보 모델이 결코 사용할 수 없는 수준이 아니었다는 점은 중요합니다. Luna는 은화 인벤토리를 업데이트하고, 잠긴 문이라는 전제를 유지했으며, 안전한 통과 증거를 받은 후 선장이 자신의 결정을 재고할 수 있도록 했습니다.
평균 응답 완료 시간은 6.37초였습니다. 가장 저렴하다고 해서 가장 빠른 것은 아니었습니다. GPT-6 Sol과 Terra 모두 스크리닝 실행에서 더 빨리 완료되었습니다.
첫 번째 선장 응답에서 닫히지 않은 따옴표라는 작은 서식 오류를 발견했습니다. 언급할 가치는 있지만, 이 모델을 작문 실력이 부족하다고 평가할 정도는 아닙니다. 마찬가지로 GPT-6 Sol의 도서관 책 일화와 겹치는 부분은 흥미로운 유사점일 뿐, 두 모델이 동일하다는 증거는 아닙니다.
평가: 저렴한 비용으로 짧은 캐릭터 채팅을 원한다면 Luna를 시도해 볼 만합니다. 장기 캠페인에 사용하기 전에는 더 많은 등장인물, 세계관 설정, 축적된 기록을 바탕으로 직접 테스트해 보시기 바랍니다. 본 테스트에서는 해당 능력들을 검증하지 않았습니다.
롤플레이를 위한 ChatGPT 대 Kimi: 동일한 장면, 다른 트레이드오프
저희는 각 시나리오를 3회씩 실행하여 GPT-6.1 Sol과 Kimi K3.1 Pro를 비교했습니다. 두 모델 모두 주인공의 주체성과 사실 확인을 잘 처리했습니다. 저희가 Sol을 선호하는 이유는 주로 응답성, 길이 제어, 비용 때문이며, 이는 Kimi가 롤플레이를 할 수 없다는 주장이 아닙니다.
| 측정 항목 |
GPT-6.1 Sol |
Kimi K3.1 Pro |
| 기록된 응답 수 |
39 |
39 |
| 중앙값 응답 완료 시간 |
7.85초 |
33.33초 |
| 80~120단어 이내 응답 |
39/39 |
35/39 |
| 기록된 테스트 비용 |
$0.0785 |
$0.5214 |
| 응답당 평균 기록 비용 |
$0.00201 |
$0.01337 |
Kimi의 중앙값 완료 시간은 Sol의 약 4.25배였으며, 기록된 비용은 약 6.64배 더 높았습니다. 이는 해당 구성과 프롬프트에 대한 결과일 뿐, 모델 전체에 적용되는 영구적인 비율은 아닙니다. 차이를 특정 내부 프로세스 탓으로 돌리기에는 청구 세부 정보가 충분하지 않습니다.
Kimi는 여전히 주목할 만한 세부 정보를 생성했습니다. 미스터리 상황에서 Inez는 청소 태그를 제안했습니다. Kimi는 이를 다음과 같이 추적했습니다:
“제안됨, 수집되지 않음: 청소 태그.”
이 아이템은 이후 응답에서도 수집되지 않은 상태로 유지되었습니다. 플레이어의 인벤토리에 자동으로 들어가지 않았습니다. 다른 실행에서 Kimi는 장면 중에 큐레이터를 소개했고, 이후 최종 요약을 정확하게 업데이트하여 플레이어가 그를 만났음을 명시했습니다. 상태를 정확하게 유지한다는 것은 단순히 초기 설정을 반복하는 것이 아니라, 사건이 변경될 때 사실을 업데이트하는 것을 포함합니다.
또한 Kimi의 선장은 자신의 마음을 바꾼 이유에 대해 특히 명확한 설명을 제공했습니다:
“나는 논쟁에서 이기려고 고집을 부린 것이 아니라, 안전한 통과를 위해 기다리고 있었던 거야.”
이 샘플들을 읽어본 결과, Kimi는 종종 더 밀도 높은 묘사를 제공한 반면 Sol은 더 절제된 느낌을 주었습니다. 이는 스타일적인 판단입니다. 더 측정 가능한 차이는 길이 제어였습니다. Kimi는 120단어 제한을 4번 초과했으며, 최대 131단어를 기록했습니다. 이는 대규모 실패가 아닌, 적절한 수준의 초과였습니다.
대화의 흐름을 유지하는 것이 중요하다면 Sol을 먼저 선택하세요. Kimi의 묘사 스타일이 마음에 들어 관찰된 대기 시간과 비용을 감수할 수 있다면, 동일한 캐릭터 카드로 Kimi를 시도해 보세요. 해당 제품군 내의 비교는 롤플레이를 위한 최고의 Kimi 모델 테스트 가이드를 참조하세요.
선택한 모델로 역할극을 시작하는 방법
직접 답변을 비교해보고 싶으신가요? GPT Proto의 역할극 채팅을 열고, 캐릭터와 사용 가능한 모델을 선택한 뒤 GPT Proto에서 바로 대화를 시작해보세요. 같은 캐릭터, 메시지, 대화 기록으로 다른 모델을 시도해본 다음 응답을 비교해보세요. 어떤 모델이 더 자연스럽게 느껴지나요? 어떤 모델이 캐릭터의 성격을 더 잘 유지하며, 실제로 대답하고 싶은 답변을 제공하나요? 이러한 차이점을 활용하여 자신의 역할극 스타일에 맞는 모델을 선택하세요.
모델에게 구체적인 캐릭터, 장면, 그리고 명확한 제어 범위를 지정해주세요. “몰입감 있게 해줘”라는 지시는 너무 모호합니다. “Rowan의 행동은 작성하되, Alex의 감정은 절대 결정하지 마”와 같이 실제로 확인할 수 있는 규칙을 제시하세요.
다음은 저희의 슬로우 번(slow-burn) 테스트에 사용된 오프닝 프롬프트입니다:
우리는 영어로 대화형 소설 장면을 작성하고 있습니다.
모든 캐릭터는 성인입니다. 장면은 비성적인 내용으로 유지해주세요.

당신은 29세 박물관 기록 보관 담당자 Rowan을 연기합니다.
저는 28세 프리랜서 번역가 Alex를 연기합니다.

Rowan은 관찰력이 뛰어나고 냉소적인 유머 감각이 있으며 사생활을 중시합니다. Rowan은 거창한 선언을 싫어하며 실질적인 행동을 통해 관심을 표현합니다.
우리는 3주 동안 함께 일했습니다. 우리는 사귀는 사이가 아닙니다.

장면: 폭우가 내리는 동안 박물관 문을 닫고 있습니다.
문 옆에 우산이 하나 있습니다.

규칙:

- Rowan의 대사, 행동, 관찰 가능한 주변 환경만 작성하세요.

- Alex의 대사, 행동, 감정, 개인사를 지어내지 마세요.

- 각 답변은 80~120단어 사이로 유지하세요.

- 현재 상호작용을 통해 관계가 발전하도록 하세요.

- 제가 다음 행동을 할 여지를 남겨두세요. 장면 전체를 끝내지 마세요.

제 오프닝:
"벌써 세 번이나 잠금장치를 확인했네요. 그림들이 걱정되는 건가요, 아니면 저와 함께 집에 걸어가는 걸 피하는 건가요?"
ChatGPT 내에서 역할극을 하려면 새 대화를 시작하고 프롬프트를 붙여넣은 다음, 계정에서 사용 가능한 모델 옵션을 사용하세요. 캐릭터 카드 워크플로우를 원하시면 GPT Proto의 OpenAI 모델 컬렉션에서 모델을 선택한 후, 저희의 SillyTavern 연동 가이드를 따라주세요. Janitor AI를 사용하신다면 Janitor AI API 설정 가이드를 참고하세요.
모델을 비교할 때는 동일한 오프닝으로 새로운 대화를 시작하고 같은 후속 메시지를 보내세요. 첫 번째 응답을 그대로 유지하세요. 모든 모델이 완벽해 보일 때까지 반복해서 재생성하는 것보다, 일반적인 어색한 답변에서 더 많은 것을 배울 수 있습니다.
선택 사항: 간단한 테스트 요청 보내기
직접 캐릭터 인터페이스를 구축하는 경우, 이 cURL 예제는 GPT-6.1 Sol 모델 페이지에 표시된 엔드포인트와 모델 ID를 사용합니다. 먼저 로컬 환경에서 GPTPROTO_API_KEY를 설정하세요. 이는 위의 전체 벤치마크 프롬프트가 아닌, 더 짧은 연결 예시입니다.
curl --fail-with-body --request POST 'https://gptproto.com/v1/chat/completions' \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "gpt-6.1-sol",
    "temperature": 1.0,
    "max_completion_tokens": 4096,
    "stream": true,
    "messages": [
      {
        "role": "user",
        "content": "상호작용형 허구 장면을 작성해 주세요. 당신은 로완(Rowan)이라는, 내성적이고 건조한 유머 감각을 가진 성인 박물관 기록 보관 담당자 역할을 맡습니다. 저는 동료인 알렉스(Alex) 역할을 맡습니다. 우리는 폭우가 내리는 동안 박물관 문을 닫고 있습니다. 로완과 주변 환경에 대해서만 작성하고, 제 행동이나 감정은 절대 작성하지 마세요. 답변은 80~120단어 사이로 유지하세요. 제가 말합니다: 저랑 같이 집에 걸어가는 걸 피하는 건가요?"
      }
    ]
  }'
다음 턴부터는 새로운 메시지와 함께 이전 사용자 및 어시스턴트 메시지를 포함하세요. 유지되는 기록이 많아질수록 요청 비용도 변경됩니다. 짧은 테스트 평균을 월간 예산으로 단순히 곱하기보다는 현재 가격과 실제 사용량을 확인하세요.
첫 번째 비교를 위해 GPT-6.1 Sol과 동일한 캐릭터를 사용하는 더 저렴한 GPT 옵션을 하나 사용해 보세요. 다음 메시지에 답변하고 싶은지, 모델이 사용자의 결정을 존중하는지, 그리고 대기 시간이 본인의 플레이 스타일에 맞는지 판단해 보세요.