Qwen 4 Max 개요: "Qoduck" 블라인드 테스트부터 14일간의 프리뷰까지
Qwen 4 Max에 대한 실질적인 개요를 알고 싶다면, 이름이 공개되기 전 4일 동안의 기록부터 살펴보세요. 2026년 11월 7일부터 11월 10일 사이, Qoduck이라는 코드명의 익명 모델이 에이전트형 코딩 IDE인 Qoder 내에 등장했습니다. Qoduck을 테스트하던 개발자들은 독특한 패턴을 발견했습니다. 모델이 빠르게 단일 패스 코드 스니펫을 반환하고 사람의 피드백을 기다리는 대신, 10~15분 동안 셸 검사를 실행하고, 처음부터 사용자 지정 SVG 에셋을 작성하며, 최종 답변을 반환하기 전에 자체 diff에 대해 단위 테스트를 수행하는 데 시간을 할애한 것입니다.
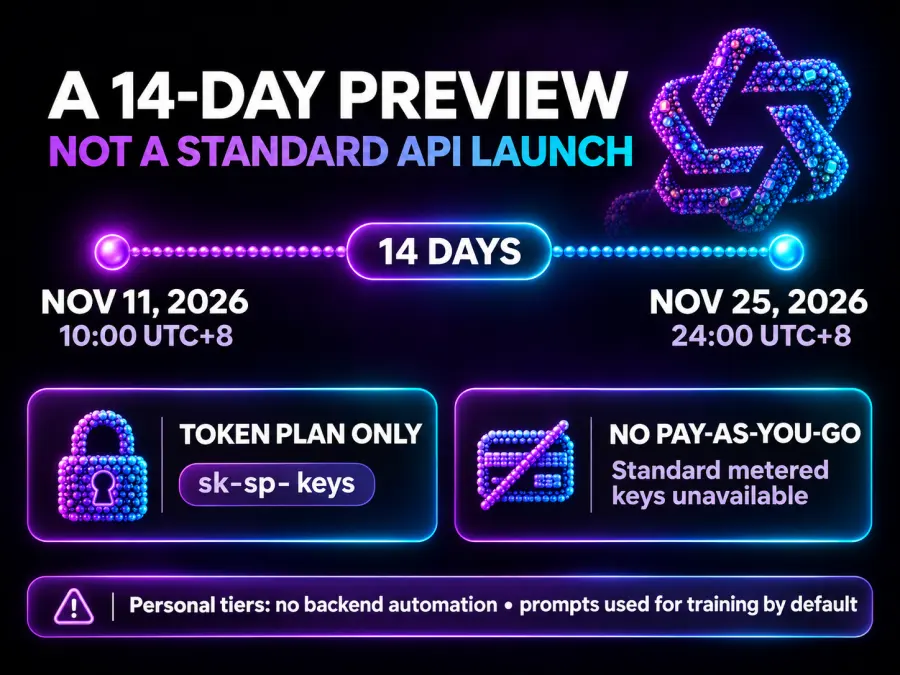
2026년 11월 11일 10:00(UTC+8), 알리바바는 Qoduck이 알리바바의 최신 모델인 Qwen 4 Max임을 확인하고, Alibaba Cloud Model Studio에서 모델 문자열 qwen4-max-preview(일부 클라이언트 구성에서는 qwen4.0-max-preview로 참조됨)로 공개했습니다. 알리바바는 토큰당 정가제를 적용한 본격적인 상용 출시 대신, 개발자 문서에서 흔히 언급되는 '14일간의 Qwen 4 Max 프리뷰'를 통해 Qwen 4 Max를 도입하는 방식으로 롤아웃을 구성했습니다. 이는 Claude Code, Cursor, Cline, Qoder와 같은 개발자 도구 내의 에이전트 워크플로우를 스트레스 테스트하기 위해 설계되었습니다.
| 사양 |
확인된 상태 (qwen4-max-preview) |
출처 / 엔지니어링 노트 |
| 공식 모델 ID |
qwen4-max-preview |
Alibaba Cloud Model Studio / Bailian 문서 |
| 미리보기 기간 |
2026년 11월 11일 (10:00) – 2026년 11월 25일 (24:00 UTC+8) |
엄격한 14일 제한 미리보기 |
| 컨텍스트 윈도우 |
1,000,000 토큰 (최대 입력: 967,000 토큰) |
중국 및 국제 문서에서 검증됨 |
| 최대 출력 토큰 |
총 393,216 (최종 출력 131,072 + 추론 262,144) |
max_tokens는 사고 및 출력 합계를 제한함 |
| 입력 / 출력 모달리티 |
입력: 텍스트, 이미지, 비디오 · 출력: 텍스트 |
미리보기 경로에서 기본 오디오 입력 지원 안 함 |
| 추론 제어 |
reasoning_effort: low, medium, xhigh |
사고(Thinking) 기능 기본 활성화; 기본값은 xhigh |
| 지원되는 API 프로토콜 |
OpenAI Chat Completions, Responses API, Anthropic Messages |
전용 sk-sp- 토큰 플랜 엔드포인트 필요 |
| 파라미터 크기 및 가중치 |
공개되지 않음 (비공개 상업용 미리보기) |
온라인상의 2.4T / 95B 수치는 Qwen3.8-Max의 것임 |
| 공식 벤치마크 표 |
미리보기 출시 시점에 게시되지 않음 |
유통되는 49.9 GameFeel 점수는 Qwen-4-Flash-Early |
qwen 4 max에 대한 설명을 세대적 도약으로 이해하는 것은 추론 시점에 컴퓨팅 자원을 어떻게 사용하는지에 달려 있습니다. 이전 버전들이 도구 호출을 선택적인 보조 기능으로 취급했던 것과 달리, 핵심적인 qwen 4 max 업그레이드는 기본 추론 과정에 자체 검증 루프를 내장했습니다. 웹 애플리케이션을 구축하거나 명령줄 유틸리티를 수정하라는 요청을 받으면, 이 모델은 디렉터리 트리를 검사하고, pytest 또는 로컬 헤드리스 브라우저를 실행하며, 자체적인 구문이나 레이아웃 오류를 포착하고, 사용자가 결과물을 보기 전에 손상된 라인을 다시 작성하는 등 수십 개의 도구 호출을 일상적으로 연결합니다.
아키텍처, 모델 크기 및 벤치마크 현실 점검
현재 qwen 4 max size 및 qwen 4 max benchmark에 대한 검색 결과에는 두 가지 잘못된 정보가 지배적입니다. 이를 바로잡는 것이 Alibaba가 실제로 출시한 것과 공개되지 않은 것이 무엇인지 파악하는 가장 빠른 방법입니다.
첫째, Alibaba는 alibaba qwen 4 max의 전체 또는 활성 파라미터 수를 공개하지 않았습니다. 여러 타사 블로그에서는 이를 토큰당 950억 개의 활성 파라미터를 가진 2.4조 파라미터 규모의 MoE(Mixture-of-Experts) 모델로 기재하고 있습니다. 해당 수치는 2026년 9월에 출시된 이전 플래그십 모델인 Qwen3.8-Max의 정보입니다. Qwen 4 Max가 100만 토큰의 컨텍스트 윈도우를 경제적으로 처리하기 위해 희소(sparse) MoE 백본을 사용할 가능성은 매우 높지만, 2026년 11월 현재 언급되는 특정 조 단위 파라미터 수치는 3.8 세대에서 잘못 전달된 검증되지 않은 정보입니다.
아키텍처 측면에서 우리가 알 수 있는 정보는 Alibaba가 2026년 8월에 기술적으로 공개한 Qwen3.8-Flash-Next에서 비롯됩니다. Qwen 팀은 이 모델을 Qwen 4 시리즈의 핵심 아키텍처 업그레이드를 검증하기 위한 테스트베드로 명시했습니다. 해당 선행 보고서에는 qwen4-max-preview가 어떻게 100만 토큰 규모의 워크로드를 처리하는지 설명하는 네 가지 구조적 변경 사항이 기록되어 있습니다:
하이브리드 GDN + QSA 어텐션: Gated DeltaNet(GDN) 선형 어텐션 레이어와 Qwen Sparse Attention(QSA)을 결합하여 1,000,000 토큰 컨텍스트에서의 첫 토큰 생성 시간(TTFT) 프리필 지연 시간을 표준 전체 어텐션 대비 최대 7.6배 단축했습니다.
4-스트림 게이트 잔차 연결: 학습된 게이트를 통해 잔차 스트림 폭을 확장함으로써 심층적인 다단계 추론 과정에서 그래디언트 흐름과 레이어 간 특징 라우팅을 개선했습니다.
N-그램 임베딩 레이어: 임베딩 단계에서 다중 토큰 로컬 컨텍스트를 직접 주입하여 초기 어텐션 블록의 어휘 패턴 매칭 부하를 줄였습니다.
Muon 옵티마이저 학습: 대규모 사전 학습 최적화를 Muon으로 전환하여 코드 및 형식 논리 말뭉치에 대한 샘플 효율성을 개선했습니다.
둘째, qwen 4 max benchmark 결과를 검색하면 Qwen 4 Max가 GameFeel Bench v1.4에서 49.9점을 기록하여 47.2점인 Claude Opus 5.5를 앞섰다는 주장을 접하게 될 것입니다. 리더보드와 기본 커밋 로그를 확인한 결과, 해당 49.9점은 Qwen-4-Flash-Early(내부 코드명 hawk)라는 초기 경량 테스트 체크포인트가 기록한 것이며, qwen4-max-preview의 점수가 아닙니다. 2026년 11월 13일 기준으로 Alibaba는 Qwen 4 Max에 대한 공식 MMLU-Pro, SWE-bench Verified 또는 AIME 리더보드 표를 발표하지 않았습니다.
현재 검증 가능한 것은 qwen 4 max context window의 메커니즘과 출력 예산이며, 이 부분에서 마이그레이션하는 개발자들이 어려움을 겪고 있습니다. 컨텍스트 윈도우는 1,000,000 토큰(문서상 프롬프트 제한은 967,000 토큰)을 수용하지만, 최대 출력은 국제 포털에 393,216 토큰으로 기재되어 있으며, 국내 포털에서는 이를 262,144개의 추론 토큰과 131,072개의 최종 답변 토큰으로 세분화하고 있습니다.
주의할 점이 있습니다. max_tokens API 매개변수는 qwen4-max-preview에서 sum 즉, reasoning_content와 content의 합계를 제어합니다. 이 모델은 기본적으로 reasoning_effort: "xhigh"(사용 가능한 세 가지 설정인 low, medium, xhigh 중 가장 높은 단계)로 설정되어 있기 때문에, 복잡한 코딩 프롬프트는 숨겨진 사고 블록 내에서 15,000에서 40,000 토큰을 쉽게 소모할 수 있습니다. 기존 클라이언트 코드에서 max_tokens: 4096 또는 8192를 전달하면, 모델이 사고 도중에 할당량을 모두 소진하여 빈 content 문자열을 반환하게 됩니다. 이러한 자동 잘림 현상을 방지하려면 max_tokens 값을 65,536 이상으로 높이거나, 일상적인 작업의 경우 reasoning_effort를 medium으로 명시적으로 낮추십시오.
Qwen 4 Max 실사용 리뷰: 커뮤니티와 미디어 테스트가 실제로 보여주는 것
Alibaba가 전통적인 벤치마크 보도 자료를 생략했기 때문에, 가장 신뢰할 수 있는 qwen 4 max 리뷰 데이터는 프리뷰 첫 48시간 동안 qwen4-max-preview를 라이브 에이전트 하네스에 연결한 엔지니어링 팀들로부터 나옵니다. 그들의 로그는 명확한 패턴을 보여줍니다. 출력 품질이 향상될 때마다 눈에 띄는 지연 시간과 토큰 비용 증가가 동반된다는 것입니다.
11월 11일, 일본의 AI 컨설팅 업체 WEEL은 Claude Code 내에서 프론트엔드 합성, 다중 소스 조사, 리포지토리 수준 디버깅 전반에 걸쳐 프리뷰 모델을 테스트한 3부작 평가를 발표했습니다:
908줄 커스텀 SVG 랜딩 페이지 (vs Qwen 3.8 Max): 산림 테마의 물리 치료 클리닉을 위한 반응형 랜딩 페이지를 구축하라는 동일한 프롬프트를 받았을 때, Qwen3.8-Max는 약 9.5분 만에 완료했지만 그리드를 깨뜨리거나 로드에 실패하는 무작위 외부 스톡 사진을 가져왔습니다. qwen4-max-preview는 거의 두 배인 약 17분이 소요되었습니다. 불안정한 외부 URL을 연결하는 대신, 백그라운드에서 코드 인터프리터를 수십 번 호출하여 숲의 캐노피, 클리닉 건축물, 직원 아이콘 등을 프로그래밍 방식으로 직접 SVG 일러스트레이션으로 그려냈고, 깨진 에셋이 하나도 없는 908줄의 HTML 파일을 제공했습니다.
Claude Code에서의 자율 CLI 디버깅 (36/36 테스트 통과): WEEL은 Claude Code(qwen4-max-preview를 Anthropic 호환 엔드포인트를 통해 구동)를 로컬 파이썬 가계부 CLI(kakeibo)에 연결하고, --export-csv 및 --month 필터링 플래그와 단위 테스트를 추가하도록 요청했습니다. 실행 시간은 11분 48초가 걸렸습니다. 초기 구현을 작성한 후, 모델은 pytest를 실행하여 2개의 실패 테스트를 잡아냈습니다. 여기에는 -100일원과 같은 음수 통화 문자열이 파이썬의 argparse에 의해 명령줄 플래그로 잘못 해석되는 엣지 케이스가 포함되었으며, 모델은 스스로 파서를 수정했습니다. 또한 별도의 지시 없이도 Microsoft Excel에서 일본어 문자가 깨지지 않도록 utf-8-sig BOM 헤더를 앞에 추가하고, CSV 수식 삽입을 차단하기 위해 선행 =, +, -, @ 문자를 이스케이프 처리했습니다. 36개 테스트 모두 통과했으며, 월간 Lite 플랜 할당량의 0.4%만 소비했습니다.
자체 검증 정책 조사: 2026년 일본 중소기업 보조금 비교표를 작성하라는 과제를 받았을 때, 모델은 2분 동안 부처 포털 전반에서 12개 이상의 웹 쿼리를 실행하고, 5분 동안 grep 및 파이썬 검증 스크립트를 실행하여 Markdown 테이블 열이 어긋나지 않았는지 확인한 후 8분 만에 결과를 제시했습니다.
이틀 후인 11월 13일, 중국 기술 매체 Silicon Star(GuiXingRen)는 qwen4-max-preview를 대상으로 시각 및 3D 엔지니어링 테스트를 진행했습니다. 고전적인 "자전거를 타는 펠리컨" SVG 애니메이션을 생성하라는 프롬프트를 받았을 때, 모델은 페달 동작과 시차를 둔 나무 그림자를 표현하면서, 요청하지 않은 0.5배~1.75배 속도 조절 슬라이더와 낮/황혼/밤 테마 전환 기능을 추가했습니다. 더 어려운 Three.js 테스트인 Paper Skies라는 플레이 가능한 3D 종이비행기 게임(비행기가 침실 창문을 통해 정원으로 날아가는 게임)을 구축하는 테스트에서, 리뷰어들은 물리 엔진과 장애물 처리가 Anthropic의 창의성 중심 모델인 Claude Fable 5.1과 대등하다고 평가했으나, 셰이더 완성도 면에서는 최신 Claude Fable 5.2에 다소 뒤처진다고 언급했습니다. Silicon Star의 자체 반응형 홈페이지를 재설계하라는 요청을 받았을 때, 모델은 로컬 브라우저를 실행하여 외부 기사 썸네일이 403 핫링크 오류를 반환하는 것을 발견하고, 이를 스타일이 적용된 SVG 그라데이션 플레이스홀더로 자동 교체했으며, 5분 만에 2차 편집 레이아웃 수정까지 완료했습니다.
X(구 트위터)와 일본 개발자 포럼에 올라온 개발자 피드백은 모든 qwen 4 max 기능 하이라이트에 중요한 뉘앙스를 더해줍니다. 개발자 @round_boys는 해당 모델이 Java와 Three.js를 사용하여 완전한 3D 장면을 한 번에 렌더링하는 모습을 시연했지만, 실행 시 약 69,000개의 토큰이 소모되었다고 언급했습니다. 원시 처리량을 측정한 다른 초기 사용자들은 기본 xhigh 설정에서 스트리밍 속도가 초당 약 33토큰 정도라고 보고했으며, 강화 학습(RL) 도구 사용 궤적이 때때로 간단한 파일 읽기 작업에서 지나치게 복잡하게 생각하는 경향이 있다고 지적했습니다. 이는 -preview 접미사가 말 그대로의 의미임을 상기시켜 줍니다.
Qwen 4 Max 가격, 토큰 플랜 규칙 및 프로덕션 차단 요소
표준적인 "입력 토큰 100만 개당 $X" 형태의 표를 기대하며 qwen 4 max 가격을 찾아보신다면, 그런 표는 찾으실 수 없을 것입니다. Alibaba는 qwen4-max-preview에 대해 종량제(pay-as-you-go) 방식의 요금제를 제공하지 않습니다. 요청을 보낼 수 있는 유일한 방법은 활성화된 Alibaba Cloud Model Studio 토큰 플랜 구독(이전 명칭: 코딩 플랜)을 이용하는 것뿐이며, 이는 토큰당 실제 달러 금액이 아닌 추상적인 월간 "크레딧"으로 청구됩니다.
국제 QwenCloud 포털에서 토큰 플랜은 개인용 및 팀용 티어로 나뉩니다:
라이트 플랜(신규 사용자 첫 달 3달러): 월 20,000 크레딧이 포함되며, 5시간 단위로 1,200 크레딧, 주 단위로 9,000 크레딧이라는 엄격한 롤링 제한이 적용됩니다.
프로 플랜(첫 달 15달러): 월 100,000 크레딧이 포함되며, 5시간 단위로 6,000 크레딧, 주 단위로 45,000 크레딧으로 제한됩니다. (Alibaba의 중국 내수용 포털에서는 라이트 및 프로 플랜이 각각 월 39위안, 199위안으로 책정되어 있으며, 첫 달 반값 프로모션으로 각각 19.5위안, 99.5위안에 제공됩니다.)
14일 프리뷰 할인(2026년 11월 11일~11월 25일): 2주간의 프리뷰 기간 동안 주간 호출(08:00~22:00 UTC+8)은 표준 크레딧 가중치의 20%만 소비하며, 야간 비피크 시간대 호출(22:00~08:00 UTC+8)에는 추가로 80% 할인이 적용되어 실제 크레딧 소모량이 일반 요금의 4% 수준으로 낮아집니다.
3달러의 비용으로 야간에 IDE에서 작업하는 개인 개발자에게는 이 프로모션 가격이 매우 매력적일 수 있습니다. 하지만 제품을 구축하거나 자동화된 CI/CD 에이전트를 운영하는 엔지니어링 팀의 경우, 토큰 플랜에는 다음과 같은 세 가지 심각한 프로덕션 차단 요소가 존재합니다:
백엔드 자동화 및 API 통합 금지: Alibaba의 토큰 플랜 약관은 개인용 라이트 및 프로 키(sk-sp-)를 지원되는 IDE 플러그인 내에서 사람이 직접 트리거하는 대화형 코딩 용도로만 제한합니다. 구독 키를 사용하여 자동화된 백엔드 스크립트, 고객용 SaaS 기능 또는 배치 데이터 파이프라인을 구동하는 것은 서비스 약관 위반이며 계정 정지 사유가 됩니다.
개인 티어의 데이터 학습 의무화: 토큰 플랜 규칙에 따라 개인용 라이트 및 프로 구독의 모든 프롬프트, 저장소 컨텍스트 및 모델 완성 결과는 기본적으로 Alibaba의 모델 학습 개선 프로그램에 포함되며, 이를 거부할 수 있는 설정은 없습니다. 오직 엔터프라이즈 팀 플랜(좌석당 월 40달러)만이 데이터 보존 금지/학습 제외를 보장합니다.
5시간 롤링 속도 제한 및 11월 25일 서비스 종료: 워크플로우가 완전히 내부적인 것이라 하더라도, 5시간마다 1,200 크레딧이라는 롤링 제한은 여러 개발자의 동시 요청을 감당할 수 없으며, qwen4-max-preview 엔드포인트는 2026년 11월 25일 24:00(UTC+8)에 종료될 예정입니다.
모델 간 비교: Qwen 4 Max vs Qwen 3.8 Max, Kimi K3.1 Pro, GLM-5.3 및 Claude Opus 5.5
현재 qwen4-max-preview를 프로덕션 백엔드에 직접 연결할 수 없기 때문에, 모든 비교 쿼리의 핵심은 구독 제한이나 데이터 학습 노출 없이 동일한 1M 컨텍스트 에이전트 워크로드를 처리할 수 있는 종량제 플래그십 모델이 무엇인지 확인하는 것입니다.
| 모델 |
결제 및 가용성 |
컨텍스트 윈도우 |
최대 출력 |
지원되는 입력 모달리티 |
GPT Proto 종량제 요금 (1M당 입력/출력) |
Qwen4-Max-Preview (qwen4-max-preview) |
14일 프리뷰 전용 (11월 25일 종료); 토큰 플랜 구독 ($6–$30/월) |
1,000,000 |
393,216 (262K CoT 포함) |
텍스트, 이미지, 비디오 |
호스팅되지 않음 (종량제 업스트림 API 없음) |
Qwen3.8 Max 0902 (qwen3.8-max-0902) |
프로덕션 종량제 |
1,000,000 |
65,536+ |
텍스트, 이미지, 비디오, 오디오, 문서 |
4.20 (공식 정가 대비 30% 할인) |
Kimi K3.1 Pro (kimi-k3.1-pro) |
프로덕션 종량제 |
1,048,576 (1.05M) |
131,072 |
텍스트, 이미지, 문서 |
10.00 ($0.20 캐시된 입력) |
GLM-5.3 (glm-5.3) |
프로덕션 종량제 |
1,050,000 (1.05M) |
128,000 |
텍스트, 이미지, 문서 |
3.74 (공식 정가 대비 15% 할인) |
Claude Opus 5.5 (claude-opus-5-5) |
프로덕션 종량제 |
1,000,000 |
128,000 |
텍스트, 이미지, 문서 |
18.00 (공식 정가 대비 10% 할인) |
Qwen 4 Max vs Qwen 3.8 Max
qwen 4 max vs qwen 3.8 max를 평가할 때 고려해야 할 상충 관계는 자율 검증 시간과 프로덕션 안정성 및 더 넓은 모달리티 지원 사이의 선택입니다. WEEL의 17분 대 9.5분 랜딩 페이지 테스트에서 입증되었듯이, Qwen 4 Max는 백그라운드 Python 검사를 실행하고 사용자 지정 SVG를 합성하는 데 두 배의 시간을 할애할 의향이 있습니다. 그러나 qwen4-max-preview는 프리뷰 경로에서 기본 오디오 및 문서 파일 파싱을 지원하지 않으며 토큰 단위로 호출할 수 없습니다.
귀하의 파이프라인이 이미 Alibaba의 프롬프트 형식, 다국어 토큰화 또는 멀티모달 비전에 의존하고 있다면, qwen3.8-max-0902가 현재 바로 사용할 수 있는 프로덕션용 플래그십 모델입니다. 이 모델은 동일한 1,000,000 토큰 컨텍스트 윈도우를 제공하며 텍스트, 이미지, 비디오, 오디오 및 문서 입력을 모두 허용합니다. GPT Proto에서 qwen3.8-max-0902는 1M 출력 토큰당 4.20의 비용으로 실행되며(Alibaba 공식 정가 대비 30% 저렴), Qwen 모델 허브에서 더 작은 오픈 가중치 모델들과 함께 비교해 볼 수 있습니다.
Qwen 4 Max 대 Kimi K3.1 Pro
Silicon Star의 11월 13일 Blender MCP 및 WebGL 벤치마크에서 qwen 4 max vs kimi k3.1 pro 대결을 정면으로 테스트한 결과, 두 모델의 차이는 매우 명확했습니다. Qwen 4 Max는 구조적 기계 공학자처럼 사고하는 반면, Kimi K3.1 Pro는 산업 디자이너처럼 사고합니다.
Blender 프롬프트("목성 궤도 메가쉽 유지보수 도크")와 WebGL 심해 게이트 테스트("만 개의 조수 관문")에서 qwen4-max-preview는 더 밀도 높은 내부 하중 지지 리브, 복잡한 도킹 암, 그리고 수위와 압력 수치를 동적으로 재계산하는 작동 가능한 조수 레벨 UI 슬라이더를 구축했습니다. 그러나 리뷰어들은 시각적 구성, 물 셰이더 조명, 색상 조화 면에서 kimi-k3.1-pro에게 일관되게 더 높은 점수를 주었습니다. 사용자 대면 프론트엔드, 인터랙티브 3D 웹 경험, 또는 오늘날 1,048,576 토큰(1.05M)의 컨텍스트 윈도우와 131,072개의 최대 출력 토큰이 필요한 긴 컨텍스트 문서 에이전트를 구축 중이라면, Kimi K3.1 Pro를 GPT Proto에서 100만 출력 토큰당 10.00달러(캐시된 입력은 100만 토큰당 0.20달러로 인하)에 이용할 수 있습니다.
Qwen 4 Max 대 GLM-5.3
qwen 4 max vs glm5.3을 검색하는 개발자들은 대개 공격적인 가격대에서 대용량 코딩 및 도구 사용 효율성을 추구합니다. Qwen 4 Max의 첫 달 3달러 Lite 프로모션은 서류상으로는 저렴해 보이지만, 5시간 롤링 크레딧 제한과 자동화 스크립트 사용 금지 조항 때문에 백그라운드 에이전트 플릿용으로는 사용할 수 없습니다.
Z.ai의 glm-5.3은 종량제 API를 통해 바로 이 문제를 해결합니다. 이 모델은 실제로 총 컨텍스트 용량에서 Qwen 4 Max를 근소하게 앞서며, 1.05M 컨텍스트 윈도우와 128K 출력 제한을 제공하고 텍스트, 이미지, 문서 입력을 모두 지원합니다. GPT Proto에서 100만 출력 토큰당 3.74달러(Z.ai 공식 요금보다 15% 저렴)로 제공되는 GLM-5.3은 자동화된 PR 리뷰 봇, 고동시성 도구 라우팅, 다중 파일 코드 생성을 위한 가장 비용 효율적인 작업용 모델입니다.
Qwen 4 Max 대 Claude Opus 5.5
Alibaba는 Claude Code 내에서 qwen 4 max vs claude opus 5.5를 고려하는 개발자들을 유치하기 위해 qwen4-max-preview에 Anthropic Messages API와의 네이티브 호환성을 구축했습니다. WEEL의 Python CLI 테스트에서 입증되었듯이, Qwen 4 Max는 이미 12분짜리 pytest 복구 루프를 실행하고 미묘한 argparse 및 CSV 주입 버그를 잡아낼 수 있습니다.
claude-opus-5-5가 결정적인 우위를 점하는 부분은 궤적 효율성, 스트리밍 응답성, 그리고 프로덕션 SLA 신뢰성입니다. 커뮤니티 테스터들은 Qwen 4 Max의 초기 단계 RL 튜닝으로 인해 xhigh 추론 시 초당 약 33토큰의 속도로 중복된 셸 체크를 반복할 수 있다고 지적했습니다. 낭비되는 도구 사용이나 개인 계층 데이터 학습이 허용되지 않는 미션 크리티컬 프로덕션 저장소를 리팩토링할 때, Claude Opus 5.5는 1M 컨텍스트 윈도우와 128K 최대 출력, 그리고 성숙한 지시 이행 능력을 제공합니다. GPT Proto를 통해 claude-opus-5-5를 100만 출력 토큰당 18.00달러(공식 Anthropic 가격보다 10% 저렴)에 호출할 수 있습니다.
통합 API를 통해 프로덕션 대안 모델을 호출하는 방법
별도의 벤더 SDK, 구독 크레딧 창 또는 sk-sp- 지역 엔드포인트를 관리하지 않고 위에서 언급한 4가지 프로덕션 플래그십 모델을 실행하고 싶다면, GPT Proto는 단일 OpenAI 호환 경로(https://gptproto.com/v1/chat/completions)를 통해 이 모든 모델을 제공합니다.
코드 스니펫을 복사하기 전에 알아두어야 할 인증 관련 세부 사항이 있습니다. 당사의 인증 가이드 및 퀵스타트 페이지에 문서화된 대로, 항상 Authorization 헤더에 Bearer 접두사를 포함하여 키를 전달하십시오(Authorization: Bearer $GPTPROTO_API_KEY). 아래는 qwen3.8-max-0902을 호출하고 문자열 하나만 변경하여 glm-5.3, kimi-k3.1-pro 또는 claude-opus-5-5로 즉시 전환하는 방법을 보여주는 문서 기반 예제입니다:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max-0902",
    "messages": [
      {
        "role": "user",
        "content": "Audit this Python CLI parser for negative-number flag collisions and CSV formula injection risks."
      }
    ]
  }'
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://gptproto.com/v1",
    api_key=os.environ["GPTPROTO_API_KEY"],
)

# 1M 컨텍스트 플래그십 모델 간에 모델 ID를 자유롭게 교체하세요:

# "qwen3.8-max-0902" ($1.40/$4.20) | "glm-5.3" ($1.19/$3.74)

# "kimi-k3.1-pro" ($2.00/$10.00)   | "claude-opus-5-5" ($3.60/$18.00)
response = client.chat.completions.create(
    model="qwen3.8-max-0902",
    messages=[
        {
            "role": "user",
            "content": "Audit this Python CLI parser for negative-number flag collisions and CSV formula injection risks.",
        }
    ],
)

print(response.choices[0].message.content)