Comment nous avons classé les modèles pour SillyTavern
La preuve principale est le September 2026 AI Roleplay Bench, qui a testé 14 modèles officiels dans 10 catégories et a évalué 840 réponses. Ses catégories couvrent le chat de compagnie, le comportement de Maître du Jeu, la voix stricte des personnages, les méchants, la robustesse, les thèmes matures et les limites de sécurité. Kimi K3, GLM-5.3 et DeepSeek V4.1 Flash sont séparés par moins de deux points ; le benchmark lui-même conseille donc de les considérer comme une égalité effective plutôt que de traiter une décimale comme une victoire décisive.
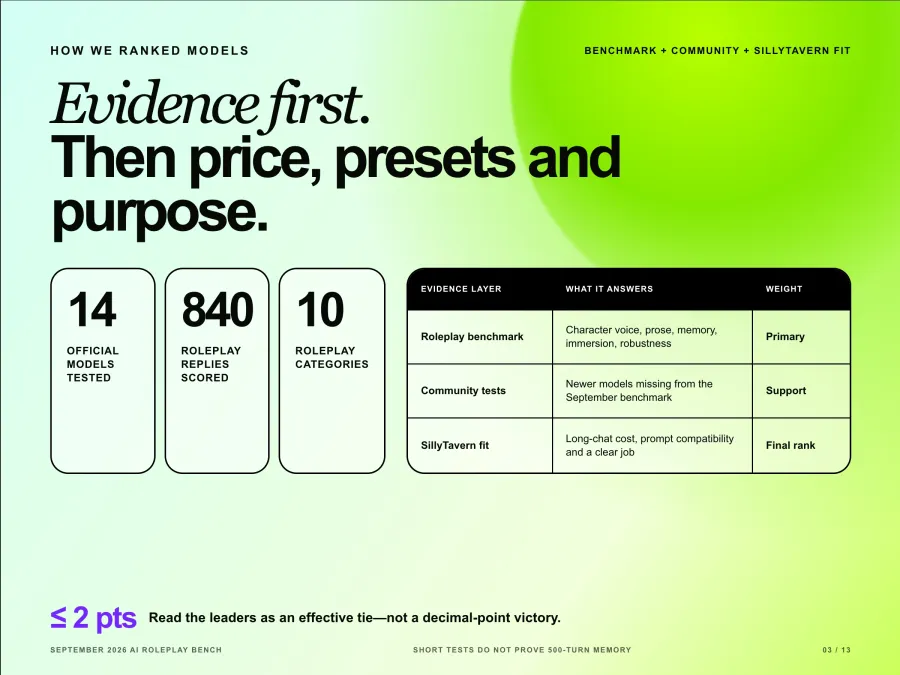
Le benchmark a également des limites. Sa méthodologie publiée utilise des scénarios courts à plusieurs tours, ne mesure pas la dérive sur des centaines de messages et exclut les réglages fins de la communauté. De nouvelles versions telles que Gemini 4 Argon sont également arrivées après ce test. Pour ces modèles, j'utilise les comparaisons de la communauté comme preuve complémentaire et je marque la recommandation comme étant moins certaine.
Le classement final ajoute trois facteurs spécifiques à SillyTavern :
Économie des discussions longues. Les jetons d'entrée dominent généralement les tours ultérieurs car SillyTavern renvoie la fiche du personnage, les instructions, les connaissances pertinentes et l'historique de la conversation.
Compatibilité des prompts et des préréglages. Les complétions de chat, les complétions de texte, les modèles d'instruction, les échantillonneurs et les contrôles de raisonnement ne sont pas interchangeables.
Un rôle clair pour chaque modèle. Un modèle moins cher ne gagne sa place que s'il a un rôle utile, et non simplement parce que son prix est bas.
Les 8 meilleurs modèles d'IA pour le jeu de rôle sur SillyTavern
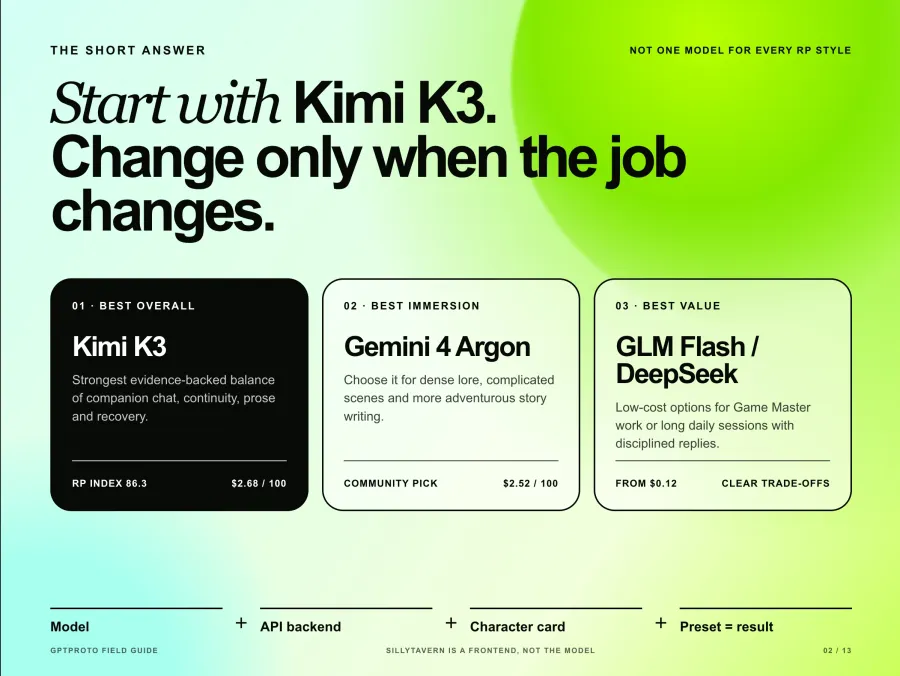
1 Kimi K3 : Le meilleur modèle global pour SillyTavern
Kimi K3 est le premier choix le plus sûr lorsque vous ne savez pas encore quel style de jeu de rôle vous préférez. Il a obtenu 86,3 au total, 90,0 pour le compagnon et 88,3 pour la robustesse dans le benchmark de jeu de rôle. Il a également dominé les évaluations du benchmark pour le personnage, la prose, la mémoire et l'immersion.
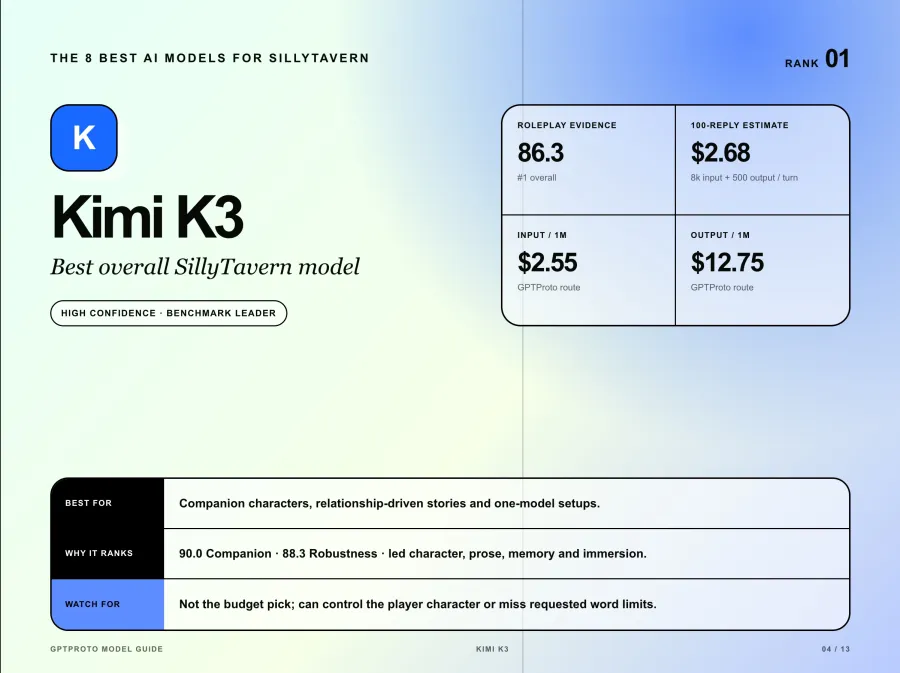
Cet équilibre compte plus dans SillyTavern qu'une seule réponse tape-à-l'œil. Kimi a géré les messages utilisateur d'un seul mot, a mémorisé les détails introduits et a maintenu le personnage actif au lieu de se transformer en un assistant générique. Ses faiblesses étaient concrètes : il contrôlait parfois le personnage du joueur en tant que Maître du Jeu et manquait les limites de mots demandées.
Idéal pour : les personnages compagnons, les histoires axées sur les relations et les utilisateurs qui souhaitent un seul modèle pour plusieurs styles de RP. Point de départ pour SillyTavern : utilisez la complétion de chat, l'ID de modèle exact kimi-k3 et une longueur de réponse modérée avant d'ajouter des règles de préréglage plus complexes. À 2,55 $ en entrée et 12,75 $ en sortie par million de jetons, ce n'est pas le choix économique.
2 Gemini 4 Argon : Le meilleur pour le jeu de rôle immersif
Gemini 4 Argon est le favori récent le plus solide de la communauté pour les univers denses, les scènes complexes et l'écriture d'histoires au long cours. Les utilisateurs de SillyTavern ont loué sa précision avec les longs prompts et sa capacité à ajouter des détails de scène utiles au lieu de simplement paraphraser la fiche de personnage. Une discussion communautaire détaillée sur l'utilisation pour les longues histoires a décrit une nette amélioration après que la même histoire soit devenue monotone sur d'autres modèles.
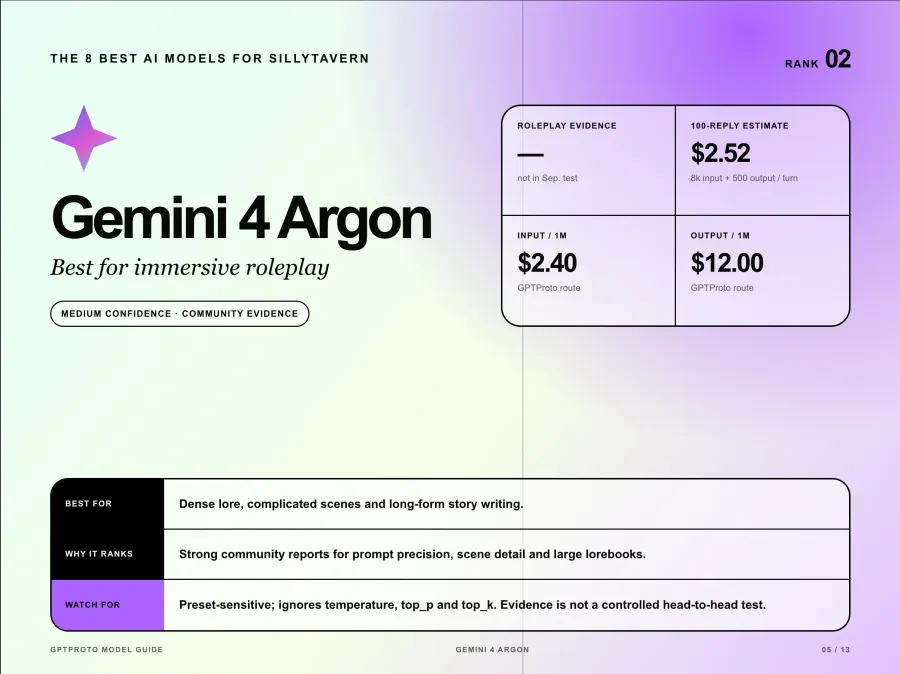
Le niveau de confiance est plus faible que pour Kimi ou GLM car Argon n'était pas inclus dans le benchmark de jeu de rôle de septembre. L'enthousiasme de la communauté est un indicateur, mais ce n'est pas un test comparatif contrôlé.
Argon nécessite également son propre préréglage. Son API ignore temperature, top_p et top_k ; copier un ancien préréglage Gemini axé sur l'échantillonnage crée donc l'illusion d'un contrôle sans modifier ces valeurs. Commencez avec une réflexion moyenne pour les discussions de personnage en tête-à-tête et testez une réflexion élevée uniquement pour les RPG complexes ou les grands livres de lore. L'inconvénient est le coût : ses tarifs de 2,40 $ en entrée et 12 $ en sortie placent un test fixe de 100 réponses à environ 2,52 $ avant que l'historique ne s'étende.
3 GLM 5.3 : Le meilleur modèle équilibré pour les histoires
GLM-5.3 est l'alternative la plus convaincante à Kimi K3 lorsque vous souhaitez que le modèle porte une plus grande partie de l'histoire. Il a obtenu un score de 85,1 au total, 92,5 pour la voix stricte et 85,8 pour la robustesse. Le benchmark le décrit comme particulièrement efficace pour le jeu de rôle axé sur l'histoire, la fiction sombre et les bots d'aventure.
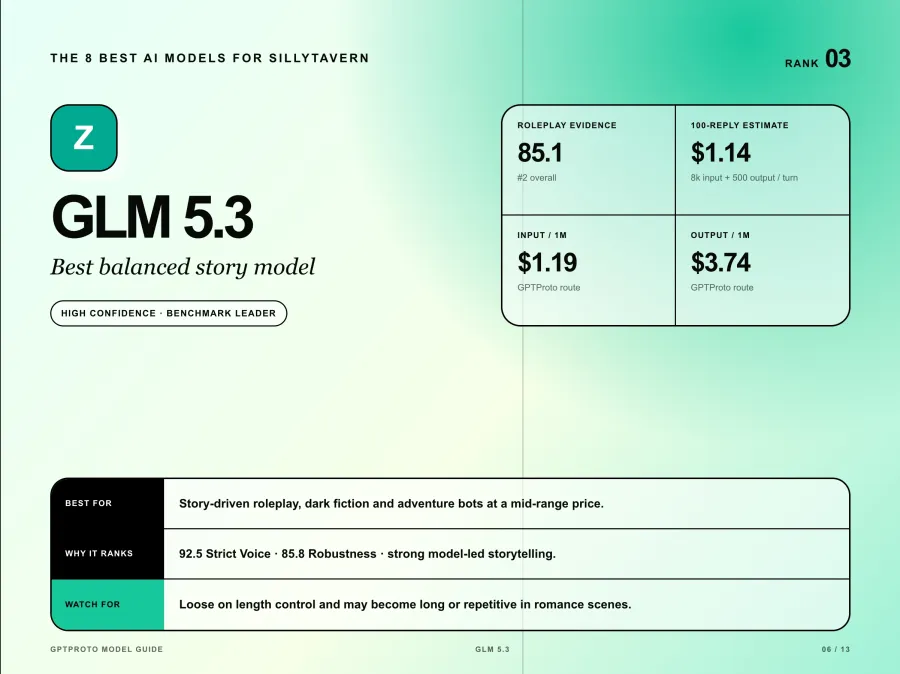
Le compromis réside dans le contrôle de la longueur et du rythme. GLM-5.3 était le plus laxiste des modèles de premier plan sur les limites de mots et a obtenu de bien moins bons résultats dans le scénario de romance du benchmark, où les réponses devenaient longues et répétitives. Une longueur de réponse maximale stricte et une instruction claire après l'historique aident, mais ne garantissent pas une sortie concise.
À 1,19 $ en entrée et 3,74 $ en sortie par million de jetons, GLM-5.3 coûte moins de la moitié du prix de Kimi K3 dans l'exemple fixe de 100 réponses. Utilisez l'ID de modèle glm-5.3. C'est un choix par défaut judicieux pour les utilisateurs qui souhaitent une qualité de jeu de rôle élevée sans payer les tarifs des modèles premium à chaque tour.
4 DeepSeek V4.1 Flash : Le meilleur pour des sessions longues et abordables
DeepSeek V4.1 Flash offre le meilleur rapport qualité-prix de cette liste. Il a obtenu un score global de 84,4, a respecté la limite de mots sur l'ensemble des 28 réponses de jeu de rôle principales sur 28, et a terminé à égalité à la première place dans la catégorie « Méchant ». Ses tarifs de 0,24 $ en entrée et 0,96 $ en sortie placent l'exemple fixe de 100 réponses à environ 0,24 $.
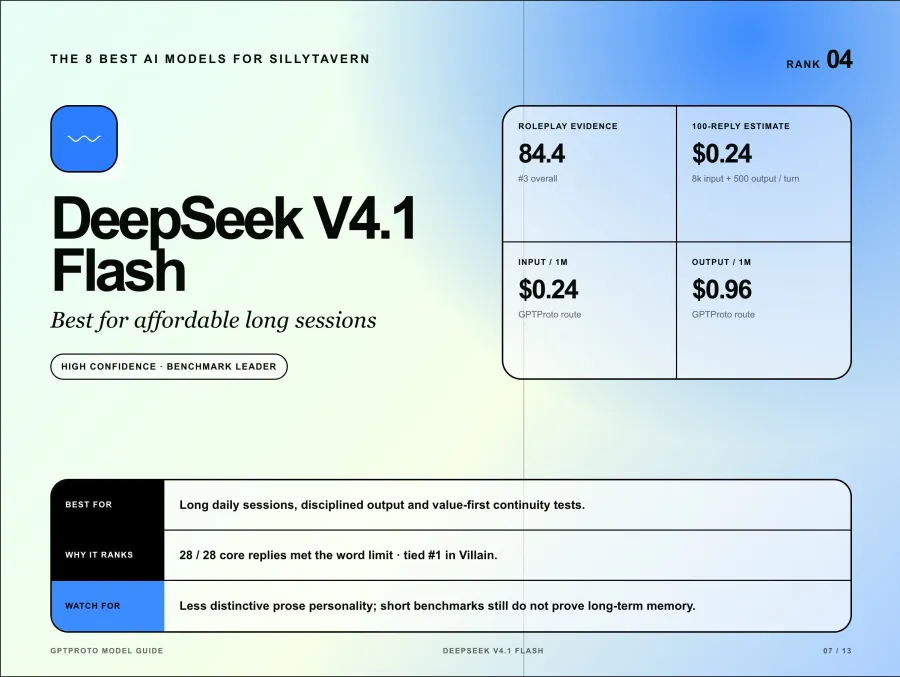
Le modèle est moins distinctif en tant que styliste de prose que Kimi, Argon ou Opus. Cela peut être un avantage lorsque la fiche de personnage contient déjà une voix forte : le modèle est moins susceptible de l'écraser avec son propre style maison. Il est également utile lorsque vous prévoyez de longues sessions quotidiennes et que vous souhaitez réserver un modèle plus coûteux pour les scènes charnières.
Utilisez deepseek-flash dans SillyTavern. À mon avis, c'est le meilleur premier test de valeur pour les discussions au long cours, mais le benchmark utilisait encore des scénarios courts. Vous devriez effectuer votre propre test de continuité sur 30 à 50 tours avant de considérer son prix bas comme une preuve de mémoire à long terme.
5 GLM 5.3 Flash : Le meilleur maître du jeu à petit prix
GLM-5.3 Flash est le spécialiste du budget. Il a obtenu un score de 89,2 en tant que Maître du jeu et 98,3 pour la Voix stricte, le score le plus élevé dans une catégorie unique lors du benchmark de septembre. À 0,1275 $ en entrée et 0,425 $ en sortie par million de jetons, l'exemple fixe de 100 réponses coûte environ 0,12 $.
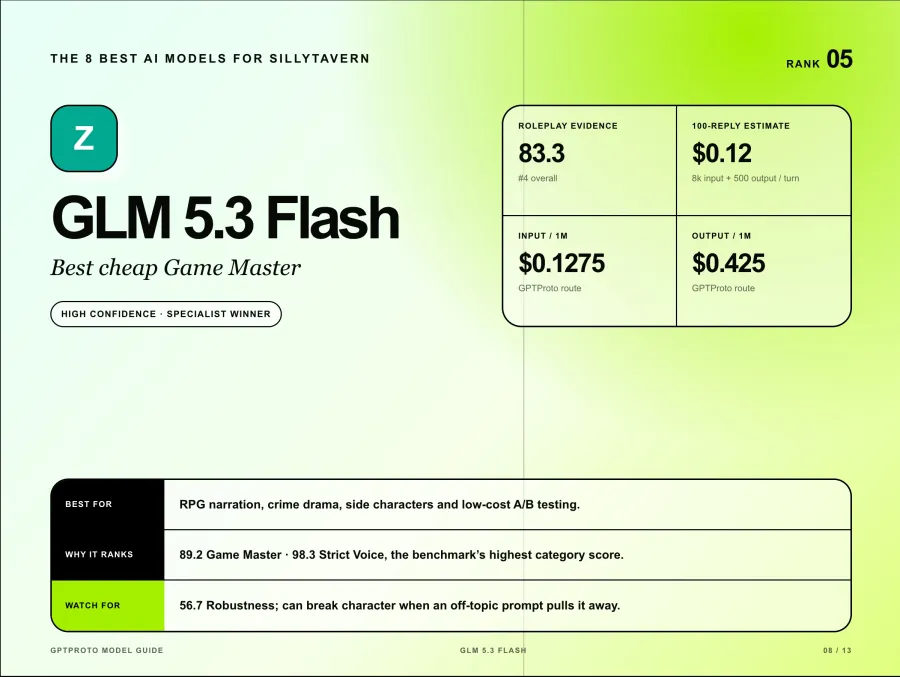
Son point faible est tout aussi important. GLM-5.3 Flash n'a obtenu qu'un score de 56,7 pour la Robustesse après avoir brisé le personnage pour répondre à une demande hors sujet comme un assistant généraliste. Il a également manqué plus de limites de mots pour les jeux de rôle principaux que les autres leaders.
Choisissez-le pour la narration RPG, les drames policiers, les personnages secondaires ou les tests A/B bon marché. Ne supposez pas que son prix bas en fait le meilleur modèle de compagnon. Dans SillyTavern, gardez les règles du personnage près de la fin du prompt et testez des tentatives de déraillement délibérées avant de vous engager dans une longue discussion avec lui. L'identifiant du modèle est glm-5.3-flash.
6 Gemini 3.8 Flash : Le meilleur modèle rapide pour le quotidien
Gemini 3.8 Flash mérite amplement sa place dans cette liste plutôt qu'une simple mention. Un benchmark communautaire de jeu de rôle récent a testé jusqu'à 64 réponses par modèle sur huit chapitres et a attribué à Gemini 3.8 Flash un score de qualité de 91,9. Ce test pondérait la préférence rédactionnelle à 75 % et la robustesse à 25 %. C'est une preuve utile, mais son score n'est pas directement comparable à celui de l'AI Roleplay Bench car les prompts et la méthode de notation diffèrent.
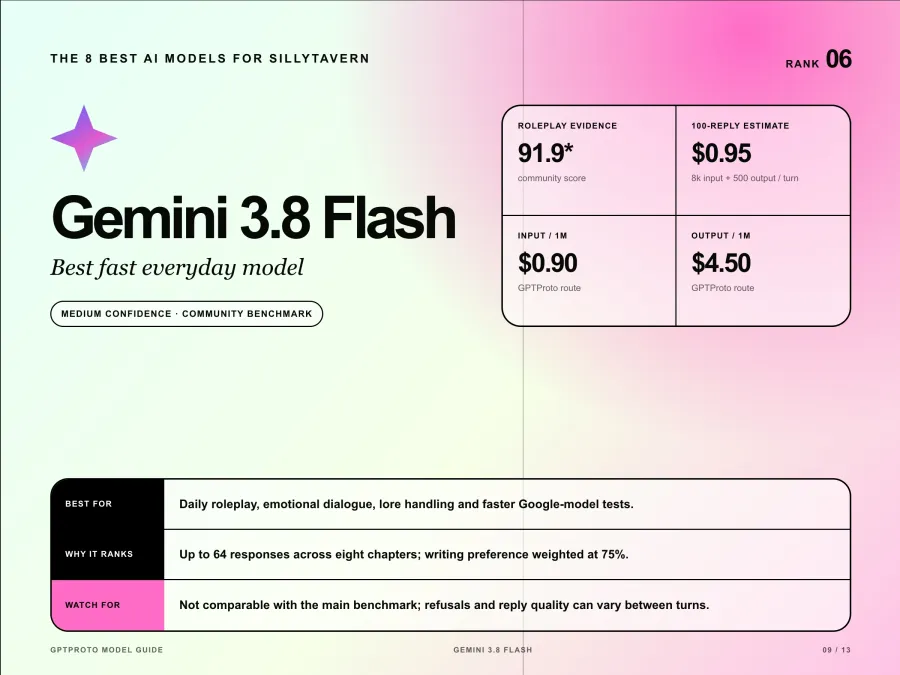
Les rapports de la communauté vantent également ses dialogues émotionnels, sa gestion du lore et son rythme conversationnel. Le point faible reste la cohérence : certains utilisateurs signalent des refus aléatoires ou des réponses inégales, même lorsque les tours précédents fonctionnent bien.
Utilisez gemini-3.8-flash et commencez avec un niveau de réflexion moyen. Ses tarifs de 0,90 $ en entrée et 4,50 $ en sortie le rendent beaucoup moins cher qu'Argon, bien que l'exemple fixe de 100 réponses coûte toujours environ 0,95 $. Choisissez-le si vous souhaitez un modèle Google pour un usage quotidien sans avoir besoin du raisonnement premium d'Argon à chaque tour.
7 Claude Opus 5.5 : Le meilleur modèle pour une prose premium
Claude Opus 5.5 est le choix premium pour la prose, mais pas le gagnant universel. Les utilisateurs qui l'apprécient soulignent sa conscience spatiale, ses connaissances générales, son rythme et sa capacité à rendre un décor vivant. Un rapport détaillé de la communauté SillyTavern le recommande pour le jeu de rôle narratif général, tout en conseillant de changer de modèle lorsqu'une scène nécessite une gestion de contenu différente.
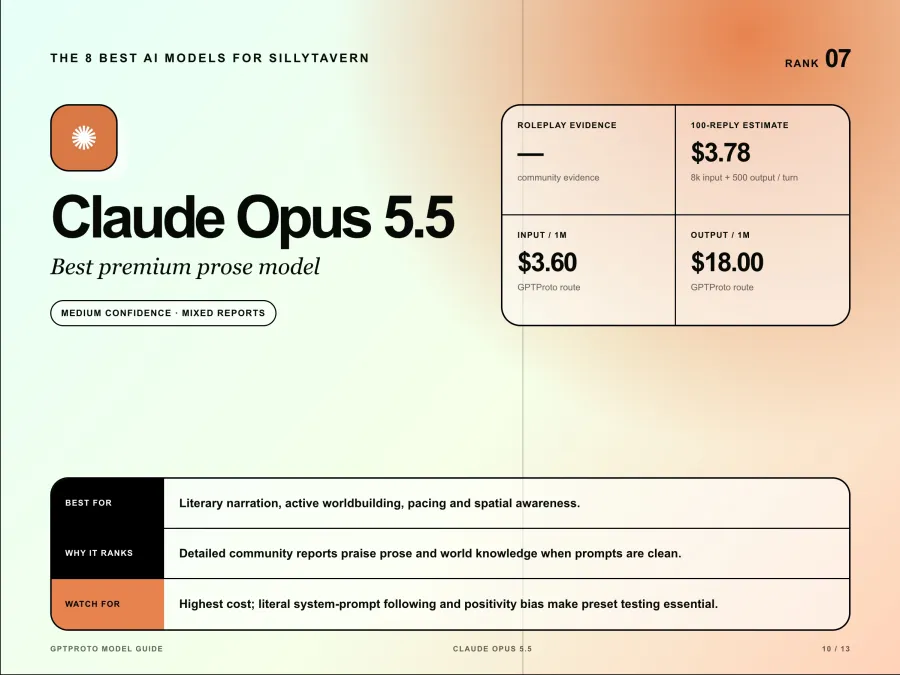
D'autres utilisateurs rapportent qu'Opus suit les longs prompts système de manière si littérale que des instructions contradictoires dans une fiche de personnage ou un préréglage peuvent déformer le personnage. Le biais de positivité est une autre plainte récurrente. Cette division explique pourquoi je ne le classerais pas au-dessus des leaders du benchmark sans tester la fiche exacte.
Le prix est l'inconvénient le plus évident : 3,60 $ en entrée et 18 $ en sortie par million de jetons, soit environ 3,78 $ pour l'exemple fixe de 100 réponses. Utilisez claude-opus-5-5, commencez avec un prompt propre et supprimez les règles de préréglage héritées que vous ne pouvez pas expliquer. Opus vaut la peine d'être testé pour la narration littéraire. Il est difficile à justifier pour un chat occasionnel à haut volume.
8 GPT 6 Luna : Le meilleur modèle GPT ultra-économique
GPT-6 Luna est la raison pour laquelle GPT ne devrait pas être absent d'un guide SillyTavern, même s'il ne s'agit pas du meilleur modèle de jeu de rôle global. Luna a obtenu un score de 71,1 au total, bien en dessous des quatre leaders du benchmark, avec 68,3 pour le Compagnon, 60,0 pour la Voix stricte et 54,2 pour la Robustesse. Sa prudence l'a fait sortir à plusieurs reprises de la fiction.
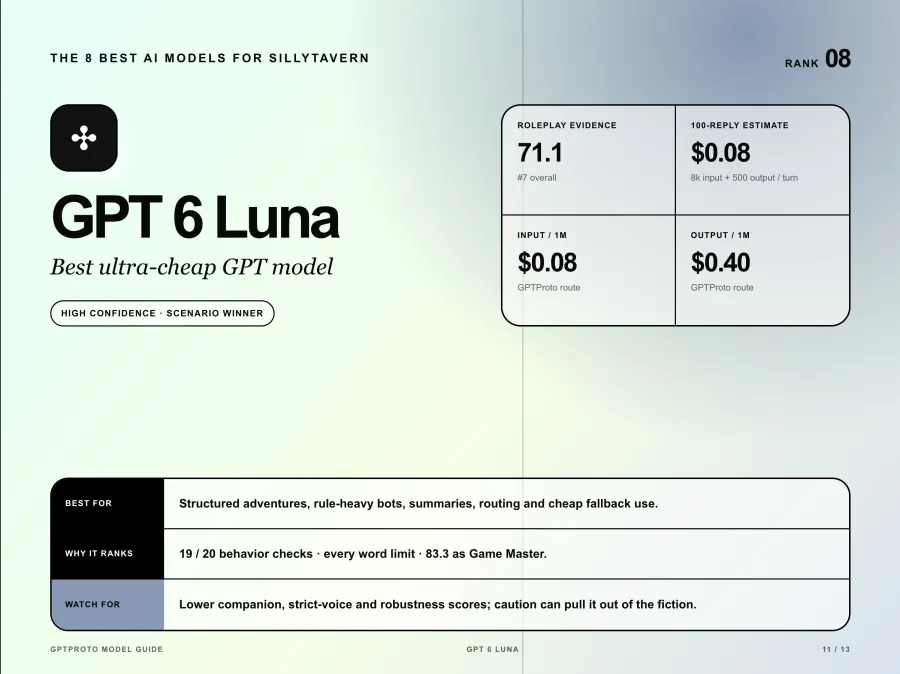
L'autre moitié du résultat est utile. GPT-6 Luna a réussi 19 des 20 contrôles de comportement, a respecté toutes les limites de mots testées et a obtenu un score de 83,3 en tant que Maître du jeu. À 0,08 $ en entrée et 0,40 $ en sortie par million de jetons, l'exemple fixe de 100 réponses coûte environ huit cents.
Utilisez gpt-6-luna pour des aventures structurées, des bots aux règles strictes, des résumés, du routage ou comme solution de secours économique. Ne le choisissez pas à la place de Kimi, GLM ou Gemini lorsque l'immersion émotionnelle est l'objectif principal. C'est un gagnant pour les scénarios, pas une affirmation déguisée selon laquelle le modèle classé septième au benchmark est le meilleur dans l'ensemble.
Pourquoi il n'y a pas plus de modèles GPT, Claude et Gemini
Un classement utile ne devrait pas réserver un espace égal à chaque fournisseur. Chaque modèle supplémentaire nécessite soit des preuves solides en matière de jeu de rôle, soit une fonction clairement différente.
| Famille de modèles |
Choix de la liste principale |
Autre modèle à tester |
Pourquoi l'alternative n'est pas classée séparément |
| GPT |
GPT-6 Luna |
GPT-6.1 Terra à 0,80 $ / 4,00 $ |
Terra a une tarification attrayante et une capacité d'écriture générale, mais aucun benchmark de jeu de rôle comparable pour le moment |
| Claude |
Claude Opus 5.5 |
Claude Sonnet 5.5 à 1,80 $ / 9,00 $ |
C'est une option Claude moins chère, mais les preuves actuelles spécifiques au jeu de rôle sont trop minces pour justifier un titre de gagnant distinct |
| Claude |
Claude Opus 5.5 |
Claude Haiku 5.5 à 0,09 $ / 0,45 $ |
Haiku est positionné pour un travail léger à haut volume ; un prix bas ne garantit pas à lui seul une prose solide ou une cohérence sur les longues sessions |
| Gemini |
Gemini 4 Argon et 3.8 Flash |
Variantes Gemini Flash Lite |
Les modèles Lite moins chers manquent des mêmes preuves communautaires spécifiques au jeu de rôle |
| Kimi |
Kimi K3 |
Kimi K3.1 Pro à 2,00 $ / 10,00 $ |
Il est plus récent et prometteur, mais il n'a pas remplacé K3 dans le benchmark spécialisé |
C'est aussi la raison pour laquelle GPT-6 Luna est classé huitième au lieu de disparaître. Il possède des preuves pour une tâche spécifique. Terra pourrait le surpasser plus tard, mais affirmer cela maintenant reviendrait à confondre les capacités générales avec les performances testées en jeu de rôle.
Meilleur modèle local pour SillyTavern par VRAM
Exécuter SillyTavern localement ne signifie pas que le modèle de langage est local. L'interface elle-même a des exigences modestes, tandis que l'inférence locale nécessite suffisamment de mémoire GPU pour les poids du modèle et le cache de contexte. L'aperçu officiel de SillyTavern recommande au moins 6 Go de VRAM comme point de départ pour l'inférence locale.
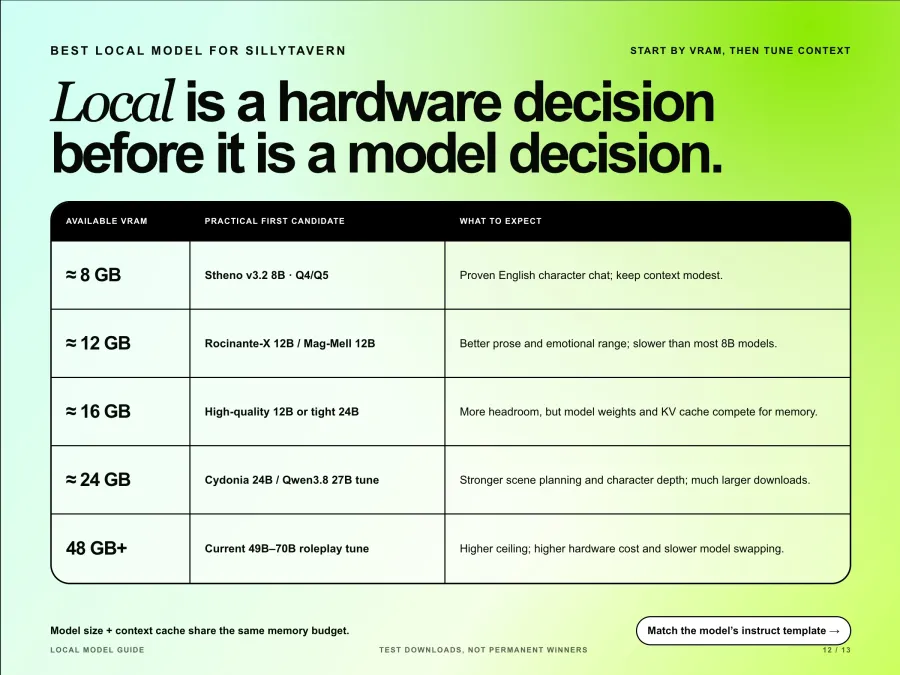
Les recommandations de modèles locaux changent rapidement, considérez donc ceux-ci comme des premiers téléchargements à tester plutôt que comme des gagnants permanents. Le répertoire de modèles de jeu de rôle sur Hugging Face contient des milliers de variantes communautaires avec des modèles et des quantifications très différents.
| VRAM disponible |
Premier candidat pratique |
À quoi s'attendre |
| Environ 8 Go |
Stheno v3.2 8B en Q4 ou Q5 |
Un point d'entrée éprouvé pour le chat de personnage en anglais, mais le contexte doit rester modeste |
| Environ 12 Go |
Rocinante-X 12B ou Mag-Mell 12B |
Meilleure prose et gamme émotionnelle que la plupart des modèles 8B, avec une génération plus lente |
| Environ 16 Go |
Une quantification 12B de meilleure qualité, ou un modèle 24B avec un contexte court et un déchargement partiel |
Plus de marge de qualité, mais un fichier de modèle tenant dans la VRAM ne garantit pas qu'un grand cache KV tiendra |
| Environ 24 Go |
Cydonia 24B ou un réglage de jeu de rôle Qwen3.8 27B |
Meilleure planification de scène et profondeur de personnage, avec des téléchargements beaucoup plus volumineux |
| 48 Go et plus |
Un réglage de jeu de rôle actuel de 49B à 70B |
Plafond plus élevé, mais coût matériel important et échange de modèles beaucoup plus lent |
Pour les cartes de 8 Go, le compromis central est simple : la taille du modèle et le contexte se disputent la même mémoire. Commencez avec un contexte plus petit, confirmez la voix du personnage, puis augmentez la limite tout en surveillant la VRAM et la vitesse de génération.
Pour les backends de complétion de texte locaux, sélectionnez le modèle d'instruction réel du modèle. La documentation du mode Instruction de SillyTavern avertit que le modèle choisi doit correspondre au format attendu par le modèle. Un réglage fin puissant avec le mauvais modèle peut paraître moins bon qu'un modèle plus petit configuré correctement.
Meilleur modèle pour le jeu de rôle à long terme
Kimi K3 est le choix le plus solide et éprouvé pour la continuité des personnages sur le long terme, tandis que DeepSeek V4.1 Flash est l'option la plus économique lorsque l'historique devient coûteux. Gemini 4 Argon est séduisant pour les lorebooks volumineux, mais une fenêtre d'un million de jetons ne doit pas être confondue avec une mémoire fiable.
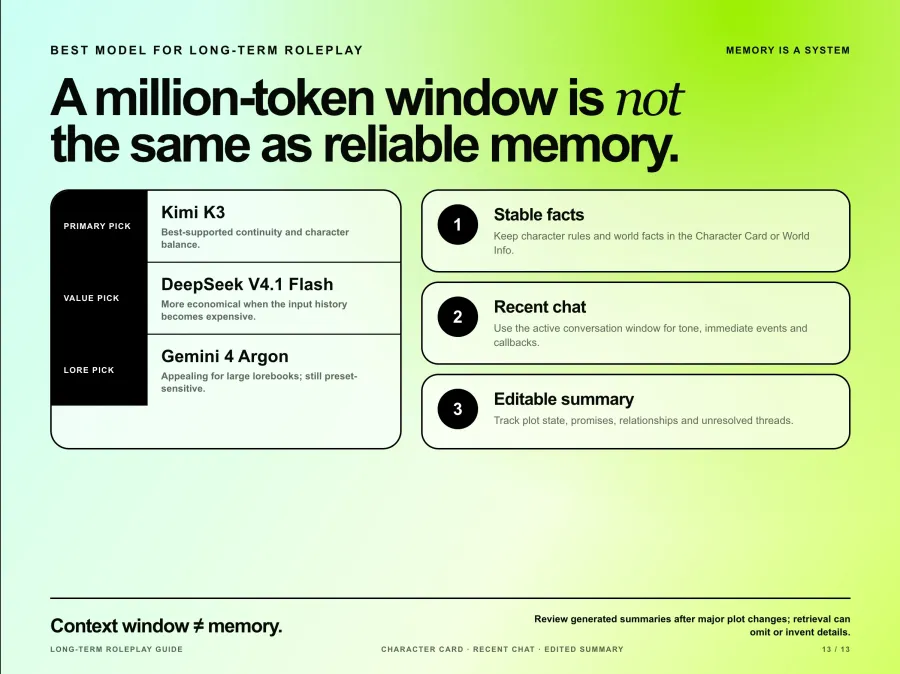
La documentation sur le contexte de SillyTavern explique que seuls les messages situés dans la plage de contexte active sont envoyés au modèle. Les informations sur le personnage, les instructions système, les World Info, les résumés et l'espace de réponse consomment tous ce même budget. Une fois que les anciens messages sortent de cette plage, le modèle ne peut plus les rappeler à moins que vous ne réinjectiez les faits pertinents.
Utilisez trois couches plutôt que de vous fier uniquement à la taille du contexte :
Conservez les faits stables sur le personnage et les règles du monde dans la fiche de personnage ou dans World Info.
Utilisez l'historique récent du chat pour le ton et les événements immédiats.
Maintenez un résumé court et modifiable pour l'état de l'intrigue, les relations, les promesses et les fils narratifs non résolus.
L'extension Summarize peut automatiser la troisième couche, mais sa propre documentation avertit que les résumés générés par le modèle peuvent omettre des détails ou en inventer. Relisez le résumé après des changements majeurs dans l'intrigue. La vectorisation du chat est expérimentale et peut rendre la récupération moins efficace, elle doit donc être testée plutôt qu'activée aveuglément.
Comment changer de modèle dans SillyTavern
Changer de modèle ne supprime pas le chat, mais cela peut modifier la voix, le formatage, le comportement face aux refus et la manière dont les messages précédents sont interprétés. Enregistrez un préréglage distinct pour chaque famille de modèles au lieu d'imposer un seul préréglage à GPT, Claude, Gemini et aux modèles de complétion de texte locaux.
Pour GPT Proto, la configuration rapide est la suivante :
Ouvrez API Connections dans SillyTavern.
Sélectionnez Chat Completion et Custom OpenAI compatible.
Définissez l'URL de base (Base URL) sur https://gptproto.com/v1. N'ajoutez pas /chat/completions ; SillyTavern l'ajoute automatiquement.
Collez la clé API et saisissez un identifiant de modèle exact tel que kimi-k3, glm-5.3-flash ou gemini-3.8-flash.
Commencez avec le traitement post-invite (Prompt Post-Processing) réglé sur None, connectez-vous et exécutez Test Message.
Le guide illustré de l'intégration API de SillyTavern couvre l'installation, les fiches de personnages, les captures d'écran et les erreurs de connexion courantes.
Si vous souhaitez vérifier la même clé et le même modèle en dehors de SillyTavern, cette requête utilise la route identique compatible avec OpenAI :
export GPTPROTO_API_KEY="VOTRE_CLE"

curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3",
    "messages": [
      {"role": "user", "content": "Réponds dans le personnage avec une courte phrase."}
    ],
    "max_tokens": 120
  }'
Après avoir changé de modèle, effectuez au moins cinq tours de discussion avec la même fiche de personnage. Incluez une réponse courte, une invite hors sujet, une instruction sur la longueur de la réponse et un rappel à un détail précédent. Cela permet de détecter plus de problèmes que de juger uniquement le message d'ouverture.
Quel modèle SillyTavern choisir
Choisissez Kimi K3 si vous souhaitez une option par défaut fiable et éprouvée.
Choisissez Gemini 4 Argon pour une narration complexe et un développement de scène immersif, en acceptant un coût plus élevé et une certitude moindre quant aux benchmarks.
Choisissez GLM-5.3 si vous recherchez un excellent narrateur à un prix intermédiaire.
Choisissez DeepSeek V4.1 Flash pour des sessions longues et abordables avec une sortie disciplinée.
Choisissez GLM-5.3 Flash pour une narration RPG économique et des voix de personnages rigoureuses.
Choisissez Gemini 3.8 Flash pour une version de Gemini plus rapide et moins chère, soutenue par des tests communautaires encourageants.
Choisissez Claude Opus 5.5 lorsque la qualité de la prose justifie le coût.
Choisissez GPT-6 Luna pour le jeu de rôle structuré, les résumés ou le routage de secours le moins cher.
Choisissez un fine-tune local pour le jeu de rôle lorsque la confidentialité, l'utilisation hors ligne et une génération illimitée priment sur le temps de configuration et la qualité des modèles cloud.
Vous pouvez comparer les signaux d'utilisation actuels et les prix des modèles sur la page des modèles SillyTavern de GPT Proto, puis tester le même personnage et le même historique sur différents modèles via le terrain de jeu API pour le jeu de rôle.