API de génération d’images par lots :Une clé, plusieurs modèles
Utilisez une seule clé API GPTProto pour exécuter des tâches d'image avec GPT Image 2, Nano Banana, Seedream et d'autres modèles pris en charge. Comparez les résultats et les coûts sur un échantillon, puis passez à l'échelle le modèle qui correspond à votre catalogue ou à votre brief créatif.
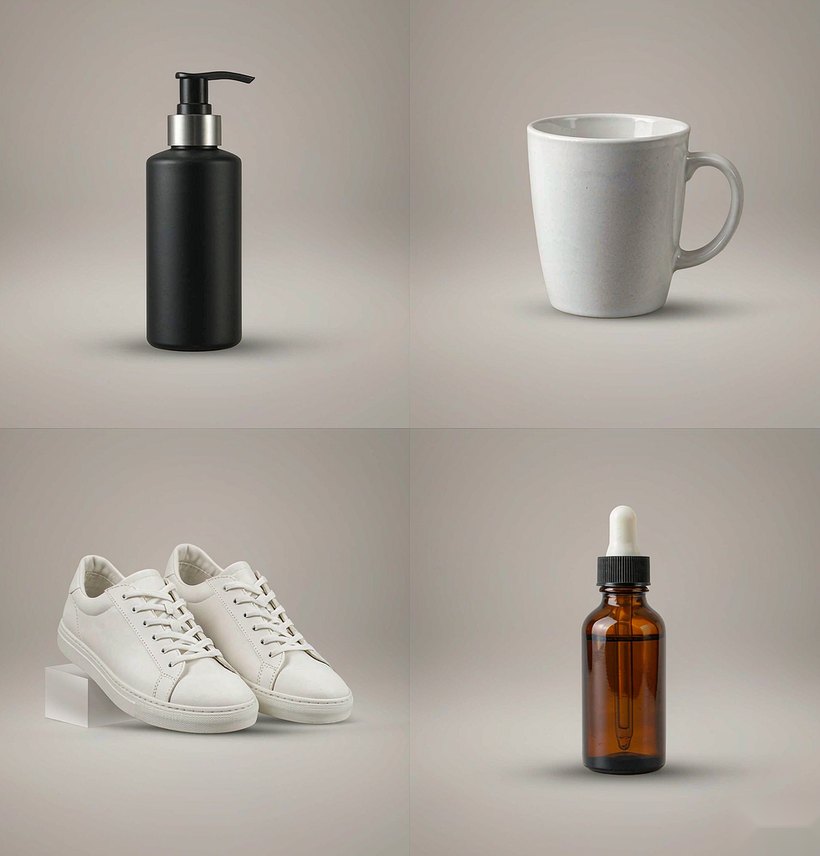
Lot de 40 références produit, un seul décor de studio. La liste d’invites contient une photo produit et son texte par ligne. Pour chaque ligne : placez le produit sur un fond gris clair sans raccord, une lumière principale douce et diffusée venant de la gauche, une légère ombre de contact, produit centré avec une marge de 15 %. Verrouillez la balance des blancs et l’étalonnage des couleurs sur tout le lot pour que le catalogue se lise comme une seule prise de vue. Format carré 1:1, 2048 px. Aucun accessoire, aucun texte, aucun logo.
Des images différentes nécessitentdes modèles différents.
Une image de catalogue, un asset de jeu et un visuel de campagne peuvent nécessiter différents modèles. Testez GPT Image 2, Nano Banana et Seedream avec la même clé GPTProto et un solde partagé. Conservez vos ID d’assets et la validation des sorties dans un même workflow de production.
Avant · cinq API d’images
✕Cinq SDK, cinq clés, cinq factures
✕Une image par appel — nouvelles tentatives manuelles
✕Le style dérive d’un modèle à l’autre
✕$0.052 par image au prix catalogue officiel
Après · gptproto
✓Une clé, un endpoint, un solde
✓Tâches par lots asynchrones, reprenables en cas d’échec
✓Une image de référence maintient le rendu sur tout le lot
✓$0.039 par image — avant les crédits bonus
Même worker, même clé — seul le nom du modèle change.
// MÊME PROMPT, RÉSULTATS DIFFÉRENTS
Un prompt. Seize modèles.Voyez ce que chacun fait bien.
Donnez à chaque modèle la même consigne et examinez le résultat avant de lancer une génération d’images complète. Comparez les détails qu’il suit, le temps qu’a pris cet exemple et le coût de cette requête.
InvitePresque toutes les photos de vin dans les données d'entraînement montrent un verre rempli au tiers, donc les modèles reproduisent ce schéma par défaut. Remplir le verre à ras bord permet de vérifier si un modèle suit le prompt ou le biais appris.
Un verre à vin rempli à ras bord de vin blanc, la surface au niveau du bord du verre, posé bien droit sur une table en bois simple. Prise de vue de face à hauteur des yeux, verre droit et non incliné, aucun autre objet dans le cadre.
Même brief de style.Interprétations différentes des modèles.
Choisissez le look dont votre projet a besoin, puis voyez comment les modèles d’image gèrent le même brief de style. Comparez les couleurs, la composition et la texture avant de choisir ce que vous testerez dans votre propre workflow.
Invite
Portrait studio d'une femme en blazer anthracite sur fond gris moyen sans couture, éclairée par une grande softbox légèrement au-dessus et à gauche avec un fill doux depuis la droite, des catchlights dans les deux yeux. Rendu 85 mm avec faible profondeur de champ, texture de peau et cheveux rebelles conservés plutôt que lissés.
Plus d’options de modèles.Moins de comptes fournisseurs.
Essayez un autre modèle sans ouvrir un autre compte fournisseur. Gardez votre pipeline d’actifs visible à mesure que les volumes augmentent : sachez ce qui a été soumis, où se trouve le résultat et combien coûte chaque modèle.
01
Une seule clé, plusieurs modèles d’images
Testez les modèles d’images disponibles avec un seul compte GPTProto et un solde partagé. Voyez comment chacun gère votre produit réel ou votre brief créatif.
Vérifiez le tarif actuel pour le modèle et les paramètres que vous prévoyez d’utiliser. Estimez d’abord le coût d’un petit échantillon, puis prévoyez un mois de production.
Attribuez un ID de produit ou d’actif à chaque requête, stockez l’ID de tâche renvoyé et examinez séparément les soumissions terminées, échouées et incertaines.
Essayez des modèles pour l'imagerie produit, les retouches basées sur référence et les assets de campagne depuis le même compte GPTProto. Comparez le résultat et le tarif actuel, puis vérifiez les entrées de chaque modèle avant de l'ajouter à votre worker.
E-commerce shots, game assets, packaging and short-drama key visuals — batch image production where reference-image consistency decides whether the batch is usable.
Cohérence des référencesAsync batch jobsCost per image
Hand over a reference image plus a change request — product-in-context, background swaps and style locks that keep a whole catalogue visually coherent.
Utilisez votre clé GPTProto pour essayer quelques modèles, puis choisissez-en un et saisissez votre volume mensuel prévu. Commencez par une petite exécution pour mesurer le coût de vos prompts et paramètres réels.
01 / Qu'exécutez-vous principalement ?
02 / Quelle intensité d'usage mensuel ?
La vidéo et les agents consomment plus vite. Si vous changez l’usage, la suggestion change aussi.
$100
Génération d'images · Régulier — chaque semaine — Prix des modèles d'image par sortie — environ 2 400+ images pour 100 $ de crédits.
Quand une tâche échoue, sachez quelle image manque.
Une seule clé GPTProto vous permet de travailler avec les modèles d’image pris en charge. Une exécution de 5 000 images doit tout de même être traçable élément par élément : conservez les ID de tâche, vérifiez les statuts et examinez les envois échoués ou incertains avant de les relancer.
01
Basculement automatique
Lorsque des routes de secours sont disponibles, le basculement peut réduire les interruptions. Des requêtes peuvent néanmoins échouer ; vérifiez le statut des tâches image avant de les relancer.
02
Canaux amont redondants
Les canaux amont redondants peuvent réduire les effets des pannes de fournisseurs. La disponibilité varie selon le modèle et le canal ; votre application doit gérer les délais dépassés et les limites de requêtes.
La surveillance et le routage aident à détecter et traiter les incidents amont, sans garantir un service ininterrompu. Journalisez les échecs et vérifiez les mécanismes de nouvelle tentative.
// Calculateur d’économies API IA
Chiffrez le lotavant de le lancer.
Choisissez un modèle, définissez les options d’image et saisissez votre volume mensuel. Comparez la dépense API estimée sur les mêmes paramètres.
Découvrez ce que les gens construisent avecGPTProto
Découvrez les retours de développeurs et de créateurs utilisant GPTProto pour leurs applications, leur contenu et leurs flux de travail IA quotidiens.
BL
Blogstra
Reddit · r/Bloggers
#Routing
For a team already juggling DeepSeek, Kimi, Qwen, or other providers, a shared routing layer can be reasonable if it removes duplicated work and the fallback behavior is tested. GPTProto is one implementation of this approach.
K
K
X (Twitter) · @ChillaiKalan__
#Cost
I've been testing GPTProto recently, and it's honestly made my creative workflow much simpler. Instead of paying for multiple subscriptions, I can access several leading AI models from one place.
SN
Sanskriti Naruka
X (Twitter) · @snskritinaruka
#Video
I turned this single prompt into a cinematic fantasy video using GPTProto. "Continuous 15-second cinematic shot, 4K resolution, hyper-realistic dark fantasy photorealism…"
CF
Caden Flux
X (Twitter) · @Caden_Flux
#Video
I challenged myself to create a cinematic AI cooking short in just 15 seconds. I used GPTProto to bring the entire workflow together, from image generation to video, all in one place.
Z
Zara
X (Twitter) · @ZaraIrahh
#Creative
Made with Seedance 2.0 + GPT Image 2 on GPTProto. A Pixar-style commercial with the perfect glow.
MO
Many-Operation2625
Reddit · r/LLMDevs
#Integration
What worked for me was pointing the cloud connections at GPTProto so the frontend only sees one endpoint and I just change the model name to swap. I am not rebuilding a connection from scratch every time.
OB
obxsurfer06
Reddit · r/singularity
#Resilience
I route the calls through GPTProto so a fallback is a config switch instead of a weekend rewrite when a model disappears. It turns "my default model just got export controlled" from an incident into a config change.
AL
Alice The Ai Expert
X (Twitter) · @AliceInfoAi
#Models
I used to switch between different AI tools just to compare results. Now I just use GPTProto. GPT-5, Claude, Gemini, Kimi, and more — all in one workspace.
EB
EntireBig7258
Reddit · r/LLMDevs
#DevOps
I route the calls through GPTProto so the model id and latency land in one place regardless of which provider is behind it. The win is having the log schema consistent across providers.
AL
Alamin
X (Twitter) · @iam_chonchol
#Video
I created this 15-second cinematic product video with GPTProto using Seedance 2.0, and I was really impressed by how smooth the workflow was.
F
Fokki
X (Twitter) · @0x_fokki
#Workflow
GPTProto routes the character prompt and shot list to a top model on one API key: 20 minutes … voices it and burns in captions from the same key: 20 minutes.
FA
FormalAd4696
Reddit · r/SillyTavernAI
#Apps
Text, images, and voice are configured separately. You can keep OpenRouter for text and use GPTProto for visuals.
AF
Any-Farm-1033
Reddit · r/EngineeringManagers
#Teams
The call layer underneath the router is GPTProto, so swapping a model does not require provisioning a new provider integration. Changing models becomes cheap enough that the question stops being "should we change."
// Tarifs
Paiement à l'image.Ajoutez du crédit. Choisissez vos modèles. Payez ce que vous consommez.
Vous ne payez que pour les images que vous générez. Rechargez une fois, utilisez le montant sur n'importe quel modèle d'image — les recharges de $20+ rapportent des crédits bonus.
$15
Crédit simple · sans bonus
Commencez. Suffisant pour tester l'endpoint et générer un premier lot. Rechargez $20+ à tout moment pour débloquer des crédits bonus.
Le plus populaire
$100
+4% crédits bonus
Le juste équilibre pour un petit pipeline qui traite des lots hebdomadaires.
Économies max. · +6%
$1,000
+6% crédits bonus
Vous obtenez $600 de solde pour $500 — les crédits bonus s'ajoutent à la tarification déjà réduite des modèles. Conçu pour des traitements par lots quotidiens.
Vous consommez 100M tokens/mois sur GPT Image 2 ? Au tarif GPTProto, c’est environ $1,920 économisés par an vs tarif officiel — avant les crédits bonus.
// FAQ
Questions avantle premier lot
Les détails pratiques des tâches d’image, des choix de modèles et des coûts.
01GPTProto propose-t-il une API Batch unique pour les tâches d’image ?+
Le workflow en masse documenté de GPT Image 2 soumet les requêtes d’image via son endpoint de modèle, stocke un ID de tâche renvoyé pour chaque requête et vérifie le résultat correspondant. Ne partez pas du principe qu’un endpoint Batch JSONL de style OpenAI est disponible sur GPTProto. Consultez le guide étape par étape pour le workflow actuel.
02Puis-je générer des images pour différents produits dans la même exécution ?+
Oui. Conservez un enregistrement par produit ou ressource dans votre propre file d’attente, générez la requête spécifique au modèle pour chaque enregistrement et enregistrez l’ID de tâche avec son SKU. Plusieurs variations d’un même prompt et des requêtes pour de nombreux produits différents sont deux workflows différents ; choisissez celui que votre tâche nécessite.
03Puis-je utiliser la même clé API GPTProto pour GPT Image 2, Nano Banana et Seedream ?+
Oui, pour les modèles pris en charge dans votre compte : une clé GPTProto et un solde partagé vous permettent d’essayer différents modèles d’image. Chaque modèle peut toujours avoir son propre endpoint, ses champs de requête, son format de sortie et son unité de facturation. Consultez la documentation du modèle avant de modifier un worker de production.
04Comment éviter de perdre le fil des résultats lors d’une longue exécution ?+
Enregistrez l’ID de la ressource, la version du prompt, le modèle, les paramètres et l’ID de tâche renvoyé après chaque requête acceptée. Interrogez l’état de la tâche et stockez le fichier finalisé dans votre propre stockage de ressources. Au redémarrage, vérifiez les ID de tâche connus avant de créer de nouvelles tâches.
05Que dois-je faire si une requête expire ou atteint une limite de débit ?+
Suivez les consignes relatives aux limites de débit et réduisez les soumissions simultanées lorsque vous recevez un 429. Un délai de connexion dépassé lors d’une soumission peut laisser l’issue incertaine ; consultez l’historique de vos tâches avant de soumettre à nouveau, car la première requête a peut-être déjà été acceptée et facturée. Examinez les erreurs de contenu ou de paramètre au lieu de les relancer sans modification.
06Une image de référence peut-elle garantir que chaque sortie soit identique ?+
Les entrées de référence et d’édition dépendent du modèle et de la tâche. Elles peuvent aider à guider un rendu ou à préserver des détails, mais elles ne garantissent pas des résultats identiques d’un modèle à l’autre ni pour chaque élément. Testez des éléments représentatifs et vérifiez la fidélité du produit avant une exécution complète.
07Comment le coût par image est-il calculé ?+
Cela dépend du modèle. Certains modèles facturent à la requête ou à la sortie, tandis que GPT Image 2 est indiqué avec des tarifs de tokens d’entrée et de sortie sur sa page de modèle. Choisissez votre taille et qualité réelles, testez un échantillon et comptez les nouvelles tentatives ou les résultats rejetés lorsque vous prévoyez le coût de production.
08Puis-je migrer un workflow d’image OpenAI existant sans modification ?+
Certaines routes compatibles OpenAI prises en charge peuvent ne nécessiter que des modifications de configuration, mais ne partez pas du principe que cela s’applique à tous les modèles. Par exemple, la route Midjourney documentée suit un chemin différent. Confirmez les champs de requête, la gestion des statuts et les formats de sortie avec un échantillon avant la migration.
09Les crédits bonus de recharge sont-ils inclus dans le calculateur d’économies ?+
La comparaison des tarifs des modèles et toute offre de crédits bonus doivent apparaître séparément. Vérifiez les conditions actuelles de crédit et d’éligibilité au moment du paiement ; l’estimation sur cette page doit indiquer lequel des deux elle inclut.
10Puis-je obtenir des factures pour mon entreprise ?+
Contactez l’équipe GPTProto ou consultez la page de facturation du compte pour connaître le processus actuel de demande de facture et les détails de facture pris en charge.
// GUIDES POUR LES PIPELINES D’IMAGES
Construisez le workflow,puis passez à l’échelle.
Guides pratiques sur les lots d’images produit, le choix des modèles et les coûts des API d’images.
Dépensez moins pour l'IA.Construisez avec un fournisseur en qui vous pouvez avoir confiance.
Obtenez un accès fiable à plus de 200 modèles d'IA avec l'API IA tout-en-un de GPTProto. Une tarification transparente, des connexions fiables et un seul compte pour votre travail quotidien avec l'IA.