GPT-6.2 Astra en un coup d'œil
| Question |
Réponse courte |
| Qu'est-ce que GPT-6.2 Astra ? |
Le modèle GPT-6.2 le plus performant d'OpenAI pour le codage complexe et le travail professionnel |
| Date de sortie |
17 novembre 2026 |
| ID du modèle API |
gpt-6.2-astra |
| Fenêtre de contexte |
1,05 million de jetons |
| Entrée / sortie maximale |
922 000 / 128 000 jetons |
| Modalités |
Entrée texte et image ; sortie texte |
| Prix standard de l'API OpenAI |
8 $ en entrée, 0,40 $ en entrée mise en cache et 40 $ en sortie pour 1 million de jetons |
| Prix GPT Proto |
6,40 $ en entrée, 0,32 $ en entrée mise en cache et 32 $ en sortie pour 1 million de jetons — 20 % de réduction |
| Meilleur usage initial |
Débogage complexe, revue de code, migrations, analyse de données, documents professionnels, science, CAO et flux de travail 3D |
| Meilleure option au quotidien |
GPT-6.2 Sol pour le codage de routine, l'écriture et les tâches à moindre coût |
La documentation du modèle OpenAI répertorie la prise en charge des réponses et des complétions de chat, ainsi que des outils incluant la recherche Web, la recherche de fichiers, l'interprète de code, le shell hébergé, l'utilisation de l'ordinateur, MCP et la génération d'images. Le modèle lui-même renvoie du texte. Les feuilles de calcul, diapositives, sites ou actifs 3D finis dépendent des outils et de l'environnement d'exécution qui l'entourent.
De quoi discutent réellement les premiers utilisateurs ?
La conversation autour du lancement ne porte pas principalement sur les scores de référence. Elle porte sur l'écart entre la capacité brute et la facilité d'utilisation au quotidien.
1. Astra peut être excellent pour examiner et réparer les systèmes existants
Les premiers tests de Copilot par GitHub ont révélé que GPT-6.2 Astra détectait beaucoup plus de problèmes réels de revue de code que GPT-6 Astra tout en utilisant moins de jetons. C'est plus pertinent pour une équipe de production qu'une énième démo d'application ponctuelle : le travail précieux consiste souvent à trouver le défaut, à préserver le comportement existant et à prouver le correctif avec des tests.
L'ingénieur Tibor Blaho a décrit l'utilisation d'Astra dans le travail quotidien d'infrastructure et de logiciel, notamment la gestion de serveurs, les sauvegardes, la surveillance, la recherche, l'administration, le débogage et la revue de code. Son exemple marquant était la mise à niveau d'une application héritée de plusieurs millions de lignes et de ses anciennes dépendances vers une version linguistique actuelle. Il a rapporté un résultat utilisable localement après environ trois heures et un test de validation propre après environ six heures, tout en notant qu'il restait du travail à faire.
Il s'agit d'une anecdote, pas d'un benchmark contrôlé. Cela reste un exemple utile car il inclut une base de code réelle, un temps écoulé et une étape de vérification. Cela souligne également un flux de travail pratique : Blaho utilise Astra et les modèles Claude pour rechercher et examiner le travail de chacun au lieu de supposer qu'un seul modèle détecte tous les défauts.
2. Les exécutions autonomes longues peuvent être frustrantes
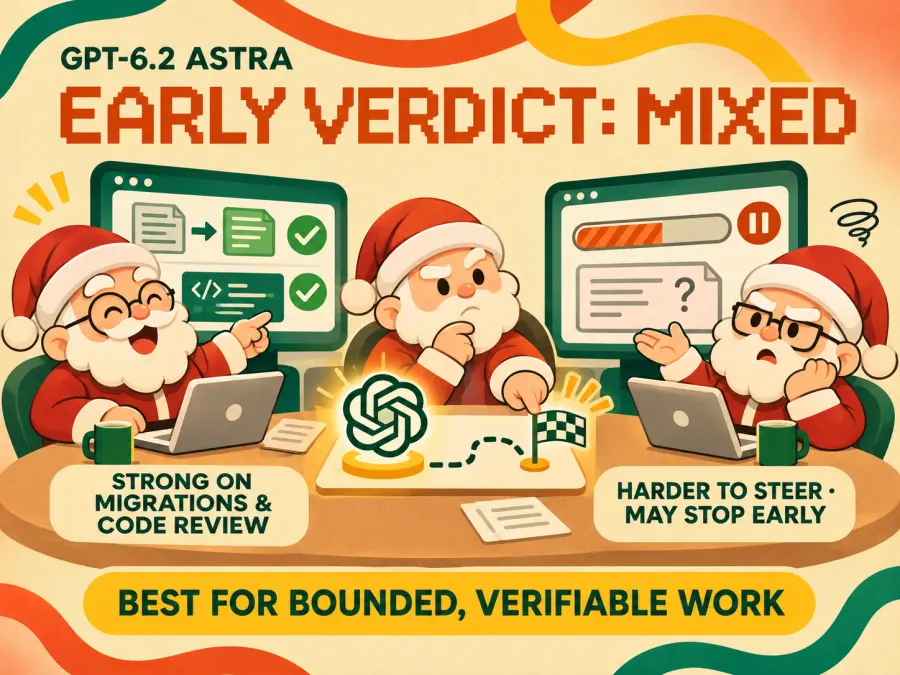
Les rapports négatifs sont également concrets. La première analyse de Dan Shipper indiquait qu'Astra s'arrêtait souvent trop tôt sur des builds de codage de bout en bout et pouvait être si concise que son écriture devenait difficile à suivre. Ethan Mollick l'a qualifiée d'irrégulière et plus difficile à piloter : elle a réussi à créer une expérience ambitieuse de type ascenseur spatial dans Blender et Unity, mais il ne s'est pas pour autant surpris à l'utiliser comme modèle quotidien.
Le compte-rendu détaillé du développeur Theo est tout aussi nuancé. Il a fait l'éloge d'Astra en tant que réviseur de code, a déclaré qu'elle trouvait des solutions innovantes et lui a attribué la conception d'un reverse-proxy qui pourrait faire économiser 25 000 $ par mois à son entreprise. Il a également signalé de longues exécutions bloquées sur des questions auxquelles il ne pouvait pas répondre, des boucles qui ne progressaient pas et des résumés plus difficiles à comprendre que les modifications de code elles-mêmes.
Ces témoignages ne prouvent pas que chaque exécution d'Astra échouera. Ils identifient le même risque sous des angles différents : le modèle peut être suffisamment capable d'effectuer le travail, mais difficile à superviser lorsque l'objectif est ouvert.
3. Une sortie concise est soit synonyme d'efficacité, soit d'un manque de contexte
Le propre guide de prompting de GPT-6.2 d'OpenAI indique qu'Astra est par défaut plus concise et directe. Pour une réponse de support, une note de révision de code ou une note de synthèse pour la direction, cela peut être utile. Pour une explication complexe, on peut avoir l'impression que le modèle a sauté le raisonnement dont le lecteur avait besoin.
Cela explique pourquoi les premières réactions sont contradictoires. Les personnes testant un livrable au périmètre restreint peuvent constater moins de remplissage et moins de jetons. Les personnes utilisant Astra comme collaborateur sur un long projet peuvent observer des réponses abruptes, des décisions inexpliquées ou des transferts prématurés.
4. La vraie question est la forme de la tâche, et non si Astra est « intelligente »
Les preuves suggèrent jusqu'ici une distinction simple :
| Forme de la tâche |
Adaptation initiale pour Astra |
| Objectif clair, outils, tests et ligne d'arrivée |
Candidat solide |
| Révision à haute valeur ajoutée où les défauts manqués sont coûteux |
Candidat solide |
| Travail sur des données multi-sources ou des documents avec une sortie vérifiable |
Candidat solide |
| E-mail de routine, notes de réunion ou petite modification de code |
Utilisez généralement Sol en priorité |
| Recherche ouverte nécessitant un jugement sur ce qui est important |
Comparez avec Fable 5.2 et maintenez une révision humaine |
| Build autonome de plusieurs heures avec des décisions ambiguës |
Testez soigneusement avant de vous y fier |
GPT-6.2 Astra est-il adapté au travail quotidien ?
Oui, mais la plupart des tâches quotidiennes ne le nécessitent pas. Pour des notes de réunion, des e-mails de routine, des recherches rapides, de petites modifications de code ou un premier brouillon, GPT-6.2 Sol est le point de départ le plus naturel. C'est le modèle qu'OpenAI positionne pour le travail quotidien, et ses tarifs par jeton sont 75 % inférieurs à ceux d'Astra. GPT Proto applique la même remise de 20 % aux deux modèles, l'écart de prix reste donc inchangé.
Astra devient utile lorsqu'une catégorie de travail ordinaire se transforme en une tâche complexe à haute valeur ajoutée. « Examine cette pull request » peut convenir à Sol ; « retrace cette défaillance intermittente à travers trois services, corrige-la et exécute les workflows affectés » est une mission pour Astra. « Résume ce CSV » est une tâche de routine ; « identifie les problèmes de qualité des données, explique les pièges statistiques et crée un classeur de décision modifiable » donne à Astra plus d'espace pour justifier son coût.
Les usages quotidiens pratiques rapportés jusqu'ici incluent le débogage, les opérations serveur, la surveillance, les sauvegardes, la revue de code, la recherche multi-sources et l'administration de bureau. Le point commun n'est pas la profession, mais le fait que la tâche soit suffisamment complexe pour bénéficier d'un raisonnement approfondi et suffisamment structurée pour vérifier le résultat.
À quoi sert GPT-6.2 Astra ?
Revue de code, analyse des causes profondes et modernisation de systèmes hérités
C'est le cas d'usage pratique le plus évident. Donnez à Astra le workflow défaillant, les journaux pertinents, le dépôt et les commandes de test. Demandez-lui de retracer la faille à travers les services, d'implémenter la correction la plus précise et sécurisée, et d'exécuter les tests affectés. Cela correspond au workflow Astra recommandé par OpenAI ainsi qu'aux rapports positifs de GitHub et des premiers ingénieurs.
Les mises à niveau de systèmes hérités peuvent être particulièrement adaptées car la tâche est difficile mais vérifiable. Le modèle peut inspecter d'anciennes dépendances, mettre à jour le code par étapes et exécuter à plusieurs reprises une compilation propre. L'humain doit toujours définir les exigences de compatibilité et examiner la migration. « Tous les tests ont réussi » n'est une preuve que si la suite de tests couvre le comportement qui compte.
Pour une revue de pull-request normale ou une petite révision, GPT-6.2 Sol peut suffire. OpenAI recommande explicitement Sol pour le codage quotidien, et il coûte un quart des tarifs standard d'entrée et de sortie d'Astra.
Analyse de données, tableaux de bord et classeurs modifiables
La valeur d'Astra ici ne réside pas simplement dans l'écriture d'une requête SQL. Il peut inspecter les données, remarquer les problèmes de qualité, énoncer des hypothèses, effectuer des analyses et transformer les résultats en un classeur, un graphique ou un tableau de bord qu'une autre personne peut examiner.
Un test d'analyse de données Plotly indépendant fournit un exemple utile de tâche réelle. Astra a réussi 41 questions sur 43, a détecté tous les problèmes de qualité de données introduits, a évité les cinq pièges statistiques et a terminé l'exécution pour 4,11 $. Sa question médiane a pris 12,4 secondes, contre 26,9 secondes pour GPT-6 Astra. Le compromis est important : il a manqué deux modèles cachés, et GPT-6.1 Sol a obtenu un score parfait lors de ce test pour 2,61 $. Astra était rapide et capable, mais pas automatiquement l'option la moins chère ou la plus précise.
L'exemple d'évaluation Alderfen d'OpenAI montre le volet documentaire de cette même capacité. Astra a créé un classeur DCF modifiable qui prévoyait les revenus jusqu'en 2031, réconciliait trois états financiers, calculait la valeur par action et plaçait les principaux facteurs à côté du tableau de sensibilité. Considérez cela comme une démonstration de fournisseur, et non comme une preuve indépendante. Cela reste un modèle utile pour un test que vous pouvez reproduire avec votre propre tableur.
Finance, comptabilité, travail juridique et documents professionnels
GPT-6.2 Astra a été entraîné pour respecter les conventions professionnelles dans les présentations, les feuilles de calcul, les notes de service et les documents. OpenAI rapporte des gains dans les flux de travail liés à la finance, à la comptabilité, au conseil, à la vente et au domaine juridique. Les résultats clients présentés sur la page de lancement incluent une réduction du nombre de cycles de révision pour les applications, les tableaux de bord et les présentations, ainsi qu'une diminution des délais de réalisation pour les travaux comptables de longue haleine. Il s'agit de résultats sélectionnés par le fournisseur ; ils doivent donc être interprétés comme des cas d'usage prometteurs plutôt que comme des résultats garantis.
Les meilleures applications sont les livrables vérifiables :
Un modèle financier dont les formules se réconcilient et réagissent correctement lorsque les hypothèses changent.
Une note juridique dont les affirmations peuvent être retracées jusqu'aux autorités et documents sources fournis.
Une présentation qui suit un modèle existant et transforme chaque titre en une conclusion étayée.
Un outil de suivi de conformité qui associe chaque exigence à une preuve, un responsable et un statut.
Les preuves indépendantes sont moins flatteuses concernant les travaux ouverts. Dans l'évaluation réaliste en milieu professionnel d'Epoch AI, aucun modèle testé n'a atteint la norme d'employé d'Epoch sur aucune tâche. GPT-6.2 Astra a obtenu une moyenne de 65 %, soit 17 points de moins que Claude Fable 5.2. Epoch a constaté qu'Astra s'était amélioré par rapport à GPT-6 Astra en matière de rédaction concise, de conception graphique et de recherche en centre de données, mais qu'il pouvait être trop prudent et omettre des conclusions étayées par les preuves disponibles.
Cette contradiction apparente est tout l'intérêt. Astra peut être très performant lorsque la grille d'évaluation et le résultat attendu sont explicites. Lorsque le travail nécessite de décider ce qui est important, de formuler des hypothèses calibrées et d'itérer sur un plan de recherche incertain, le choix du modèle et la supervision humaine sont plus importants.
Analyse scientifique et recherche technique
OpenAI positionne la science comme un cas d'usage phare d'Astra et rapporte des résultats de premier plan sur les flux de travail scientifiques basés sur terminal. Un signal précoce distinct provient du chercheur en biomédecine Derya Unutmaz, qui a privilégié Astra pour la science et le codage à long terme, tout en préférant Opus 5.5 pour le goût en matière de design et l'intelligence émotionnelle. Il a également décrit son expérience de recherche biomédicale avec Astra comme étant solide.
Cela ne signifie pas qu'Astra peut produire de manière indépendante des recherches prêtes à être publiées. L'évaluation d'Epoch a révélé que les modèles de pointe réutilisaient encore des idées existantes, s'appuyaient trop lourdement sur les premières tentatives et peinaient à identifier les découvertes les plus importantes. Utilisez Astra pour effectuer des recherches, coder des analyses, comparer des sources, tester une hypothèse énoncée ou contester un brouillon. Ne traitez pas un récit de recherche confiant comme une validation.
CAO, simulation, conception 3D et prototypes visuels
Ici, les exemples de lancement sont plus intéressants que les jeux. OpenAI a montré Astra modélisant des composants de véhicule, écrivant un solveur Python pour la dynamique du châssis, animant le résultat dans Blender et créant un guide d'assemblage ainsi qu'un catalogue de pièces pour un buggy radiocommandé. Ces exemples combinent raisonnement visuel, code, utilisation de l'ordinateur et documentation dans un seul flux de travail.
Cette combinaison peut aider à l'exploration technique initiale : transformer des images de référence et des manuels en un modèle modifiable, tester une révision en simulation et produire une explication visuelle pour un réviseur. Une conception physique nécessite toujours une validation technique. Une animation plausible n'est pas la preuve que les charges, les tolérances, les matériaux ou les exigences de sécurité sont corrects.
GPT-6.2 Astra peut-il créer des jeux ?
Oui. Meridian Sound Racing est une démo jouable par navigateur, et le projet d'ascenseur spatial d'Ethan Mollick combinait Blender, Unity, une expérience de navigation et une simulation de physique en apesanteur.
Mais « peut créer un jeu » n'est pas le meilleur résumé d'Astra. Ces projets prouvent que le modèle peut coordonner du code, des ressources 3D, des outils et des interactions sur un projet de grande envergure. Ces mêmes capacités sont utiles pour les simulations, les expériences de formation, les jumeaux numériques, les configurateurs de produits et les récits de données interactifs.
La cohérence créative nécessite également des tests. Les premiers utilisateurs ont signalé des instincts visuels par défaut solides, mais des motifs de conception répétitifs et un contrôle plus faible sur le style. Donnez à Astra une référence visuelle, une typographie, un public cible, des règles d'interaction et des objectifs explicitement exclus. Ensuite, jugez la deuxième révision, et pas seulement la première capture d'écran.
Comment obtenir de meilleurs résultats avec GPT-6.2 Astra
Les plaintes de la communauté suggèrent qu'Astra a besoin d'un brief opérationnel plus explicite qu'un simple prompt de chat. Le guide d'OpenAI avertit également que le modèle peut proposer une étape suivante et attendre lorsque l'intention n'est pas claire.
Utilisez une structure de prompt comme celle-ci :
Objectif :
Réaliser [livrable spécifique].

Terminé quand :

1. [Vérification d'acceptation]

2. [Test ou preuve]

3. [Format de sortie requis]

Autonomie :
Faites des hypothèses raisonnables et réversibles et continuez sans attendre.
Ne demandez que si une décision modifierait matériellement le résultat ou entraînerait une action irréversible.

Contraintes :

- Préserver [comportement ou style existant].

- Ne pas modifier [zone hors périmètre].

- Utiliser [outils, fichiers, sources ou conventions].

Vérification :
Exécuter [tests ou vérifications]. Signaler explicitement tout fichier manquant, outil défaillant, hypothèse non prise en charge ou étape incomplète.

Livraison finale :
Résumer ce qui a été modifié, ce qui a été vérifié, les risques restants et l'utilisation/coût total.
Pour le travail par API multi-tours, gardez le préfixe du prompt précédent inchangé et ajoutez les nouvelles instructions. OpenAI indique que cela préserve le raisonnement et améliore la réutilisation du cache de prompt. Pour le travail front-end ou visuel, fournissez une référence réelle et nommez la typographie et l'imagerie souhaitées. « Faites-le moderne » n'est pas un système de design.
Combien coûte GPT-6.2 Astra par tâche ?
Ces tarifs sont exprimés en USD par million de jetons pour des requêtes allant jusqu'à 272 000 jetons en entrée. Les lignes GPT Proto appliquent la remise actuelle de 20 % sur les tarifs standard d'OpenAI.
| Modèle et itinéraire |
Entrée |
Entrée en cache |
Sortie |
| GPT-6.2 Astra — Standard OpenAI |
8,00 $ |
0,40 $ |
40,00 $ |
| GPT-6.2 Astra sur GPT Proto — 20 % de réduction |
6,40 $ |
0,32 $ |
32,00 $ |
| GPT-6 Astra — Standard OpenAI |
10,00 $ |
1,00 $ |
50,00 $ |
| GPT-6.2 Sol — Standard OpenAI |
2,00 $ |
0,10 $ |
10,00 $ |
| GPT-6.2 Sol sur GPT Proto — 20 % de réduction |
1,60 $ |
0,08 $ |
8,00 $ |
Pour une requête avec 20 000 jetons d'entrée non mis en cache et 5 000 jetons de sortie facturés, le coût standard des jetons serait de 0,36 $ sur GPT-6.2 Astra, 0,45 $ sur GPT-6 Astra et 0,09 $ sur GPT-6.2 Sol. Aux tarifs actuels de GPT Proto, le même nombre de jetons coûte 0,288 $ sur Astra ou 0,072 $ sur Sol. Une tâche d'agent réelle peut effectuer des appels de modèle répétés, réutiliser un contexte mis en cache, réessayer des outils ayant échoué ou produire un résultat beaucoup plus long.
Au-delà de 272 000 jetons d'entrée dans une seule requête, les tarifs d'entrée et de cache d'Astra doublent et les coûts de sortie sont multipliés par 1,5 par rapport au tarif pour contexte court pour l'ensemble de la requête. La fenêtre de contexte de 1,05 M est utile, mais la remplir sans discernement peut entraîner une facture élevée. Mesurez le coût par tâche terminée, et non seulement le prix par million de jetons.
L'exécution Plotly donne un exemple concret : 43 questions analytiques coûtent 4,11 $ sur GPT-6.2 Astra, contre 19,97 $ sur GPT-6 Astra. Pourtant, GPT-6.2 Sol a coûté 1,22 $ et n'a terminé qu'avec une seule question de retard. La mise à niveau d'Astra est réelle ; le modèle le moins cher peut toujours offrir une meilleure rentabilité pour le trafic de production courant.
Les deux itinéraires à prix réduit sont désormais actifs. Consultez la page du modèle GPT-6.2 Astra ou la page du modèle GPT-6.2 Sol pour connaître l'identifiant du modèle actuel et le format de requête avant d'envoyer du trafic de production. La collection de modèles OpenAI répertorie le reste des modèles OpenAI disponibles.
GPT-6.2 Astra est-il meilleur que Claude Fable 5.2 ?
Pas pour tous les types de travail.
OpenAI rapporte qu'Astra a plus que doublé le taux de réussite strict de Fable 5.2 sur un benchmark d'agent juridique, pour environ un sixième du coût. Dans FrontierCode 2.0 de Cognition, cependant, Fable 5.2 a obtenu un score plus élevé sur les modifications apportées à des bases de code existantes. L'évaluation en milieu de travail en conditions réelles d'Epoch a également favorisé Fable 5.2 de 17 points.
| Choisissez GPT-6.2 Astra lorsque… |
Choisissez Claude Fable 5.2 lorsque… |
| La revue de code, le débogage, l'utilisation d'outils ou un livrable technique vérifiable sont essentiels |
La tâche est ouverte et nécessite un jugement solide sur ce qui est important |
| Vous avez besoin de flux de travail de CAO, de simulation, de 3D ou d'utilisation informatique |
Le style de collaboration et la lisibilité des explications longues importent davantage |
| Le coût des tâches répétées et l'efficacité du cache sont importants |
Vos propres tests représentatifs montrent moins d'interventions ou une meilleure exécution |
| Vous voulez qu'un second modèle examine le travail d'un autre agent |
Vous voulez qu'un second modèle remette en question les hypothèses et les correctifs d'Astra |
La réponse la plus pratique est peut-être d'utiliser les deux. Le flux de travail de vérification croisée précoce décrit par Tibor Blaho est plus crédible que de déclarer un gagnant universel : laissez un modèle implémenter ou effectuer des recherches, puis demandez à l'autre de rechercher les défauts manqués et les hypothèses non étayées.
Pour une comparaison créative, réutilisez le brief interactif sur l'aquarelle de notre test Claude Fable 5.2. Donnez aux deux modèles le même projet existant et demandez un nouveau contrôle sans casser ceux qui sont en place. Comparez la précision du premier essai, le nombre de révisions, la qualité des explications, le nombre total de jetons et le coût de la tâche terminée. Vous pouvez trouver l'accès à Fable sur la page de l'API Claude Fable 5.2.
Où pouvez-vous utiliser GPT-6.2 Astra ?
ChatGPT Work : GPT-6.2 Astra est disponible dans Work plutôt que dans le chat ChatGPT classique. L'accès dépend de votre forfait, des paramètres de l'espace de travail et du statut de déploiement.
Codex : Oui. Choisissez Astra dans l'application Codex ou utilisez /model dans l'interface de ligne de commande (CLI). C'est l'option recommandée par OpenAI pour tracer des bugs complexes entre les services et finaliser les correctifs et les tests.
Claude Code : Il n'existe pas d'option native GPT-6.2 Astra. La documentation de la passerelle LLM d'Anthropic indique que le routage de Claude Code vers des modèles non-Claude via une passerelle n'est pas pris en charge.
OpenAI API : Utilisez l'identifiant de modèle officiel gpt-6.2-astra. OpenAI recommande l'API Responses pour les flux de travail nécessitant l'appel d'outils.
GPT Proto : GPT-6.2 Astra et GPT-6.2 Sol sont disponibles à un tarif inférieur de 20 % aux tarifs standards des jetons API d'OpenAI. Choisissez Astra pour le raisonnement complexe et les livrables professionnels vérifiables ; choisissez Sol pour le codage de routine, la rédaction et les charges de travail plus importantes. Le calendrier de déploiement initial de GPT-6.2 Astra retrace les premières apparitions dans Codex.
La requête suivante utilise l'identifiant du modèle Astra en direct. Vous pouvez copier le dernier extrait d'intégration directement depuis sa page de modèle.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  --header "Authorization: Bearer ${GPTPROTO_API_KEY}" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "gpt-6.2-astra",
    "messages": [
      {
        "role": "user",
        "content": "We sold 12 units at $25 each. Each unit cost $10. Return revenue and gross profit in USD as JSON using the keys revenue and gross_profit."
      }
    ]
  }'
Le revenu devrait être de 300 $ et la marge brute de 180 $. Pour une exécution de routine moins coûteuse, passez à l'identifiant de modèle exact indiqué sur la page GPT-6.2 Sol. Vous pouvez également parcourir la collection de modèles OpenAI pour découvrir d'autres modèles disponibles.
Conclusion
L'avantage le plus convaincant de GPT-6.2 Astra n'est pas sa capacité à créer un jeu. C'est sa capacité à combiner raisonnement, code, outils, fichiers et utilisation informatique sur des tâches ayant une finalité mesurable : un bug corrigé et testé, une migration qui se compile proprement, un classeur qui se réconcilie ou une analyse qui expose ses hypothèses.
La limite est tout aussi pratique. Les premiers utilisateurs décrivent régulièrement un modèle capable d'être brillant sur une tâche tout en restant difficile à diriger ou à comprendre sur le long terme. Utilisez Sol pour le travail de routine. Utilisez Astra lorsque le travail est suffisamment complexe pour le justifier, définissez précisément ce qui est « terminé », vérifiez le résultat et comparez-le avec Fable 5.2 sur les tâches où le jugement de recherche et le style de collaboration sont importants.