Présentation de Qwen 4 Max : du test à l'aveugle « Qoduck » à la version préliminaire de 14 jours
Si vous souhaitez un aperçu pratique de Qwen 4 Max, commencez par les quatre jours précédant l'annonce de son nom. Entre le 7 et le 10 novembre 2026, un modèle anonyme portant le nom de code Qoduck est apparu dans Qoder, un IDE de codage agentique. Les développeurs testant Qoduck ont remarqué un comportement inhabituel : au lieu de renvoyer rapidement un extrait de code en une seule passe et d'attendre les retours humains, le modèle passait dix à quinze minutes à effectuer des vérifications dans le shell, à rédiger des ressources SVG personnalisées à partir de zéro et à exécuter des tests unitaires sur ses propres diffs avant de fournir une réponse finale.
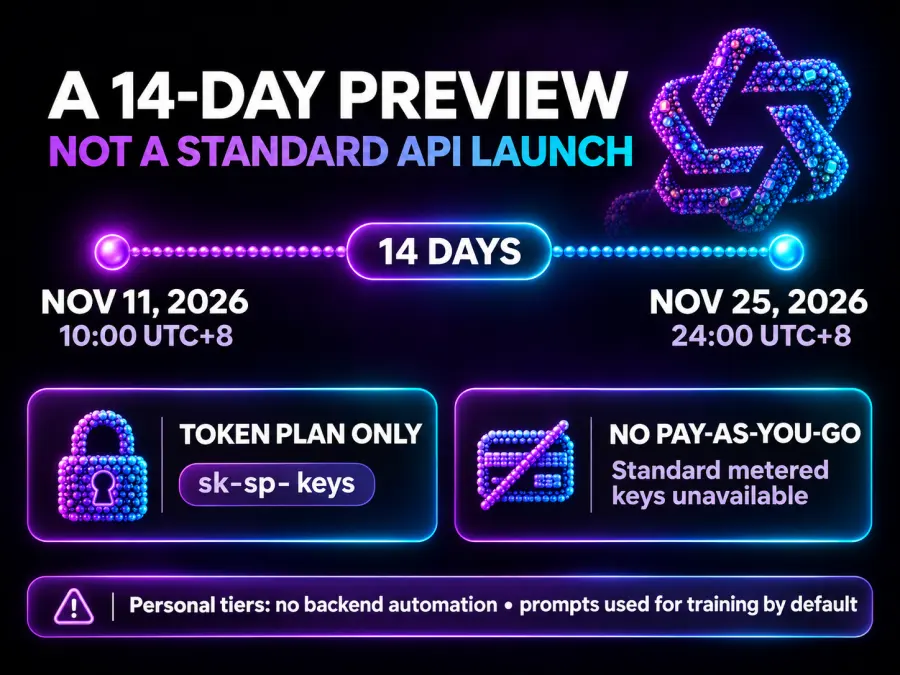
Le 11 novembre 2026 à 10h00 UTC+8, Alibaba a confirmé que Qoduck était le nouveau modèle Qwen, Qwen 4 Max, et l'a rendu disponible dans Alibaba Cloud Model Studio sous la chaîne de modèle qwen4-max-preview (référencée sous le nom qwen4.0-max-preview dans certaines configurations client). Plutôt que d'organiser un lancement commercial complet avec des tarifs par jeton, Alibaba a structuré le déploiement — souvent décrit dans la documentation développeur comme l'introduction de Qwen 4 Max via une version préliminaire de 14 jours — afin de tester sous contrainte les flux de travail agentiques au sein d'outils de développement tels que Claude Code, Cursor, Cline et Qoder.
| Spécifications |
Statut confirmé (qwen4-max-preview) |
Source / Note technique |
| ID officiel du modèle |
qwen4-max-preview |
Documentation Alibaba Cloud Model Studio / Bailian |
| Fenêtre de prévisualisation |
11 nov. 2026 (10:00) – 25 nov. 2026 (24:00 UTC+8) |
Prévisualisation limitée stricte de 14 jours |
| Fenêtre de contexte |
1 000 000 de jetons (entrée max : 967 000 jetons) |
Vérifié via la documentation CN et internationale |
| Jetons de sortie max |
393 216 au total (131 072 sortie finale + 262 144 raisonnement) |
max_tokens plafonne la réflexion et la sortie combinées |
| Modalités d'entrée / sortie |
Entrée : Texte, Image, Vidéo · Sortie : Texte |
Pas d'entrée audio native sur la version de prévisualisation |
| Contrôle du raisonnement |
reasoning_effort : low, medium, xhigh |
Réflexion activée par défaut ; par défaut sur xhigh |
| Protocoles API pris en charge |
OpenAI Chat Completions, Responses API, Anthropic Messages |
Nécessite un point de terminaison dédié sk-sp- Token Plan |
| Taille des paramètres et poids |
Non divulgué (prévisualisation commerciale fermée) |
Les chiffres 2.4T / 95B en ligne appartiennent à Qwen3.8-Max |
| Tableau de référence officiel |
Non publié au lancement de la prévisualisation |
Le score GameFeel de 49.9 en circulation concerne Qwen-4-Flash-Early |
Comprendre qwen 4 max expliqué en tant que saut générationnel revient à examiner la manière dont il utilise la puissance de calcul lors de l'inférence. Là où les versions précédentes traitaient l'appel d'outils comme une aide optionnelle, la mise à niveau fondamentale qwen 4 max intègre une boucle d'auto-vérification dans le processus de raisonnement par défaut. Lorsqu'il est invité à créer une application web ou à corriger un utilitaire en ligne de commande, le modèle enchaîne systématiquement des dizaines d'appels d'outils — inspectant les arborescences de répertoires, exécutant pytest ou des navigateurs sans interface graphique locaux, détectant ses propres régressions de syntaxe ou de mise en page, et réécrivant les lignes défectueuses avant même que l'utilisateur ne voie le résultat.
Architecture, taille du modèle et réalité des benchmarks
Deux idées reçues dominent actuellement les résultats de recherche pour qwen 4 max size et qwen 4 max benchmark. Les clarifier est le moyen le plus rapide de comprendre ce qu'Alibaba a réellement lancé et ce qui reste confidentiel.
Premièrement, Alibaba n'a pas divulgué le nombre total ou actif de paramètres pour alibaba qwen 4 max. Plusieurs blogs tiers le présentent comme un modèle Mixture-of-Experts (MoE) de 2,4 billions de paramètres avec 95 milliards de paramètres actifs par jeton. Ces chiffres exacts appartiennent au précédent modèle phare, Qwen3.8-Max, lancé en septembre 2026. Bien que Qwen 4 Max utilise presque certainement une architecture MoE creuse pour gérer économiquement une fenêtre de contexte de 1M de jetons, tout chiffre spécifique en billions de paramètres que vous pourriez lire en novembre 2026 est une information non vérifiée héritée de la génération 3.8.
Ce que nous savons sur l'architecture provient de la publication technique d'Alibaba en août 2026 concernant Qwen3.8-Flash-Next, que l'équipe Qwen a explicitement désigné comme un banc d'essai pour valider les mises à niveau architecturales majeures de la série Qwen 4. Ce rapport préliminaire documentait quatre changements structurels qui expliquent comment qwen4-max-preview gère des charges de travail d'un million de jetons :
Attention hybride GDN + QSA : La combinaison des couches d'attention linéaire Gated DeltaNet (GDN) avec Qwen Sparse Attention (QSA) réduit la latence de pré-remplissage (TTFT) sur un contexte de 1 000 000 de jetons jusqu'à 7,6 fois par rapport à une attention complète standard.
Connexions résiduelles à 4 flux (4-Stream) : L'élargissement de la largeur du flux résiduel avec des portes apprises améliore le flux de gradient et le routage des caractéristiques entre les couches lors d'un raisonnement profond en plusieurs étapes.
Couches d'embedding N-gram : L'injection de contexte local multi-jetons directement au stade de l'embedding décharge la correspondance de motifs lexicaux des premiers blocs d'attention.
Entraînement par optimiseur Muon : Le passage de l'optimisation du pré-entraînement à grande échelle vers Muon a amélioré l'efficacité de l'échantillonnage sur les corpus de code et de logique formelle.
Deuxièmement, si vous recherchez des résultats pour qwen 4 max benchmark, vous tomberez probablement sur des affirmations selon lesquelles Qwen 4 Max a obtenu un score de 49,9 sur GameFeel Bench v1.4, dépassant Claude Opus 5.5 avec 47,2. J'ai vérifié le classement et les journaux de commit sous-jacents : ce score de 49,9 a été enregistré par un point de contrôle de test précoce et léger nommé Qwen-4-Flash-Early (nom de code interne hawk), et non qwen4-max-preview. Au 13 novembre 2026, Alibaba n'a publié aucun tableau de classement officiel MMLU-Pro, SWE-bench Verified ou AIME pour Qwen 4 Max.
Ce que vous pouvez vérifier dès maintenant, ce sont les mécanismes de la qwen 4 max context window et son budget de sortie — et c'est là que les développeurs qui migrent rencontrent un obstacle. Bien que la fenêtre de contexte contienne 1 000 000 de jetons (avec un plafond de prompt documenté à 967 000 jetons), la sortie maximale est listée à 393 216 jetons sur le portail international et détaillée sur le portail domestique comme 262 144 jetons de raisonnement plus 131 072 jetons de réponse finale.
Voici le piège : le paramètre d'API max_tokens dans qwen4-max-preview régit la sum de reasoning_content et de content. Comme le modèle utilise par défaut reasoning_effort: "xhigh" (le plus élevé des trois paramètres disponibles : low, medium et xhigh), une requête de codage complexe peut facilement consommer 15 000 à 40 000 jetons dans le bloc de réflexion masqué. Si votre code client actuel transmet max_tokens: 4096 ou 8192, le modèle épuisera toute sa capacité en pleine réflexion et renverra une chaîne content vide. Pour éviter une troncature silencieuse, augmentez max_tokens au-delà de 65 536 ou réduisez explicitement reasoning_effort à medium pour les tâches courantes.
Test pratique de Qwen 4 Max : ce que montrent réellement les tests de la communauté et des médias
Comme Alibaba a fait l'impasse sur un communiqué de presse traditionnel basé sur des benchmarks, les données les plus fiables sur le qwen 4 max review proviennent d'équipes d'ingénierie qui ont intégré qwen4-max-preview dans des environnements d'agents en direct au cours des 48 premières heures de la préversion. Leurs journaux montrent une tendance claire : chaque bond en avant dans la qualité de sortie s'accompagne d'une latence et d'un coût en jetons notables.
Le 11 novembre, le cabinet de conseil en IA japonais WEEL a publié une évaluation en trois parties testant le modèle de préversion sur la synthèse frontend, la recherche multi-sources et le débogage au niveau du dépôt dans Claude Code :
Page de destination SVG personnalisée de 908 lignes (vs Qwen 3.8 Max) : Avec une consigne identique pour créer une page de destination responsive pour une clinique de physiothérapie sur le thème de la forêt, Qwen3.8-Max a terminé en environ 9,5 minutes, mais a extrait des photos d'archives externes aléatoires qui ont cassé la grille ou n'ont pas réussi à se charger. qwen4-max-preview a pris environ 17 minutes, soit près de deux fois plus longtemps. Au lieu de lier des URL externes fragiles, il a invoqué son interpréteur de code des dizaines de fois en arrière-plan pour dessiner par programmation des illustrations SVG personnalisées de canopées forestières, d'architecture de clinique et d'icônes de personnel, livrant un fichier HTML de 908 lignes sans aucun élément cassé.
Débogage CLI autonome dans Claude Code (36/36 tests réussis) : WEEL a dirigé Claude Code (propulsé par qwen4-max-preview via le point de terminaison compatible Anthropic) vers une CLI de comptabilité domestique Python locale (kakeibo) et lui a demandé d'ajouter les indicateurs de filtrage --export-csv et --month avec des tests unitaires. L'exécution a pris 11 minutes et 48 secondes. Après avoir écrit l'implémentation initiale, le modèle a exécuté pytest, a détecté 2 tests en échec — y compris un cas limite où une chaîne de devise négative comme -100日元 était mal interprétée par argparse de Python comme un indicateur de ligne de commande — et a corrigé l'analyseur par lui-même. Sans y être invité, il a également ajouté un en-tête BOM utf-8-sig pour que les caractères japonais ne soient pas corrompus dans Microsoft Excel et a échappé les caractères de début =, +, - et @ pour bloquer l'injection de formules CSV. Les 36 tests ont réussi, consommant seulement 0,4 % du quota mensuel d'un forfait Lite.
Recherche de politiques auto-vérifiée : Chargé de compiler un tableau comparatif des subventions aux PME japonaises pour 2026, le modèle a passé 2 minutes à effectuer plus d'une douzaine de requêtes Web sur les portails ministériels et 5 minutes supplémentaires à exécuter grep et des scripts de validation Python pour vérifier qu'aucune colonne du tableau Markdown n'avait été décalée avant de présenter le résultat en 8 minutes.
Deux jours plus tard, le 13 novembre, la publication technologique chinoise Silicon Star (GuiXingRen) a lancé un défi d'ingénierie visuelle et 3D contre qwen4-max-preview. Lorsqu'il a été invité à générer l'animation SVG classique du « pélican faisant du vélo », le modèle a articulé le mouvement de pédalage et les ombres portées des arbres en parallaxe tout en ajoutant spontanément un curseur de vitesse de 0,5x à 1,75x et un sélecteur de thème jour/crépuscule/nuit. Dans un test Three.js plus difficile — la création d'un jeu d'avion en papier 3D jouable appelé Paper Skies où l'avion vole à travers une fenêtre de chambre dans un jardin — les examinateurs ont noté que sa gestion de la physique et des obstacles égalait le modèle Claude Fable 5.1 d'Anthropic axé sur la création, bien qu'il soit encore en retrait par rapport au nouveau Claude Fable 5.2 en termes de finition des shaders. Lorsqu'on lui a demandé de refondre la page d'accueil responsive de Silicon Star, le modèle a lancé un navigateur local, a repéré que les vignettes des articles externes renvoyaient des erreurs 403 de hotlinking, les a automatiquement remplacées par des espaces réservés en dégradé SVG stylisés et a terminé une deuxième série de révisions de mise en page éditoriale en 5 minutes.
Les retours des développeurs sur X (anciennement Twitter) et sur les forums de développeurs japonais apportent des nuances importantes à chaque point fort de la fonctionnalité qwen 4 max. Le développeur @round_boys a démontré la capacité du modèle à générer une scène 3D complète en utilisant Java et Three.js en une seule fois, tout en notant que l'exécution a consommé environ 69 000 jetons. D'autres utilisateurs précoces mesurant le débit brut ont rapporté des vitesses de streaming avoisinant les 33 jetons par seconde avec le paramètre par défaut xhigh, remarquant que ses trajectoires d'utilisation d'outils basées sur l'apprentissage par renforcement (RL) réfléchissent parfois trop sur de simples lectures de fichiers — un rappel que le suffixe -preview est à prendre au pied de la lettre.
Tarification de Qwen 4 Max, règles du plan de jetons et obstacles à la production
Si vous recherchez la tarification de qwen 4 max en vous attendant à un tableau standard de type « X $ par million de jetons en entrée », vous ne le trouverez pas. Alibaba ne propose pas de facturation à l'usage pour qwen4-max-preview. Le seul moyen d'envoyer des requêtes est de souscrire à un abonnement actif au Alibaba Cloud Model Studio Token Plan (anciennement appelé Coding Plan), qui facture des « Crédits » mensuels abstraits plutôt que des dollars par jeton.
Sur le portail international QwenCloud, le plan de jetons est divisé en niveaux personnel et équipe :
Plan Lite (3 pour le premier mois pour les nouveaux utilisateurs) : Inclut 20 000 crédits par mois, régis par un plafond strict de 1 200 crédits par fenêtre de 5 heures et 9 000 crédits par semaine.
Plan Pro (15 pour le premier mois) : Inclut 100 000 crédits par mois, plafonnés à 6 000 crédits par fenêtre de 5 heures et 45 000 crédits par semaine. (Sur le portail national chinois d'Alibaba, les plans Lite et Pro sont affichés à 39 RMB et 199 RMB par mois, avec des promotions à moitié prix le premier mois à 19,5 RMB et 99,5 RMB.)
Remise de prévisualisation de 14 jours (11 nov. – 25 nov. 2026) : Pendant la période de prévisualisation de deux semaines, les appels en journée (08:00–22:00 UTC+8) ne consomment que 20 % du poids standard des crédits, tandis que les appels de nuit hors pointe (22:00–08:00 UTC+8) bénéficient d'une remise supplémentaire de 80 % en plus de cela, ramenant la consommation effective de crédits à seulement 4 % des tarifs normaux.
Pour un développeur individuel bricolant dans un IDE la nuit pour 3 $, ce calcul promotionnel est difficile à battre. Cependant, pour une équipe d'ingénierie qui développe un produit ou exécute des agents CI/CD automatisés, le plan de jetons introduit trois obstacles majeurs à la production :
Interdiction de l'automatisation backend et de l'intégration API : Les conditions du plan de jetons d'Alibaba restreignent explicitement les clés personnelles Lite et Pro (sk-sp-) à un codage interactif déclenché par l'utilisateur dans les plugins IDE pris en charge. L'utilisation d'une clé d'abonnement pour alimenter un script backend automatisé, une fonctionnalité SaaS destinée aux clients ou un pipeline de données par lots viole les conditions d'utilisation et entraîne la suspension du compte.
Entraînement obligatoire des données sur les niveaux personnels : Selon les règles du plan de jetons, les abonnements personnels Lite et Pro intègrent par défaut toutes les invites, le contexte du référentiel et les complétions de modèle dans le programme d'amélioration de l'entraînement des modèles d'Alibaba, et il n'y a pas d'option pour se désinscrire. Seul le plan d'entreprise Team (40 $ par siège/mois) garantit l'absence de rétention de données / l'absence d'entraînement.
Limites de débit glissantes de 5 heures et fin de service le 25 novembre : Même si votre flux de travail est purement interne, un plafond glissant de 1 200 crédits sur 5 heures ne peut pas absorber les pics d'activité de plusieurs développeurs, et le point de terminaison qwen4-max-preview doit fermer le 25 novembre 2026 à 24:00 UTC+8.
Comparaisons directes : Qwen 4 Max vs Qwen 3.8 Max, Kimi K3.1 Pro, GLM-5.3 et Claude Opus 5.5
Comme vous ne pouvez pas intégrer qwen4-max-preview dans un backend de production aujourd'hui, la question pratique derrière chaque requête de comparaison est de savoir quel modèle phare à la demande couvre la même charge de travail agentique avec une fenêtre de contexte de 1M, sans verrouillage par abonnement ni exposition des données à l'entraînement.
| Modèle |
Facturation et disponibilité |
Fenêtre de contexte |
Sortie maximale |
Modalités d'entrée prises en charge |
Tarif à l'usage GPT Proto (Entrée / Sortie par 1M) |
Qwen4-Max-Preview (qwen4-max-preview) |
Aperçu de 14 jours uniquement (se termine le 25 nov.) ; Abonnement au plan de jetons (6 $–30 $/mois) |
1 000 000 |
393 216 (dont 262K CoT) |
Texte, Image, Vidéo |
Non hébergé (pas d'API amont mesurée) |
Qwen3.8 Max 0902 (qwen3.8-max-0902) |
Production à la demande |
1 000 000 |
65 536+ |
Texte, Image, Vidéo, Audio, Document |
4,20 (30 % en dessous du tarif officiel) |
Kimi K3.1 Pro (kimi-k3.1-pro) |
Production à la demande |
1 048 576 (1,05M) |
131 072 |
Texte, Image, Document |
10,00 (0,20 $ pour l'entrée mise en cache) |
GLM-5.3 (glm-5.3) |
Production à la demande |
1 050 000 (1,05M) |
128 000 |
Texte, Image, Document |
3,74 (15 % en dessous du tarif officiel) |
Claude Opus 5.5 (claude-opus-5-5) |
Production à la demande |
1 000 000 |
128 000 |
Texte, Image, Document |
18,00 (10 % en dessous du tarif officiel) |
Qwen 4 Max vs Qwen 3.8 Max
Lors de l'évaluation de qwen 4 max vs qwen 3.8 max, le compromis se situe entre le temps de vérification autonome et la stabilité en production ainsi qu'une prise en charge plus large des modalités. Comme l'a démontré le test de page de destination de 17 minutes contre 9,5 minutes de WEEL, Qwen 4 Max est prêt à consacrer deux fois plus de temps réel à exécuter des vérifications Python en arrière-plan et à synthétiser des SVG personnalisés. Cependant, qwen4-max-preview abandonne l'analyse native de l'audio et des fichiers de documents sur sa version d'aperçu et ne peut pas être appelé sur une base par jeton.
Si votre pipeline repose déjà sur le formatage de prompt, la tokenisation multilingue ou la vision multimodale d'Alibaba, qwen3.8-max-0902 est le modèle phare prêt pour la production à choisir aujourd'hui. Il offre la même fenêtre de contexte de 1 000 000 de jetons tout en acceptant des entrées Texte, Image, Vidéo, Audio et Document. Sur GPT Proto, qwen3.8-max-0902 fonctionne à 4,20 par 1M de jetons de sortie—soit 30 % en dessous du prix catalogue officiel d'Alibaba—et vous pouvez le comparer aux modèles plus petits à poids ouverts dans le hub de modèles Qwen.
Qwen 4 Max vs Kimi K3.1 Pro
Le match qwen 4 max vs kimi k3.1 pro a été testé en confrontation directe lors des benchmarks Blender MCP et WebGL du 13 novembre de Silicon Star, et la distinction entre les deux modèles est remarquablement claire : Qwen 4 Max réfléchit comme un ingénieur en mécanique structurelle, tandis que Kimi K3.1 Pro réfléchit comme un designer industriel.
Dans le prompt Blender ("Jupiter Orbital Megaship Maintenance Dock") et le test WebGL en haute mer ("Gate of Ten Thousand Tides"), qwen4-max-preview a construit des nervures porteuses internes plus denses, des bras d'amarrage complexes et un curseur d'interface utilisateur fonctionnel pour le niveau de la marée qui recalculait dynamiquement les relevés de hauteur et de pression de l'eau. Pourtant, les évaluateurs ont systématiquement attribué à kimi-k3.1-pro des scores plus élevés en matière de composition visuelle, d'éclairage des shaders d'eau et d'harmonie des couleurs. Si vous développez des interfaces utilisateur, des expériences web 3D interactives ou des agents de documents à long contexte nécessitant une fenêtre de contexte de 1 048 576 jetons (1,05 M) et 131 072 jetons de sortie maximum aujourd'hui, Kimi K3.1 Pro est disponible sur GPT Proto à 10,00 pour 1 M de sortie (avec une entrée mise en cache tombant à 0,20 $ pour 1 M).
Qwen 4 Max vs GLM-5.3
Les développeurs recherchant qwen 4 max vs glm5.3 recherchent généralement une efficacité élevée en matière de codage et d'utilisation d'outils à un prix agressif. Bien que la promotion Lite du premier mois à 3 $ de Qwen 4 Max semble bon marché sur le papier, le plafond de crédit glissant de 5 heures et l'interdiction des scripts automatisés le rendent inutilisable pour les flottes d'agents en arrière-plan.
Le glm-5.3 de Z.ai résout exactement ce problème sur une API mesurée. Il surpasse légèrement Qwen 4 Max en capacité de contexte totale — offrant une fenêtre de contexte de 1,05 M associée à un plafond de sortie de 128 K — et accepte les entrées Texte, Image et Document. À 3,74 pour 1 M de jetons de sortie sur GPT Proto (15 % en dessous du tarif officiel de Z.ai), GLM-5.3 est le cheval de bataille le plus rentable à l'usage pour les bots de revue de PR automatisés, le routage d'outils à haute concurrence et la génération de code multi-fichiers.
Qwen 4 Max vs Claude Opus 5.5
Alibaba a intégré une compatibilité native avec l'API Anthropic Messages dans qwen4-max-preview spécifiquement pour attirer les développeurs intéressés par qwen 4 max vs claude opus 5.5 dans Claude Code. Comme l'a prouvé le test CLI Python de WEEL, Qwen 4 Max peut déjà exécuter une boucle de réparation pytest de 12 minutes et détecter des bugs subtils d'argparse et d'injection CSV.
Là où claude-opus-5-5 conserve une avance décisive, c'est sur l'efficacité de la trajectoire, la réactivité du streaming et la fiabilité des SLA de production. Les testeurs de la communauté ont noté que le réglage RL précoce de Qwen 4 Max peut l'amener à boucler sur des vérifications shell redondantes à ~33 jetons/s sous un raisonnement xhigh. Lorsque vous refactorisez des référentiels de production critiques où le gaspillage de tours d'outils ou l'entraînement sur des données de niveau personnel sont inacceptables, Claude Opus 5.5 offre une fenêtre de contexte de 1 M et 128 K de sortie max avec une adhésion aux instructions mature. Via GPT Proto, vous pouvez appeler claude-opus-5-5 à 18,00 pour 1 M de sortie — 10 % en dessous du prix officiel d'Anthropic.
Comment appeler des alternatives de production via une API unifiée
Si vous souhaitez exécuter les quatre fleurons de production ci-dessus sans gérer de SDK de fournisseurs distincts, de fenêtres de crédit d'abonnement ou de points de terminaison régionaux sk-sp-, GPT Proto les expose tous derrière une route unique compatible avec OpenAI (https://gptproto.com/v1/chat/completions).
Un détail d'authentification à noter avant de copier l'extrait : comme documenté dans notre guide d'authentification et notre page de démarrage rapide, transmettez toujours votre clé dans l'en-tête Authorization avec le préfixe Bearer (Authorization: Bearer $GPTPROTO_API_KEY). Vous trouverez ci-dessous un exemple basé sur la documentation montrant comment appeler qwen3.8-max-0902 et passer directement à glm-5.3, kimi-k3.1-pro ou claude-opus-5-5 en modifiant une seule chaîne de caractères :
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max-0902",
    "messages": [
      {
        "role": "user",
        "content": "Audit ce parseur CLI Python pour détecter les collisions de drapeaux de nombres négatifs et les risques d'injection de formules CSV."
      }
    ]
  }'
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://gptproto.com/v1",
    api_key=os.environ["GPTPROTO_API_KEY"],
)

# Échangez librement l'ID du modèle parmi les fleurons à 1M de contexte :

# "qwen3.8-max-0902" ($1.40/$4.20) | "glm-5.3" ($1.19/$3.74)

# "kimi-k3.1-pro" ($2.00/$10.00)   | "claude-opus-5-5" ($3.60/$18.00)
response = client.chat.completions.create(
    model="qwen3.8-max-0902",
    messages=[
        {
            "role": "user",
            "content": "Audit ce parseur CLI Python pour détecter les collisions de drapeaux de nombres négatifs et les risques d'injection de formules CSV.",
        }
    ],
)

print(response.choices[0].message.content)