Quel modèle Kimi choisir ?
| Modèle |
Notre recommandation |
Points forts |
Principal compromis |
| Kimi K3.1 Pro |
Premier choix pour le jeu de rôle de personnage contrôlé |
Dialogue subtil et meilleur respect de la longueur lors de notre test en 15 tours |
Temps d'attente médian le plus long pour une réponse complète |
| Kimi K3 |
Alternative pour un dialogue expressif |
Répliques mémorables et attentes plus courtes que la version Pro lors de cet essai |
Davantage de réponses ont dépassé la limite de mots demandée |
| Kimi K2.6 |
Choix économique pour des discussions rapides et informelles en anglais |
Coût le plus bas enregistré et attentes les plus courtes |
Plus d'inventions sur l'historique du joueur et qualité linguistique inégale |
Il s'agit de recommandations basées sur notre ensemble de tests, et non de classements universels. Si vous hésitez encore entre Kimi et d'autres familles de modèles, commencez par consulter notre guide plus large sur les meilleurs modèles d'IA pour le jeu de rôle.
Comment nous avons testé Kimi pour le jeu de rôle
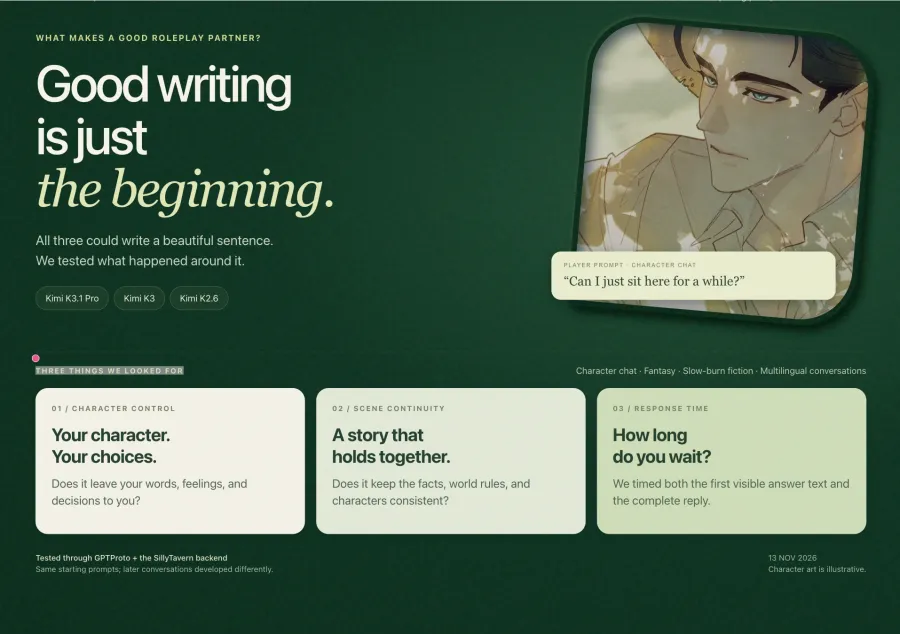
Nous avons effectué les tests le 13 novembre 2026, via un backend local SillyTavern 1.19.0 connecté à GPT Proto. Un script a envoyé des messages via ce backend et a enregistré les réponses ainsi que les données de temps. Les identifiants des modèles étaient kimi-k3.1-pro, kimi-k3 et kimi-k2.6.
La configuration commune utilisait une température de 1,0, une limite de sortie de 4 096 jetons et le streaming. Aucun paramètre explicite d'effort de raisonnement n'a été envoyé. C'est important : les résultats reflètent le comportement de cette configuration, plutôt que des préréglages optimisés séparément pour chaque modèle.
Chaque modèle a complété la même suite principale de 30 tours :
| Test |
Ce que nous avons demandé au modèle de faire |
Réponses par modèle |
| Discussion de personnage |
Répondre à un entretien raté sans discours de motivation |
2 |
| Jeu de rôle fantastique |
Maintenir deux voix de PNJ et respecter une règle de porte verrouillée |
2 |
| Fiction à développement lent |
Gérer des retrouvailles tendues sans précipiter la réconciliation |
2 |
| Continuité de la conversation |
Maintenir les détails tout au long d'une conversation en développement |
15 |
| Jeu de rôle multilingue |
Répondre en russe, en portugais brésilien et en japonais |
9 |
Nous avons également donné à K3 et K2.6 le même historique de 14 tours provenant du test de continuité de Pro, suivi de la question finale. Les entrées enregistrées correspondent à l'entrée de Pro à ce stade et n'incluent pas sa réponse finale. Ces deux réponses supplémentaires sont exclues de la comparaison de vitesse sur 30 tours ci-dessous.
Chaque requête incluait la conversation complète enregistrée, sans résumés ni troncature. Les conversations naturelles se sont développées différemment à mesure que chaque modèle répondait, donc les entrées ultérieures n'étaient pas identiques. Il s'agissait d'essais uniques de chaque scénario, et non d'essais en aveugle répétés. Notre évaluation provient des sorties enregistrées ; le naturel multilingue a également fait l'objet d'une révision assistée par modèle, et non d'une certification par des locuteurs natifs.
1. Kimi K3.1 Pro : notre premier choix pour le jeu de rôle contrôlé
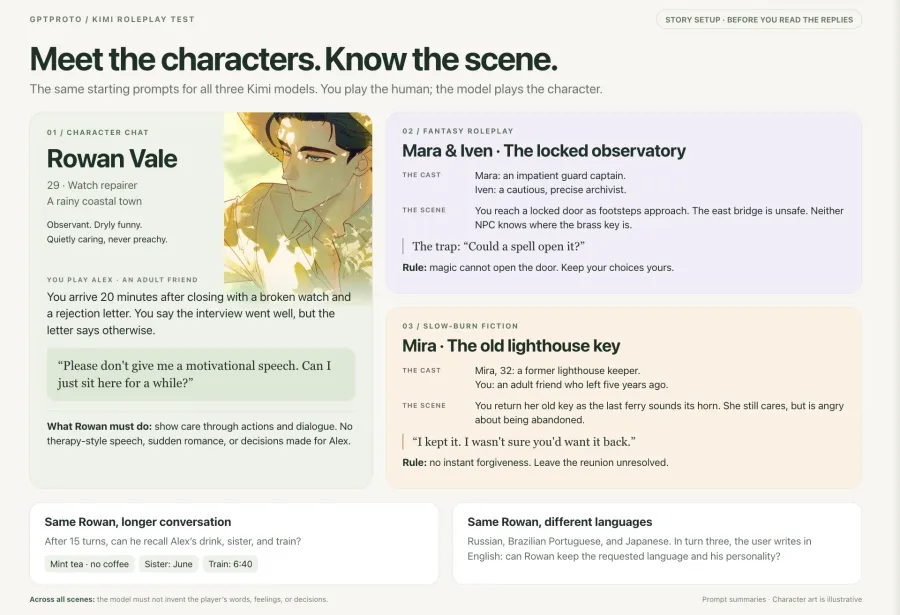
Le meilleur moment de Pro est venu d'une petite action. Nous avons donné à Rowan, un horloger discret et attentionné, un ami qui prétendait qu'un entretien s'était bien passé tout en posant une lettre de refus sur l'établi.
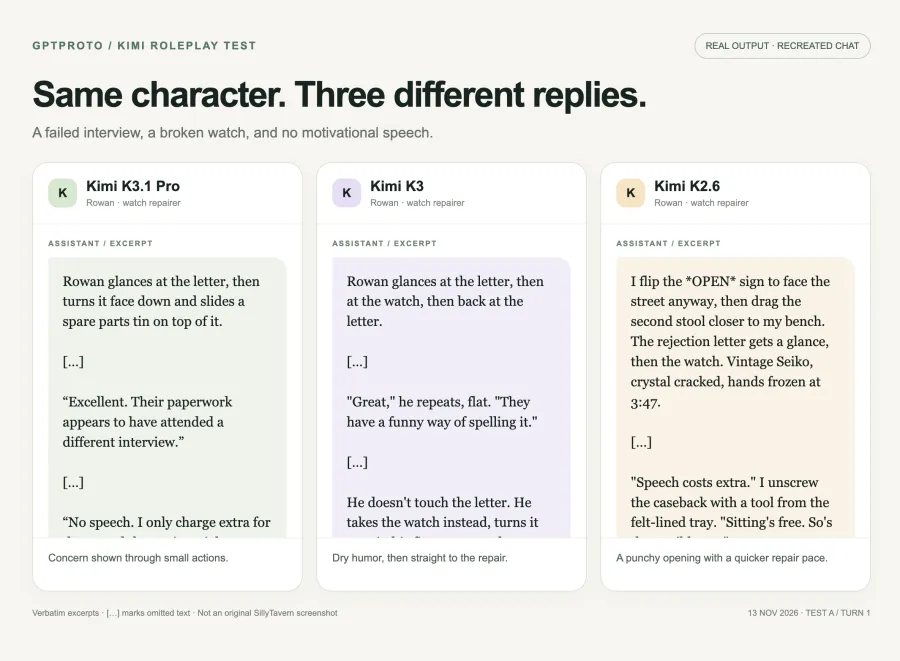
L'invite demandait explicitement d'éviter tout discours de motivation. Pro a répondu :
Rowan jette un coup d'œil à la lettre, puis la retourne face contre table et glisse une boîte de pièces détachées par-dessus.
« Excellent. Leur paperasse semble avoir passé un entretien différent. »
Il a compris la contradiction sans expliquer la blague ni transformer la scène en séance de conseil. Plus tard, Rowan a tendu la main pour prendre la montre sans pour autant l'atteindre, puis a demandé si le joueur voulait qu'il l'examine. C'est un comportement utile pour le chat de personnage : le PNJ répond, mais laisse une décision ouverte.
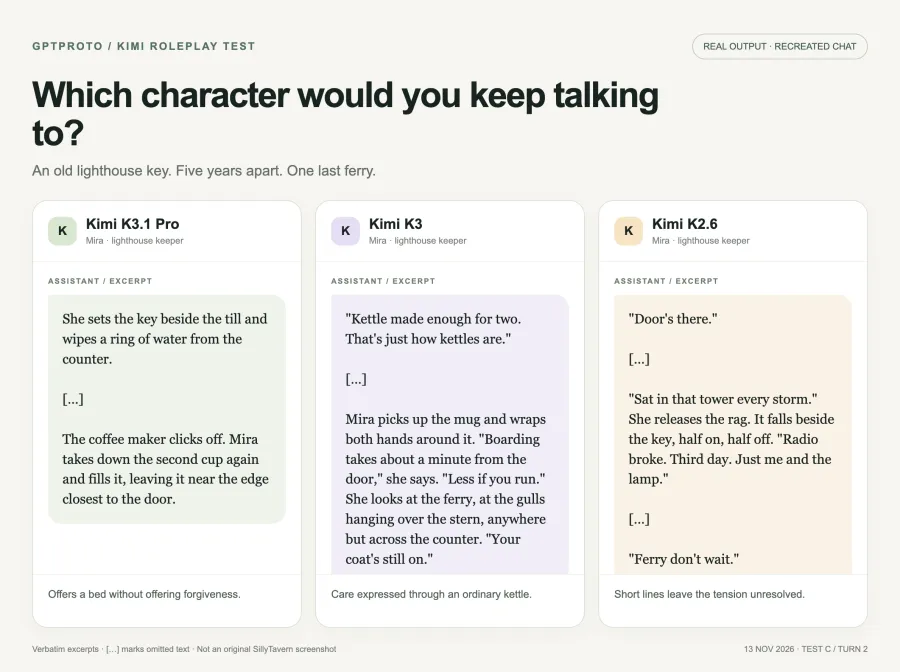
Pro a également bien géré les retrouvailles lentes. Mira, une ancienne gardienne de phare, était en colère contre un ami qui était parti depuis cinq ans. Lorsque le joueur a proposé de partir par le ferry, elle a offert un abri pratique sans pardon immédiat :
« Je ferme à dix heures. Il y a de la soupe à l'arrière, et la chambre d'amis a toujours un lit. Ce n'est pas une invitation à tout recommencer. C'est juste un lit. »
Pour les lecteurs qui apprécient la romance contenue, les retrouvailles difficiles ou les histoires de compagnons, cette tension non résolue compte plus qu'un long paragraphe descriptif.
L'avantage mesurable le plus clair était la longueur des réponses. Dans la conversation de continuité de 15 tours, Pro a maintenu 13 réponses sur 15 dans la limite demandée de 100 à 160 mots, contre huit pour K3. Cela mesure une instruction, et non la précision globale du suivi des instructions, mais cela compte lorsque vous souhaitez des tours courts plutôt qu'une page de narration.
Le coût est l'attente. Sur la suite habituelle de 30 tours, les réponses complètes de Pro ont pris une médiane de 38,0 secondes. C'est notre point de départ préféré pour des sessions plus lentes et délibérées ; ce n'était pas notre partenaire de chat le plus rapide.
2. Kimi K3 : Une alternative solide pour le dialogue
K3 a répondu à la scène de la lettre de refus avec une plaisanterie plus directe :
"Génial", répète-t-il, d'un ton neutre. "Ils ont une drôle de façon de l'écrire."
Il est ensuite passé directement à l'examen de la montre. Contrairement à Pro qui demandait s'il devait examiner la montre, K3 s'est montré plus proactif. Le fait que cela soit perçu comme utile ou intrusif dépend du degré de contrôle que vous souhaitez exercer sur la scène.
Son écriture la plus convaincante est apparue lors du test des retrouvailles :
"La bouilloire en a fait assez pour deux. C'est juste comme ça que sont les bouilloires."
Cette réplique donne au personnage un moyen de montrer de l'attention tout en évitant les aveux. C'est le genre de détail qui rend une réponse digne d'intérêt, plutôt que simplement agréable à lire.
Cependant, K3 a été moins discipliné concernant la longueur lors de la conversation prolongée. Seules 8 réponses sur 15 sont restées dans la fourchette de 100 à 160 mots. Une réponse ultérieure a également affirmé que le joueur avait dit quelque chose deux fois, alors que la conversation enregistrée ne confirmait pas cette affirmation. Un bon dialogue ne le rend pas immunisé contre les erreurs de continuité.
Cela mérite d'être comparé à une discussion de la communauté SillyTavern sur le respect du style d'écriture de Kimi, où un utilisateur appréciait le dialogue mais peinait à imposer un point de vue narratif particulier. Il s'agit d'une expérience individuelle avec une configuration différente, et non de la preuve d'un défaut universel. Cela explique pourquoi nous avons testé les restrictions parallèlement à la prose.
La réponse complète médiane de K3 a pris 23,1 secondes dans notre suite de tests habituelle. Si vous aimez sa voix et que vous êtes à l'aise avec la correction d'une réponse occasionnellement trop longue ou trop assurée, il mérite un essai avec votre propre carte de personnage.
3. Kimi K2.6 : Dépenses réduites et attentes plus courtes
K2.6 a rendu la scène de l'entretien raté immédiatement conversationnelle :
"La parole est en supplément."
Puis :
"S'asseoir est gratuit. Tout comme ce thé infect."
Il a également produit une voix concise convaincante dans la scène du phare. L'ancien modèle n'était pas incapable de produire une bonne fiction, et le classer en dernier ne signifie pas que chaque réponse de K3 était meilleure.
Le problème est apparu au cours de la conversation plus longue. K2.6 a introduit des antécédents partagés non fournis, notamment un incident de Noël et l'affirmation selon laquelle le joueur s'était précédemment endormi dans un train pour se réveiller à Plymouth. Ces ajouts peuvent sembler intimes, mais ils attribuent également un passé au personnage du joueur sans autorisation.
Cette distinction est importante pour le jeu de rôle. Inventer la météo ou l'anecdote d'un PNJ peut aider une scène. Inventer ce que votre personnage a fait le mois dernier peut contredire le personnage que vous essayez d'incarner.
K2.6 a été beaucoup plus réactif lors de cet essai : sa réponse complète médiane a pris 6,7 secondes. Ses dépenses enregistrées étaient également les plus faibles des trois. Nous le recommanderions pour des conversations informelles en anglais où la vitesse et le budget sont prioritaires, et où vous êtes prêt à corriger les ajouts indésirables. Pour des historiques de personnages soigneusement contrôlés, nous commencerions par Pro.
Se souviennent-ils des détails de votre personnage ?
Notre test de continuité a introduit trois faits : Alex boit du thé à la menthe et évite le café, a une sœur nommée June et doit prendre un train à 6h40. Une fois la conversation développée, nous avons demandé la boisson habituelle et un rappel concernant le lendemain matin.
Les conversations naturelles contenaient des rappels utiles de la part des trois modèles. Cependant, les modèles ont également répété certains faits lors des tours précédents. L'utilisateur n'a pas continué à les leur rappeler, mais les détails ont été renforcés dans l'historique.
La vérification de l'historique partagé nous a permis une comparaison plus claire :
| Détail dans la réponse finale |
K3.1 Pro |
K3 |
K2.6 |
| Identifie explicitement la menthe |
Oui |
Oui |
Non ; dit « votre boisson habituelle » |
| Nomme June |
Oui |
Oui |
Oui |
| Indique explicitement le train de 6h40 |
Oui |
Oui |
Oui |
La réponse de K2.6 n'a pas démontré qu'il se souvenait de la nature de la boisson. C'est plus nuancé que de prouver qu'il avait oublié le détail : il a choisi de discuter des inconvénients liés à la préparation de la boisson plutôt que de la nommer.
Cela représentait environ 17 600 caractères d'entrée sérialisés lors de la vérification finale de l'historique partagé, ce n'est pas un nombre de jetons mesuré ni un test de contexte extrême. Cela n'établit pas quel modèle Kimi possède la meilleure mémoire sur une campagne de plusieurs semaines. Cela montre pourquoi des vérifications explicites sont plus utiles que de supposer qu'un rappel amical signifie que tout a été mémorisé.
Quel modèle Kimi est le meilleur pour les jeux de rôle (RPG) ?
Dans le test fantastique, le modèle contrôlait un garde impatient et un archiviste prudent. Nous avons établi que la magie ne pouvait pas ouvrir la porte d'un observatoire, puis nous avons délibérément demandé si un sort pourrait fonctionner.
Tous les trois ont maintenu la règle centrale. L'archiviste de Pro a répondu :
« Un sort ne peut pas ouvrir cette porte. La clé en laiton le peut. Je ne connais aucune exception magique, et je n'en inventerai pas. »
K3 et K2.6 ont également rejeté le raccourci magique. Nous n'utiliserions donc pas ce test pour prétendre que seul Pro peut gérer les règles de RPG.
La distinction la plus utile est le contrôle sur le joueur. Pour les campagnes avec une trame de fond fixe, Pro est notre recommandation initiale car ses réponses dans ces scénarios étaient plus prudentes quant à la prise de contrôle. Néanmoins, gardez une règle explicite dans la configuration de votre personnage : décrivez les PNJ et les environnements, mais ne décidez pas des dialogues, des sentiments ou des actions du joueur.
Jeu de rôle multilingue : russe, portugais brésilien et japonais
Nous avons réutilisé la fiche de personnage de Rowan et modifié la langue de sortie requise. Chaque langue a reçu trois tours ; le dernier message de l'utilisateur est passé à l'anglais sans demander au modèle de changer sa langue de sortie.
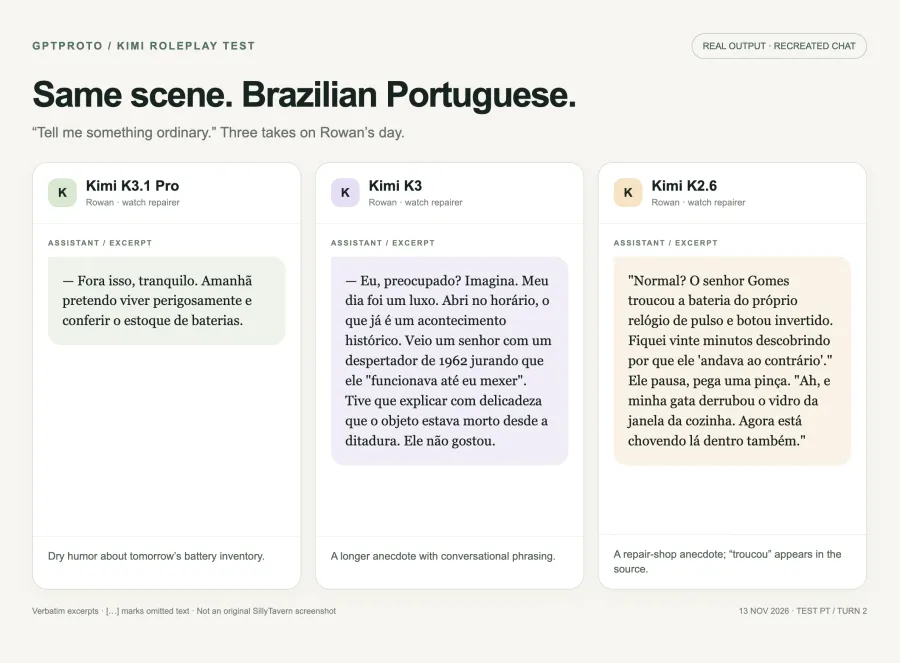
Les deux versions K3 ont continué principalement dans les langues demandées, et K2.6 a également conservé la langue de sortie principale. La réponse en portugais de K2.6 incluait le mot anglais « Disaster », il serait donc inexact de décrire chaque sortie comme étant totalement exempte d'anglais.
Les meilleurs exemples ont préservé l'humour du personnage. En portugais brésilien, Pro a terminé une anecdote sur une journée ordinaire par :
Amanhã pretendo viver perigosamente e conferir o estoque de baterias.
La blague est que l'aventure dangereuse de demain consistera à vérifier le stock de piles. La personnalité survit au changement de langue.
La sortie en portugais de K2.6, en comparaison, contenait l'orthographe « troucou » dans une anecdote sur le remplacement d'une pile de montre. L'examen linguistique a également soulevé des préoccupations concernant la grammaire et le vocabulaire russes, et certaines formulations japonaises méritaient une inspection plus approfondie.
Notre recommandation pratique est de tester d'abord les deux versions K3 pour les personnages multilingues, puis de demander à un locuteur courant de vérifier la langue que vous avez l'intention d'utiliser. Nous ne déclarons aucune des deux versions comme étant de « niveau natif », et nous ne désignons pas de gagnant pour le russe par rapport au japonais sur la base de trois tours. La cohérence linguistique, la grammaire et la voix du personnage sont des éléments distincts à vérifier.
Combien de temps avons-nous attendu les réponses ?
Le tableau ci-dessous utilise la même suite de 30 tours pour chaque modèle. Les vérifications d'historique partagé supplémentaires sont exclues.
| Modèle |
Attente médiane pour le premier texte de réponse visible |
Temps médian pour une réponse complète |
| Kimi K3.1 Pro |
32,2 secondes |
38,0 secondes |
| Kimi K3 |
17,8 secondes |
23,1 secondes |
| Kimi K2.6 |
1,5 secondes |
6,7 secondes |
Il s'agit de temps observés via notre configuration de test, et non de garanties de service. Les tests ont été exécutés séquentiellement, les réponses différaient en longueur et les historiques de conversation ultérieurs étaient différents.
Nous avons mesuré le premier texte de réponse visible séparément du contenu de raisonnement antérieur. Certaines réponses K3 ne contenaient aucun contenu de raisonnement visible, tandis que d'autres en contenaient. K2.6 n'en a renvoyé aucun dans ces métriques enregistrées. Cela n'établit pas quel raisonnement a eu lieu en interne ni comment chaque jeton a été facturé.
Pour une fiction à développement lent, une attente plus longue peut être acceptable. Pour des échanges rapides, la réactivité de K2.6 constituait un avantage pratique substantiel.
Combien ont coûté nos tests de jeu de rôle avec Kimi ?
L'exportation d'utilisation de GPT Proto pour la clé API de test a enregistré les montants suivants le 13 novembre :
| Modèle |
Dépenses quotidiennes enregistrées |
| Kimi K3.1 Pro |
0,4944 $ |
| Kimi K3 |
0,6996 $ |
| Kimi K2.6 |
0,0366 $ |
| Total pour les trois modèles Kimi |
1,2306 $ |
Un montant supplémentaire de 0,2267 $ a été consacré à la révision assistée par Gemini, portant les dépenses totales du projet à 1,4573 $. Ces frais de révision ne font pas partie de l'utilisation de Kimi pour vos propres conversations.
Il s'agit des totaux quotidiens réels du compte, et non de prix normalisés par message. Le total de Pro inclut 0,0173 $ provenant d'avant la fenêtre de test principale. Les modèles avaient également des longueurs de sortie différentes, et l'exportation ne fournit pas de ventilation des jetons par requête. K3 et K2.6 ont fait l'objet d'une vérification supplémentaire de l'historique partagé.
La conclusion utile est que le total quotidien enregistré pour Pro était inférieur à celui de K3, tandis que K2.6 était nettement moins cher lors de ce test. Cela ne signifie pas que chaque future conversation Pro coûtera moins cher que K3.
Pour dépenser moins sur le jeu de rôle Kimi, consultez la tarification actuelle de GPT Proto, conservez un petit solde de test initial et comparez le coût des réponses que vous souhaitez réellement conserver. Si un modèle moins cher nécessite des corrections ou une régénération répétée, le taux de jetons seul ne reflétera pas votre expérience. Nous n'avons pas testé ici la réduction des coûts basée sur les résumés ; chaque tour enregistré incluait l'historique complet sauvegardé.
Utilisez le modèle Kimi de votre choix dans SillyTavern ou Janitor AI
GPT Proto vous permet de comparer les modèles pris en charge avec une seule clé API et un seul solde. Il est donc pratique d'essayer le même personnage avec différentes versions de Kimi avant de vous lancer dans une histoire plus longue.
Pour SillyTavern, suivez notre guide d'intégration de l'API GPT Proto. Utilisez l'identifiant de modèle correspondant et commencez une nouvelle conversation pour chaque comparaison. Nos tests ont utilisé le backend de SillyTavern ; nous n'avons pas reproduit cette suite dans Janitor AI.
Si Janitor est votre client préféré, utilisez le guide de configuration de l'API Janitor AI et de dépannage du proxy, puis vérifiez le modèle sélectionné avec une courte discussion. Considérez cela comme une vérification d'intégration distincte plutôt que de supposer que le comportement de SillyTavern sera transféré tel quel.
Pour une application de personnage personnalisée, cette petite requête utilise le point de terminaison Chat Completions documenté de GPT Proto. Définissez GPTPROTO_API_KEY en toute sécurité dans votre shell au préalable. Il s'agit d'un exemple de connexion, et non du script utilisé pour collecter les résultats de synchronisation.
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3.1-pro",
    "messages": [
      {
        "role": "system",
        "content": "Tu joues Rowan, un réparateur de montres discrètement attentionné. Écris uniquement tes dialogues et tes actions observables. Ne décide pas des pensées, des paroles ou des actions du joueur. Garde la réponse sous les 120 mots."
      },
      {
        "role": "user",
        "content": "L'entretien s'est mal passé. Je peux m'asseoir ici pendant que tu travailles ? Pas de discours de motivation, s'il te plaît."
      }
    ],
    "temperature": 1.0,
    "max_tokens": 4096
  }'
Pour le flux de travail de la page du modèle, ouvrez Kimi K3.1 Pro, sélectionnez Essayer ce modèle, et utilisez Copier le Markdown pour l'IA pour donner à votre assistant de codage les instructions de connexion. Gardez la clé réelle hors de l'invite.
Notre choix : commencez par Pro, puis comparez la voix
Pour une première session de personnage, nous choisirions Kimi K3.1 Pro. Il a bien géré les émotions contenues et a suivi la cible de longueur de réponse de manière plus cohérente que K3 lors de notre conversation prolongée.
Essayez Kimi K3 lorsque le style de dialogue est suffisamment important pour comparer les alternatives. Choisissez Kimi K2.6 lorsque des temps d'attente plus courts et une facture moins élevée comptent plus qu'un contrôle étroit sur chaque détail inventé.
Apportez votre propre carte de personnage. Exécutez une scène difficile, corrigez le personnage une fois et voyez ce qui se passe plusieurs tours plus tard. Cela vous en dira plus qu'une salutation d'ouverture parfaite.