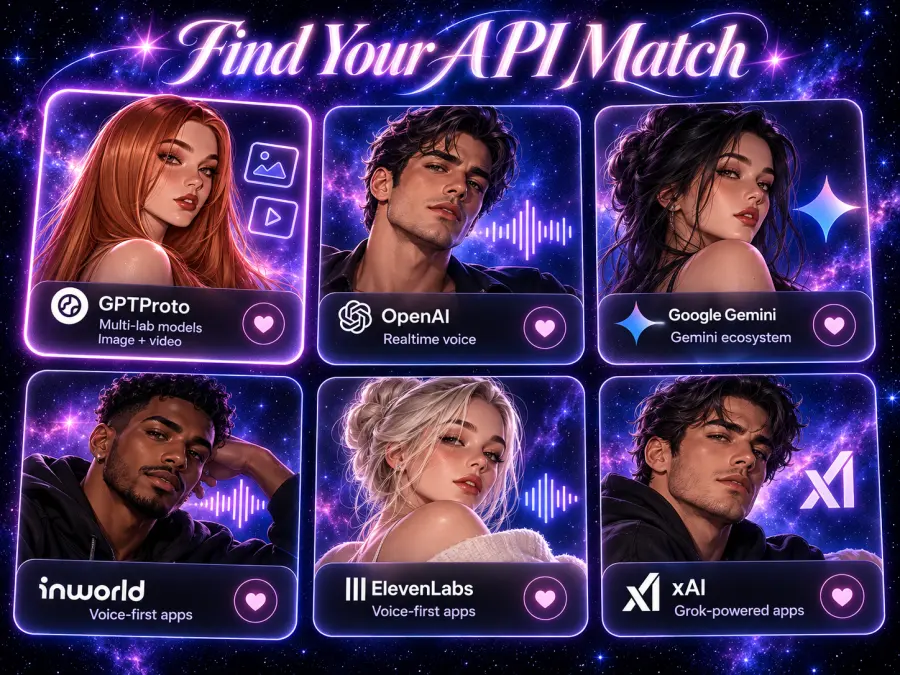
Aperçu des meilleurs fournisseurs d'API pour les applications de compagnons IA
| Fournisseur |
Utilisation idéale |
Capacités à évaluer |
Principal compromis |
| GPT Proto |
Combinaison de modèles de différents laboratoires avec du contenu visuel |
Modèles de chat, d'image et de vidéo pris en charge sous une seule clé et un seul solde |
Votre application gère toujours l'état du personnage et la mémoire persistante |
| OpenAI |
Intégration directe avec les modèles vocaux en temps réel d'OpenAI |
Texte, génération d'images, parole et interaction audio en temps réel |
L'accès à d'autres familles de modèles nécessite des intégrations supplémentaires |
| Google Gemini API |
Produits utilisant l'écosystème IA de Google |
Chat Gemini, interaction en direct, génération d'images et modèles vidéo |
L'entrée en direct et les médias générés utilisent des capacités de modèles différentes |
| Inworld |
Expériences vocales en temps réel configurables |
STT, LLM sélectionnables, TTS, ainsi que l'inférence d'images et de vidéos |
La mémoire inter-sessions nécessite le stockage et la restauration par l'application |
| ElevenLabs |
Produits axés sur la voix nécessitant également du contenu visuel |
Agents, voix configurables et API de génération d'images/vidéos |
L'accès à l'API média nécessite un abonnement |
| xAI |
Produits construits autour de Grok |
Chat, génération d'images/vidéos Imagine et API vocales |
Chaque fonctionnalité a ses propres exigences de requête et de facturation |
Comment nous avons sélectionné ces fournisseurs d'API
Il s'agit d'un guide de sélection basé sur la documentation, vérifié le 27 octobre 2026. Les recommandations reflètent les capacités disponibles, les exigences d'intégration et les structures de facturation publiées. Elles ne représentent pas un classement mesuré de la qualité du dialogue ou de la vitesse de réponse.
J'ai donné la priorité aux fournisseurs qu'un développeur pourrait évaluer pour un produit compagnon, puis j'ai pris en compte le choix du modèle, la prise en charge des médias, le travail d'application et le coût. Une comparaison utile doit expliquer si un service fournit une inférence de modèle, un pipeline de conversation vocale ou une infrastructure de produit supplémentaire.
Les projets réels montrent pourquoi cette distinction est importante. Le projet compagnon open-source Utsuwa configure séparément les fournisseurs de LLM et de synthèse vocale. Son application récupère l'historique des conversations, injecte les souvenirs pertinents et ajuste le contexte pour s'adapter au modèle sélectionné. La sélection du fournisseur n'est qu'une partie de ce système.
Pour plus d'exemples, explorez les applications de chat avec personnages et leur utilisation des modèles de GPT Proto. Utilisez les listes pour étudier les modèles d'application et les choix de modèles. Elles ne déterminent pas quel fournisseur sera le plus performant pour votre propre application.
6 fournisseurs d'API à considérer pour votre application de compagnon
1. GPT Proto pour combiner des modèles de chat, d'image et de vidéo
GPT Proto est le point de départ le plus solide de cette liste si vous souhaitez comparer différentes familles de modèles et ajouter des visuels générés via un seul et même compte. Son API d'IA pour le jeu de rôle vous permet d'évaluer les prompts de personnages et de comparer les modèles pris en charge avant de vous engager sur l'un d'eux.
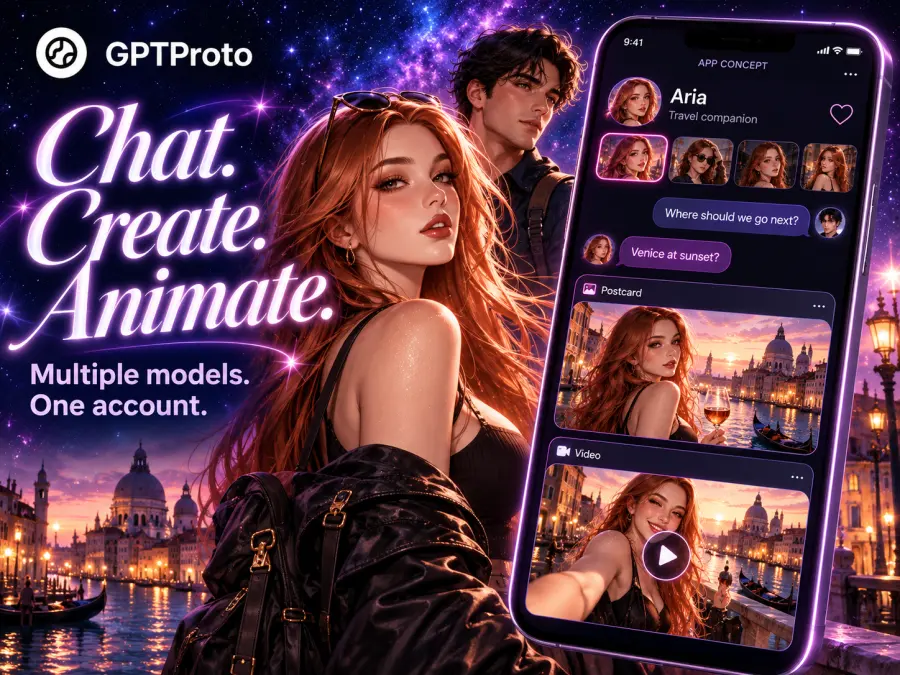
Prenons l'exemple d'un compagnon de voyage fictif : un modèle de chat écrit la conversation, un modèle d'image crée une carte postale du personnage et un modèle vidéo anime une scène. Ces tâches peuvent utiliser des modèles différents. GPT Proto propose des pages dédiées pour des options telles que la génération d'images Nano Banana 2.1 et la génération vidéo Kling 4.0, avec des exemples de requêtes spécifiques à chaque modèle.
L'accès partagé réduit le nombre de comptes et de soldes que votre équipe doit gérer. L'intégration nécessite tout de même une gestion distincte pour chaque tâche. Une requête de chat-completions et une tâche vidéo asynchrone ont des cycles de vie différents.
Pour une référence budgétaire concrète, GPT-6 Luna sur GPT Proto affiche 0,08 $ par million de jetons en entrée et 0,40 $ par million de jetons en sortie. Cela en fait un candidat pour des expériences de chat peu coûteuses ; la qualité du personnage nécessite sa propre évaluation.
Choisissez GPT Proto lorsque la flexibilité des modèles et les fonctionnalités visuelles sont prioritaires. Intégrez la mémoire, les autorisations utilisateur et l'état des personnages dans votre application, et vérifiez séparément toute fonctionnalité vocale en temps réel requise.
2. OpenAI pour un accès direct aux modèles vocaux en temps réel
OpenAI est un choix pratique lorsque les exigences de votre produit sont centrées sur ses modèles et l'interaction vocale en temps réel. L'API Realtime traite l'audio directement, maintient l'état de la conversation et prend en charge les outils. Son flux documenté pour navigateur utilise un secret client éphémère et WebRTC ; les connexions serveur peuvent utiliser WebSocket.
Ceci est utile pour un compagnon vocal qui doit gérer les interruptions ou appeler un outil pendant la conversation. Vous pouvez développer avec l'API originale et ses SDK, avec moins de services intermédiaires à examiner lorsqu'une fonctionnalité spécifique à un modèle se comporte de manière inattendue.
La limite réside dans le choix des modèles entre les différents fournisseurs. Si votre produit a besoin plus tard du style de dialogue d'un autre laboratoire ou d'un modèle d'image différent, vous devrez ajouter cette intégration vous-même. L'état de la conversation stocké nécessite également une conception explicite pour l'historique utilisateur et la récupération de la mémoire.
Pour la vidéo, vérifiez attentivement la disponibilité actuelle. L'avis de dépréciation d'OpenAI liste l'arrêt de l'API Videos et de l'API Sora 2 au 24 septembre 2026. Un tutoriel ancien accessible ne constitue pas une preuve suffisante que son point de terminaison reste disponible.
Choisissez OpenAI lorsque l'accès direct à ses capacités en temps réel l'emporte sur le besoin de changer de famille de modèles.
3. Google Gemini API pour les applications basées sur Google AI
Google mérite d'être pris en considération si vous utilisez déjà son écosystème de développement et que vous souhaitez évaluer les fonctionnalités de conversation, d'entrée visuelle, d'images générées et de vidéo au sein de cet environnement.
L'API Gemini Live prend en charge les interactions en streaming, avec des connexions WebSocket côté frontend ou backend. Google recommande l'utilisation de jetons éphémères pour les connexions client en production. Cela peut convenir à un compagnon qui répond à des entrées vocales et à des informations provenant d'une caméra ou d'un écran partagé.
La vidéo générée constitue une sélection distincte. Le guide vidéo Gemini actuel oriente les développeurs vers Gemini Omni Flash et le distingue des points de terminaison Veo 3.1 Preview désormais abandonnés. Pour un personnage envoyant un court message animé, évaluez un modèle de génération plutôt que de supposer que l'entrée vidéo Live fournit ce résultat.
Le travail pratique consiste à sélectionner et à tester les bons modèles pour chaque fonctionnalité. Un produit peut nécessiter des paramètres, des limites d'utilisation et des calculs de facturation différents pour le chat, la voix et les médias. Séparez ces coûts dans vos prévisions.
Choisissez Google lorsque son écosystème correspond à votre application et que vous êtes à l'aise avec la sélection de modèles différents pour des interactions différentes.
4. Inworld pour des pipelines vocaux en temps réel configurables
Inworld mérite une attention particulière lorsque la conversation vocale est au cœur de l'expérience. Son API en temps réel combine la reconnaissance vocale, le LLM de votre choix et la synthèse vocale, tout en gérant la détection des tours de parole et les interruptions via WebSocket ou WebRTC.
Il offre également une couverture médiatique plus large. Inworld Inference expose des modèles de texte, d'image et de vidéo ; décrire la plateforme comme un simple service vocal serait donc passer à côté d'une partie de son offre.
La limite importante concerne la mémoire persistante. Sa documentation sur la mémoire à long terme explique que les sessions en temps réel sont temporaires. Votre client doit enregistrer la mémoire en externe et la restaurer pour une session future. Il s'agit d'une responsabilité concrète de l'application à inclure dans les estimations de développement.
Pour l'évaluation des coûts, suivez séparément la reconnaissance vocale, la consommation du LLM et la parole générée, puis ajoutez l'utilisation des médias. Un prix unitaire bas pour la synthèse vocale ne définit pas le prix d'une conversation entière.
Choisissez Inworld lorsque l'interaction vocale configurable est une exigence fondamentale et que vous souhaitez réduire le travail d'orchestration. Planifiez le flux de base de données et de restauration de la mémoire parallèlement à l'intégration vocale.
5. ElevenLabs pour les applications vocales avec fonctionnalités visuelles
ElevenLabs est un candidat de choix lorsque vous souhaitez que la configuration vocale et les contrôles de conversation fassent partie de la plateforme que vous achetez. ElevenAgents prend en charge la sélection du modèle de langage, la gestion des tours de parole, les interruptions et le déploiement via des intégrations web et mobiles.
Son offre d'image et de vidéo change la donne. Le guide de l'API Image & Vidéo documente des points de terminaison de génération asynchrone distincts, avec des résultats collectés via des webhooks ou par interrogation (polling). L'accès nécessite un plan Pro ou supérieur ainsi que les autorisations API appropriées.
Cette exigence d'abonnement est importante pour un petit prototype. Comparez l'utilisation prévue des fonctionnalités avec les services disponibles dans le plan que vous comptez acheter. Les générations de médias consomment des crédits en fonction du modèle, des paramètres et des entrées sélectionnés ; une allocation vocale ne doit pas être considérée comme un budget média illimité.
Il existe une autre distinction en termes de coûts : la documentation du modèle d'agent comptabilise l'utilisation des LLM tiers séparément. Estimez la configuration de conversation que vous déploierez réellement plutôt que d'utiliser un prix vocal affiché comme coût total.
Choisissez ElevenLabs lorsque la configuration vocale et les outils d'agent justifient les exigences de la plateforme. Vérifiez l'accès aux médias avant de concevoir des fonctionnalités d'image ou de vidéo de personnage autour de cela.
6. xAI pour les applications construites autour des modèles Grok
xAI est pertinent lorsque vous souhaitez spécifiquement utiliser Grok comme modèle conversationnel et évaluer les capacités multimédias et vocales associées.
La documentation d'Imagine couvre la génération et l'édition d'images ainsi que la génération de vidéos. Cela offre aux développeurs un moyen de tester une conversation de personnage et du contenu visuel généré au sein de l'écosystème du même fournisseur.
La voix doit être évaluée via sa propre documentation de l'API vocale. Considérez l'interaction vocale, le chat textuel et les clips générés comme des éléments d'intégration et de budget distincts, même lorsqu'ils partagent un même compte.
Vous construisez toujours le produit compagnon. Une API de modèle ne fournit pas automatiquement les ressources de personnage, l'état de relation persistante ou l'interface que l'on trouve dans une application compagnon grand public. Vérifiez les entrées, les sorties et les contrôles réels de l'API par rapport aux fonctionnalités de votre cahier des charges.
Choisissez xAI lorsque Grok lui-même fait partie de la décision produit. Si votre priorité est de comparer de nombreuses familles de modèles, incluez également un service multi-modèles dans votre évaluation.
Combien coûte réellement une application compagnon IA ?
Un devis basé sur les jetons devient utile lorsque vous le reliez à une charge de travail définie. Les longues conversations peuvent nécessiter le renvoi des instructions du personnage, des souvenirs récupérés et de l'historique récent à chaque requête. Mesurez les entrées que votre application envoie.
Voici une charge de travail textuelle hypothétique : 1 000 sessions, 50 réponses par session, une moyenne de 2 000 jetons d'entrée par requête et 200 jetons de sortie facturés par réponse. Cela produit 100 millions de jetons d'entrée et 10 millions de jetons de sortie.
| Même modèle et même charge de travail |
GPT Proto GPT-6 Luna |
OpenAI GPT-6 Luna |
| Prix d'entrée par million de jetons |
$0,08 |
$0,10 |
| Prix de sortie par million de jetons |
$0,40 |
$0,50 |
| Coût pour 100 millions de jetons d'entrée |
$8 |
$10 |
| Coût pour 10 millions de jetons de sortie |
$4 |
$5 |
| Estimation totale de l'inférence textuelle |
$12 |
$15 |
Les tarifs proviennent de la page des modèles de GPT Proto et de la documentation du modèle OpenAI GPT-6 Luna. Ce calcul utilise les tarifs standards sans mise en cache et suppose qu'il n'y a pas de sortie de raisonnement au-delà de l'allocation de jetons indiquée. Il exclut les frais d'écriture en cache, les tentatives de nouvelle connexion, les médias, le traitement de la mémoire, le stockage et les taxes. Il s'agit d'une illustration des coûts d'achat, et non d'une comparaison mesurée de la qualité du compagnon.
Pour un produit multimodal, ajoutez l'utilisation suivante à vos prévisions :
| Fonctionnalité |
Éléments à mesurer |
| Mémoire persistante |
Appels d'extraction ou de résumé, embeddings utilisés, récupération et stockage |
| Images de personnage |
Images demandées, résolution, entrées de référence et générations répétées |
| Vidéos courtes |
Durée générée, résolution, ressources d'entrée, paramètres audio et tentatives facturées |
| Conversation vocale |
Reconnaissance, utilisation LLM, sortie vocale et tous frais de plateforme ou de connexion |
La latence fait également partie de l'évaluation du produit. Dans un compte de développement de compagnon de bureau, l'auteur a combiné l'inférence cloud avec la parole locale et la mémoire de base de données, puis a signalé des délais liés aux appels d'outils. Il s'agit d'une expérience individuelle, mais elle illustre pourquoi un modèle de texte rapide ne suffit pas à déterminer le temps d'attente ressenti par les utilisateurs.
Connectez un modèle de chat et planifiez votre flux de travail multimédia
Commencez par une courte conversation avec un personnage. Créez une clé API GPT Proto, ajoutez du crédit et définissez la variable d'environnement GPTPROTO_API_KEY sur votre serveur. La page du modèle GPT-6 Luna fournit l'exemple d'utilisation de l'API actuel.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "gpt-6-luna",
    "messages": [
      {
        "role": "system",
        "content": "You are Mira, a fictional travel companion. Be warm and concise."
      },
      {
        "role": "user",
        "content": "I have one free afternoon in Kyoto and prefer quiet places."
      }
    ]
  }'
Lisez la réponse depuis choices[0].message.content. Cette requête fournit une instruction de personnage et un message. Pour poursuivre le dialogue, votre backend doit assembler la conversation et les souvenirs pertinents pour chaque appel. Gardez la clé API permanente hors du code du navigateur et des bundles mobiles.
Ensuite, sélectionnez un modèle d'image ou de vidéo depuis sa propre page. Utilisez les instructions d'utilisation de l'API de la page du modèle lorsque vous demandez à votre assistant de codage de créer l'intégration. Préservez le point de terminaison documenté, l'authentification, les paramètres et le flux de traitement des résultats.
Une tâche multimédia asynchrone nécessite un ID de travail enregistré et un gestionnaire de fin de tâche. Votre interface peut afficher une image ou une vidéo en attente pendant que le chat se poursuit. Connecter chaque tâche au point de terminaison de complétion de chat ne reproduira pas ces capacités distinctes.
Quel fournisseur d'API choisir ?
| Votre première étape produit |
Présélection |
À valider avant de s'engager |
| MVP de compagnon textuel |
GPT Proto ou une API de modèle direct |
Comportement du personnage, coût par conversation, gestion de la mémoire |
| Chat avec images et clips de personnages |
GPT Proto, Google, Inworld, ElevenLabs ou xAI |
Disponibilité exacte du modèle, accès aux médias, références et flux de complétion des tâches |
| Compagnon vocal en temps réel |
OpenAI, Inworld, ElevenLabs ou Gemini Live |
Interruptions, première réponse audible, cohérence vocale et coût total de la session |
| Produit conçu spécifiquement autour de Grok |
xAI |
Fonctionnalités API requises et travail d'application au-delà de l'accès au modèle |
Pour une équipe qui explore encore son modèle de dialogue et ses fonctionnalités visuelles, je commencerais par GPT Proto et une petite évaluation reproductible. Utilisez les mêmes instructions de personnage et le même historique de conversation, puis comparez les modèles pris en charge avant de construire le reste du produit autour de l'un d'eux.
La sélection du modèle mérite une étape distincte. Notre guide des meilleurs modèles d'IA pour le jeu de rôle se concentre sur les modèles de dialogue sous-jacents. Utilisez-le pour restreindre les candidats, puis testez vos propres personnages et modèles de session.
Commencez avec l'API IA de GPT Proto pour le jeu de rôle pour comparer une conversation de personnage, et ajoutez la génération visuelle une fois que l'expérience de chat répond à vos exigences.