Kimi K3.1 Pro vs Opus 5.5 en un coup d'œil
| Élément |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Prix officiel entrée / sortie par 1M de jetons |
2 $ / 10 $ |
4 $ / 20 $ |
| Prix GPT Proto entrée / sortie par 1M de jetons |
2 $ / 10 $ |
3,60 $ / 18 $ |
| Fenêtre de contexte |
Environ 1M de jetons |
1M de jetons |
| Entrée / sortie du modèle |
Texte et images / texte |
Texte et images / texte |
| Effort de raisonnement par défaut de l'API native |
Max |
Moyen |
| Mon premier essai recommandé |
Tâches limitées avec vérifications claires |
Développement complexe et révision finale |
Les prix ont été vérifiés le 29 octobre 2026. Les spécifications officielles proviennent de la documentation de l'API Kimi et de la documentation du modèle Claude. Les tarifs de GPT Proto sont listés sur la page de l'API Kimi K3.1 Pro et la page de l'API Claude Opus 5.5. Les opérations de cache et autres frais applicables nécessitent une comptabilité séparée.
Pour une comparaison rapide du catalogue, utilisez la page de comparaison Kimi K3.1 Pro vs Claude Opus 5.5. Pour le contexte sur cette version de Kimi, voir ce qui a changé dans Kimi K3.1 Pro.
Ce que les benchmarks nous disent sur le codage et ce qu'ils omettent
La comparaison de lancement publiée par Moonshot rapporte 65,7 % pour Kimi K3.1 Pro et 66,4 % pour Opus 5.5 sur Terminal-Bench 4.0. Il s'agit de chiffres publiés par le fournisseur, en attente d'une vérification indépendante de cette comparaison spécifique. Ils justifient de prendre Kimi au sérieux pour le travail sur terminal ; ils n'établissent pas une performance égale dans le développement d'applications.
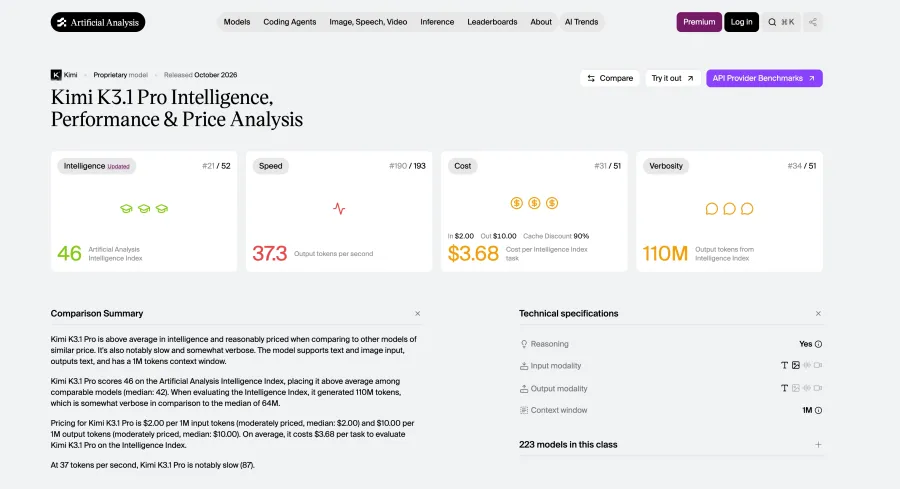
L'image indépendante plus large est différente. Le 29 octobre, les pages des modèles de l'Artificial Analysis Intelligence Index v5.0 montraient Kimi à 46 et Opus à 58, ce dernier étant étiqueté Max avec repli par défaut. Ces points d'index ne sont pas des pourcentages ou un taux de réussite de codage. Gardez la version de l'index et la configuration associées à la comparaison.
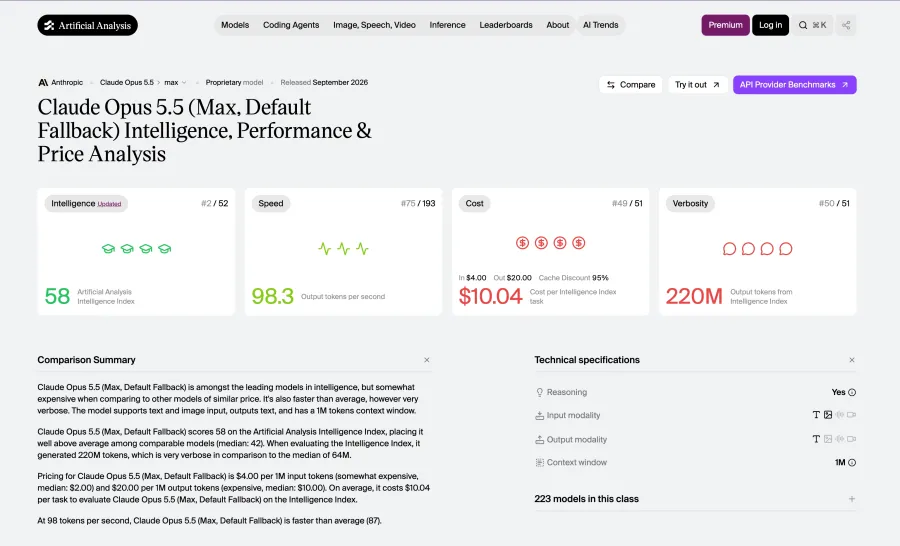
Je traiterais Opus comme la référence de qualité initiale pour les travaux exigeants, puis je testerais si Kimi répond aux mêmes critères d'acceptation à un coût inférieur. Un benchmark de terminal ne peut pas vous dire si un formulaire de réservation conserve son état ou si un tableau de bord reste lisible sur mobile. Vos tests d'application doivent y répondre.
Codage Frontend : d'une capture d'écran à une interface fonctionnelle
Pour une tâche de conversion de capture d'écran en interface, séparez l'apparence du comportement. Une mise en page fidèle nécessite tout de même une navigation fonctionnelle, des états de formulaire, un accès au clavier et une version mobile utilisable. Demandez ensuite une modification. Ajouter un filtre sans casser la mise en page existante est un test différent de la génération d'une page à partir de zéro.
Il existe un exemple utile pour les développeurs ici. Dans la comparaison publiée par Melvynx, il a préféré le traitement visuel d'Opus pour un vérificateur de fuseaux horaires. Il s'agit d'un jugement esthétique sur une réalisation précise, plutôt que d'un taux de réussite mesuré en développement frontend.
Pour un site marketing ou un tableau de bord client, mon premier choix serait Opus lorsque le design nécessite une distinction et des raffinements répétés. Kimi est un candidat judicieux pour une interface interne dotée d'un système de design clair, surtout lorsque vous pouvez inspecter le résultat avant la mise en ligne. Le compromis réside dans le temps passé à corriger ce que le prompt initial laisse en suspens.
Considérez une interface de réservation comme un test d'évaluation. Donnez aux deux modèles la même image de référence, la bibliothèque de composants existante et les exigences pour la sélection de dates, les créneaux indisponibles, la validation et la confirmation. Demandez à chacun de connecter l'interface à la même API fictive. Introduisez ensuite une requête échouée et vérifiez si l'utilisateur peut récupérer ses données sans perdre le formulaire.
Cette dernière étape transforme cela en une comparaison d'application. Elle permet de voir si une page attrayante gère également l'action suivante du client.
Applications interactives et 3D : qualité visuelle, logique et performances d'exécution
Le cas de Kimi devient plus intéressant sur le travail visuel interactif. L'exemple de la lampe à lave de Melvynx incluait des contrôles d'éclairage et de couleur. Il a jugé le résultat d'Opus, plus exigeant, comme étant le meilleur, tout en trouvant les matériaux et les effets de verre de Kimi convaincants. Ses coûts d'exécution rapportés étaient de 2,30 $ pour Kimi High et 4,16 $ pour Max, contre 4,35 $ pour Opus Medium et 6,39 $ pour Extra High.
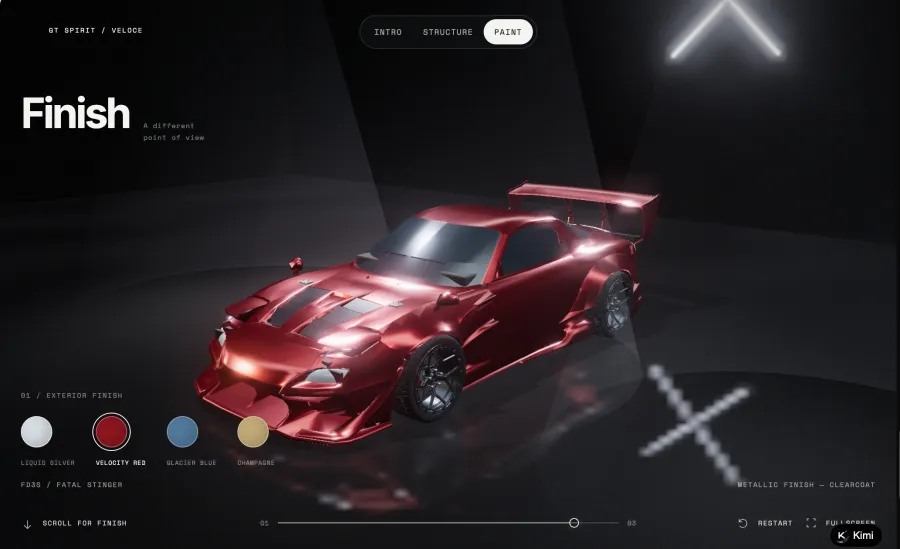
La même analyse décrit une simulation de crash qui a mieux fonctionné avec Kimi High qu'avec Max. L'auteur divulgue un lien d'affiliation Kimi et un espace de travail partagé non isolé. Ces exemples sont des observations utiles, avec ces limites à prendre en compte.
Mon interprétation est que Kimi mérite d'être testé pour des configurateurs de produits, des démonstrations pédagogiques et des prototypes visuels. Choisir automatiquement un réglage plus exigeant reviendrait à passer à côté de l'une des leçons pratiques de ces exemples. Commencez par une exigence explicite et inspectez l'artefact.
Pour un configurateur de meubles, définissez ce qui doit changer lorsqu'une personne sélectionne un matériau, change de vue de caméra ou réinitialise le design. Vérifiez si le prix affiché correspond à la sélection. Rechargez la page. Essayez les commandes sur un téléphone. Une chaise visuellement attrayante n'est qu'une partie du livrable.
La précision technique nécessite ses propres vérifications. Les résultats BenchCAD de Moonshot rapportent 92,7 % pour Kimi et 96,2 % pour Opus avec des outils, en utilisant une métrique de reconstruction géométrique. Ce résultat publié par le fournisseur répond à une question différente de celle de savoir si une scène est attrayante. Une animation convaincante nécessite toujours une validation distincte avant de l'utiliser pour enseigner la physique ou représenter un processus d'ingénierie.
Pour un prototype, je testerais Kimi en premier. Pour une application sensible à la précision, je commencerais par Opus et j'exigerais des vérifications spécifiques au domaine, quel que soit le modèle qui produit le code.
Développement agentique : le modèle peut-il accomplir une tâche en plusieurs étapes ?
Un agent travaillant dans un dépôt doit comprendre le comportement existant, choisir les fichiers à modifier, exécuter des outils, interpréter les échecs et décider quand s'arrêter. Des erreurs peuvent s'accumuler entre ces étapes.
Les deux fournisseurs publient des exemples de travaux étendus. Moonshot décrit Kimi diagnostiquant et corrigeant un simulateur avant de réentraîner un contrôleur de marche. Le rapport de lancement d'Opus 5.5 d'Anthropic décrit des améliorations sur une application web, incluant une tâche de temps de chargement complétée avec succès lors de 39 essais sur 40. Il s'agit d'exemples distincts fournis par les vendeurs, plutôt que d'un test comparatif direct partagé.
Pour une application de facturation existante, une comparaison utile consisterait à ajouter des importations CSV. Cela nécessite le mappage des champs, la gestion des lignes invalides, la détection des doublons, un aperçu et des tests couvrant le comportement existant. Laissez chaque modèle travailler à partir du même instantané de dépôt et inspectez les deux correctifs. Un résumé indiquant « tous les tests réussis » doit être étayé par un journal de tests.
Pour ce type de modification inter-fichiers, Opus serait mon point de départ par défaut. Kimi est plus facile à évaluer sur une partie délimitée du travail, comme l'implémentation d'une validation par rapport à un schéma convenu. Étendez son périmètre une fois que les tests ont établi qu'il peut gérer l'application environnante.
La configuration compte également. Les conseils sur l'utilisation des outils de Kimi nécessitent de conserver l'intégralité du message de l'assistant au fil des tours. La documentation d'Opus de Claude décrit le raisonnement spécifique au modèle et le comportement des outils. Vérifiez ces détails sur la voie que vous avez choisie ; correspondre à un format de requête de base n'établit pas un comportement d'agent identique.
Tarification et coût : combien coûte réellement un résultat accepté ?
Kimi K3.1 Pro propose les tarifs d'entrée et de sortie standard les plus bas. La question plus complexe est de savoir combien d'appels, de tentatives et de cycles de révision votre tâche nécessite.
Voici un exemple de planification utilisant les tarifs listés par GPT Proto. Supposons que chaque tentative utilise 1 million de jetons d'entrée non mis en cache et 200 000 jetons de sortie facturés. Il s'agit de volumes hypothétiques, et non de résultats d'application observés.
| Scénario de planification |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Une tentative aux volumes indiqués |
4,00 $ |
7,20 $ |
| Deux tentatives, chacune aux mêmes volumes |
8,00 $ |
14,40 $ |
Selon ces hypothèses, un résultat Kimi nécessitant deux tentatives coûte plus cher en jetons qu'un résultat Opus accepté après une seule tentative. Les nouvelles tentatives répètent rarement exactement les mêmes volumes de jetons, utilisez donc vos relevés d'utilisation pour le calcul réel.
La mise en cache modifie à nouveau la comparaison. Les deux fournisseurs listent les lectures de cache officielles à 0,20 $ par million de jetons dans leur documentation Kimi et Claude. Une longue session d'agent avec de nombreux succès de cache aura un ratio de coût différent de celui d'une nouvelle requête. Vérifiez également les frais d'écriture en cache, l'utilisation de la sortie et les tarifs réels de votre fournisseur.
Pour une équipe, je suivrais le coût par tâche acceptée ainsi que le temps écoulé et les minutes de révision. Un brouillon moins cher peut être une bonne affaire lorsqu'il est rapide à vérifier. Il devient moins attractif lorsqu'un développeur doit reconstruire ce que l'agent a modifié avant de lui faire confiance.
Comment comparer les deux modèles sur votre propre application via GPT Proto
Utilisez une petite modification d'application avec des résultats observables. Un formulaire de réservation, un importateur CSV ou un configurateur de produit vous fournira des preuves plus utiles qu'une demande non restreinte de « construire quelque chose d'impressionnant ».
Ouvrez la page du modèle Kimi et la page du modèle Opus. Utilisez « Try this model » (Essayer ce modèle) et « Quick Start » (Démarrage rapide) pour obtenir le guide d'intégration, puis copiez les instructions Markdown dans votre assistant de codage. Conservez votre clé API dans une variable d'environnement locale ou une configuration côté serveur.
Avant d'évaluer la qualité du développement, vérifiez que les deux routes de modèle répondent. Cet exemple de connexion suit le format « Chat Completions » publié sur les pages des modèles. Définissez GPTPROTO_API_KEY localement avant de l'exécuter ; les requêtes consomment des jetons payants.
for model in kimi-k3.1-pro claude-opus-5-5; do
  curl --fail-with-body --silent --show-error --max-time 180 \
    https://gptproto.com/v1/chat/completions \
    -H "Authorization: Bearer $GPTPROTO_API_KEY" \
    -H "Content-Type: application/json" \
    --data "{
      \"model\": \"$model\",
      \"messages\": [{\"role\": \"user\",
        \"content\": \"Return only: API connection OK\"}]
    }"
done
Ceci vérifie la connectivité, pas la qualité du codage. Les API natives ont des paramètres de raisonnement par défaut différents ; configurez et enregistrez les paramètres d'effort pris en charge avant une comparaison d'application. Une réponse d'API nécessite également un agent ou une application autour d'elle pour modifier des fichiers, exécuter des outils et inspecter un navigateur.
Pour l'essai de développement, démarrez chaque modèle à partir d'une copie propre du même projet. Fournissez la même tâche, les mêmes autorisations, dépendances et tests d'acceptation. Enregistrez la route du modèle, l'effort, l'utilisation facturée, le temps de réalisation et les modifications manuelles requises. Répétez la tâche avant de faire d'une petite différence votre valeur par défaut en production.
Si le point de terminaison renvoie une erreur d'authentification, vérifiez la clé et l'en-tête d'autorisation. Si un paramètre optionnel est rejeté, comparez-le avec le guide actuel de la page du modèle. Vérifiez qu'une réponse réussie contient la sortie de modèle prévue avant d'étendre le travail.
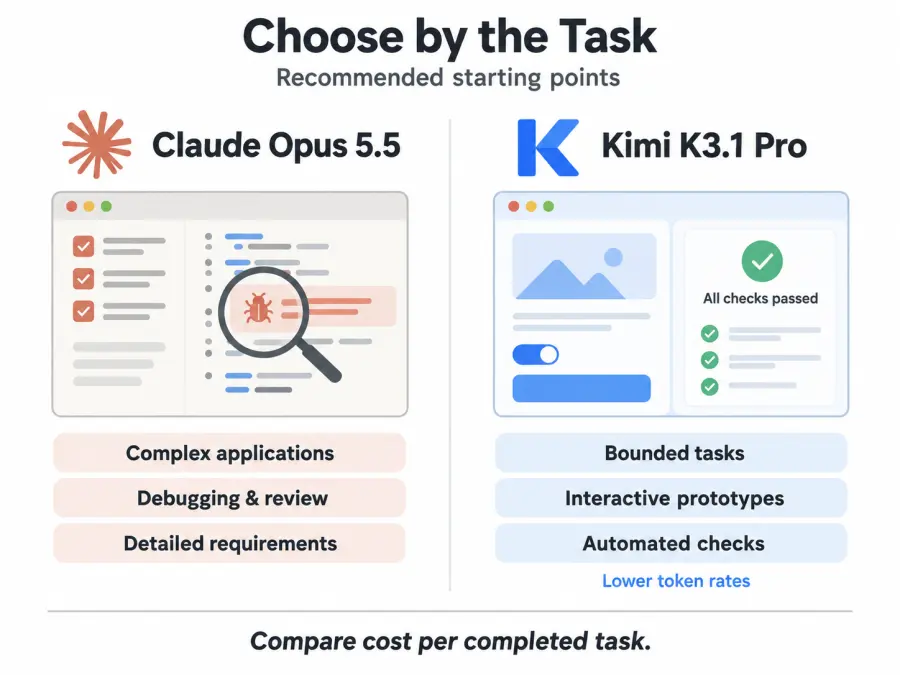
Quel modèle choisir ?
| Votre charge de travail |
Mon choix initial |
Condition pour le conserver |
| Frontend orienté client avec révisions de conception répétées |
Opus 5.5 |
Une meilleure acceptation du résultat justifie son coût |
| Prototype interactif ou expérience visuelle |
Kimi K3.1 Pro |
Les contrôles fonctionnent et l'artefact est facile à inspecter |
| Modifications complexes dans une application existante |
Opus 5.5 |
Les tests du dépôt et la revue confirment ce choix |
| Implémentation répétée selon une spécification fixe |
Kimi K3.1 Pro |
Les vérifications automatisées maintiennent les coûts de correction bas |
| Code ou simulation sensible à la précision |
Opus comme base de référence initiale |
Une validation externe est requise pour l'un ou l'autre modèle |
Je choisirais Opus 5.5 comme défaut initial pour une équipe confiant une charge de travail applicative importante à un agent. Les preuves d'évaluation plus larges justifient de commencer par là, tandis que le dépôt réel déterminera si le coût premium est justifié.
Kimi K3.1 Pro est un candidat pratique pour réduire le coût des tâches bien définies. Commencez par des tâches que vous pouvez inspecter ou tester, mesurez les résultats acceptés et augmentez ses responsabilités à mesure que les preuves s'accumulent. C'est une raison plus solide de changer de modèle qu'une quasi-égalité sur un seul benchmark.
Testez une petite tâche sur les pages API Kimi K3.1 Pro et API Claude Opus 5.5, utilisez les guides d'intégration et comparez le résultat que votre application peut accepter.