Si vous hésitez aujourd'hui entre GPT 6.1 Terra et Sonnet 5.5, voici la règle de décision rapide que j'utilise avant de lancer un benchmark :
Choisissez GPT-6.1 Terra si votre pipeline effectue de l'inspection de captures d'écran à haut volume, de l'automatisation de formulaires et de factures, du débogage de mise en page d'interface utilisateur, ou des tâches de codage délimitées où un tarif de 0,80 $/4,00 $ par jeton et une exécution des tâches 3 fois plus rapide comptent plus que la profondeur de refactorisation autonome maximale — et que vos entrées par requête unique restent inférieures ou égales à 272 000 jetons.
Restez sur Claude Sonnet 5.5 si votre agent exécute des migrations de dépôts multi-fichiers, du débogage de terminal approfondi où une modification manquée coûte plus cher que la facture de jetons, ou des invites en un seul passage entre 300 000 et 900 000 jetons, là où le supplément pour contexte long d'OpenAI annule l'avantage tarifaire de Terra sur les entrées.
Vous pouvez consulter les tarifs du catalogue en direct ou calculer votre volume mensuel de jetons via le hub de comparaison de modèles GPT Proto avant de vous engager dans l'une ou l'autre voie. Tout ce qui suit est une comparaison basée sur la documentation et les benchmarks, vérifiée le 5 novembre 2026 ; les benchmarks rapportés par les fournisseurs sont étiquetés séparément des mesures indépendantes effectuées par Artificial Analysis et des premiers retours des développeurs.
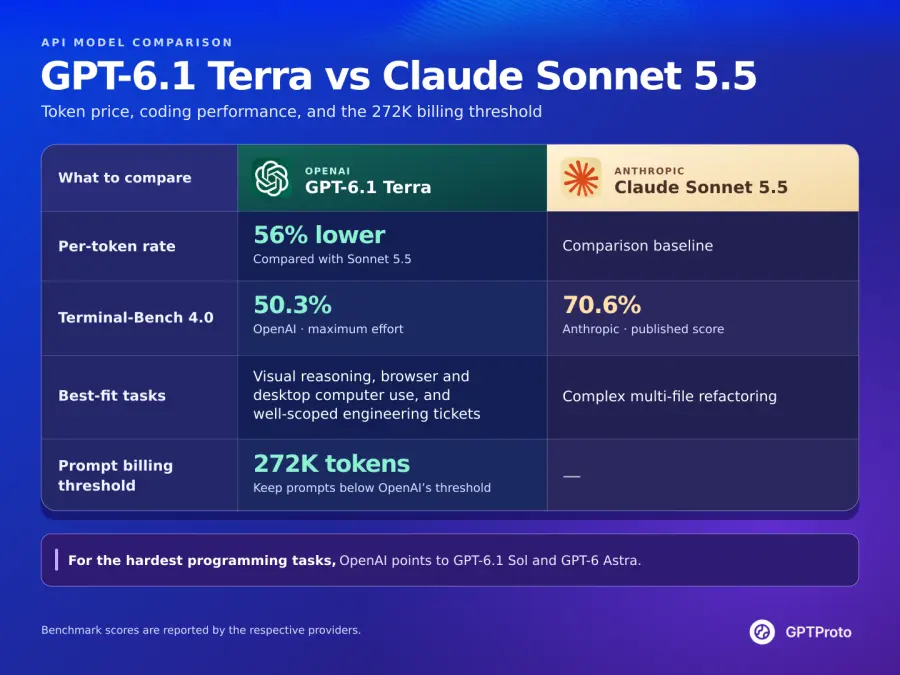
Comparaison rapide : GPT-6.1 Terra vs Claude Sonnet 5.5
Les développeurs à la recherche d'une comparaison entre ChatGPT 6.1 Terra et Sonnet 5.5, ou Anthropic Claude Sonnet 5.5 et GPT 6.1 Terra, se heurtent souvent à des fiches techniques contradictoires, car les deux fournisseurs structurent différemment leurs contrôles de raisonnement, leurs points de terminaison d'outils et leurs surcoûts liés aux contextes longs. Le tableau ci-dessous aligne les deux modèles avec la documentation officielle d'OpenAI gpt-6.1-terra, l'aperçu de Claude Sonnet 5.5 d'Anthropic et les tarifs du catalogue GPT Proto en temps réel.
| Spécification |
GPT-6.1 Terra (gpt-6.1-terra) |
Claude Sonnet 5.5 (claude-sonnet-5-5) |
| Fournisseur |
OpenAI |
Anthropic |
| Date de sortie |
26 octobre 2026 |
28 septembre 2026 |
| Entrée / sortie standard officielle (par 1M de jetons) |
1,00 $ / 5,00 $ |
2,00 $ / 10,00 $ |
| Entrée / sortie GPT Proto (par 1M de jetons) |
0,80 $ / 4,00 $ (−20 % vs officiel) |
1,80 $ / 9,00 $ (−10 % vs officiel) |
| Lecture d'entrée mise en cache officielle (par 1M de jetons) |
0,05 $ (5 % de l'entrée de base) |
0,10 $ (réduit de 0,20 $ le 7 oct. 2026) |
| Écriture de cache officielle (par 1M de jetons) |
1,25 $ (TTL 30m) / 2,50 $ (TTL 12h) |
2,50 $ (TTL 5m) |
| Lecture / écriture de cache GPT Proto (par 1M de jetons) |
0,04 $ / 1,00 $ |
0,09 $ / 2,25 $ (vérifier la page du modèle en direct) |
| Fenêtre de contexte |
1 050 000 jetons |
1 000 000 jetons |
| Règle de tarification pour contexte long |
>272K d'entrée facturés à 2x l'entrée/cache et 1,5x la sortie |
Tarif forfaitaire sur toute la fenêtre de contexte de 1M |
| Jetons de sortie maximum |
128 000 jetons |
128 000 jetons |
| Modalités d'entrée / sortie |
Texte, Image, Document en entrée → Texte en sortie |
Texte, Image, Document en entrée → Texte en sortie |
| Date limite de connaissances |
1er juin 2026 |
Début à mi-2026 (conserve le tokenizer Sonnet 5) |
| Contrôles de raisonnement / effort |
none, low, medium (par défaut), high, xhigh, max |
Réflexion adaptative activée par défaut ; medium, high (par défaut API), max, between_tools |
| Point de terminaison requis pour l'appel d'outils |
/v1/responses requis par la doc OpenAI |
/v1/messages (natif) ou compatible OpenAI /v1/chat/completions |
| Disponibilité client & IDE |
ChatGPT Work & Codex (pas le chat classique), GitHub Copilot, Claude Code (via API) |
Claude.ai, Claude Code, GitHub Copilot, Cursor |
| Indice d'intelligence AA (v4.3.2) |
41 (medium) / 48 (max) |
56 (max, repli par défaut) |
| Coût moyen d'une tâche d'évaluation AA |
0,10 $ (`medium`) / 0,40 $ (max) |
5,46 $ (max, repli par défaut) |
| Terminal-Bench 4.0 (rapporté par le fournisseur) |
50,3 % (max effort) |
70,6 % |
Trois lignes de ce tableau font l'essentiel du travail lorsque vous budgétisez une application. Premièrement, sur les requêtes standard de moins de 272K jetons, GPT-6.1 Terra est 56 % moins cher par jeton sur GPT Proto pour l'entrée et la sortie, de sorte que les longues complétions ne renversent pas le classement des coûts. Deuxièmement, Sonnet 5.5 détient une avance de 20,3 points de pourcentage sur Terminal-Bench 4.0, ce qui correspond étroitement au comportement des deux modèles lors des modifications de référentiel non guidées. Troisièmement, contrairement à GPT-6.1 Sol, GPT-6.1 Terra rétablit la prise en charge de reasoning.effort: "none", offrant à nouveau aux développeurs OpenAI un véritable chemin rapide sans raisonnement.
Analyse des prix et des coûts : lequel est le plus cher et lequel est le plus rentable ?
Lorsque les développeurs recherchent « GPT 6.1 Terra vs Sonnet 5.5 lequel est le plus cher » ou « lequel est le plus rentable », ils essaient généralement de concilier deux chiffres différents : le tarif par million de jetons affiché sur la page de tarification et le coût réel en dollars d'une tâche d'agent terminée. Ces deux ratios ne sont pas identiques.
Au niveau du jeton, Claude Sonnet 5.5 est le modèle le plus cher, et de loin. La tarification officielle d'Anthropic est de 2,00 $ par million de jetons en entrée et 10,00 $ par million de jetons en sortie, soit le double du prix catalogue d'OpenAI de 1,00 $/5,00 $ pour Terra. Comme GPT Proto applique une remise de 20 % sur GPT-6.1 Terra (0,80 $ en entrée / 4,00 $ en sortie) et une remise de 10 % sur Claude Sonnet 5.5 (1,80 $ en entrée / 9,00 $ en sortie), Sonnet 5.5 coûte 2,25 fois plus cher par jeton sur la plateforme. Les deux fournisseurs facturent désormais les lectures d'entrées mises en cache à 5 % de l'entrée de base (0,05 $ officiel pour Terra contre 0,10 $ officiel pour Sonnet 5.5 après qu'Anthropic a réduit de moitié le prix de lecture du cache de Sonnet en octobre 2026), et les deux facturent 1,25 fois l'entrée de base pour les écritures en cache standard (1,25 $ contre 2,50 $ officiel). Notez qu'une invite longue à usage unique écrite dans le cache ajoute en fait une surcharge de 25 % sur l'un ou l'autre modèle si vous ne lisez jamais ce préfixe une seconde fois.
Au niveau de la tâche, l'écart devient beaucoup plus important. Dans l'Intelligence Index v4.3.2 d'Artificial Analysis (publié du 26 au 27 octobre 2026), la configuration Claude Sonnet 5.5 (max effort avec repli par défaut) testée a enregistré un coût moyen pondéré de 5,46 $ par tâche d'évaluation. Dans la même suite d'évaluation, [GPT-6.1 Terra à l'effort `max`](https://artificialanalysis.ai/models/gpt-6-1-terra) a coûté en moyenne 0,40 $ par tâche, et GPT-6.1 Terra à l'effort medium a coûté en moyenne seulement 0,10 $ par tâche. Cela représente une différence de 13,6x à l'effort max et une différence de 54,6x si l'on compare le paramètre le plus élevé de Sonnet au paramètre medium par défaut de Terra.
Pourquoi une différence de 2x par jeton se transforme-t-elle en un écart de facture de 13x à 54x ? Les modèles de raisonnement facturent les jetons de réflexion comme des jetons de sortie. Lorsque Sonnet 5.5 fonctionne à un effort élevé ou maximal sur un benchmark ouvert, il génère de longues chaînes de raisonnement à 10,00 $ par million de jetons (9,00 $ sur GPT Proto). L'annonce de Terra note également qu'à l'effort maximal sur l'examen final des agents, Terra a utilisé moins d'un tiers du nombre de jetons que Claude Opus 5.5. Plus important encore, la découverte de la frontière de Pareto par Artificial Analysis : pour GPT-6.1 Terra, les paramètres d'effort low et medium sont optimaux au sens de Pareto en termes d'intelligence par rapport au coût. Passer Terra à max fait passer son score de 41 à 48, ce qui équivaut à GPT-6.1 Sol à l'effort medium — sauf que Sol medium coûte 0,21 $ par tâche alors que Terra `max` coûte 0,40 $. En bref, si vous voulez la configuration la plus rentable sur Terra, maintenez-la sur low ou medium ; si une tâche est suffisamment difficile pour exiger un effort max, vous devriez déjà tester Sol ou Sonnet 5.5.
Calcul des coûts réels : deux scénarios de production
Pour comprendre où le tarif par jeton plus avantageux est réellement rentable — et où il se retourne contre vous — effectuons le calcul exact aux tarifs du catalogue en direct de GPT Proto (0,80 $/4,00 $ pour Terra ; 1,80 $/9,00 $ pour Sonnet 5.5), en supposant des requêtes non mises en cache de moins de 272 000 jetons.
Le scénario A est une boucle d'agent de contrôle qualité visuel et d'extraction de formulaires en 20 étapes. Chaque étape envoie une capture d'écran et un extrait DOM totalisant 15 000 jetons d'entrée et génère 1 500 jetons de sortie (incluant medium jetons de raisonnement). Sur 20 étapes, un seul flux de travail consomme 300 000 jetons d'entrée (0,3 M) et 30 000 jetons de sortie (0,03 M) :
GPT-6.1 Terra sur GPT Proto : (0,3 * 0,80 $) + (0,03 * 4,00 $) = 0,24 $ + 0,12 $ = 0,36 $ par flux de travail.
Claude Sonnet 5.5 sur GPT Proto : (0,3 * 1,80 $) + (0,03 * 9,00 $) = 0,54 $ + 0,27 $ = 0,81 $ par flux de travail.
À raison de 10 000 flux de travail par mois, Terra coûte 3 600 $ contre 8 100 $ pour Sonnet, soit une économie mensuelle de 4 500 $. Même si Terra échoue à la validation sur 20 % de ses exécutions et doit recommencer ces 2 000 flux de travail depuis le début (ajoutant 720 $), votre facture totale est de 4 320 $, ce qui permet tout de même d'économiser 3 780 $ par mois par rapport à une exécution Sonnet sans nouvelle tentative.
Le scénario B est une refonte backend multi-fichiers dans une pull request active. Supposons que chaque tentative lise 80 000 jetons d'entrée et émette 10 000 jetons de sortie. Un passage propre sur Sonnet 5.5 coûte (0,08 * 1,80 $) + (0,01 * 9,00 $) = 0,234 $. Un passage sur Terra coûte (0,08 * 0,80 $) + (0,01 * 4,00 $) = 0,104 $. Vous économisez 13 cents sur l'appel API. Le piège est que si Terra manque une dépendance de type inter-module — ce qui correspond à son écart de 50,3 % contre 70,6 % sur Terminal-Bench — et force trois nouvelles tentatives plus 12 minutes du temps d'un ingénieur senior à 90 $/heure (18,00 $ de main-d'œuvre), cette économie de 13 cents sur les jetons vient de coûter 18,18 $ à votre équipe. En une phrase : Terra gagne haut la main sur les boucles répétables et vérifiables par machine, tandis que Sonnet 5.5 justifie son tarif plus élevé dès qu'une modification échouée nécessite du temps de révision humaine.
Contexte de la fenêtre (1,05 M vs 1 M) : Pourquoi dépasser 272 000 tokens change la donne
Sur le papier, la comparaison entre la fenêtre de contexte du GPT 6.1 Terra et du Sonnet 5.5 semble être un match nul avec un léger avantage pour OpenAI : Terra accepte 1 050 000 tokens en entrée et émet jusqu'à 128 000 tokens en sortie, tandis que Claude Sonnet 5.5 accepte 1 000 000 de tokens en entrée et émet jusqu'à 128 000 tokens en sortie. La plupart des tableaux comparatifs s'arrêtent là.
Cependant, si vous lisez la documentation du modèle gpt-6.1-terra d'OpenAI, il existe un seuil de facturation à 272 000 tokens en entrée qui modifie radicalement l'économie des contextes longs. Chaque fois qu'une requête dépasse 272 000 tokens en entrée sur GPT-6.1 Terra, OpenAI facture l'intégralité de la requête — et pas seulement les tokens au-delà de 272 000 — au double des tarifs d'entrée et de cache, et à 1,5 fois le tarif de sortie.
Voici ce qui arrive au tarif officiel par million de tokens dès que votre requête passe de 272 000 à 272 001 tokens :
| Tranche de contexte |
GPT-6.1 Terra (Tarif officiel) |
Claude Sonnet 5.5 (Tarif officiel) |
Relation de prix d'entrée |
| Requête standard (≤272 000 tokens en entrée) |
1,00 $ entrée / 5,00 $ sortie / 0,05 $ lecture cache |
2,00 $ entrée / 10,00 $ sortie / 0,10 $ lecture cache |
Terra est 50 % moins cher en entrée et en sortie |
| Requête à contexte long (>272 000 à 1 M+ tokens en entrée) |
2,00 $ entrée / 7,50 $ sortie / 0,10 $ lecture cache |
2,00 $ entrée / 10,00 $ sortie / 0,10 $ lecture cache |
Les tarifs d'entrée et de lecture cache sont identiques (2,00 $ / 0,10 $ ) |
Contrairement au modèle plus petit Haiku 5.5 d'Anthropic (qui applique une surcharge de 5x au-delà de 100 000 tokens), Claude Sonnet 5.5 maintient une tarification fixe sur l'ensemble de sa fenêtre de contexte de 1 000 000 de tokens.
Faites le calcul pour un audit de dépôt de 400 000 tokens produisant 10 000 tokens en sortie aux tarifs officiels :
GPT-6.1 Terra (déclenche la règle >272 000 2x/1,5x) : (0,4 * 2,00 $) + (0,01 * 7,50 $) = 0,80 $ + 0,075 $ = 0,875 $.
Claude Sonnet 5.5 (tarif fixe) : (0,4 * 2,00 $) + (0,01 * 10,00 $) = 0,80 $ + 0,10 $ = 0,900 $.
Une fois que votre requête dépasse 272 000 tokens, la remise de 50 % sur l'entrée de Terra disparaît complètement, ne laissant qu'une différence totale de 0,025 $ sur un appel de 400 000 tokens. Ma recommandation est simple : n'envoyez jamais de requêtes monolithiques de plus de 272 000 tokens à GPT-6.1 Terra en espérant bénéficier d'une économie de moitié prix. Soit vous segmentez/récupérez votre contexte en dessous de 272 000 tokens pour que Terra reste dans sa tranche à 1,00 $ (0,80 $ GPT Proto), soit vous dirigez les dumps de dépôts de 300 000 à 900 000 tokens directement vers Claude Sonnet 5.5, où vous payez le même tarif d'entrée officiel tout en bénéficiant d'une meilleure compréhension du code sur le long terme. (Avant d'exécuter des requêtes >272 000 tokens en production via GPT Proto, vérifiez auprès du support de la plateforme comment l'ajustement du palier de 272 000 en amont est répercuté sur le solde de votre compte.)
Benchmarks et retours de la communauté : codage, frontend et travail agentique
Les scores composites globaux masquent les domaines où chaque modèle excelle réellement. Sur l'Artificial Analysis Intelligence Index v4.3.2, Claude Sonnet 5.5 (max, repli par défaut) obtient 56, GPT-6.1 Sol (max) obtient 52, et GPT-6.1 Terra obtient 48 avec un effort max et 41 avec un effort moyen. (Sur l'instantané de l'index du 3 novembre 2026 affiché sur la carte de comparaison de GPT Proto, Sonnet 5.5 enregistre 54,2 et Terra max enregistre 51 — un écart plus restreint de 3,2 points qui reste en faveur de Sonnet.) Pour prendre une décision de routage pratique pour le code, l'interface utilisateur frontend ou les boucles d'agents, nous devons décomposer ces agrégats par type de tâche et les comparer à ce que les développeurs rapportent sur le terrain.
1. Backend et codage sur terminal (GPT 6.1 Terra vs Sonnet 5.5 pour le code)
Pour l'ingénierie logicielle pure depuis la ligne de commande, Anthropic conserve un avantage évident. Sur Terminal-Bench 4.0, Anthropic rapporte 70,6 % pour Claude Sonnet 5.5 (contre 10,3 % pour Sonnet 5), tandis qu'OpenAI rapporte 50,3 % pour GPT-6.1 Terra à l'effort max (contre 21,5 % pour GPT-5.6 Terra). Dans le nouvel Coding Agent Index v2.0 d'Artificial Analysis, Terra obtient un score de 48, soit 17 points devant le modèle léger GPT-6 Luna (31), mais 6 points derrière GPT-6.1 Sol (54). Artificial Analysis note également que pour les agents de codage spécifiquement, les paramètres d'effort low et xhigh de Terra se situent sur la frontière de rentabilité, tandis que les autres paramètres d'effort sont à la traîne.
Les premiers tests en conditions réelles soulignent la limite exacte entre les deux modèles :
Le journal des modifications de GitHub Copilot du 26 octobre 2026 a rapporté que lors des premiers tests internes, GPT-6.1 Terra a résolu nettement plus de tâches de terminal et de codage C# que GPT-5.6 Terra, ajoutant une observation comportementale cruciale : « Il travaille par étapes concentrées et consolidées sur des tâches bien définies. » GitHub n'a pas publié les pourcentages bruts de taux de réussite dans cette note, il faut donc le considérer comme une constatation qualitative de la plateforme plutôt que comme un benchmark contrôlé.
Du côté de Claude, un test comparatif précoce réalisé par des développeurs sur r/ClaudeAI (exécutant dix tâches de codage personnelles trois fois par configuration à l'effort high dans Claude Code et pi-agent) a révélé que Sonnet 5.5 terminait systématiquement les implémentations en moins de tours conversationnels et avec moins de jetons de sortie que son prédécesseur, en grande partie parce que Sonnet 5.5 traite les appels d'outils parallèles de manière plus agressive. De même, sur l'évaluation externe CursorBench 4.0 de Cursor, Sonnet 5.5 à l'effort high a obtenu un score de 47,8 % pour 1,67 $ par tâche.
Ce qu'il faut retenir pour les développeurs backend : si le ticket est bien défini (écrire une méthode de service C#, ajouter un test unitaire ou corriger un script CLI isolé), Terra à l'effort low ou medium le terminera rapidement pour moins de la moitié du prix en jetons. Si le ticket nécessite de suivre l'état à travers dix fichiers où une boucle de nouvelle tentative supplémentaire ruine le flux de travail, la compétence terminale de 70,6 % de Sonnet 5.5 justifie le tarif plus élevé. Lorsque l'informatique scientifique est impliquée, OpenAI rapporte également que sur Terminal-Bench-Science 0.1 (comme l'écriture de code pour suivre les divisions cellulaires dans une vidéo en accéléré), Terra à l'effort max surpasse en réalité GPT-6.1 Sol et se rapproche à moins de cinq points de Claude Opus 5.5 pour moins d'un cinquième du coût estimé.
2. GPT-6.1 Terra vs Sonnet 5.5 pour le développement frontend
Rechercher GPT 6.1 Terra vs Sonnet 5.5 pour le développement frontend mérite une réponse spécifique, car l'ingénierie frontend consiste en deux métiers distincts réunis : le travail de mise en page visuelle/DOM et la logique d'état/architecture.
Lorsque OpenAI a présenté le score de 50,3 % de GPT-6.1 Terra sur Terminal-Bench 4.0, le seul exemple de codage concret mis en avant dans l'annonce était un bug frontend : « corriger une page web dont la mise en page se décale lors du chargement » (Cumulative Layout Shift, ou CLS). Parallèlement, OpenAI a rapporté que sur MMMU-Pro — un benchmark pour le raisonnement visuel sur des diagrammes, des captures d'écran et des mises en page denses — GPT-6.1 Terra surpasse GPT-5.6 Terra à tous les niveaux d'effort et égale presque les modèles de pointe GPT-6 Astra et GPT-6.1 Sol pour une fraction du prix. Dans le fil de discussion du jour de lancement sur le forum de la communauté des développeurs OpenAI, l'une des premières réactions de développeurs a résumé Terra comme « un excellent rapport qualité-prix, surtout en ce qui concerne la compréhension visuelle. Correct également sur le codage. »
Cette distinction offre aux équipes frontend une répartition claire des tâches :
Utilisez GPT-6.1 Terra pour le travail frontend visuel et de couche UI : transformer des captures d'écran ou des wireframes Figma en balisage Tailwind/HTML initial, comparer les captures d'écran Playwright rendues avec les spécifications de conception pour repérer les nœuds DOM qui se chevauchent ou les régressions de points de rupture mobiles, et diagnostiquer les décalages de mise en page CSS. Comme Terra traite les images nativement, s'exécute plus de 3 fois plus vite que GPT-6.1 Sol et Astra sur les benchmarks d'action visuelle, et coûte 0,80 $/4,00 $ sur GPT Proto, votre pipeline CI peut se permettre d'exécuter des vérifications de régression visuelle à chaque commit.
Utilisez Claude Sonnet 5.5 pour l'architecture frontend à forte intensité logique : refactoriser des arbres d'état complexes d'actions serveur React/Next.js, résoudre des contraintes génériques TypeScript complexes, ou migrer un store Redux hérité sans casser l'hydratation. Lorsqu'il n'y a pas de capture d'écran à inspecter et que la difficulté réside purement dans la cohérence d'état multi-fichiers, Sonnet 5.5 reste l'option la plus fiable.
3. Travail agentique, utilisation de l'ordinateur et exactitude (pour le travail agentique)
Si votre définition de GPT 6.1 Terra vs Sonnet 5.5 pour le travail agentique se concentre sur l'automatisation des interfaces graphiques, l'analyse de documents et l'utilisation informatique de back-office, GPT-6.1 Terra est sans doute la version la plus avantageuse d'OpenAI en 2026.
Dans les évaluations rapportées par le fournisseur OpenAI sur l'examen Agents' Last Exam v1 (qui teste des flux de travail professionnels en plusieurs étapes, comme la conversion de dessins architecturaux en modèle 3D ou l'enregistrement de timecodes plan par plan pour un film d'animation), GPT-6.1 Terra à un effort moyen a obtenu un score supérieur de 15 points de pourcentage à celui de GPT-5.6 Terra pour environ un tiers du coût, égalant le modèle phare GPT-6 Astra à un dixième du prix par jeton. À un effort maximal, OpenAI rapporte que Terra est plus de 3 fois plus efficace en termes de jetons que Claude Opus 5.5 et coûte 1/4 de son prix par jeton, ce qui donne un coût par tâche environ 9 fois inférieur tout en terminant les flux de travail plus de 3 fois plus rapidement que GPT-6 Astra et GPT-6.1 Sol.
Sur OSWorld 2.1 (contrôle d'applications de bureau), OpenAI rapporte que Terra à un effort moyen bat le meilleur score de GPT-5.6 Terra pour une fraction du coût par tâche. Pour rester équilibré, le score OSWorld 2.1 (hors ligne) publié par Anthropic pour Claude Sonnet 5.5 est un score très élevé de 83,9 % (divulgué dans le tableau de référence Haiku 5.5 d'Anthropic d'octobre 2026). Les deux modèles sont des moteurs d'utilisation informatique de premier plan ; la différence réside dans le fait que les agents de capture d'écran envoient une nouvelle capture d'écran à chaque clic, ce qui consomme rapidement les jetons d'entrée et rend le tarif d'entrée GPT Proto de 0,80 $/M de Terra beaucoup plus facile à maintenir à grande échelle.
Tout aussi important pour les agents autonomes est de savoir quand le modèle ne sait pas quelque chose. Dans le benchmark indépendant AA-Omniscience d'Artificial Analysis, le taux d'hallucination de GPT-6.1 Terra (la fréquence à laquelle le modèle devine lorsqu'il manque de connaissances) a chuté de 50 points de pourcentage — passant de 88 % sur GPT-5.6 Terra à 38 % — tout en gagnant simultanément 2 points en précision globale. Cette mesure indépendante confirme l'évaluation interne de l'exactitude d'OpenAI (détaillée plus en détail dans la fiche système de GPT-6.1 Terra), où les taux d'erreur factuelle à faible effort sur des invites difficiles sont passés de 53,6 % à 16,7 % (et jusqu'à 4,3 % à un effort maximal). Des taux d'hallucination plus faibles signifient moins d'appels d'outils corrompus en aval.
Expérience développeur et pièges de l'API (GPT 6.1 Terra vs Sonnet 5.5 pour les développeurs)
Passer de gpt-6.1-terra à claude-sonnet-5-5 en production est rarement une simple substitution de chaîne de caractères. Si vous évaluez l'ergonomie de GPT 6.1 Terra vs Sonnet 5.5 pour les développeurs, quatre contraintes au niveau de l'API dicteront votre travail d'intégration.
Premièrement, GPT-6.1 Terra prend en charge reasoning.effort: "none", contrairement à GPT-6.1 Sol. Lorsque OpenAI a lancé GPT-6.1 Sol le 29 septembre 2026, ils ont supprimé les niveaux de raisonnement none et minimal, forçant chaque requête sur le niveau low ou supérieur, ce qui a rendu inopérants les paramètres temperature et top_p. Selon le guide de migration et de prompting officiel d'OpenAI pour gpt-6.1-terra, Terra prend en charge tout le spectre : none, low, medium (par défaut), high, xhigh et max. Si vous définissez reasoning_effort: "none", Terra s'exécute sans générer de jetons de raisonnement masqués et autorise les paramètres d'échantillonnage standard. Cependant, dès que vous utilisez low, medium, high, xhigh ou max, vous devez supprimer temperature, top_p, top_logprobs et logprobs de votre charge utile de requête, sinon l'API rejettera l'appel avec une erreur HTTP 400.
Deuxièmement, OpenAI exige l'utilisation de l'API Responses (/v1/responses) pour l'appel d'outils sur GPT-6.1 Terra. Bien que les invites de texte et d'image simples fonctionnent sur /v1/chat/completions, la documentation du modèle d'OpenAI indique explicitement que l'appel d'outils nécessite /v1/responses. Une fois sur l'API Responses, Terra prend en charge les neuf outils natifs intégrés d'OpenAI — recherche Web, recherche de fichiers, génération d'images, interpréteur de code, shell hébergé, apply_patch, compétences, utilisation de l'ordinateur, MCP et recherche d'outils — ainsi que async: true sur les outils de fonction personnalisés, permettant au modèle de continuer à raisonner pendant l'exécution d'un outil en arrière-plan. De plus, Terra prend en charge l'envoi d'un élément d'entrée configuration_update au milieu d'une conversation pour augmenter ou diminuer reasoning.effort lors d'une étape complexe sans réécrire le préfixe de l'invite ni invalider votre cache d'invite de 30 minutes (prompt_cache_options.ttl: "30m").
Troisièmement, Claude Sonnet 5.5 possède ses propres pièges à erreurs 400. Selon le guide de migration de Anthropic pour Sonnet 5.5, Sonnet 5.5 utilise la réflexion adaptative par défaut (avec un effort high sur l'API et medium dans Claude Code, comme indiqué dans la documentation de configuration de Claude Code d'Anthropic). Si votre intégration Claude existante envoie thinking: {"type": "disabled"}, vous devez la mettre à jour vers between_tools pour obtenir le paramètre de réflexion le plus bas. Plus important encore, Sonnet 5.5 rejette les choix d'outils forcés (tool_choice: {"type": "any"} ou un outil nommé forcé) avec une erreur 400 lorsque la réflexion adaptative est active ; vous devez utiliser auto et guider la sélection de l'outil dans l'invite. Vous devez également analyser les blocs de contenu de réponse par type plutôt que de supposer que content[0] est du texte, car le premier bloc est fréquemment un bloc thinking.
Quatrièmement, l'intégration IDE et CLI est déjà configurée pour les deux. Notez que dans les abonnements grand public, les notes de version d'OpenAI confirment que GPT-6.1 Terra a été déployé sur ChatGPT Work et Codex (pour les plans Plus, Pro, Business, Enterprise et Edu), et non sur l'interface de chat ChatGPT standard, et qu'il ne prend pas en charge la résidence des données aux EAU (bien que le mode Rapide prenne en charge la résidence des données dans l'UE). Pour les développeurs travaillant dans des terminaux locaux, les deux modèles peuvent être connectés à Claude Code et OpenAI Codex via GPT Proto. Sur la page du modèle GPT-6.1 Terra, cliquer sur Essayer ce modèle ouvre un panneau de démarrage rapide où vous pouvez sélectionner Claude Code ou ChatGPT (Codex) sous Laisser l'IA terminer l'intégration, ou cliquer sur Copier le Markdown pour l'IA pour permettre à votre assistant de codage de configurer automatiquement les variables d'environnement.
Développement d'applications : comment router les deux modèles avec une seule clé API
Lorsque les équipes nous interrogent sur le choix entre GPT 6.1 Terra et Sonnet 5.5 pour le développement d'applications, la meilleure architecture consiste presque toujours à ne pas choisir un seul modèle pour 100 % du trafic. Comme les deux modèles sont regroupés sous un solde prépayé unique sur GPT Proto, vous pouvez router les requêtes étape par étape plutôt que par fournisseur : envoyez l'inspection visuelle à haute fréquence, la classification de captures d'écran et les correctifs d'interface utilisateur limités à gpt-6.1-terra à 0,80 $/4,00 $, et confiez la synthèse de code multi-fichiers à claude-sonnet-5-5 à 1,80 $/9,00 $.
1. Vérification initiale via cURL (Chat Completions compatibles OpenAI)
Les deux modèles peuvent être appelés pour l'analyse de texte et d'images via le point de terminaison unifié et compatible OpenAI de GPT Proto /v1/chat/completions en utilisant un jeton Bearer standard. Passer de l'un à l'autre ne nécessite de modifier que la chaîne "model" :
# Appel 1 : GPT-6.1 Terra (0,80 $ entrée / 4,00 $ sortie pour 1M de jetons sur GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [
      {
        "role": "user",
        "content": "Inspecte cette règle CSS et explique en deux phrases pourquoi elle déclenche un décalage de mise en page sur mobile : .hero-banner { width: 100%; height: auto; }"
      }
    ]
  }'

# Appel 2 : Claude Sonnet 5.5 (1,80 $ entrée / 9,00 $ sortie pour 1M de jetons sur GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "messages": [
      {
        "role": "user",
        "content": "Écris un helper TypeScript qui valide les signatures de webhook en utilisant l'API Web Crypto avec une comparaison à temps constant."
      }
    ]
  }'
2. Exemple de routeur d'étapes en Python pour les pipelines Frontend et App
Voici un modèle Python pratique utilisant le SDK openai standard pointé vers https://gptproto.com/v1. Dans ce flux de travail, l'étape 1 utilise gpt-6.1-terra pour trier un rapport de bug d'interface (où le volume de jetons est élevé et le diagnostic visuel/DOM est peu coûteux), et l'étape 2 route dynamiquement le correctif de code réel soit vers gpt-6.1-terra (pour des correctifs CSS isolés sur un seul composant), soit vers claude-sonnet-5-5 (lorsque le tri signale un changement d'état entre plusieurs fichiers ou lorsque le prompt approche la limite des 272 000 jetons) :
import os
import json
from openai import OpenAI

# Une seule clé API et un solde partagé entre les modèles OpenAI et Anthropic
client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

def triage_and_patch_ui_issue(dom_snapshot: str, screenshot_url: str, approx_tokens: int) -> dict:
    # Étape 1 : Effectuer systématiquement un triage visuel/DOM sur GPT-6.1 Terra (0,80 $ / 4,00 $ par 1M de tokens)
    triage_response = client.chat.completions.create(
        model="gpt-6.1-terra",
        messages=[
            {
                "role": "system",
                "content": (
                    "Vous êtes un agent de triage QA frontend. Inspectez la capture d'écran et le DOM. "
                    "Retournez un JSON avec les clés : 'root_cause', 'scope' ('isolated_css' ou 'multi_file_state'), "
                    "et 'target_files' (tableau de chaînes)."
                ),
            },
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": f"Instantané DOM : {dom_snapshot}"},
                    {"type": "image_url", "image_url": {"url": screenshot_url}},
                ],
            },
        ],
        response_format={"type": "json_object"},
    )

    triage_data = json.loads(triage_response.choices[0].message.content)

    # Étape 2 : Routage selon la portée de la tâche ET la limite de facturation de contexte long de 272K
    # Si le correctif touche à un état multi-fichiers OU dépasse 272K tokens en entrée, escaladez vers Sonnet 5.5
    if triage_data.get("scope") == "multi_file_state" or approx_tokens > 272_000:
        selected_model = "claude-sonnet-5-5"
    else:
        selected_model = "gpt-6.1-terra"

    patch_response = client.chat.completions.create(
        model=selected_model,
        messages=[
            {
                "role": "user",
                "content": (
                    f"Diagnostic de triage : {json.dumps(triage_data)} | "
                    f"Générez un correctif minimal prêt pour la production pour le DOM/composant : {dom_snapshot}"
                ),
            }
        ],
    )

    return {
        "triage": triage_data,
        "routed_to": selected_model,
        "patch": patch_response.choices[0].message.content,
    }

if __name__ == "__main__":
    sample_dom = "<div class='card-grid'><img src='/hero.webp' /><h2>Checkout</h2></div>"
    result = triage_and_patch_ui_issue(
        dom_snapshot=sample_dom,
        screenshot_url="https://example.com/cls-regression-frame.png",
        approx_tokens=12_000,
    )
    print(f"Correctif routé vers : {result['routed_to']}")
    print(result["patch"])
Note de pré-déploiement (test de fumée requis) : Vérifiez les chaînes de modèles exactes (gpt-6.1-terra et claude-sonnet-5-5) par rapport aux panneaux d'utilisation de l'API en direct sur leurs pages de modèles GPT Proto avant de déployer des boucles facturables. Si votre agent s'appuie sur les outils de l'API Responses native d'OpenAI (apply_patch, Hosted shell, ou les appels de fonction async: true) ou sur les paramètres de réflexion adaptative natifs d'Anthropic /v1/messages (output_config.effort), effectuez un test de fumée rapide sur les points de terminaison natifs respectifs de GPT Proto (/v1/responses et /v1/messages) pour confirmer le passage des paramètres sur votre route.
Verdict : lequel devriez-vous utiliser ?
Si vous souhaitez un tableau unique à copier dans un document de revue d'architecture, faites correspondre votre charge de travail principale au mode de défaillance et à la limite de facturation qui vous importent le plus :
| Charge de travail / Scénario |
Modèle recommandé |
Paramètre recommandé |
Pourquoi il gagne |
| QA de captures d'écran à haut volume, lecture de factures/formulaires et utilisation d'ordinateur via navigateur |
GPT-6.1 Terra |
low ou medium effort |
Taux de jetons GPT Proto 56 % inférieur (0,80 $/4,00 $), exécution des tâches >3x plus rapide que Sol/Astra, et vision MMMU-Pro au niveau d'Astra. |
| Débogage d'interface frontend (décalages de mise en page CLS, Figma-vers-CSS, régressions visuelles) |
GPT-6.1 Terra |
medium effort |
Conçu pour l'inspection visuelle + DOM ; explicitement évalué sur les correctifs de décalage de mise en page de pages web. |
Classification à faible latence, routage ou extraction JSON où la temperature est nécessaire |
GPT-6.1 Terra |
reasoning.effort: "none" |
Rétablit le niveau none sans raisonnement que GPT-6.1 Sol avait supprimé, en maintenant la latence et le nombre de jetons de sortie au minimum. |
| Refactorisation backend multi-fichiers et changements d'état complexes TypeScript/React |
Claude Sonnet 5.5 |
medium ou high effort |
70,6 % contre 50,3 % sur Terminal-Bench 4.0 ; regroupe les appels d'outils en moins de tours, économisant un temps de revue coûteux pour les développeurs. |
| Analyse de dépôt à long contexte en une seule requête (300 000 à 900 000 jetons d'entrée) |
Claude Sonnet 5.5 |
medium ou high effort |
Terra déclenche une surcharge de 2x en entrée / 1,5x en sortie au-delà de 272 000 jetons (passant à 2,00 $ officiels en entrée), annulant son avantage tarifaire. |
Codage terminal natif OpenAI le plus approfondi lorsque le max de Terra ne suffit pas |
GPT-6.1 Sol |
medium effort |
Obtient un score de 54 contre 48 pour Terra sur l'AA Coding Agent Index v2.0, et le medium de Sol (0,21 $/tâche) est en réalité moins cher par tâche que le `max` de Terra (0,40 $/tâche). |
Pour résumer le verdict sans détour : commencez chaque étape répétable de visuel, d'utilisation d'ordinateur et de codage borné sur GPT-6.1 Terra avec un effort low ou medium pour bénéficier du tarif de 0,80 $/4,00 $, et gardez Claude Sonnet 5.5 pour les étapes de codage multi-fichiers et les invites >272 000 jetons où sa meilleure précision au premier passage et sa tarification fixe pour 1M de contexte sont rentables. Pour intégrer vos propres ratios mensuels d'entrée et de sortie, ouvrez le calculateur de comparaison GPT Proto et testez les deux modèles côte à côte sur un seul solde.