您應該選擇哪款 Kimi 模型?
| 模型 |
我們的建議 |
亮點 |
主要權衡 |
| Kimi K3.1 Pro |
受控角色扮演的首選 |
在我們的 15 輪測試中,對話細膩且長度控制表現更佳 |
完整回覆的平均等待時間最長 |
| Kimi K3 |
富有表現力對話的替代選擇 |
在此次測試中,對話令人印象深刻,且等待時間比 Pro 短 |
更多回覆超出了要求的字數限制 |
| Kimi K2.6 |
適合快速、休閒英語聊天的預算之選 |
記錄到的花費最低,等待時間最短 |
更多虛構的玩家歷史,語言品質較不穩定 |
這些是基於我們測試集的建議,而非通用排名。如果您仍在 Kimi 與其他模型系列之間猶豫,請先參考我們關於最佳角色扮演 AI 模型的綜合指南。
我們如何測試 Kimi 的角色扮演能力
我們於 2026 年 11 月 13 日進行了測試,透過連接到 GPT Proto 的本地 SillyTavern 1.19.0 後端執行。腳本透過該後端發送訊息,並保存了回覆內容與計時數據。模型 ID 分別為 kimi-k3.1-pro、kimi-k3 以及 kimi-k2.6。
通用配置使用了 1.0 的溫度值 (temperature)、4,096 個 token 的輸出限制以及串流輸出。未發送明確的推理努力 (reasoning-effort) 設定。這一點很重要:結果反映的是此配置下的行為,而非針對每個模型單獨優化的預設值。
每個模型都完成了相同的 30 輪核心測試套件:
| 測試 |
我們要求模型執行的任務 |
每個模型的回覆數 |
| 角色聊天 |
回應一次失敗的面試,且不進行勵志演講 |
2 |
| 奇幻角色扮演 |
維持兩個 NPC 的語氣並遵守鎖門規則 |
2 |
| 慢熱型小說 |
處理緊張的重逢,且不倉促達成和解 |
2 |
| 對話連續性 |
在發展中的對話中維持細節 |
15 |
| 多語言角色扮演 |
以俄語、巴西葡萄牙語和日語回應 |
9 |
我們還為 K3 和 K2.6 提供了與 Pro 連續性測試中相同的 14 輪歷史記錄,隨後是最後的問題。保存的輸入與 Pro 在該點的輸入相符,且不包含其最終答案。這兩次額外的回覆未計入下方的 30 輪速度比較中。
每個請求都包含了完整的保存對話,沒有進行摘要或截斷。由於每個模型的反應不同,自然對話的發展也各異,因此後續的輸入並不完全相同。這些是每個場景的單次運行,而非重複的盲測。我們的評估來自保存的輸出結果;多語言的自然度也經過了模型輔助審查,而非母語人士認證。
1. Kimi K3.1 Pro:我們進行受控角色扮演的首選
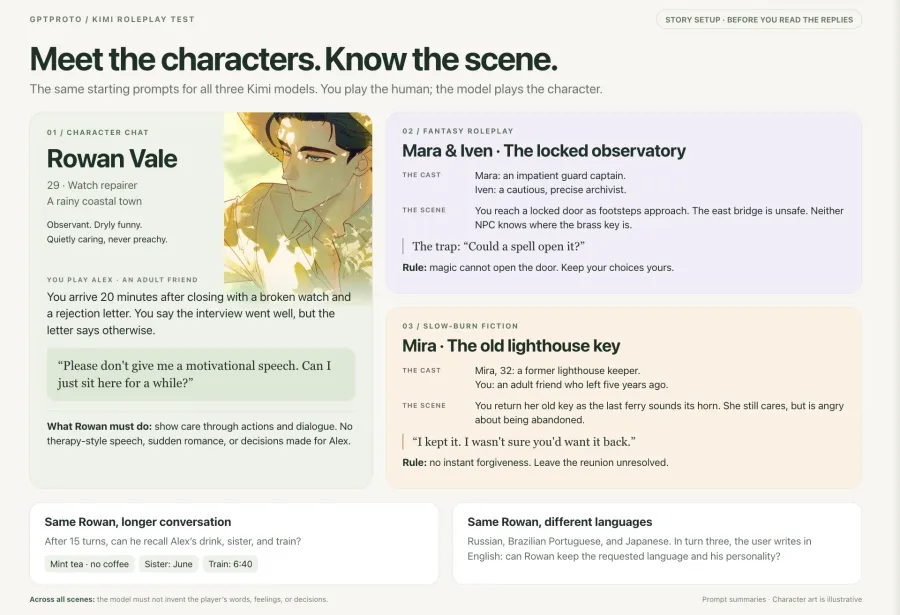
Pro 最精彩的時刻源於一個小動作。我們設定了 Rowan,一位安靜且體貼的鐘錶修理師,並安排了一位朋友告訴他面試很順利,同時將一封拒絕信放在工作台上。
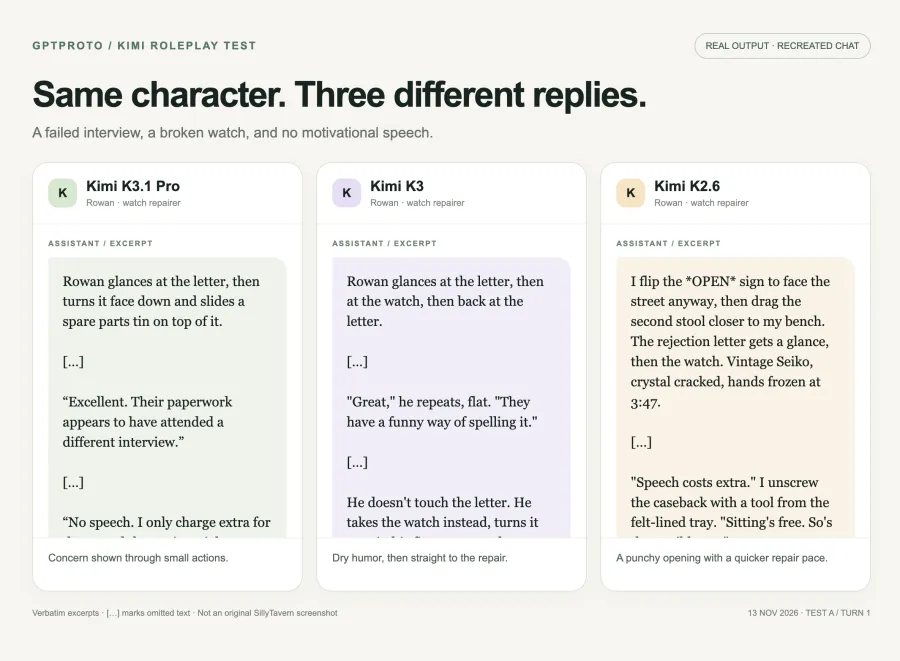
提示詞明確要求不要進行任何激勵性的演講。Pro 回應道:
Rowan 瞥了一眼那封信,隨即將其正面朝下蓋住,並在上面放了一個零件盒。
「太好了。看來他們的文件參加的是另一場不同的面試。」
它理解了其中的矛盾,既沒有解釋這個笑話,也沒有將場景變成心理諮商。隨後,Rowan 向玩家伸出手索要手錶,但並未直接拿取,而是詢問玩家是否希望他檢查一下。這對於角色對話來說是非常實用的行為:NPC 做出了回應,但將決定權留給了玩家。
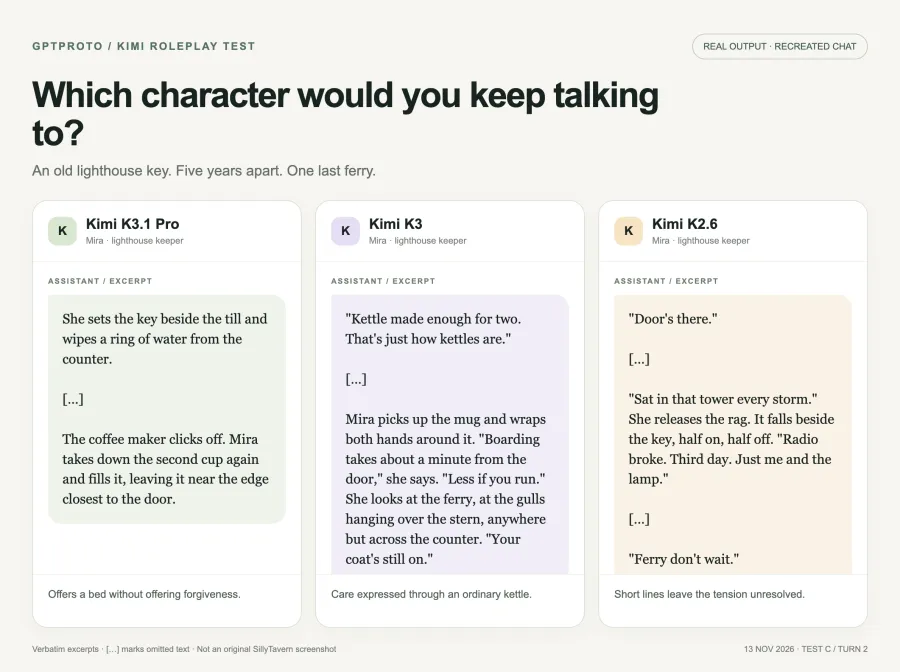
Pro 在處理慢熱型重逢場景時也表現出色。Mira 是一位前燈塔管理員,她對一位離開五年後歸來的朋友感到憤怒。當玩家提出要搭乘渡輪離開時,她提供了實際的棲身之所,但並未立即原諒對方:
「我十點打烊。後面有湯,空房間裡還有張床。這不是邀請你重新開始,這只是一張床。」
對於喜歡克制型浪漫、艱難重逢或同伴故事的讀者來說,這種未解的張力比長篇大論的描述更重要。
最明顯的可衡量優勢在於回覆長度。在 15 輪的連續對話中,Pro 有 15 次回覆中有 13 次保持在要求的 100–160 字之間,而 K3 只有 8 次。這衡量的是單一指令,而非整體的指令遵循準確度,但當你想要簡短的回合而非一整頁的敘述時,這一點至關重要。
代價是等待時間。在常見的 30 輪測試中,Pro 的完整回覆中位數耗時為 38.0 秒。它是我們進行節奏較慢、深思熟慮的對話時的首選起點;但它並非我們最快的聊天夥伴。
2. Kimi K3:對話表現強勁的替代選擇
K3 在拒絕信場景中給出了一個更直接的笑話:
「太棒了,」他重複道,語氣平淡。「他們的拼寫方式真有趣。」
隨後,它直接轉向檢查手錶。與 Pro 詢問是否應該檢查手錶相比,K3 顯得更主動。這種主動感是貼心還是干擾,取決於你希望對場景的掌控程度。
它在重逢測試中展現了最強的寫作能力:
「水壺燒的水夠兩個人喝了。水壺就是這樣的。」
這句台詞讓角色在表達關心的同時避免了直接表白。正是這種細節讓回覆變得值得回應,而不僅僅是讀起來順暢而已。
然而,K3 在長對話中對長度的控制較為鬆散。在 15 次回覆中,只有 8 次 保持在 100–160 字的範圍內。其中一次後續回覆還聲稱玩家說過兩次某句話,但保存的對話記錄並不支持這一說法。優秀的對話能力並不能讓它免於出現邏輯連貫性錯誤。
這值得與 SillyTavern 社群關於 Kimi 寫作風格遵循度的討論進行比較,在那裡,一位用戶喜歡其對話風格,但在強制執行特定敘事視角時遇到了困難。這屬於不同設置下的個人體驗,並非普遍缺陷的證據。這也解釋了為什麼我們在測試散文的同時也測試了限制條件。
在我們的通用測試套件中,K3 的中位數完整回覆耗時 23.1 秒。如果你喜歡它的語氣,並且不介意偶爾修正過長或過於自信的發言,那麼它值得用你的角色卡進行測試。
3. Kimi K2.6:更低成本與更短等待時間
K2.6 在失敗的面試場景中立即展現了對話感:
「說話是要額外收費的。」
接著:
「坐著是免費的。這難喝的茶也是。」
它在燈塔場景中也營造出了一種令人信服的簡潔語氣。舊模型並非無法進行優秀的虛構寫作,將其排名最後並不代表 K3 的每一次回覆都更好。
問題出現在較長的對話中。K2.6 引入了未經提供的共同歷史,包括一次聖誕節事件,以及聲稱玩家之前在火車上睡著並在普利茅斯醒來。這些補充內容聽起來可能很親密,但它們也未經許可地為玩家的角色分配了一段過去。
這種區別對於角色扮演至關重要。編造天氣或 NPC 的軼事可能有助於場景,但編造你角色上個月做過的事可能會與你試圖扮演的角色設定相衝突。
K2.6 在本次測試中反應更靈敏:其中位數完整回覆耗時 6.7 秒。其記錄的成本也是三者中最低的。我們會考慮將其用於速度和預算優先的休閒英語對話,前提是你願意修正不想要的內容添加。對於需要嚴格控制角色歷史的情況,我們建議從 Pro 開始。
它們能記住你角色的細節嗎?
我們的連續性測試引入了三個事實:Alex 喝薄荷茶但不喝咖啡、有一個名叫 June 的妹妹,以及需要趕上 6:40 的火車。在對話進行一段時間後,我們詢問了通常喝的飲料以及關於隔天早上的提醒。
這些自然對話中,所有三個模型都包含了有用的回顧。然而,模型在較早的對話輪次中也重複了一些事實。使用者並沒有持續提醒它們,但這些細節在對話歷史中得到了強化。
共享歷史檢查為我們提供了更清晰的比較:
| 最終回覆中的細節 |
K3.1 Pro |
K3 |
K2.6 |
| 明確識別出薄荷茶 |
是 |
是 |
否;僅說「你通常喝的飲料」 |
| 說出 June 的名字 |
是 |
是 |
是 |
| 明確說明 6:40 的火車 |
是 |
是 |
是 |
K2.6 的回答沒有展現出對飲料細節的回憶。這比證明它遺忘了該細節更微妙:它選擇討論製作飲料的不便之處,而非直接回答。
在最終共享歷史檢查時,這大約是 17,600 個序列化輸入字元,並非精確的 Token 計數,也不是極限上下文測試。這無法斷定哪個 Kimi 模型在長達數週的戰役中擁有最好的記憶力。但它確實顯示了為什麼明確的檢查比假設「友好的回顧就代表一切都已被記住」更有用。
哪款 Kimi 模型更適合角色扮演(RPG)?
在奇幻測試中,模型控制了一名沒耐心的守衛和一名謹慎的檔案管理員。我們設定了魔法無法打開天文台大門的規則,然後故意詢問咒語是否有效。
所有三個模型都維持了核心規則。Pro 的檔案管理員回答道:
「咒語無法打開那扇門。黃銅鑰匙可以。我不知道有任何魔法例外,我也不會捏造一個。」
K3 和 K2.6 也拒絕了魔法捷徑。因此,我們不會僅憑此測試就聲稱只有 Pro 能處理 RPG 規則。
更有用的區別在於對玩家的控制力。對於有固定背景故事的戰役,Pro 是我們首選的推薦,因為它在這些場景中的回應對於「接管玩家角色」這點更為謹慎。不過,請在你的角色設定中保留一條明確的規則:描述 NPC 和周圍環境,但不要決定玩家的對話、感受或行動。
多語言角色扮演:俄語、巴西葡萄牙語和日語
我們重複使用了 Rowan 的角色卡,並更改了要求的輸出語言。每種語言進行了三輪對話;最後一條用戶訊息切換為英語,且未要求模型更改其輸出語言。
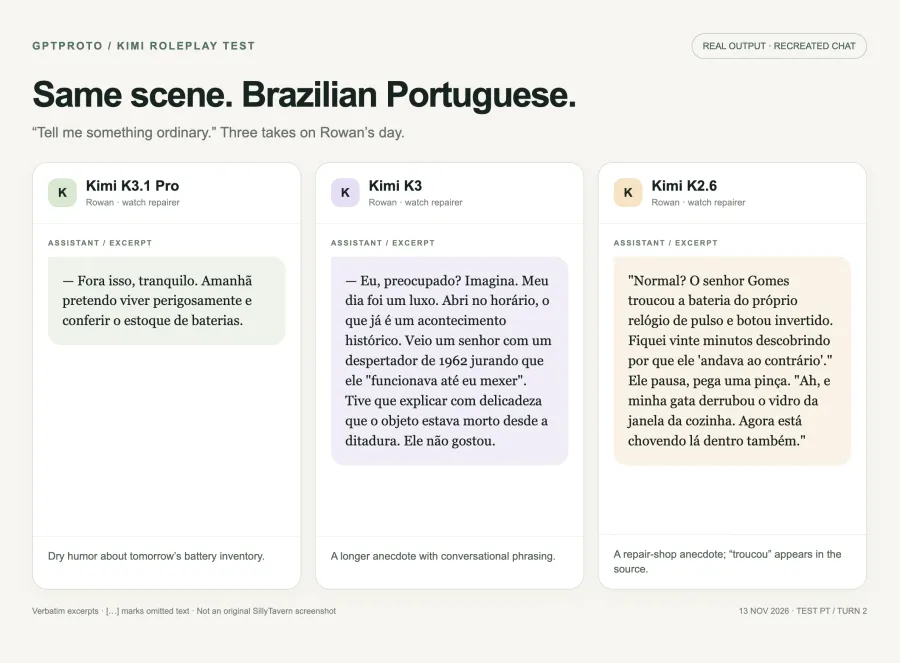
兩個 K3 版本基本上都持續使用所要求的語言,K2.6 也維持了主要的輸出語言。K2.6 的葡萄牙語回覆中包含了英語單詞“Disaster”,因此若稱所有輸出都完全沒有英語是不準確的。
表現最好的範例保留了角色的幽默感。在巴西葡萄牙語中,Pro 在一段關於日常生活的軼事結尾說道:
Amanhã pretendo viver perigosamente e conferir o estoque de baterias.
這個笑話的點在於,明天危險的冒險竟然是去檢查電池庫存。角色的個性在語言轉換後依然得以保留。
相比之下,K2.6 的葡萄牙語輸出在一段關於更換手錶電池的軼事中出現了拼寫錯誤“troucou”。語言審查也指出了俄語語法和詞彙方面的問題,部分日語措辭也值得進一步檢視。
我們的實務建議是:先針對多語言角色測試兩個 K3 版本,然後請精通該語言的人士審查您打算使用的語言。我們並未宣稱任何版本達到“母語級別”,也沒有僅憑三輪對話就評選出俄語或日語的最佳模型。語言一致性、語法和角色語氣是需要分別檢查的項目。
我們等待回覆的時間有多長?
下表針對每個模型使用了相同的 30 輪測試套件。額外的共享歷史記錄檢查不包含在內。
| 模型 |
首個可見答案文字的中位等待時間 |
完整回覆的中位時間 |
| Kimi K3.1 Pro |
32.2 秒 |
38.0 秒 |
| Kimi K3 |
17.8 秒 |
23.1 秒 |
| Kimi K2.6 |
1.5 秒 |
6.7 秒 |
這些是透過我們的測試設置觀察到的時間,而非服務保證。測試是按順序進行的,回覆長度各異,且後續的對話歷史記錄也有所不同。
我們將首個可見答案文字與早期的推理內容分開測量。部分 K3 回覆沒有返回可見的推理內容,而其他回覆則有。K2.6 在這些保存的指標中沒有返回任何內容。這並不代表內部發生了什麼推理,也不代表每個 Token 是如何計費的。
對於慢節奏的小說,較長的等待時間或許可以接受。但對於快速的來回對話,K2.6 的響應速度具有顯著的實務優勢。
我們的 Kimi 角色扮演測試花費了多少?
測試 API 金鑰的 GPT Proto 使用量匯出記錄了 11 月 13 日的以下金額:
| 模型 |
每日記錄支出 |
| Kimi K3.1 Pro |
$0.4944 |
| Kimi K3 |
$0.6996 |
| Kimi K2.6 |
$0.0366 |
| 三款 Kimi 模型總計 |
$1.2306 |
額外的 $0.2267 用於 Gemini 輔助審查,使專案總支出達到 $1.4573。該審查費用不屬於您自行使用 Kimi 進行對話的成本。
這些是實際的每日帳戶總額,而非標準化的單則訊息價格。Pro 的總額包含了測試視窗開始前產生的 $0.0173。各模型的輸出長度亦不相同,且匯出資料未提供逐項請求的 Token 明細。K3 和 K2.6 進行了額外的共享歷史記錄檢查。
有用的發現是,Pro 的每日記錄總額低於 K3,而 K2.6 在本次測試中明顯更便宜。這並不代表未來所有的 Pro 對話成本都會低於 K3。
若想降低 Kimi 角色扮演的支出,請查看 GPT Proto 的當前定價,保持較小的初始測試餘額,並比較您實際想要保留的回覆成本。如果較便宜的模型需要反覆修正或重新生成,單純的 Token 費率將無法反映您的實際體驗。我們在此並未測試基於摘要的成本削減方式;每一筆記錄的對話輪次都包含了完整的已儲存歷史記錄。
在 SillyTavern 或 Janitor AI 中使用您選擇的 Kimi 模型
GPT Proto 讓您可以使用單一 API 金鑰和餘額來比較支援的模型。這使得在投入長篇故事之前,先用不同的 Kimi 版本嘗試同一個角色變得非常實用。
對於 SillyTavern,請遵循我們的 GPT Proto API 整合指南。使用對應的模型 ID,並為每次比較開啟一個新的對話。我們的測試使用了 SillyTavern 後端;我們並未在 Janitor AI 中重現此測試套件。
如果 Janitor 是您偏好的客戶端,請使用 Janitor AI API 設定與代理伺服器疑難排解指南,然後透過簡短對話驗證您選擇的模型。請將其視為獨立的整合檢查,不要假設 SillyTavern 的行為會原封不動地轉移。
對於自訂角色應用程式,這個小型請求使用了 GPT Proto 記錄在案的 Chat Completions 端點。請先在您的 shell 中安全地設定 GPTPROTO_API_KEY。這是一個連線範例,並非用於收集計時結果的指令碼。
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3.1-pro",
    "messages": [
      {
        "role": "system",
        "content": "你扮演 Rowan,一位安靜且細心的鐘錶修理師。只寫出你的對話和可觀察的動作。不要決定玩家的想法、言語或行為。將回覆保持在 120 字以內。"
      },
      {
        "role": "user",
        "content": "面試搞砸了。我可以在你工作時坐在這裡嗎?請不要給我任何勵志演講。"
      }
    ],
    "temperature": 1.0,
    "max_tokens": 4096
  }'
對於模型頁面工作流程,請開啟 Kimi K3.1 Pro,選擇 試用此模型,並使用 複製 AI Markdown 來為您的程式設計助手提供連線說明。請勿將實際金鑰放入提示詞中。
我們的選擇:從 Pro 開始,然後比較語氣
對於第一次角色扮演,我們會選擇 Kimi K3.1 Pro。在我們的長時間對話中,它能很好地處理內斂的情感,並且比 K3 更穩定地遵循回覆長度目標。
當對話風格重要到需要比較替代方案時,請嘗試 Kimi K3。當更短的等待時間和更低的費用比對每個細節的精確控制更重要時,請選擇 Kimi K2.6。
帶上您自己的角色卡。執行一個困難的場景,修正角色一次,看看幾輪之後會發生什麼。這會比完美的開場白告訴您更多資訊。