Qwen 4 Max 概覽:從「Qoduck」盲測到 14 天預覽版
如果您想了解 Qwen 4 Max 的實用概覽,請從它公開命名前的四天說起。在 2026 年 11 月 7 日至 11 月 10 日期間,一個代號為 Qoduck 的匿名模型出現在 Qoder(一款代理式編碼 IDE)中。測試 Qoduck 的開發者注意到一種不同尋常的模式:該模型沒有像以往那樣快速返回單次代碼片段並等待人類反饋,而是花費了 10 到 15 分鐘來啟動 Shell 檢查、從零開始編寫自定義 SVG 資產,並針對自身的差異(diffs)運行單元測試,最後才返回最終答案。
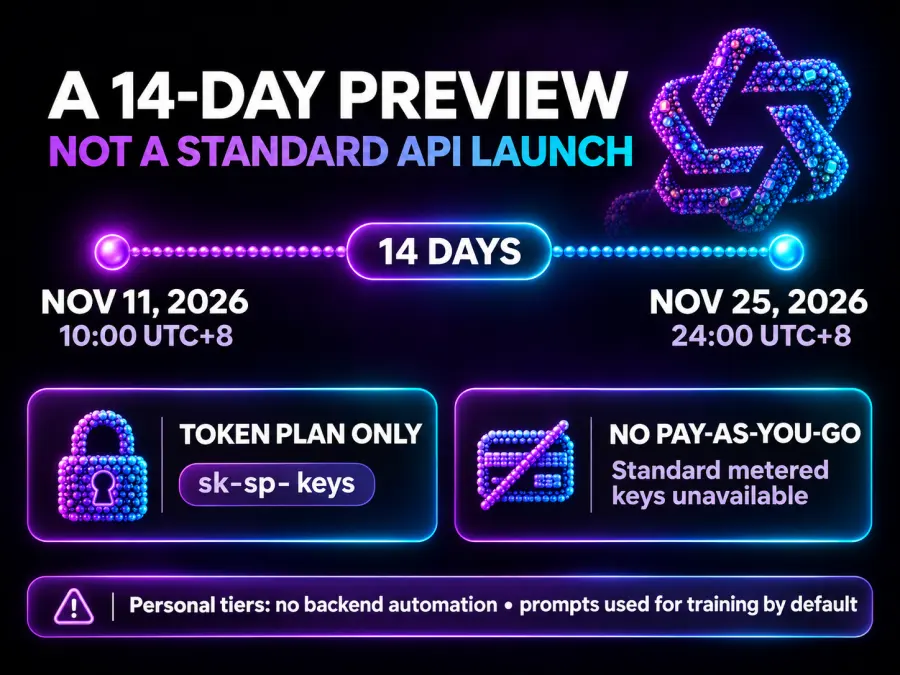
2026 年 11 月 11 日 10:00 (UTC+8),阿里巴巴證實 Qoduck 即為 Qwen 最新模型 Qwen 4 Max,並將其發佈在 Alibaba Cloud Model Studio 中,模型字串為 qwen4-max-preview(在部分客戶端配置中引用為 qwen4.0-max-preview)。阿里巴巴並未進行按 Token 計費的全面商業發佈,而是將此次推廣(在開發者文檔中常被描述為透過 14 天 Qwen 4 Max 預覽版引入)定位為針對 Claude Code、Cursor、Cline 和 Qoder 等開發工具內代理工作流程的壓力測試。
| 規格 |
確認狀態 (qwen4-max-preview) |
來源 / 工程說明 |
| 官方模型 ID |
qwen4-max-preview |
阿里雲 Model Studio / 百煉文檔 |
| 預覽窗口 |
2026 年 11 月 11 日 (10:00) – 2026 年 11 月 25 日 (24:00 UTC+8) |
嚴格的 14 天限時預覽 |
| 上下文窗口 |
1,000,000 個 Token(最大輸入:967,000 個 Token) |
已在中國及國際文檔中驗證 |
| 最大輸出 Token |
總計 393,216(131,072 最終輸出 + 262,144 推理) |
max_tokens 限制包含思考與輸出總和 |
| 輸入 / 輸出模態 |
輸入:文字、圖像、影片 · 輸出:文字 |
預覽路徑不支援原生音訊輸入 |
| 推理控制 |
reasoning_effort: low(低)、medium(中)、xhigh(極高) |
預設開啟思考模式;預設為 xhigh |
| 支援的 API 協議 |
OpenAI Chat Completions、Responses API、Anthropic Messages |
需要專用的 sk-sp- Token 計劃端點 |
| 參數規模與權重 |
未公開(封閉商業預覽) |
網路上流傳的 2.4T / 95B 數據屬於 Qwen3.8-Max |
| 官方基準測試表 |
預覽發佈時未公佈 |
流傳的 49.9 GameFeel 分數屬於 Qwen-4-Flash-Early |
將 qwen 4 max 解讀 為一代跨越,關鍵在於它如何在推理時消耗計算資源。早期的版本將工具調用視為可選的輔助功能,而核心的 qwen 4 max 升級 將自我驗證循環內建於預設的推理軌跡中。當被要求構建 Web 應用程式或修補命令行工具時,該模型會例行公事地鏈接數十次工具調用——檢查目錄樹、運行 pytest 或本地無頭瀏覽器、捕捉自身的語法或佈局回歸,並在用戶看到輸出之前重寫錯誤的代碼行。
架構、模型規模與基準測試的現實檢視
目前搜尋結果中,關於 qwen 4 max size 與 qwen 4 max benchmark 的資訊充斥著兩大誤區。釐清這些誤區是了解阿里巴巴實際發布了什麼以及哪些資訊尚未公開的最快途徑。
首先,阿里巴巴尚未公開 alibaba qwen 4 max 的總參數或活躍參數數量。一些第三方部落格將其列為具有 2.4 兆參數的混合專家模型 (MoE),每個 Token 擁有 950 億個活躍參數。這些確切數字屬於上一代旗艦模型 Qwen3.8-Max,該模型於 2026 年 9 月發布。雖然 Qwen 4 Max 幾乎可以肯定使用稀疏 MoE 主幹架構來經濟地支援 1M 的上下文視窗,但您在 2026 年 11 月看到的任何具體兆級參數數字,都是從 3.8 代沿用而來的未經證實資訊。
我們目前掌握的架構資訊來自阿里巴巴於 2026 年 8 月發布的 Qwen3.8-Flash-Next 技術報告,Qwen 團隊明確將其指定為驗證 Qwen 4 系列核心架構升級的測試平台。該前導報告記錄了四項結構性變更,解釋了 qwen4-max-preview 如何處理百萬 Token 的工作負載:
混合 GDN + QSA 注意力機制: 將門控 DeltaNet (GDN) 線性注意力層與 Qwen 稀疏注意力 (QSA) 相結合,與標準的全注意力機制相比,在 1,000,000 Token 的上下文長度下,首字延遲 (TTFT) 預填充速度提升了高達 7.6 倍。
4-串流門控殘差連接: 透過學習門控擴展殘差流寬度,改善了深度多步驟推理過程中的梯度流與跨層特徵路由。
N-gram 嵌入層: 在嵌入階段直接注入多 Token 的局部上下文,減輕了早期注意力區塊在詞彙模式匹配上的負擔。
Muon 優化器訓練: 將大規模預訓練優化切換至 Muon,提升了在程式碼與形式邏輯語料庫上的樣本效率。
其次,如果您搜尋 qwen 4 max benchmark 結果,很可能會看到 Qwen 4 Max 在 GameFeel Bench v1.4 獲得 49.9 分,險勝 Claude Opus 5.5 的 47.2 分的說法。我查閱了排行榜與底層提交日誌:該 49.9 分是由一個名為 Qwen-4-Flash-Early(內部代號 hawk)的早期輕量級測試檢查點所記錄,而非 qwen4-max-preview。截至 2026 年 11 月 13 日,阿里巴巴尚未發布 Qwen 4 Max 的官方 MMLU-Pro、SWE-bench Verified 或 AIME 排行榜數據。
您現在可以驗證的是 qwen 4 max context window 的機制及其輸出預算——這正是遷移開發者遇到瓶頸的地方。雖然上下文視窗可容納 1,000,000 個 Token(文件記載提示詞上限為 967,000 個 Token),但國際門戶網站列出的最大輸出為 393,216 個 Token,而國內門戶網站則將其細分為 262,144 個推理 Token 與 131,072 個最終答案 Token。
關鍵在於:max_tokens API 參數在 qwen4-max-preview 中控制了 sum(總和),即 reasoning_content 與 content 的總和。由於該模型預設為 reasoning_effort: "xhigh"(三種可用設定中最高的一種:low、medium 以及 xhigh),一個複雜的程式設計提示詞很容易在隱藏的思考區塊中消耗掉 15,000 到 40,000 個 token。如果現有的客戶端程式碼傳遞了 max_tokens: 4096 或 8192,模型將會在思考過程中耗盡其配額,並返回一個空的 content 字串。為了避免靜默截斷,請將 max_tokens 提高到 65,536 以上,或者在執行常規任務時將 reasoning_effort 明確調降至 medium。
Qwen 4 Max 實測:社群與媒體測試揭示了什麼
由於阿里巴巴跳過了傳統的基準測試新聞發布,最可靠的 qwen 4 max 評測 數據來自於在預覽版發布的前 48 小時內,將 qwen4-max-preview 接入即時代理(Agent)系統的工程團隊。他們的日誌顯示出一個明顯的模式:輸出品質的每一次提升,都伴隨著顯著的延遲增加與 Token 成本上升。
11 月 11 日,日本 AI 諮詢公司 WEEL 發布了一份三部分的評估報告,測試了該預覽模型在前端合成、多來源研究以及 Claude Code 內部的儲存庫級別除錯能力:
908 行自訂 SVG 登陸頁面(對比 Qwen 3.8 Max): 在給予完全相同的提示詞以建構一個林業主題物理治療診所的響應式登陸頁面時,Qwen3.8-Max 花了大約 9.5 分鐘完成,但拉取了隨機的外部圖庫照片,導致網格破裂或載入失敗。qwen4-max-preview 花了大約 17 分鐘——耗時幾乎是前者的兩倍。它沒有連結脆弱的外部 URL,而是在後台數十次調用其程式碼直譯器(Code Interpreter),以程式化方式繪製了森林樹冠、診所建築和員工圖示的自訂 SVG 插圖,最終交付了一個 908 行且無任何資源損壞的 HTML 檔案。
Claude Code 中的自主 CLI 除錯(36/36 測試通過): WEEL 將 Claude Code(透過 Anthropic 相容端點由 qwen4-max-preview 驅動)指向一個本地 Python 家庭記帳 CLI 工具(kakeibo),並要求其添加 --export-csv 和 --month 過濾標記以及單元測試。執行過程耗時 11 分 48 秒。在編寫完初步實作後,模型執行了 pytest,捕獲了 2 個失敗的測試——包括一個邊緣情況,即像 -100日元 這樣的負數貨幣字串被 Python 的 argparse 誤解為命令列標記——並自行修復了解析器。在未經提示的情況下,它還預先添加了 utf-8-sig BOM 標頭,以防止日文字元在 Microsoft Excel 中出現亂碼,並轉義了開頭的 =、+、- 和 @ 字元,以防止 CSV 公式注入。所有 36 項測試均通過,僅消耗了每月 Lite 方案配額的 0.4%。
自我驗證政策研究: 在被要求編制一份 2026 年日本中小企業補貼比較表時,該模型花了 2 分鐘在各個政府部門入口網站進行了十幾次網路查詢,並花了 5 分鐘執行 grep 和 Python 驗證腳本,以確保在呈現 8 分鐘的結果之前,沒有 Markdown 表格列發生錯位。
兩天後的 11 月 13 日,中國科技媒體矽星人(Silicon Star)對 qwen4-max-preview 進行了一場視覺與 3D 工程挑戰。當被要求生成經典的「鵜鶘騎腳踏車」SVG 動畫時,該模型不僅細緻地呈現了踩踏動作和視差樹影,還主動添加了 0.5 倍至 1.75 倍的速度滑桿以及日/暮/夜主題切換器。在更困難的 Three.js 測試中——建構一個名為 Paper Skies 的可遊玩 3D 紙飛機遊戲,讓飛機穿過臥室窗戶飛向花園——評測者指出,其物理效果和障礙物處理能力與 Anthropic 專注於創意的 Claude Fable 5.1 相當,儘管在著色器精緻度上仍落後於更新的 Claude Fable 5.2。當被要求重新設計矽星人自己的響應式首頁時,該模型啟動了一個本地瀏覽器,發現外部文章縮圖返回了 403 熱連結錯誤,便自動將其替換為樣式化的 SVG 漸層佔位符,並在 5 分鐘內完成了第二輪編輯佈局修訂。
X(前身為 Twitter)上的開發者回饋以及日本開發者論壇為每一項 qwen 4 max 功能 的亮點增添了重要的細節。開發者 @round_boys 展示了該模型使用 Java 和 Three.js 一次性渲染出完整的 3D 場景,但也指出該次運行消耗了約 69,000 個 token。其他測量原始吞吐量的早期採用者報告稱,在預設的 xhigh 設定下,串流速度徘徊在每秒 33 個 token 左右,並指出其強化學習 (RL) 工具使用軌跡有時會對簡單的檔案讀取進行過度思考——這提醒了我們 -preview 後綴是名副其實的。
Qwen 4 Max 定價、Token 方案規則與生產環境阻礙
如果您搜尋 qwen 4 max pricing 並期待看到標準的「每百萬輸入 Token $X」表格,您將會失望。阿里巴巴並未針對 qwen4-max-preview 提供計量式隨用隨付的計費方式。發送請求的唯一途徑是透過有效的 Alibaba Cloud Model Studio Token Plan 訂閱(前身為 Coding Plan),該方案以抽象的每月「點數 (Credits)」而非原始的每 Token 美元金額進行計費。
在國際版 QwenCloud 入口網站上,Token 方案分為個人版與團隊版:
Lite 方案(新用戶首月 3 美元): 包含每月 20,000 點數,受限於嚴格的滾動式限流機制,即每 5 小時視窗 1,200 點數,每週 9,000 點數。
Pro 方案(首月 15 美元): 包含每月 100,000 點數,上限為每 5 小時視窗 6,000 點數,每週 45,000 點數。(在阿里巴巴中國境內入口網站,Lite 與 Pro 方案定價分別為每月 39 元人民幣與 199 元人民幣,首月另有半價優惠,分別為 19.5 元與 99.5 元人民幣。)
14 天預覽折扣(2026 年 11 月 11 日至 11 月 25 日): 在為期兩週的預覽期間,日間呼叫(UTC+8 08:00–22:00)僅消耗標準點數權重的 20%,而離峰夜間呼叫(UTC+8 22:00–08:00)在此基礎上再享 80% 折扣——使實際點數消耗降至正常費率的僅 4%。
對於在夜間使用 IDE 進行開發的個人開發者來說,以 3 美元的價格享受此優惠極具吸引力。然而,對於構建產品或執行自動化 CI/CD 代理的工程團隊而言,該 Token 方案帶來了三個嚴重的生產環境阻礙:
禁止後端自動化與 API 整合: 阿里巴巴的 Token 方案條款明確限制個人 Lite 與 Pro 金鑰 (sk-sp-) 僅能用於支援的 IDE 外掛程式中由人工觸發的互動式編碼。使用訂閱金鑰來驅動自動化後端指令碼、面向客戶的 SaaS 功能或批次資料管線,將違反服務條款並導致帳戶被暫停。
個人方案強制資料訓練: 根據 Token 方案規則,個人 Lite 與 Pro 訂閱預設會將所有提示詞、儲存庫上下文與模型補全內容納入阿里巴巴的模型訓練改進計畫中,且無法選擇退出。只有企業級團隊方案(每席位每月 40 美元)提供零資料保留/不進行訓練的保證。
滾動式 5 小時速率限制與 11 月 25 日終止服務: 即使您的工作流程完全是內部性質,1,200 點數的滾動式 5 小時上限也無法應付多位開發者的突發需求,且 qwen4-max-preview 端點預計將於 2026 年 11 月 25 日 UTC+8 24:00 關閉。
直接對比:Qwen 4 Max 與 Qwen 3.8 Max、Kimi K3.1 Pro、GLM-5.3 及 Claude Opus 5.5
由於您目前無法將 qwen4-max-preview 接入生產環境後端,因此每個對比查詢背後的實際問題是:哪款隨用隨付的旗艦模型能在無需訂閱綁定或數據訓練風險的情況下,處理同樣的 100 萬上下文 Agent 工作負載。
| 模型 |
計費與可用性 |
上下文窗口 |
最大輸出 |
支援的輸入模態 |
GPT Proto 計量費率(每 100 萬輸入/輸出) |
Qwen4-Max-Preview (qwen4-max-preview) |
僅限 14 天預覽(11 月 25 日結束);需 Token 方案訂閱(每月 6–30 美元) |
1,000,000 |
393,216(含 262K CoT) |
文字、圖像、影片 |
未託管(無計量上游 API) |
Qwen3.8 Max 0902 (qwen3.8-max-0902) |
生產環境隨用隨付 |
1,000,000 |
65,536+ |
文字、圖像、影片、音訊、文件 |
4.20(低於官方定價 30%) |
Kimi K3.1 Pro (kimi-k3.1-pro) |
生產環境隨用隨付 |
1,048,576 (1.05M) |
131,072 |
文字、圖像、文件 |
10.00(快取輸入為 0.20 美元) |
GLM-5.3 (glm-5.3) |
生產環境隨用隨付 |
1,050,000 (1.05M) |
128,000 |
文字、圖像、文件 |
3.74(低於官方定價 15%) |
Claude Opus 5.5 (claude-opus-5-5) |
生產環境隨用隨付 |
1,000,000 |
128,000 |
文字、圖像、文件 |
18.00(低於官方定價 10%) |
Qwen 4 Max 與 Qwen 3.8 Max 的對比
在評估 qwen 4 max 與 qwen 3.8 max 時,權衡點在於自主驗證時間與生產穩定性及更廣泛的模態支援。正如 WEEL 的 17 分鐘對比 9.5 分鐘登陸頁面測試所顯示,Qwen 4 Max 願意花費兩倍的實際時間來運行後台 Python 檢查並合成自定義 SVG。然而,qwen4-max-preview 在其預覽路徑中放棄了原生音訊和文件解析功能,且無法按 Token 計費。
如果您的流水線已經依賴阿里巴巴的提示詞格式、多語言 Token 化或多模態視覺,那麼 qwen3.8-max-0902 是目前最適合鎖定的生產級旗艦模型。它提供相同的 100 萬 Token 上下文窗口,同時支援文字、圖像、影片、音訊和文件輸入。在 GPT Proto 上,qwen3.8-max-0902 的運行價格為 每 100 萬輸出 Token 4.20 美元——比阿里巴巴官方計量定價低 30%——您可以在 Qwen 模型中心 中將其與較小的開源權重版本進行對比。
Qwen 4 Max 與 Kimi K3.1 Pro 對決
在 Silicon Star 11 月 13 日的 Blender MCP 和 WebGL 基準測試中,qwen 4 max vs kimi k3.1 pro 進行了正面交鋒,兩款模型的差異非常明顯:Qwen 4 Max 的思考方式像結構機械工程師,而 Kimi K3.1 Pro 的思考方式則像工業設計師。
在 Blender 提示詞(「木星軌道巨型飛船維修船塢」)和 WebGL 深海閘門測試(「萬潮之門」)中,qwen4-max-preview 構建了更密集的內部承重肋架、複雜的對接臂,以及一個可動態重新計算水位和壓力讀數的潮位 UI 滑桿。然而,評測人員在視覺構圖、水體著色器光影和色彩協調性方面,始終給予 kimi-k3.1-pro 更高的評分。如果您正在構建面向用戶的前端介面、互動式 3D 網頁體驗,或是需要 1,048,576 個 token (1.05M) 上下文視窗與 131,072 個最大輸出 token 的長上下文文件代理,Kimi K3.1 Pro 現已在 GPT Proto 上線,價格為 每 1M 輸出 10.00(快取輸入價格低至 每 1M 0.20 美元)。
Qwen 4 Max 與 GLM-5.3 對決
搜尋 qwen 4 max vs glm5.3 的開發者通常是在追求高容量編碼和工具使用效率,同時對價格非常敏感。雖然 Qwen 4 Max 首月 3 美元的 Lite 促銷方案帳面上看起來很便宜,但 5 小時滾動信用額度上限以及對自動化腳本的限制,使其無法用於後台代理集群。
Z.ai 的 glm-5.3 在計量 API 上完美解決了這個問題。它在總上下文容量上略勝 Qwen 4 Max 一籌——提供 1.05M 上下文視窗 並搭配 128K 輸出上限——且支援文字、圖像和文件輸入。在 GPT Proto 上,其價格為 每 1M 輸出 token 3.74(比 Z.ai 官方費率低 15%),GLM-5.3 是用於自動化 PR 審查機器人、高併發工具路由和多文件代碼生成的最高性價比按量付費主力模型。
Qwen 4 Max 與 Claude Opus 5.5 對決
阿里巴巴在 qwen4-max-preview 中內建了原生 Anthropic Messages API 相容性,專門為了爭取那些在 Claude Code 中考慮 qwen 4 max vs claude opus 5.5 的開發者。正如 WEEL 的 Python CLI 測試所證明,Qwen 4 Max 已經能夠執行 12 分鐘的 pytest 修復迴圈,並捕捉到細微的 argparse 和 CSV 注入漏洞。
而 claude-opus-5-5 在軌跡效率、串流響應速度和生產環境 SLA 可靠性方面仍保持決定性領先。社群測試人員指出,Qwen 4 Max 的早期 RL 調優可能會導致其在 xhigh 推理模式下,以約 33 token/s 的速度陷入冗餘的 shell 檢查迴圈。當您在重構任務關鍵型生產儲存庫,且無法容忍浪費工具調用次數或個人層級數據訓練時,Claude Opus 5.5 提供了 1M 上下文視窗和 128K 最大輸出,並具備成熟的指令遵循能力。透過 GPT Proto,您可以以 claude-opus-5-5 每 1M 輸出 18.00 的價格調用——比 Anthropic 官方定價低 10%。
如何透過統一 API 呼叫生產環境替代方案
如果您想在不管理個別廠商 SDK、訂閱額度視窗或 sk-sp- 區域端點的情況下執行上述四款生產環境旗艦模型,GPT Proto 將它們全部整合在單一相容於 OpenAI 的路由(https://gptproto.com/v1/chat/completions)之後。
在複製程式碼片段前,有一項驗證細節值得注意:正如我們在 驗證指南 與 快速入門頁面 中所述,請務必在 Authorization 標頭中傳遞您的金鑰,並加上 Bearer 前綴(Authorization: Bearer $GPTPROTO_API_KEY)。以下是一個基於文件的範例,展示如何呼叫 qwen3.8-max-0902,並透過更改單一字串直接切換至 glm-5.3、kimi-k3.1-pro 或 claude-opus-5-5:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max-0902",
    "messages": [
      {
        "role": "user",
        "content": "Audit this Python CLI parser for negative-number flag collisions and CSV formula injection risks."
      }
    ]
  }'
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://gptproto.com/v1",
    api_key=os.environ["GPTPROTO_API_KEY"],
)

# 在支援 1M 上下文的生產環境旗艦模型間自由切換模型 ID:

# "qwen3.8-max-0902" ($1.40/$4.20) | "glm-5.3" ($1.19/$3.74)

# "kimi-k3.1-pro" ($2.00/$10.00)   | "claude-opus-5-5" ($3.60/$18.00)
response = client.chat.completions.create(
    model="qwen3.8-max-0902",
    messages=[
        {
            "role": "user",
            "content": "Audit this Python CLI parser for negative-number flag collisions and CSV formula injection risks.",
        }
    ],
)

print(response.choices[0].message.content)