平價程式編寫 LLM 概覽
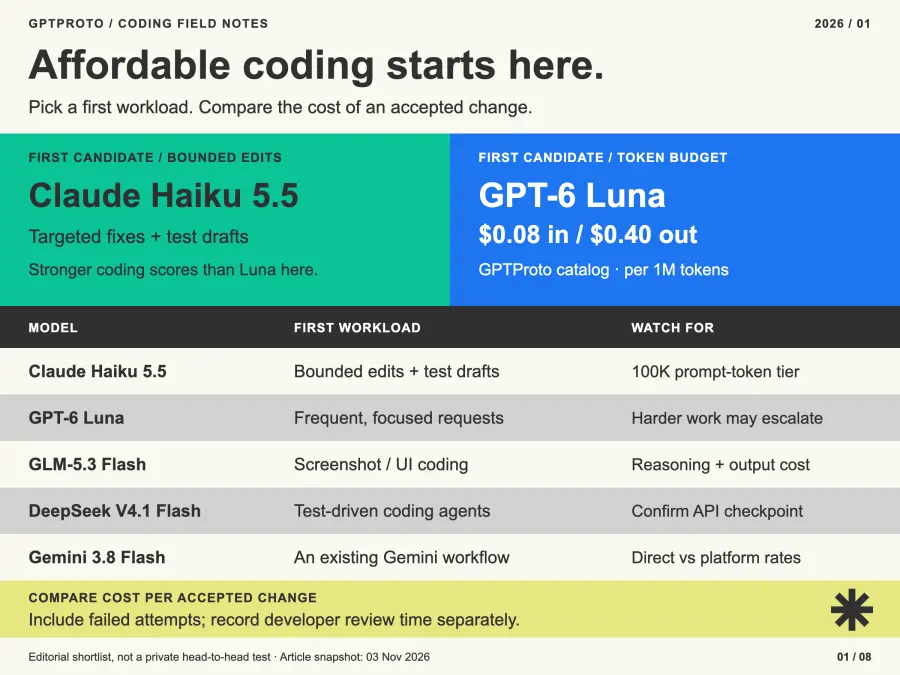
| 模型 |
首選評估工作負載 |
主要權衡因素 |
| Claude Haiku 5.5 |
受限的程式碼編輯、測試草稿及程式編寫子任務 |
其低價層級在超過 10 萬個提示詞 Token 後即結束 |
| GPT-6 Luna |
頻繁且範圍狹窄的程式編寫請求 |
更複雜的儲存庫工作可能需要升級模型 |
| GLM-5.3 Flash |
涉及螢幕截圖或 UI 參考的程式編寫任務 |
推理工作量與輸出長度會影響帳單費用 |
| DeepSeek V4.1 Flash |
帶有測試與重試限制的程式編寫代理程式 |
請確認 API 別名所提供的檢查點版本 |
| Gemini 3.8 Flash |
在現有 Gemini 工作流程中進行程式編寫 |
直接供應商的促銷費率與平台報價有所不同 |
如果您同時也在選擇供應商與模型,我們關於 開發者 AI API 平台比較 的文章涵蓋了存取權限、計費、整合及生產控制等更廣泛的問題。
我們如何比較成本與程式編寫能力
一個平價的 LLM 程式編寫模型必須在 Token 價格具備優勢前,先擁有足夠執行任務的能力。我們優先考慮程式編寫相關的實證,接著檢查工作負載成本、上下文層級、工具相容性以及是否有可用的 GPT Proto 模型頁面。
以下結果來自 Artificial Analysis。Terminal-Bench 4.0 評估代理程式編寫與終端機使用能力;FrontierCode 2.0 評估開源儲存庫中的軟體工程能力。不同的配置可能會改變結果,因此評估設定會標註在每個模型旁邊。
| 評估模型 |
Terminal-Bench 4.0 |
FrontierCode 2.0 |
| Claude Haiku 5.5 Max |
33% |
35% |
| GPT-6 Luna Max |
13% |
25% |
| GLM-5.3 Flash (如列出) |
33% |
18% |
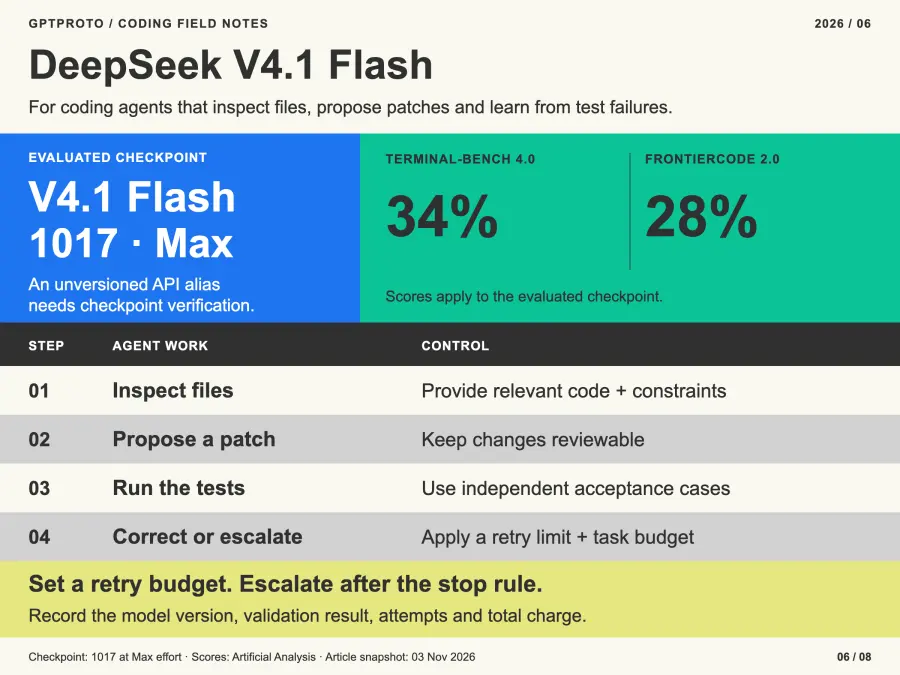
| DeepSeek V4.1 Flash 1017 Max |
34% |
28% |
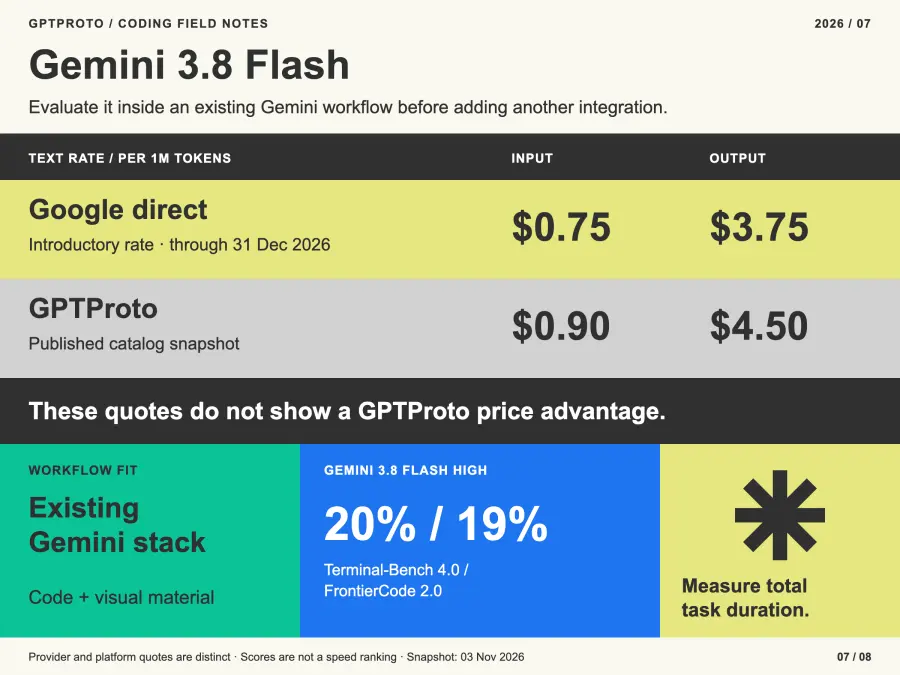
| Gemini 3.8 Flash High |
20% |
19% |
底層比較包括 Haiku 與 Luna、DeepSeek 與 GLM Flash,以及 Haiku 與 Gemini。這些百分比僅描述上述評估結果,而非您儲存庫的預期成功率。它們也不代表 GPT Proto 的延遲或正常運行時間。
下方的價格估算保持 Token 使用量不變,以呈現計費計算方式。實際模型在處理相同提示詞時可能會使用不同的 Token 數量,尤其是在啟用推理功能時。
5 款最佳平價程式編寫 LLM
1. Claude Haiku 5.5 適用於受限的編碼任務
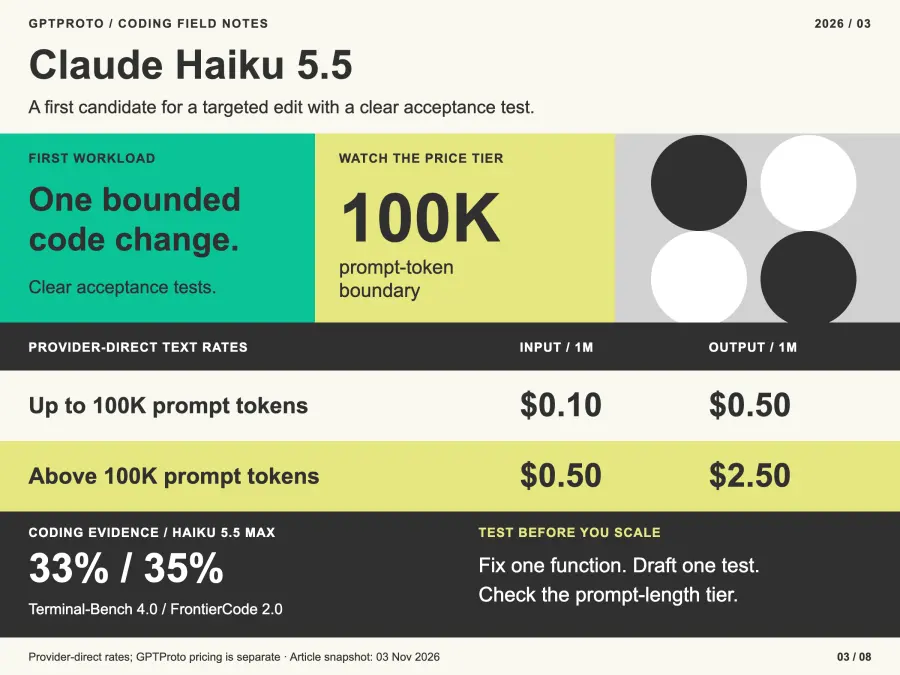
Claude Haiku 5.5 是我們針對目標編輯任務的首選,適用於有明確驗收測試且提示詞(prompt)在 100K token 以下的場景。其編碼表現使其在付費使用更大的 Claude 模型前,非常值得評估。
Anthropic 的發布公告 將 Haiku 定位為與 Sonnet 和 Opus 並列,用於處理重複性工作和編碼子任務的模型。這建議了一個實用的起始範圍:修復單個函數、草擬測試,或調查一個封閉的錯誤。
重要的成本界限在於提示詞長度。當提示詞超過 100K token 時,上游輸入/輸出費率會從每百萬 token $0.10/$0.50 上升至 $0.50/$2.50。大上下文視窗並不意味著整個視窗範圍內都能使用最低價格層級。
2. GPT-6 Luna 適用於頻繁且聚焦的請求
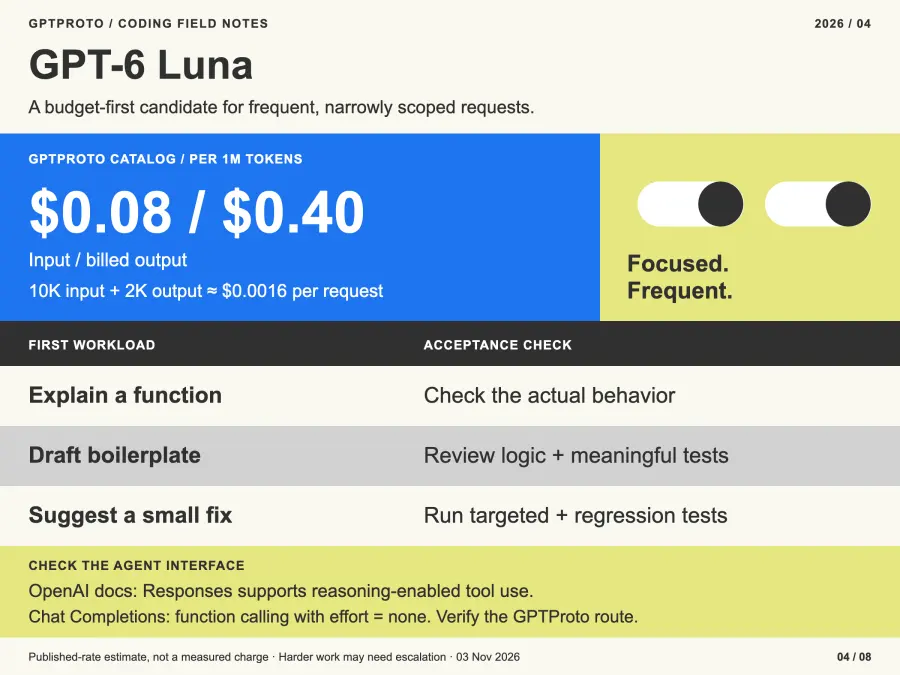
GPT-6 Luna 是處理重複性、有限請求的預算首選:例如解釋函數、草擬樣板代碼,或建議一個可由現有測試判斷的小型修復。
其發布的 GPT Proto 目錄費率為每百萬 token 輸入 $0.08,輸出 $0.40。公開的編碼評分低於 Haiku,因此我們建議透過特定任務評估來讓 Luna 發揮更廣泛的作用。
在構建 Agent 時,請檢查整合介面。OpenAI 模型文檔 指定了透過 Responses 啟用推理的工具使用;Chat Completions 允許在推理工作量(reasoning effort)設置為 none 的情況下進行函數調用。在將模型切換視為僅需配置的變更之前,請確認 GPT Proto 路由實際支援的功能。
3. GLM-5.3 Flash 適用於預算型視覺編碼
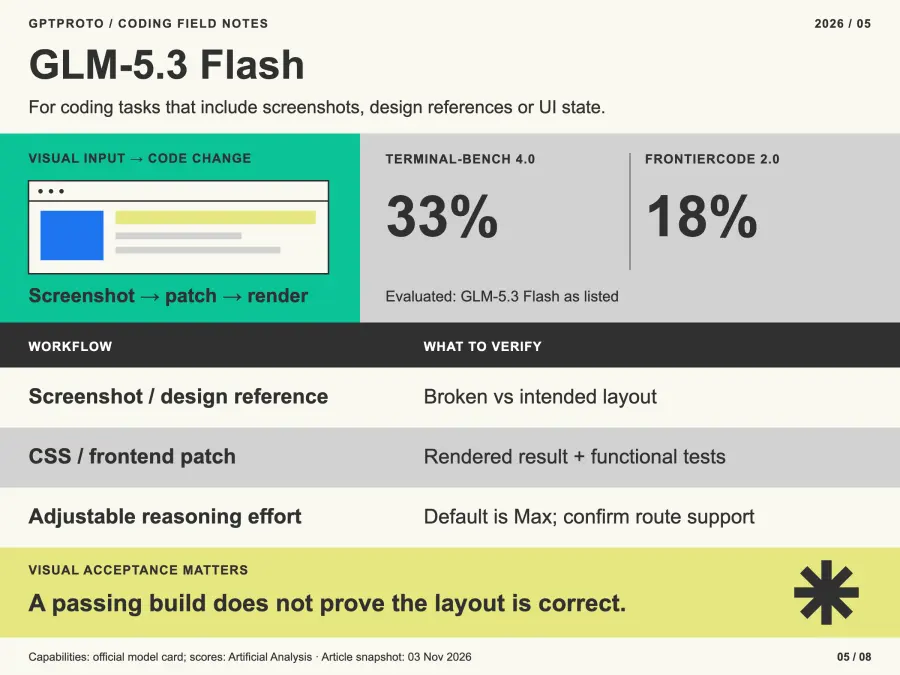
GLM-5.3 Flash 當編碼任務包含截圖、設計參考或渲染介面時,應列入候選名單。例如,前端助手可能需要在提出 CSS 修改建議前,比較損壞的佈局與預期狀態。
官方 GLM-5.3 Flash 模型卡 記錄了多模態輸入、開放權重以及可調整的推理工作量。其預設發布的工作量為最大值。僅在確認託管路由支援的情況下,才使用其他設置。
其兩項編碼評分差異顯著。這提醒我們應測試您的任務組合,而不是將單一終端基準測試視為通用的代碼編輯排名。視覺修復也需要渲染後的比較;僅靠編譯無法確定佈局是否正確。
4. DeepSeek V4.1 Flash 適用於測試驅動的編碼代理
DeepSeek Flash 非常值得評估,特別是對於那些需要在預算範圍內檢查檔案、提出變更、接收測試失敗並進行重試的代理程式。
於 10 月 17 日發布的公告 描述了在編碼效能、任務完成速度和輸出長度方面的改進。我們表格中的獨立測試結果特別指代 V4.1 Flash 1017 的「最大努力 (Max effort)」模式。未標註版本的別名本身並不能證明您的平台正在使用該檢查點;請在可能的情況下記錄已解析的版本。
若要更全面地了解 DeepSeek、GLM、Qwen 和 Kimi,請參閱我們的 中文 LLM 編碼能力比較。當困難的儲存庫變更耗盡了預算路徑時,請保留更強大的候選模型以備使用。
5. Gemini 3.8 Flash 適用於現有的 Gemini 工作流程
Gemini 3.8 Flash 是當您的應用程式已經在使用 Gemini,或需要將程式碼與視覺素材結合時的候選模型。在增加另一個特定供應商的整合之前,請先在現有的工作流程中對其進行評估。
Google 的模型更新 文件中提到了可調整的思考能力,以及在 2026 年 12 月 31 日之前,透過直接供應商提供的每百萬 token 輸入 0.75 美元 / 輸出 3.75 美元的推廣費率。已發布的 GPT Proto 目錄快照價格為 0.90 美元 / 4.50 美元。這些數據並不支援「GPT Proto 比 Google 當前的促銷價格更便宜」的說法。
我們將 Gemini 納入考量是基於工作流程的契合度,而非僅因其名稱中帶有「Flash」就授予其速度獎項。請針對您的提示詞測量獲得可用答案所需的時間以及總任務時長。
程式設計 LLM API 定價比較
本表格使用在規定條件下的供應商直接公開文字費率,而非 GPT Proto 的計費費率。保持來源與工作負載的明確性,可確保比較結果的可重現性。
小型請求包含 10K 輸入與 2K 計費輸出 Token。儲存庫基準包含 200K 輸入與 20K 計費輸出 Token。兩者皆假設無快取命中;計費輸出必須包含適用時的推理 Token。
| 模型與定價條件 |
每 100 萬 Token 的輸入/輸出 |
小型請求 |
儲存庫基準 |
| Haiku 5.5(提示詞 Token 在 100K 以內) |
$0.10 / $0.50 |
$0.0020 |
使用下一級費率 |
| Haiku 5.5(提示詞 Token 超過 100K) |
$0.50 / $2.50 |
不適用 |
$0.1500 |
| GPT-6 Luna(基礎上下文層級內) |
$0.10 / $0.50 |
$0.0020 |
$0.0300 |
| GLM-5.3 Flash(公開標準費率) |
$0.15 / $0.50 |
$0.0025 |
$0.0400 |
| DeepSeek Flash(上游高峰費率) |
$0.30 / $1.20 |
$0.0054 |
$0.0840 |
| Gemini 3.8 Flash(入門直接費率) |
$0.75 / $3.75 |
$0.0150 |
$0.2250 |
費率證據來自連結的模型文件與上述獨立比較。DeepSeek 的發布說明確認非高峰時段的 Token 費率為高峰時段的一半。Luna 對超過 272K 輸入 Token 的完整請求適用較高費率。Gemini 的入門費率將於 2026 年結束。在編列預算前,請務必確認適用的路徑與日期。
若要存取 GPT Proto,請使用連結模型頁面上的即時定價面板。目錄中有兩個明確範例:低價層級的 Luna($0.08/$0.40)與 Haiku($0.09/$0.45)。同樣的小型請求估算分別為 $0.0016 與 $0.0018。這些是基於公開費率的計算,而非實際收費。
對於每月進行 10,000 次小型請求的小型應用程式,上游 Luna 或低階 Haiku 範例的總費用為 $20(不含重試與其他費用)。如果應用程式發送的上下文數量不同或產生更長的輸出,該估算值將不再適用。
快取需要獨立計算:將未快取的輸入、快取讀取、任何快取寫入或儲存以及計費輸出相加。穩定的儲存庫前綴可能有助於節省成本,但變更提示詞或快取未命中會影響節省效果。
開發者Simon Willison 的 Haiku 5.5 測試提供了一個具體範例,說明不同的努力設定如何改變時間與成本。它也討論了 Tokenizer 的變更。預算編列的教訓是:應衡量實際使用量,而非假設每個模型對相同文字計算的 Token 數量都相同。
哪種模型適合您的編碼任務
| 任務 |
初始候選模型 |
驗收檢查 |
| 受限的程式碼編輯或錯誤修復 |
Haiku 5.5 與 Luna |
針對性測試加上現有的回歸測試 |
| 草擬單元測試或樣板程式碼 |
Luna 與 Haiku 5.5 |
審查斷言並驗證有意義的失敗案例 |
| 視覺化前端修復 |
GLM-5.3 Flash 與 Gemini 3.8 Flash |
渲染對比加上功能測試 |
| 多步驟編碼代理 |
DeepSeek Flash 與 Haiku 5.5 |
已完成任務、有效的工具呼叫、重試次數與總成本 |
這些是評估的起點。如果生成的測試只是重複模型錯誤的假設,那麼測試可能會通過,但功能仍然是錯誤的。請保留獨立的驗收案例,並檢查測試本身的變更。
對於同時需要搜尋文件、分類請求或執行支援任務的代理,我們的 AI 代理平價 LLM API 指南 涵蓋了更廣泛的工作負載組合。
何時值得使用高級編碼模型
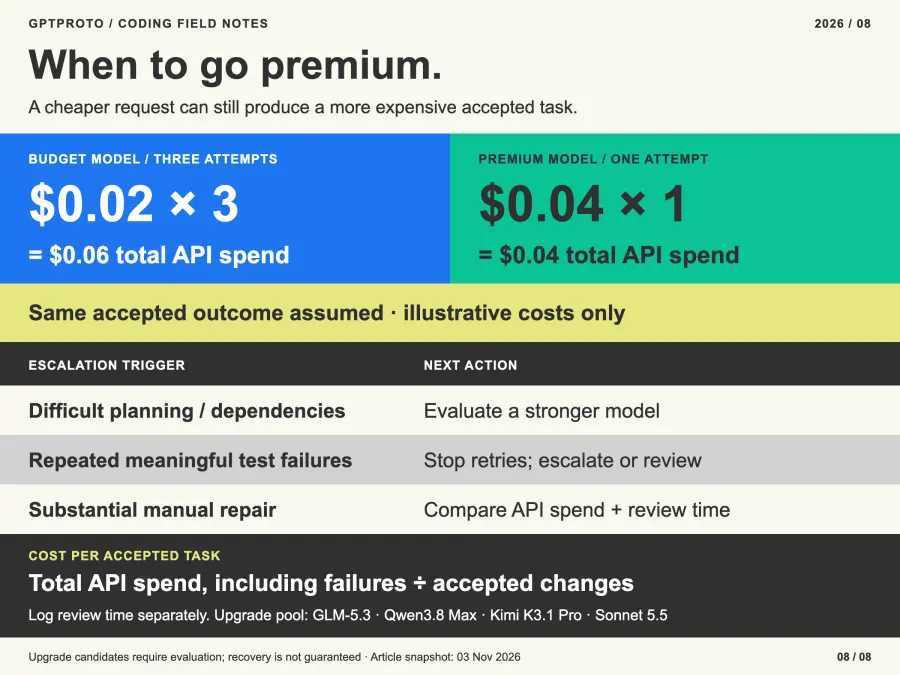
當任務需要困難的規劃、反覆無法通過有意義的測試,或需要大量手動修復時,請進行升級。GLM-5.3、Qwen3.8 Max、Kimi K3.1 Pro 以及 Claude Sonnet 5.5 可以組成一個獨立的評估池來處理這些工作。將它們納入此處是為了提供一個值得研究的升級路徑,而非聲稱它們總能挽救失敗的預算模型任務。
請使用「每次驗收任務的成本」來衡量:即評估期間的 API 總支出除以已驗收的變更數量。請將失敗嘗試的支出也包含在內。將審查時間分開記錄,以免低廉的 API 帳單掩蓋了昂貴的開發人員清理成本。
舉例來說,三次 0.02 美元的嘗試總成本為 0.06 美元。而一次 0.04 美元就能直接完成相同任務的嘗試,總體成本反而更低。您的測量成功率將決定這種權衡是否成立。
如何在不進行無止盡重試的情況下使用預算模型
在發出第一個請求之前,請先設定驗收檢查和停止規則。一個實用的起始策略是:進行一次初始嘗試,根據測試失敗進行一次修正,然後再決定是否升級或進行人工審查。請根據觀察到的結果和任務預算來調整該策略。
應用程式應記錄模型與檢查點、推理設定、Token 使用量、經過時間、驗證結果以及總費用。模型提出修補程式;您的執行器執行測試;您的路由邏輯決定接下來的操作。
多模型 API 簡化了存取與計費流程。但通過測試、預算感知路由和自動升級仍然需要經過驗證的平台功能或應用程式邏輯。我們的 開發人員 AI 閘道指南 比較了不同的存取與控制層。
透過 GPT Proto 嘗試經濟實惠的程式編寫模型
開啟入選模型頁面,選擇 嘗試此模型,並查看目前的快速入門指南與定價。準備好 API 金鑰與餘額。如果面板提供 複製 AI Markdown,請將該指南連同任務與驗收標準一併傳送給您的程式編寫助手。請務必將真實金鑰保留在您的本機環境或伺服器密鑰儲存庫中。
為了進行可重現的首次練習,請修正此分頁函式:頁碼從 1 開始,page 與 per_page 均為整數,小於 1 的值必須引發 ValueError,且輸入列表必須保持不變。
將以下內容儲存為新工作資料夾中的 request_patch.py。它使用 Python 標準函式庫,請求候選函式、檢查其語法,並將其儲存以供審查。它不會執行回傳的程式碼。
import ast
import json
import os
import time
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.request import Request, urlopen

key = os.environ.get("GPTPROTO_API_KEY")
if not key:
    raise SystemExit("請在您的環境中設定 GPTPROTO_API_KEY。")

source = """def paginate(items, page, per_page):
    start = page * per_page
    return items[start:start + per_page]
"""
task = (
    "修正 paginate。頁碼從 1 開始。page 與 per_page 為 "
    "整數;若任一數值小於 1,請引發 ValueError。若超過最後一頁,請回傳 "
    "空列表。請勿變更 items。保留 "
    "函式簽章。僅回傳函式,無需 Markdown "
    "或說明。\n\n" + source
)
payload = {
    "model": os.environ.get("GPTPROTO_MODEL", "gpt-6-luna"),
    "messages": [{"role": "user", "content": task}],
}
request = Request(
    "https://gptproto.com/v1/chat/completions",
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Authorization": f"Bearer {key}",
        "Content-Type": "application/json",
    },
    method="POST",
)
started = time.perf_counter()
try:
    with urlopen(request, timeout=60) as response:
        result = json.load(response)
except HTTPError as exc:
    raise SystemExit(f"API 回傳 HTTP {exc.code}。") from exc
except (URLError, TimeoutError) as exc:
    raise SystemExit("請求失敗或逾時。") from exc

try:
    code = result["choices"][0]["message"]["content"]
except (KeyError, IndexError, TypeError) as exc:
    raise SystemExit("API 回應中沒有候選文字。") from exc
if not isinstance(code, str) or not code.strip():
    raise SystemExit("回應中不包含 Python 程式碼。")
code = code.strip()
try:
    ast.parse(code)
except SyntaxError as exc:
    raise SystemExit("請檢查回應;它不是純 Python 程式碼。") from exc

Path("candidate.py").write_text(code + "\n", encoding="utf-8")
print("已儲存 candidate.py。執行測試前請先審查。")
print("秒數:", round(time.perf_counter() - started, 2))
print("用量:", json.dumps(result.get("usage", {})))
將這些驗收檢查儲存為 test_candidate.py:
import unittest
from candidate import paginate


class PaginationTests(unittest.TestCase):
    def test_pages(self):
        items = [0, 1, 2, 3, 4]
        self.assertEqual(paginate(items, 1, 2), [0, 1])
        self.assertEqual(paginate(items, 2, 2), [2, 3])
        self.assertEqual(paginate(items, 3, 2), [4])
        self.assertEqual(paginate(items, 4, 2), [])
        self.assertEqual(items, [0, 1, 2, 3, 4])

    def test_empty_input(self):
        self.assertEqual(paginate([], 1, 2), [])

    def test_invalid_values(self):
        for page, per_page in [(0, 2), (-1, 2), (1, 0), (1, -1)]:
            with self.subTest(page=page, per_page=per_page):
                with self.assertRaises(ValueError):
                    paginate([0, 1], page, per_page)


if __name__ == "__main__":
    unittest.main()
設定好環境金鑰後,執行 python request_patch.py。檢查 candidate.py,然後執行 python -m unittest -v test_candidate.py。語法檢查僅能確認 Python 可以解析輸出內容;測試則是評估其所述行為。這個小練習並非儲存庫規模的基準測試。
使用另一個已記錄的模型 ID 透過 GPTPROTO_MODEL 重複上述步驟。記錄失敗與成功的案例,並結合回傳的使用量與適用費率來比較費用。逾時或失敗的嘗試仍應納入評估記錄中。
選擇一項具體任務,保持其驗收檢查標準不變,並比較兩個候選模型。前往 Claude Haiku 5.5 API 頁面 或 GPT-6 Luna API 頁面 查看當前定價並開始您的第一次程式編寫請求。