比較 Kimi K3.1 Pro、DeepSeek V4.1 Flash、Qwen3.8-Max-0902、GLM-5.3 以及 GLM-5.3 Flash 在應用程式開發、編碼代理 (Coding Agents)、視覺化除錯及 API 成本方面的表現。
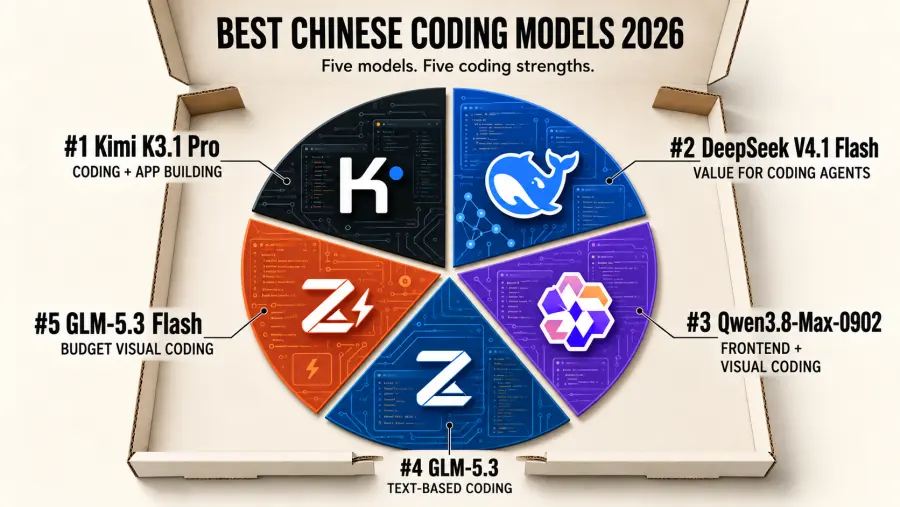
在 10 月 29 日的更新中,Kimi K3.1 Pro 是我們針對高難度編碼與應用程式建構工作的首選推薦。DeepSeek V4.1 Flash 是適合重複性編碼代理呼叫的高性價比候選模型。Qwen3.8-Max-0902 依然是視覺化前端工作的首選,GLM-5.3 適合文字導向的儲存庫任務,而 GLM-5.3 Flash 則適合預算有限的生產環境。
正確的選擇取決於您的需求:是通過儲存庫測試套件、視覺化比對、功能整合,還是成本上限。模型可能在某項決策中領先,卻在另一項中表現平平。
本次更新將 Kimi K3 替換為 K3.1 Pro,加入了 DeepSeek 1017 版本的發布資訊,並更新了價格比較。排序反映了我們以編碼為核心的選擇優先順序,包括能力、任務契合度與成本。這是編輯推薦,而非單一基準測試排名的重現。
更新於 2026 年 10 月 29 日。五款主要模型均有公開的 GPTProto 模型頁面。基準測試快照與供應商路由均分開標識:下方的 DeepSeek 1017 結果並不代表未標註版本的 API 別名目前所使用的檢查點。
重點摘要
最佳整體編碼候選模型: Kimi K3.1 Pro。
最佳高性價比編碼代理候選模型: DeepSeek V4.1 Flash,部署前值得先確認 1017 版本升級。
最適合前端與視覺化除錯的模型: Qwen3.8-Max-0902。
最適合文字導向儲存庫與終端工作流程的模型: GLM-5.3。
此清單中顯示的最低 Token 費率: GLM-5.3 Flash。
當遇到困難的實作瓶頸時,請從 Kimi 開始嘗試。當重複呼叫佔據主要成本時,請比較 DeepSeek 與 GLM Flash。若截圖是驗收測試的一部分,請務必將 Qwen 或其他視覺化模型納入評估。
2026 年最佳中文 LLM 模型概覽
價格比較如下所示。將價格與能力分開考量,能讓您更容易理解為什麼昂貴的模型仍值得針對特定任務進行測試。
速度測量數據來自各模型建立者的 API,並由 Artificial Analysis 進行測量。這些數據僅為快照,並非 GPT Proto 的延遲保證。供應商負載、提示詞長度、推理工作量、快取行為及輸出長度都可能改變生產環境的效能。
「模態」(Modality) 欄位描述了 GPT Proto 所公開的路徑。可下載的檢查點與名稱相似的託管 API 可能不會公開完全相同的功能。
我們如何評選這些中文程式編寫模型
龐大的參數數量或一百萬 token 的上下文視窗,並不能說明模型是否能完成儲存庫(repository)任務。在此排名中的所有五款模型,大約都處於相同的長上下文等級。它們的實際差異體現在其他方面。
我們考量了六個問題:
該模型在獨立評測中的表現如何,而不僅僅是參考開發者提供的基準測試圖表?
它能否持續進行多檔案編碼、終端機操作、工具呼叫以及「規劃—執行—驗證」循環?
當證據不僅僅是文字時,它能否檢查螢幕截圖、圖表、文件或錄製的產品流程?
在計入輸出 token、推理過程以及可能的重試次數後,實際的 API 任務成本是多少?
模型權重是否真的可以下載,以及商業部署受什麼授權條款規範?
是否有現成的 GPT Proto 路徑供讀者透過相同的帳戶和 API 格式進行測試?
目前的 Artificial Analysis 排行榜 顯示 Kimi K3.1 Pro 的智力指數(Intelligence Index)得分為 46,Qwen3.8 Max 0902 為 34,而 DeepSeek V4.1 Flash 1017(最大推理模式)與 GLM-5.3(最大推理模式)均為 32。該指數是一項廣泛的能力衡量指標,它並不能直接衡量修復您應用程式錯誤的成本。
這些分數屬於智力指數 v5.0。請勿將其與較早的指數版本合併,也不要將不同評測版本之間的變化解讀為模型本身的衰退。當目前的排行榜未顯示可比較的數值時,我們也避免為 GLM-5.3 Flash 指定舊的指數分數。
程式編寫結果可能會指向不同的方向。在 Artificial Analysis 的 DeepSeek 與 GLM 比較 中,GLM 在 Terminal-Bench 4.0 中領先,而 DeepSeek 在 FrontierCode 2.0 中領先。這種分歧正是為什麼這份入圍名單包含針對特定任務的建議,並將成本因素納入排序考量的原因。
1. Kimi K3.1 Pro:最佳整體程式開發候選模型
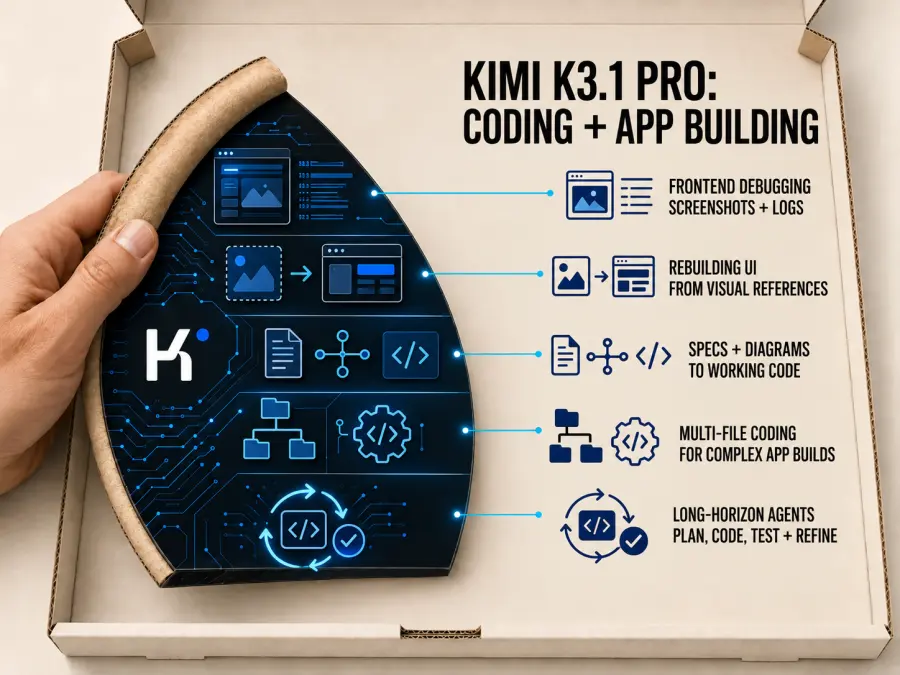
Kimi K3.1 Pro 躍居首位,因為新版本在處理複雜、長篇幅的軟體開發任務上展現了更強的實力。Moonshot 的技術部落格 報告指出,其在 Terminal-Bench 4.0 上的得分為 65.7%,在內部的 Kimi Code Bench 3.0 Long-horizon 測試中為 61.2%,而 K3 在後者的得分為 55.95%。以上均為廠商報告的結果。
此外還有獨立的評測訊號:Artificial Analysis 記錄其在 Terminal-Bench 4.0 上的得分約為 67%。該結果屬於其評估設置,應與 Moonshot 的數據分開看待。
當代理程式(Agent)需要理解陌生的應用程式、修改多個關聯檔案,並在測試失敗後持續運作時,我會優先測試 K3.1 Pro。對於應用程式開發者而言,關鍵問題在於它能否在實作與修正後,交付符合需求的程式功能。
其 GPT Proto 路由 支援文字與視覺輸入。這使其成為結合原始碼、設計參考與渲染介面等任務的候選模型。建議仍從受限任務開始測試:定義預期行為,並為代理程式提供驗證方法。
較高的 Token 費用是其代價。請將其保留給那些能透過提升完成品質來抵銷成本的任務。同時,請務必確認部署狀態:截至本次更新,Moonshot 預計於 11 月 4 日發布完整的 K3.1 Pro 權重。現有的 K3 權重並不代表 K3.1 Pro 已經可以下載。
結論: 針對困難的功能開發或應用程式建構,請先從 Kimi K3.1 Pro 開始,然後再與較便宜的候選模型比較其變更採納率與總支出。
2. DeepSeek V4.1 Flash:程式開發代理程式的最佳性價比選擇
當目標是在可重複的生產預算內維持有效的程式開發能力時,DeepSeek 值得更高的排名。它是讀取程式碼、提出修補程式、檢查測試輸出並進行重試的代理程式的理想候選。
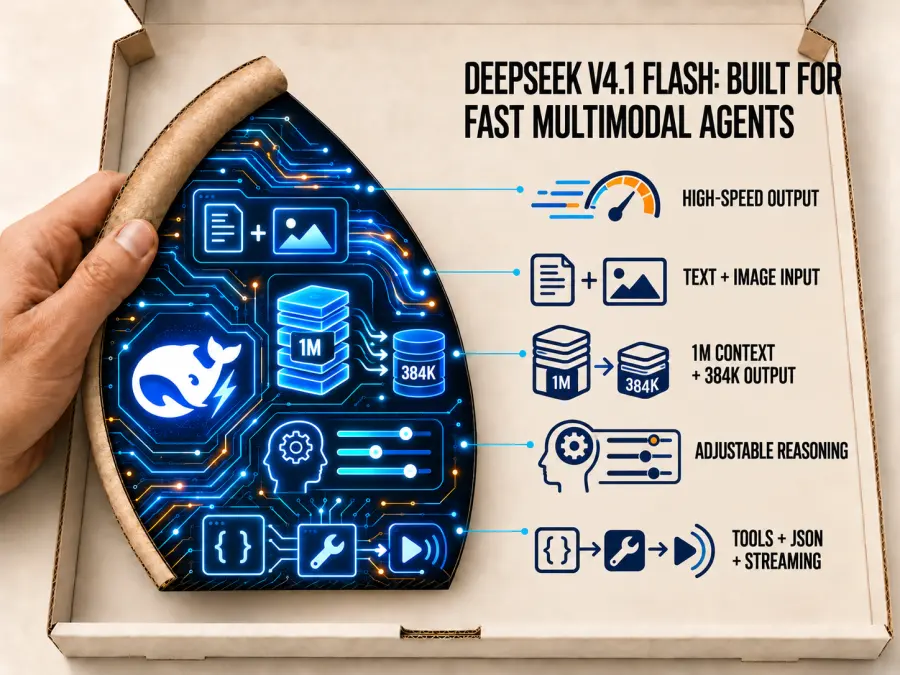
DeepSeek V4.1 Flash 1017 模型卡 報告顯示其相較於早期的 V4.1 Flash 版本有所提升:Terminal-Bench 4.0 從 31.2 升至 42.3,DeepSWE v1.1 從 74.2 升至 77.0,ProgramBench 從 20.3 升至 29.1。這些是 DeepSeek 自行報告的評估結果,而非 GPT Proto 的重現結果。
該更新增強了將 DeepSeek 納入程式開發測試的理由,但這並不代表其他模型就此過時。獨立的程式開發評估顯示,勝出者仍取決於具體任務,且生產環境中的代理程式必須根據其實際使用的工具與限制來進行評估。
請明確區分路由。GPT Proto 透過 deepseek-flash 暴露 DeepSeek Flash;其公開頁面描述的是 V4.1 Flash,並未標明 1017 檢查點。在將較新的結果視為該端點的證據之前,請務必確認已部署的版本。
結論: 將 DeepSeek 測試為優先考慮性價比的實作模型。請記錄模型版本以及成功率、重試次數、延遲與支出,以免日後的別名更新導致比較結果產生歧義。
3. Qwen3.8-Max-0902:前端開發與視覺除錯的最佳選擇
當程式設計任務始於可視化元素(如參考頁面、損壞的版面、圖表或一系列介面狀態)時,Qwen 依然是一個實用的選擇。Qwen3.8-Max-0902 路線支援多模態輸入,允許應用程式將視覺素材與程式碼及指令結合使用。
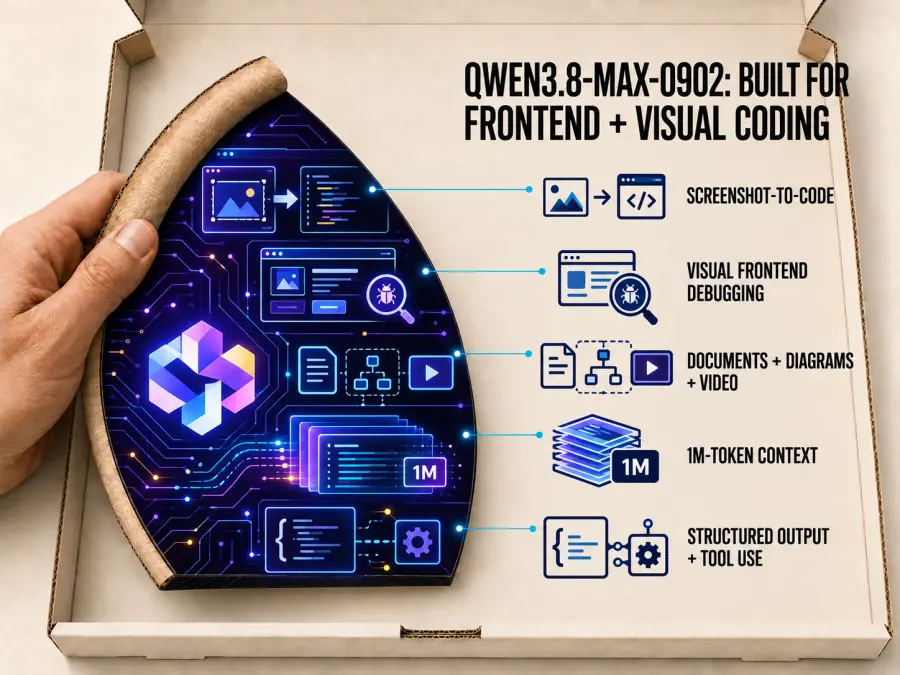
進行前端評估時,請提供與其他候選模型相同的設計參考和儲存庫存取權限。要求 AI 代理實作該頁面、進行渲染、檢查重要狀態並修正結果。除了程式碼正確性外,還需評估間距、層級、響應式設計以及互動功能的運作情況。
這就是為什麼即使在 Kimi 升級後,Qwen 在此仍佔有一席之地。前端篩選需要視覺驗收標準,而通用智慧評分僅能部分描述該項工作。這是我們的流程建議;並非聲稱 Qwen 在新的五模型前端測試中勝出。
成本權衡非常直接:其顯示的 Token 費率高於 DeepSeek 和 GLM Flash。對於小型純文字修補程式,請在試用中納入其中一種較便宜的路線。此外,在記錄功能時,請將確切的 0902 託管快照與任何相關的可下載檢查點分開。
結論: 當符合視覺簡報是實作成功與否的關鍵時,請將 Qwen 列入候選名單。
4. GLM-5.3:基於文字的儲存庫工作的最佳選擇
GLM-5.3 在程式碼調查、終端任務以及證據以文字形式呈現的變更方面仍然具有相關性。更新後的排名將 Kimi 列為整體推薦,同時將 GLM 保留為專注於程式設計的候選模型。
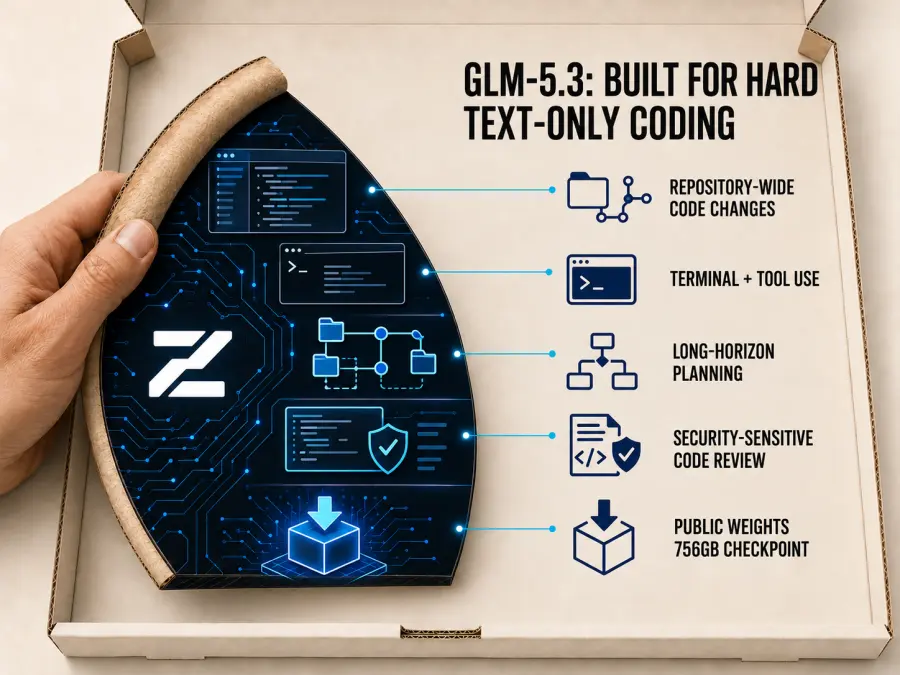
這項獨立的 DeepSeek 與 GLM 比較說明了其定位:GLM 在 Terminal-Bench 4.0 上得分為 42%,而 DeepSeek 1017 為 34%;但在 FrontierCode 2.0 中,DeepSeek 以 28% 對 22% 勝出。這些結果描述了該評估者的設定,因此不應取代供應商配置不同的執行結果。
我會將 GLM 保留在涉及後端整合失敗、不熟悉的依賴項或需要多次「指令與測試」循環的儲存庫變更試驗中。驗收標準應包括通過重現測試以及對變更內容的解釋。
這份GPT Proto GLM-5.3 頁面記錄了文字輸入和文字輸出。如果 AI 代理需要直接檢查螢幕截圖,請在該步驟使用視覺化路線。由於其 Token 費率高於預算型模型,因此反覆重試的成本也值得衡量。
結論: 對於能穩定通過測試的儲存庫和終端工作流程,請保留 GLM-5.3。針對困難任務可與 Kimi 比較,針對成本考量則可與 DeepSeek 比較。
5. GLM-5.3 Flash:最佳預算視覺編碼候選模型
GLM-5.3 Flash 之所以能保持其地位,是因為頻繁的 Agent 調用使得 Token 費率比標題能力的微小差異更為重要。在下方價格快照中,它是這五款 GPT Proto 條目中輸入和輸出費率最低的。
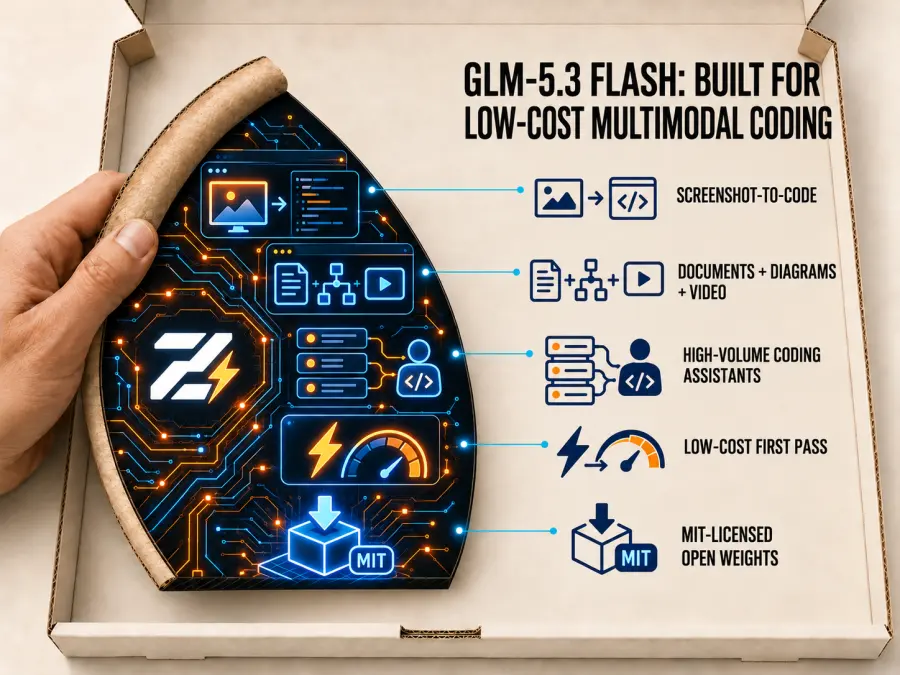
該 模型頁面 記錄了文字、圖像、影片和檔案輸入,以及 MIT 授權的權重。它還解釋了 Flash 使用了與標準 GLM-5.3 不同的多模態基礎。在建立路由策略時,請將兩者視為獨立的候選模型。
實際評估時,可以將有邊界的問題、視覺佈局檢查或初步實作指派給 Flash。請保留與較大型模型相同的驗收測試。如果結果失敗,請將失敗的嘗試和升級處理計入總成本中。
低費率為迭代留下了空間,但重複且無效的嘗試可能會抵消這一優勢。在將其選為預設模型之前,請先衡量任務的成功頻率。該記錄模型始終啟用推理功能,因此請將推理 Token 的使用量和回應時間納入檢查範圍。
結論: 將 GLM-5.3 Flash 作為視覺編碼和重複性子任務的預算預設模型進行測試,並為失敗情況制定明確的升級處理路徑。
榮譽提名
MiniMax M3.1 Flash
MiniMax 目前的候選模型值得關注,而不僅僅是舊版的 M3。10 月 19 日的發布公告 指出其在 DeepSWE v1.1 上達到 73.7%,並強調了更低成本的 Agent 執行。這使得 M3.1 Flash 與 DeepSeek 和 GLM Flash 處於相同的預算討論範疇。
在確認確切的 GPT Proto 路由、模型 ID、定價和支援的功能之前,請將其保留在研究觀察名單中。在未經驗證的情況下,不應將現有的 MiniMax M3 端點標記為 M3.1 Flash。
小米 MiMo-V2.6 與其他新興模型
MiMo-V2.6 值得持續關注;Artificial Analysis 已將 MiMo-V2.6-Pro 納入其評估中。在檢查其任務證據和建議的實際存取路徑後,再將新模型放入主要名單中。
當應用程式依賴已驗證的行為時,舊版的 Kimi K3 和 DeepSeek V4 Pro 部署可能仍值得保留。在轉移現有流量之前,請先在這些相同任務上測試替代模型。
值得關注的模型
Step 5 Preview 和小米的 MiMo-V2.6 系列是相關的新型中文模型,但由於 GPT Proto 在本次更新時尚未確認其即時路由,因此未將其納入主要排名。只有在確切的模型頁面、API 字串、價格和支援的請求欄位皆已上線並經過測試後,才將它們加入排名清單。
一項真實的程式設計任務,五種不同的選擇
試想在現有的 TypeScript SaaS 應用程式中加入訂閱計費功能。代理程式必須理解當前的用戶模型、實作結帳流程、安全地處理 Webhook 事件、更新帳戶權限並驗證結果。
| 需求 |
評估候選模型 |
檢查重點 |
| 在多個檔案中實作連線功能 |
Kimi K3.1 Pro |
正確的行為、連貫的變更以及測試失敗後的恢復能力 |
| 執行重複的實作與修正嘗試 |
DeepSeek V4.1 Flash |
每美元可接受的修復次數;記錄所提供的修訂版本 |
| 將計費介面與設計參考進行比對 |
Qwen3.8-Max-0902 |
視覺準確度、響應式行為與運作狀態 |
| 診斷後端與終端錯誤 |
GLM-5.3 |
重現品質、指令使用與測試結果 |
| 以低成本處理受限的實作或視覺檢查 |
GLM-5.3 Flash |
失敗率、重試次數以及包含升級在內的成本 |
對於此範例,一個美觀的結帳按鈕只是結果的一部分。Webhook 必須經過驗證,重複的事件不得授予重複的權益,且訂閱變更必須更新正確的帳戶。在比較模型之前,請先撰寫這些驗收測試。
同樣的程式設計任務需要多少成本?
為了進行簡單的 Token 成本比較,假設每次嘗試包含 100,000 個未快取的輸入 Token 和 20,000 個可計費的輸出 Token。以下使用 GPT Proto 於 2026 年 10 月 29 日顯示的定價面板。費率以每百萬 Token 的美元計算;未假設任何快取或離峰時段優惠。
計算方式為 0.1 × 輸入費率 + 0.02 × 輸出費率。DeepSeek 行的價格為顯示的 GPT Proto 路由價格;它並不代表該別名所提供的檢查點。
這些僅為說明性的 Token 費用。實際輸出必須包含適用的可計費推理成本,且完整的任務可能涉及更多輪次、工具結果、重試或使用其他模型。規劃支出時,請務必查看即時定價面板。
衡量總 API 支出除以通過驗收測試的變更次數。這比假設每個模型都能以相同數量的 Token 完成任務更具參考價值。
為什麼基準測試的贏家未必是最佳程式設計代理
您的程式設計代理控制著模型能看到哪些檔案、如何呼叫工具、何時執行測試,以及失敗後會發生什麼。即使模型本身不變,改變這些設定也會影響最終結果。
在比較候選模型之前,請確保儲存庫、任務說明、工具、驗收測試和時間限制保持一致。允許每個模型使用其所需的請求格式,並記錄其推理設定。接著測量已完成的任務、回歸問題、重試次數、耗時以及 API 支出。
對於此候選清單,請使用 Kimi 測試能力上限,使用 DeepSeek 和 GLM Flash 測試生產經濟效益,使用 Qwen 進行視覺驗收,並使用 GLM 進行基於文字的儲存庫執行。讓結果來決定哪些階段共用同一個模型,哪些階段需要不同的路徑。
您應該使用哪種中文程式設計模型?
當優先事項是完成困難的功能或應用程式,且您可以證明較高的每 Token 預算合理時,請優先選擇 Kimi K3.1 Pro。
當重複的代理呼叫使得成本變得重要時,請選擇 DeepSeek V4.1 Flash。在根據 1017 特定證據進行部署之前,請先確認已部署的版本。
當實作必須符合螢幕截圖、版面配置或其他視覺參考時,請選擇 Qwen3.8-Max-0902。
當您的評估重點在於原始程式碼、終端輸出和後端行為時,請選擇 GLM-5.3。
當您需要一個低費率的視覺程式設計候選模型,且能在升級失敗之前檢測到錯誤時,請選擇 GLM-5.3 Flash。
進行初步比較時,請使用一個已經具備可靠驗收測試的受限任務。相比於無人檢查的大型生成應用程式,一個經過驗證的小型變更更能為您提供有用的部署證據。
如何透過單一 API 呼叫這些中文 LLM 模型
開啟您想嘗試的候選模型頁面,然後使用 試用此模型 → 快速入門。建立或選擇一個 GPT Proto API 金鑰,並使用 複製 AI Markdown,將目前的整合說明提供給您的程式設計助手。
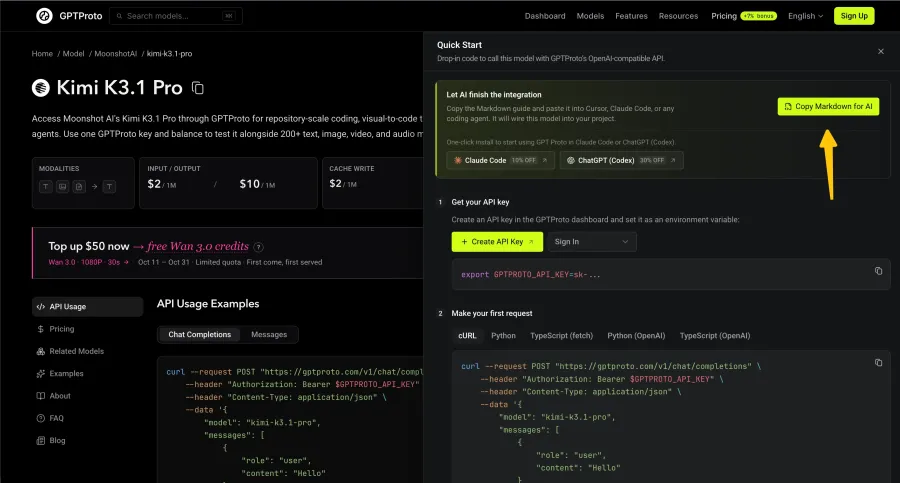
請要求它檢查您的專案、遵循複製的端點與請求欄位、將金鑰保留在伺服器端配置中,並新增一個小型連線檢查。請在本地配置真實金鑰,而非將其貼上至公開的提示詞或儲存庫中。
下方的模型 ID 標識了本次更新所審查的公開 GPT Proto 路由:
| 模型 |
GPT Proto 模型 ID |
| Kimi K3.1 Pro |
kimi-k3.1-pro |
| DeepSeek Flash |
deepseek-flash |
| Qwen3.8-Max-0902 |
qwen3.8-max-0902 |
| GLM-5.3 |
glm-5.3 |
| GLM-5.3 Flash |
glm-5.3-flash |
請針對每個路由使用即時模型頁面指南。模型在推理欄位、工具呼叫處理與多模態請求格式上可能有所不同,因此更改模型字串僅是遷移的一部分。在正式投入生產環境前,應先進行單次請求測試,隨後進行多輪工具使用測試。
將模型 API 連接到您的應用程式,與更改驅動程式設計助手的模型是兩項獨立的任務。請檢查用戶端支援的連線格式以進行後者。
比較所有 GPT Proto 模型後再分配生產流量。您可以使用單一 API 金鑰與共享餘額來評估不同的支援模型,無需為每個供應商維護單獨的整合與預付帳戶。
開啟 Kimi K3.1 Pro 以開始處理困難的程式設計任務,或在優先考慮重複呼叫成本時比較 DeepSeek Flash 與 GLM-5.3 Flash。請使用模型頁面的整合指南,並在擴大工作負載前驗證一個小的變更。