Réponse courte : Que sont Claude Fable 5.1 et Mythos 5.1 ?
Claude Fable 5.1 et Claude Mythos 5.1 sont deux versions d’accès du même modèle Anthropic sous-jacent. Fable 5.1 est disponible pour les utilisateurs Claude classiques et les clients de l’API avec des garde-fous en cybersécurité et biologie. Mythos 5.1 est limité aux organisations approuvées dans les programmes d’accès de confiance d’Anthropic.
| Détail |
Claude Fable 5.1 |
Claude Mythos 5.1 |
| Date de sortie |
1er septembre 2026 |
1er septembre 2026 |
| Modèle sous-jacent |
Identique |
Identique |
| Accès général à l’API |
Oui |
Non |
| Voie d’accès |
Produits Claude, API et clouds partenaires |
Project Glasswing et programmes approuvés |
| Accès en cybersécurité et biologie |
Garde-fous supplémentaires et routage de repli |
Accès élargi pour la recherche vérifiée |
| ID de modèle de l’API Claude |
claude-fable-5-1 |
claude-mythos-5-1 |
| Fenêtre de contexte |
1 million de tokens |
1 million de tokens |
| Sortie maximale |
128 000 tokens |
128 000 tokens |
L’annonce de lancement d’Anthropic décrit la paire comme le même modèle avec différents niveaux de garde-fous. Sa documentation pour développeurs liste Fable 5.1 pour tous les clients de l’API Claude et Mythos 5.1 pour les participants à Project Glasswing uniquement.
Quelle est la relation entre Claude Fable 5.1 et Mythos 5.1 ?
Fable et Mythos ne sont pas des niveaux de capacité distincts comme l’étaient Sonnet, Opus et les familles Claude antérieures. Anthropic affirme qu’ils utilisent le même modèle sous-jacent. La séparation se fait au niveau des garde-fous et de l’accès.
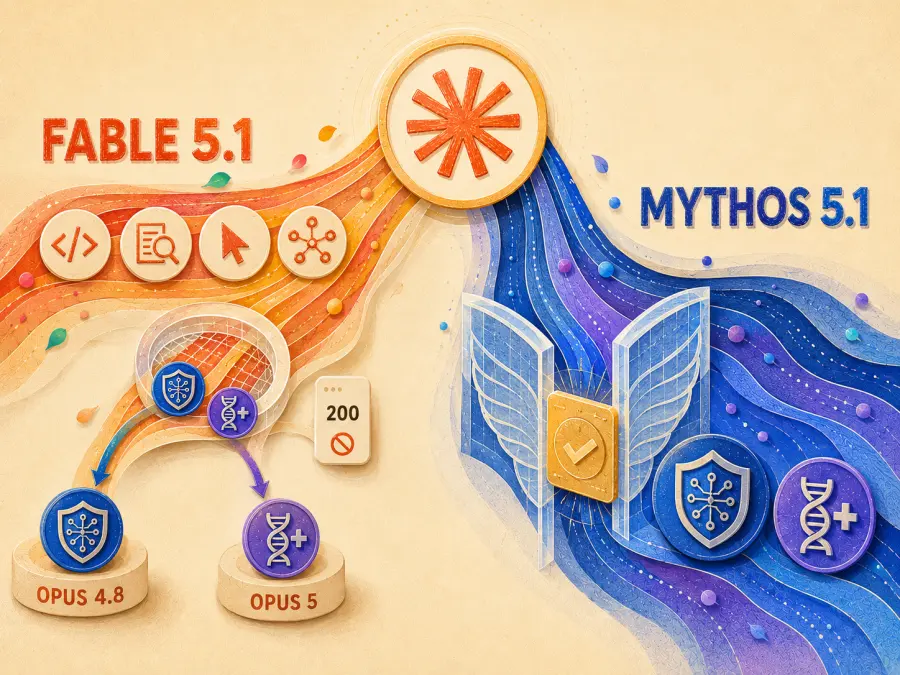
Fable 5.1 est le produit public. Il est destiné au codage de longue durée, à la recherche, à l’utilisation de l’ordinateur et au travail de connaissance, mais des classificateurs surveillent les requêtes en cybersécurité et biologie. Une requête de cybersécurité signalée peut basculer vers Claude Opus 4.8, tandis qu’une requête de biologie signalée peut basculer vers Claude Opus 5. Les développeurs d’API doivent configurer ce comportement ; un refus peut aussi arriver sous forme de réponse HTTP 200 avec stop_reason: "refusal" plutôt que comme une erreur de requête classique.
Mythos 5.1 est destiné aux organisations qu’Anthropic a examinées et approuvées pour des travaux dans des domaines tels que la sécurité défensive et les sciences de la vie. Il offre un accès plus large aux capacités cyber et biologie du même modèle. Cela ne fait pas de Mythos un paramètre caché dans le point de terminaison public Fable. L’accès est contrôlé par Anthropic, et les clients approuvés doivent passer par des programmes tels que Project Glasswing.
Les garde-fous sont aussi plus précis que ceux lancés avec Fable 5. Anthropic rapporte que ses nouveaux contrôles de cybersécurité produisent 60 % de faux positifs en moins. Il indique que les garde-fous de biologie interviennent sur des requêtes bénignes 85 % moins souvent. Fable 5.1 peut désormais identifier des vulnérabilités dans le code source, mais les tests d’intrusion, la génération d’exploits et l’analyse de vulnérabilités basée sur des binaires peuvent encore être restreints. Ces pourcentages proviennent de l’évaluation d’Anthropic, et non d’un audit indépendant. Les pages produit Fable et Mythos expliquent les limites actuelles.
Les deux versions appliquent par défaut une conservation des données de 30 jours pour la surveillance de sécurité. Anthropic indique que ses prochains Enterprise Frontier Safeguards permettront aux clients entreprise éligibles de conserver les données dans une infrastructure cloud contrôlée par le client ; d’ici ce déploiement, les clients expressément autorisés peuvent recevoir un accès sans conservation des données. Il s’agit d’une condition d’accès, pas d’une valeur par défaut générale pour chaque compte API Fable 5.1.
En clair : Mythos 5.1 n’est pas « Fable 5.1 avec effort maximal ». C’est Fable 5.1 dans un dispositif d’accès et de sécurité différent.
Fonctionnalités de Claude Fable 5.1 : qu’est-ce qui a changé depuis Fable 5 ?
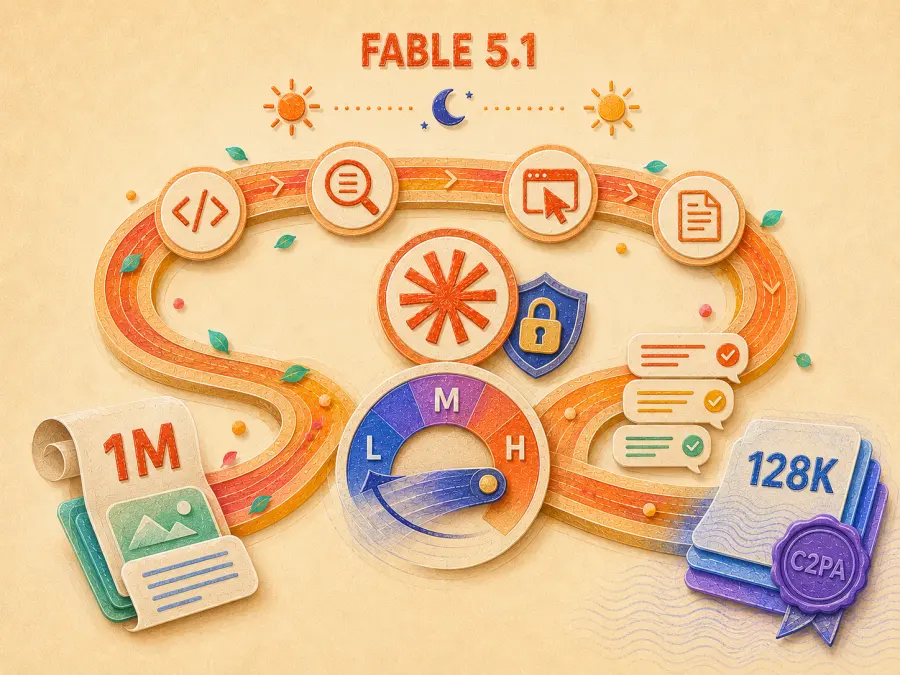
Fable 5.1 conserve la forme générale de Claude Fable 5 : une fenêtre de contexte d’un million de tokens, jusqu’à 128 000 tokens de sortie, une entrée image et texte, et un raisonnement adaptatif toujours activé. La mise à niveau 5.1 se concentre sur le travail de longue durée, l’effort contrôlable, la communication des agents et moins d’interventions inutiles des garde-fous.
Agents de longue durée plus capables
Anthropic positionne Fable 5.1 pour des missions qui peuvent occuper un agent pendant des heures ou des jours : implémentation à l’échelle d’un dépôt de code, analyse des causes racines, recherche multi-étapes, production de documents, utilisation du navigateur et travail qui traverse plusieurs applications. L’effort High est la valeur par défaut dans Claude Code, tandis que Medium est la valeur par défaut dans Claude.ai et Claude Cowork.
L’amélioration revendiquée n’est pas seulement plus de raisonnement au réglage le plus élevé. Anthropic affirme que Fable 5.1 en effort Low ou Medium peut égaler ou dépasser Fable 5 sur certaines tâches mesurées à moindre coût. Cela fait du choix de l’effort une partie de la conception du déploiement plutôt qu’un contrôle décoratif. La récupération routinière et le formatage peuvent ne pas nécessiter Max ; un diagnostic architectural difficile peut en avoir besoin.
L’effort peut changer au sein d’une conversation
Avec une fonctionnalité bêta, une application peut augmenter ou réduire l’effort en cours de conversation sans invalider le cache de prompt. Un agent pourrait utiliser l’effort High pour planifier une migration, puis passer à Low pour résumer les étapes terminées. Claude Opus 5 prend aussi en charge ce comportement.
Fable 5.1 prend en outre en charge les messages système limités au tour. Une instruction temporaire peut s’appliquer au tour actuel et s’effacer au message utilisateur suivant tout en restant dans l’historique de messages en ajout seul. C’est utile pour les boucles d’outils qui ont besoin de rappels de courte durée sans réécrire le contexte antérieur.
Mises à jour de progression et provenance du contenu
Les développeurs peuvent demander des mises à jour d’état lisibles entre les appels d’outils avec l’option bêta thinking.display: "updates". La chaîne de pensée brute n’est toujours pas renvoyée. La fonctionnalité expose de courts messages de progression tout en gardant le raisonnement privé caché.
Anthropic indique aussi que le texte généré par Fable 5.1 et Mythos 5.1 porte son filigrane textuel statistique. Les fichiers image et vidéo pris en charge produits via des outils peuvent recevoir des C2PA Content Credentials signés lorsqu’ils sont récupérés via l’API Files. Ces fonctionnalités n’ajoutent pas de caractères visibles ni de tokens facturables à la réponse texte.
Tous les changements de comportement ne sont pas des améliorations
Les notes de migration sont inhabituellement franches sur les régressions et les compromis :
L’appel d’outils en parallèle peut être plus variable. Fable 5.1 peut effectuer un appel par tour là où Fable 5 regroupait auparavant plusieurs appels indépendants. Des tours supplémentaires ajoutent des allers-retours, des tokens et du temps réel.
En effort Low, le modèle est plus susceptible de répondre de mémoire plutôt que d’appeler un outil de recherche ou de récupération. Les tâches qui nécessitent des informations actuelles ont besoin d’un niveau d’effort plus élevé ou d’une instruction de vérification explicite.
La narration de progression est moins fréquente pendant les longues exécutions, sauf si l’application la demande.
La prose peut être plus dense, avec des phrases plus longues et moins de sauts de paragraphe.
Pour une petite modification de fichier, le modèle peut réécrire tout le fichier au lieu de renvoyer un correctif ciblé, ce qui augmente le coût de sortie.
Les résumés de documents peuvent reproduire la formulation source sans toujours l’indiquer comme une citation.
Ce ne sont pas des raisons de rejeter la mise à niveau. Ce sont des raisons de relancer les évaluations propres à un agent au lieu de supposer qu’un numéro de modèle plus élevé préserve chaque comportement.
Claude Fable 5.1 vs Claude Fable 5
| Domaine |
Claude Fable 5 |
Claude Fable 5.1 |
| Entrée standard |
10 $ / 1M tokens |
10 $ / 1M tokens |
| Sortie standard |
50 $ / 1M tokens |
50 $ / 1M tokens |
| Lecture du cache |
1 $ / 1M tokens |
0,25 $ / 1M tokens |
| Fenêtre de contexte |
1M tokens |
1M tokens |
| Sortie maximale |
128K tokens |
128K tokens |
| Réflexion adaptative |
Toujours activée |
Toujours activée |
| Effort en cours de conversation |
Aucune fonctionnalité équivalente au lancement |
Pris en charge en bêta |
| Faux positifs des garde-fous |
Plus élevé |
Réduit lors des tests d’Anthropic |
| Choix d’outil nommé forcé |
Les intégrations existantes peuvent l’utiliser |
any et tool nommé renvoient une erreur |
| Provenance du contenu |
Comportement antérieur |
Filigrane textuel statistique et prise en charge C2PA |
Un détail de facturation supplémentaire mérite attention. Fable 5.1 utilise le même tokeniseur que Fable 5, introduit avec Claude Opus 4.7. Anthropic indique que le même texte peut produire environ 30 % de tokens en plus qu’avec des modèles antérieurs à Opus 4.7. Les équipes migrant depuis Fable 5 ne verront pas ce saut de tokeniseur, mais les équipes qui comparent 5.1 à des générations Claude plus anciennes ne devraient pas estimer le coût à partir du seul nombre de caractères.
Tarification de Claude Fable 5.1 : cache moins cher, mais pas toujours une tâche moins chère
Fable 5.1 conserve les tarifs API affichés de Fable 5. Le changement se concentre sur la mise en cache des prompts.
| Élément de facturation |
Prix officiel de Claude Fable 5.1 |
| Entrée standard |
10 $ / 1M tokens |
| Écriture de cache de 5 minutes |
12,50 $ / 1M tokens |
| Écriture de cache d’1 heure |
20 $ / 1M tokens |
| Lecture du cache |
0,25 $ / 1M tokens |
| Sortie standard |
50 $ / 1M tokens |
| Entrée par lots |
5 $ / 1M tokens |
| Sortie par lots |
25 $ / 1M tokens |
Le tarif de lecture du cache est passé de 1 $ à 0,25 $ par million de tokens, soit une réduction de 75 %. C’est important pour les agents qui relisent de façon répétée un grand prompt système, une carte de dépôt, des définitions d’outils ou un contexte de travail accumulé. Anthropic estime que les charges de travail typiques facturées au token coûteront environ 25 % de moins que Fable 5, tandis que les charges de travail fortement agentiques pourraient économiser jusqu’à environ 45 %. Les tarifs complets et les multiplicateurs de cache figurent dans la documentation de tarification Claude.
Mais « un cache 75 % moins cher » n’est pas la même affirmation qu’« un modèle 75 % moins cher ». L’entrée fraîche reste à 10 $ et la sortie à 50 $. Si un nouveau réglage d’effort produit une trace de raisonnement ou une réponse plus longue, la facture de sortie peut effacer l’économie de cache.
C’est ce qui s’est produit dans l’évaluation avant sortie d’Artificial Analysis. Son analyse de lancement a constaté que Fable 5.1 en effort Max utilisait environ 1,7 fois plus de tokens de sortie que Fable 5 Max. Son coût mesuré était d’environ 3,7 $ par tâche de l’Intelligence Index, soit environ 20 % de plus que Fable 5 Max, même après la remise de cache. En effort Extra-élevé, le modèle a obtenu un point de moins que Max sur l’indice, mais a coûté sensiblement moins par tâche.
Voici la conclusion de coût la plus utile :
Fable 5.1 est moins cher pour relire un contexte mis en cache. S’il est moins cher pour accomplir votre tâche dépend des hits de cache, de l’effort, de la longueur de sortie, des tours d’outils et du comportement de repli.
Avant de basculer le trafic de production, comparez le coût par résultat accepté, pas le prix par million de tokens mis en cache.
Quelle est la force de Claude Fable 5.1 ? Benchmarks et leurs limites
Anthropic rapporte d’importantes améliorations par rapport à Fable 5 en recherche scientifique, travail en terminal, automatisation métier et codage agentique. Le tableau de lancement ci-dessous utilise la configuration de test d’Anthropic, il doit donc être lu comme une preuve de fournisseur plutôt qu’un verdict neutre.
| Benchmark |
Fable 5.1 |
Fable 5 |
Opus 5 |
GPT-5.6 Sol |
| Terminal-Bench-Science 0.1 |
52,6 % |
24,7 % |
29,0 % |
22,4 % |
| Terminal-Bench 4.0 |
55,8 % |
42,0 % |
52,3 % |
37,3 % |
| GDPval-AA v2 |
1 853 |
1 723 |
1 824 |
1 711 |
| OSWorld 2.0, strict |
41,7 % |
36,1 % |
39,6 % |
— |
| Humanity’s Last Exam, sans outils |
60,9 % |
57,8 % |
56,6 % |
— |
| AutomationBench |
31,4 % |
17,1 % |
26,9 % |
19,6 % |
| CursorBench 3.2.0 |
73,4 % |
70,5 % |
70,0 % |
67,2 % |
Source : le rapport de lancement de Fable 5.1 et Mythos 5.1 d’Anthropic.
Sur Terminal-Bench 4.0, Mythos 5.1 a obtenu 60,9 % contre 55,8 % pour Fable 5.1. Anthropic attribue cet écart aux tâches où les garde-fous cyber de Fable sont intervenus, et non à un modèle de base différent. L’entreprise note aussi que certaines requêtes de benchmark ont été routées vers des modèles Opus lorsque les garde-fous se sont déclenchés.
Des tests indépendants placent Fable 5.1 en tête, avec une réserve
Artificial Analysis a évalué Fable 5.1 avant sa sortie et a attribué une note de 66 en effort Max sur son Intelligence Index. Au moment du lancement, cela le plaçait devant Opus 5 Max à 63, Fable 5 Max à 62, GPT-5.6 Sol Max à 61, et les configurations Max de Kimi K3 et GLM-5.3 à 60.
| Modèle et réglage |
Intelligence Index d’Artificial Analysis |
| Claude Fable 5.1 Max |
66 |
| Claude Opus 5 Max |
63 |
| Claude Fable 5 Max |
62 |
| GPT-5.6 Sol Max |
61 |
| Kimi K3 Max |
60 |
| GLM-5.3 Max |
60 |
La réserve est importante : Artificial Analysis a activé le repli côté serveur par défaut d’Anthropic. Opus 4.8 ou Opus 5 ont généré environ 4 % des tokens de sortie sur l’ensemble de l’indice lorsque les classificateurs de sécurité sont intervenus. Le score de 66 représente donc une configuration de production réaliste de Fable 5.1, et non une exécution en laboratoire où chaque token provenait uniquement de Fable.
Les résultats indépendants révèlent aussi un compromis moins flatteur. Sur AA-Omniscience, Fable 5.1 a tenté plus de questions et obtenu une précision brute supérieure à Fable 5. Mais lorsqu’il ne connaissait pas la bonne réponse, il était aussi plus susceptible d’en tenter une. Les deux effets se sont annulés sur l’indice de fiabilité du benchmark. Être plus enclin à répondre ne signifie pas automatiquement être moins susceptible d’halluciner.
Une lecture honnête des benchmarks est conditionnelle. Fable 5.1 obtient le meilleur résultat composite précoce, en particulier pour le travail agentique et de connaissance, mais il est coûteux et verbeux en Max. Une équipe qui choisit un modèle de production devrait comparer les niveaux d’effort à ses propres critères d’acceptation plutôt que de déployer Max partout.
Claude Fable 5.1 vs Opus 5, GPT-5.6 Sol, Kimi K3 et GLM-5.3
Les modèles ci-dessous se recoupent en codage, recherche et travail agentique, mais occupent des positions de prix et de déploiement très différentes. Les prix de ce tableau sont les tarifs catalogue directs des fournisseurs par million de tokens d’entrée et de sortie standard ; les pages de modèles GPT Proto liées peuvent proposer d’autres tarifs.
| Modèle |
Intelligence Index AA, Max |
Prix direct entrée / sortie |
Raison pratique de le choisir |
| Claude Fable 5.1 |
66 |
10 $ / 50 $ |
Raisonnement de longue durée et travail agentique haut de gamme |
| Claude Opus 5 |
63 |
5 $ / 25 $ |
Valeur par défaut Anthropic moins coûteuse pour la plupart des charges de travail |
| GPT-5.6 Sol |
61 |
5 $ / 30 $ |
Efficacité des agents, codage, utilisation de l’ordinateur et exécution multi-agents |
| Kimi K3 |
60 |
3 $ / 15 $ |
Poids ouverts, entrée d’images et coût API inférieur |
| GLM-5.3 |
60 |
1,40 $ / 4,40 $ |
Codage textuel et workflows agentiques moins coûteux |
Sources des prix : Anthropic, OpenAI, Moonshot AI et Z.AI. Les résultats d’indice indépendants proviennent d’Artificial Analysis.
Claude Fable 5.1 vs Claude Opus 5
Fable 5.1 a le plafond mesuré le plus élevé, mais Opus 5 coûte moitié moins par token d’entrée et de sortie standard. Le guide pour développeurs d’Anthropic indique à la plupart des charges de travail de commencer avec Opus 5 et d’utiliser Fable 5.1 lorsque le raisonnement exigeant ou le travail à long horizon reste insuffisant à un effort Opus plus élevé. C’est un conseil inhabituellement direct : le modèle le plus récent et le mieux noté n’est pas la valeur par défaut recommandée.
Choisissez Fable 5.1 lorsque la valeur de résolution d’une tâche difficile justifie un coût d’inférence supplémentaire. Gardez Opus 5 lorsqu’il passe déjà l’évaluation, en particulier pour le trafic de production à fort volume.
Claude Fable 5.1 vs GPT-5.6 Sol
Fable 5.1 mène l’indice composite actuel d’Artificial Analysis, tandis que GPT-5.6 Sol a un prix catalogue inférieur et est conçu autour d’un usage d’outils économe en tokens, de l’utilisation de l’ordinateur et de l’exécution multi-agents. Le tableau de lancement d’Anthropic favorise Fable 5.1 sur plusieurs tests partagés, mais ces résultats utilisent le harnais d’Anthropic. Le rapport GPT-5.6 d’OpenAI publie différentes évaluations qui favorisent GPT-5.6 Sol par rapport au précédent Fable 5 en efficacité de codage.
La conclusion la plus sûre dépend de la charge de travail. Fable 5.1 est le meilleur candidat précoce pour une tâche de raisonnement unique, difficile et longue. GPT-5.6 Sol mérite la priorité lorsque le coût, les flux de travail parallèles et l’efficacité des appels d’outils comptent autant que l’intelligence composite de pointe.
Claude Fable 5.1 vs Kimi K3
Kimi K3 atteint 60 sur le même indice indépendant tout en facturant 3 $ par million de tokens d’entrée et 15 $ par million de tokens de sortie. Il offre aussi des poids ouverts, une fenêtre de contexte d’un million de tokens et une compréhension native des images. Fable 5.1 obtient un meilleur score, mais il est propriétaire et coûte plus de trois fois plus cher en entrée et sortie standard.
Utilisez Fable 5.1 pour les tâches où les derniers points de capacité mesurée ont une valeur commerciale claire. Kimi K3 est plus facile à justifier lorsque le déploiement privé, l’accès au modèle ou le budget d’inférence est central dans la décision.
Claude Fable 5.1 vs GLM-5.3
GLM-5.3 obtient aussi 60 sur l’indice Artificial Analysis et prend en charge une fenêtre de contexte d’un million de tokens. Ses tarifs directs sont de 1,40 $ par million de tokens d’entrée et 4,40 $ par million de tokens de sortie. Contrairement à Fable 5.1, le modèle standard GLM-5.3 est uniquement textuel.
Fable 5.1 convient mieux au travail difficile sur documents visuels et aux missions autonomes les plus haut de gamme. GLM-5.3 est l’option plus économique pour le codage textuel et les agents, surtout lorsqu’une équipe doit exécuter de nombreuses tâches plutôt que maximiser la probabilité de succès d’une tâche coûteuse.
Migration de Claude Fable 5 vers Fable 5.1
Changer l’ID du modèle est nécessaire, mais ce n’est pas toute la migration.
1. Mettre à jour l’ID de modèle de l’API Claude
Cet exemple Python exécutable utilise le SDK officiel d’Anthropic et l’ID de modèle public Fable 5.1 :
import os
from anthropic import Anthropic

client = Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    messages=[
        {
            "role": "user",
            "content": "Review this migration plan and identify the three highest-risk assumptions.",
        }
    ],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
Le code Fable 5 existant passe de :
model = "claude-fable-5"
à :
model = "claude-fable-5-1"
2. Supprimer le choix d’outil forcé
Fable 5.1 ne prend pas en charge les valeurs tool_choice de any ou d’un tool nommé. L’un ou l’autre renvoie une 400 invalid_request_error :
tool_choice : les types "tool" et "any" ne sont pas pris en charge pour ce modèle.
Utilisez plutôt la sélection automatique :
{
  "tool_choice": {"type": "auto"}
}
Si la sortie doit correspondre à un schéma JSON, combinez le choix automatique d’outil avec l’usage strict des outils ou les sorties structurées. Si le modèle doit appeler un outil particulier, énoncez explicitement la condition dans le prompt et validez l’action renvoyée.
3. Conserver l’historique des blocs de réflexion en ajout seul
Fable 5.1 peut lire les blocs de réflexion produits par des modèles Claude antérieurs. Les modèles antérieurs ne peuvent pas lire les blocs de réflexion produits par Fable 5.1. Une conversation peut passer d’Opus 5 ou Fable 5 à Fable 5.1 et préserver l’état de raisonnement, mais un retour en arrière supprime les blocs de réflexion plus récents.
Modifier un message antérieur, changer le prompt système de niveau supérieur, reconstruire le tableau d’outils ou servir des octets de fichier différents à la même URL de document peut aussi invalider les blocs de réflexion ultérieurs. Lorsque l’application est active, l’API peut renvoyer :
Le bloc est lié à une autre conversation
Traitez l’historique de conversation de longue durée comme en ajout seul. Ajoutez des instructions temporaires via des messages système en cours de conversation ou limités au tour, et utilisez la compaction côté serveur ou l’édition de contexte au lieu de réécrire silencieusement les tours antérieurs. Les notes de migration Fable 5.1 d’Anthropic documentent les modèles acceptés.
4. Relancer les évaluations de coût et de comportement
Au minimum, mesurez :
taux de résultats acceptés en effort Low, Medium, High et Max ;
tokens de sortie et de raisonnement par tâche terminée ;
taux de hits du cache de prompts ;
nombre de tours d’outils et d’appels d’outils parallèles ;
temps jusqu’à la première réponse utile ;
fréquence des refus et des replis ;
si l’effort Low déclenche encore une recherche lorsque des informations fraîches sont nécessaires ;
si les petites modifications de fichiers restent ciblées.
Un modèle peut obtenir un meilleur score tout en rendant un agent particulier plus lent ou plus coûteux. La migration n’est terminée que lorsque la nouvelle configuration passe les seuils de qualité et de coût propres à la charge de travail.
Évaluer le modèle Fable actuel via GPT Proto
La page de modèle actuelle de GPT Proto expose Claude Fable 5 via un point de terminaison de chat compatible OpenAI. L’appel suivant utilise l’ID claude-fable-5 listé ; il ne prétend pas que cet ID est Fable 5.1 :
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "claude-fable-5",
    "messages": [
      {
        "role": "user",
        "content": "Review this migration plan and identify the three highest-risk assumptions."
      }
    ]
  }'
Vous pouvez essayer Claude Fable 5 via GPT Proto ou utiliser les pages liées GPT-5.6 Sol, Kimi K3 et GLM-5.3 pour évaluer des alternatives moins coûteuses avec le même compte et solde. Avant d’utiliser une future route Fable 5.1, confirmez son ID de modèle exact sur la page du modèle plutôt que de le deviner à partir de l’ID d’Anthropic.
Ce que disent les premiers testeurs et développeurs
Les premières réactions sont partagées entre l’enthousiasme pour le travail de longue durée et la méfiance envers les benchmarks de lancement.
Every a testé Fable 5.1 pendant environ une semaine sur le codage, l’écriture et le travail de connaissance. Son équipe a rapporté que le modèle était plus facile à interagir que le Fable original, pouvait travailler pendant de longues périodes et utilisait moins de la moitié des tokens d’Opus 5 sur certaines tâches comparables. Leur revue pratique a aussi relevé des limites : Fable 5.1 dépassait encore les nombres de mots demandés, et à effort plus élevé, il continuait parfois à travailler après qu’un testeur l’ait interrompu pour demander ce qu’il faisait. L’équipe n’a pas mesuré directement les économies par rapport à Fable 5.
C’est une preuve utile, mais cela reste un rapport d’accès anticipé d’une seule équipe. Cela n’établit pas de résultat général de coût ou de fiabilité.
La discussion de lancement sur r/ClaudeAI était plus sceptique. Plusieurs commentateurs se sont demandé si les benchmarks publiés se traduiraient dans le codage quotidien et ont souligné l’absence d’un résultat DeepSWE dans le tableau principal d’Anthropic. D’autres ont considéré la réduction de lecture du cache comme la partie la plus importante de l’annonce, car le contexte mis en cache représente la majeure partie de leur usage d’agents.
Les deux réactions peuvent être vraies. Fable 5.1 peut être une mise à niveau significative pour le travail délégué difficile tout en étant surdimensionné et trop cher pour le chat ordinaire, le codage de routine ou les appels d’outils courts. Le sentiment du jour de lancement ne peut pas trancher ce choix ; des tests répétés sur la charge de travail le peuvent.
Devriez-vous passer à Claude Fable 5.1 ?
Choisissez Fable 5.1 lorsque :
une tâche dure des heures ou des jours et que l’échec coûte plus cher que l’inférence ;
Opus 5 à effort plus élevé n’atteint toujours pas votre seuil d’acceptation ;
la charge de travail combine code, documents visuels, recherche et plusieurs outils ;
l’agent lit de façon répétée un grand préfixe mis en cache ;
votre intégration peut gérer les refus, le repli, les blocs de réflexion en ajout seul et le choix automatique d’outils ;
vous réglerez l’effort par tâche au lieu d’envoyer chaque requête en Max.
Restez avec Opus 5 ou Fable 5 lorsque :
le modèle actuel passe déjà votre évaluation ;
les charges de travail sont courtes, prévisibles et à forte sortie ;
l’application dépend d’appels d’outils nommés forcés ;
l’historique de conversation est régulièrement réécrit côté client ;
l’équipe ne peut pas encore surveiller le comportement de repli et de refus ;
le coût compte plus que les derniers points sur un benchmark composite.
Envisagez Kimi K3 ou GLM-5.3 lorsque :
le coût de l’API est une contrainte forte ;
les poids ouverts ou l’auto-hébergement comptent ;
la charge de travail consiste principalement en codage textuel et tâches agentiques ;
vous devez traiter de nombreux jobs et pouvez tolérer un score de pointe de benchmark plus faible ;
router chaque job vers un modèle adapté est plus économique que de standardiser sur l’option la plus chère.
Claude Fable 5.1 est donc un spécialiste à haut plafond, pas un remplacement automatique de chaque déploiement Claude.
Verdict final
Claude Fable 5.1 et Claude Mythos 5.1 sont le même modèle sous-jacent proposé via deux dispositifs d’accès. Fable est la version publique avec des garde-fous supplémentaires en cybersécurité et biologie. Mythos est réservé aux organisations vérifiées qui ont besoin de capacités plus larges dans ces domaines. Les développeurs ordinaires ne peuvent pas activer Mythos via un paramètre de modèle.
La mise à niveau 5.1 apporte des résultats précoces plus solides sur le codage de longue durée, la recherche scientifique, le travail de connaissance et l’automatisation métier. Elle ajoute aussi des contrôles utiles pour changer l’effort, des instructions système temporaires, des mises à jour de progression et la provenance du contenu. L’histoire du coût est plus étroite que le titre le suggère : les lectures de cache sont 75 % moins chères, mais les tarifs de sortie sont inchangés, et des tests indépendants ont constaté que l’effort Max pouvait encore coûter plus cher par tâche d’évaluation terminée que Fable 5.
Si un déploiement Opus 5 ou Fable 5 existant fonctionne déjà, gardez-le jusqu’à ce que Fable 5.1 passe la même évaluation au niveau des tâches. Si le modèle actuel échoue sur des missions difficiles à plusieurs étapes, Fable 5.1 est l’un des premiers candidats à tester. Pour les agents textuels sensibles au prix, GLM-5.3 offre un tarif bien plus bas. Kimi K3 ajoute des poids ouverts et l’entrée d’images, tandis que GPT-5.6 Sol met l’accent sur l’usage efficace des outils et l’exécution multi-agents.
La bonne comparaison n’est pas un nom de modèle contre un autre. C’est le résultat accepté, le total de tokens, le temps et le coût sur le travail que votre application effectue réellement.