Qwen3.8-Flash-Next vs GLM-5.3 Flash en un coup d'œil
| Catégorie |
Qwen3.8-Flash-Next |
GLM-5.3 Flash |
Avantage actuel |
| Statut du produit |
Aperçu d'architecture expérimentale |
API de production et poids ouverts |
GLM |
| Indice d'intelligence indépendant |
56 |
57 |
GLM, de justesse |
| Vitesse de sortie sur les routes first-party suivies |
87.4 tokens/s |
45.2 tokens/s |
Qwen |
| Temps jusqu'au premier token |
2.57 secondes |
1.54 secondes |
GLM |
| Contexte natif |
262,144 tokens |
1,048,576 tokens |
GLM |
| Taille du modèle |
modèle de langage 125B + embeddings n-gram 51B + MTP 4B |
320B au total |
— |
| Paramètres activés |
6B |
18B |
Qwen pour le calcul par token |
| Entrée multimodale |
Encodeur de vision ; support de serving variable |
Texte, image, vidéo et fichiers |
GLM pour un usage managé |
| Licence des poids |
Qwen Community License 1.0 |
MIT |
GLM |
| API de production |
Qwen oriente les utilisateurs managés vers Qwen3.8-Flash |
Disponible sous glm-5.3-flash |
GLM |
| Meilleur usage |
Expériences locales et recherche sur le serving à haut débit |
Codage en production et agents multimodaux |
Dépend de la charge de travail |
Les chiffres indépendants proviennent de Artificial Analysis, qui évalue les deux modèles selon une même méthodologie. GLM mène son Intelligence Index 57 à 56. Qwen génère sa sortie presque deux fois plus vite sur les routes first-party suivies, tandis que GLM commence à renvoyer des tokens plus tôt et fournit quatre fois le contexte natif.
Ce n'est pas un balayage net pour l'un ou l'autre modèle. C'est un arbitrage entre l'efficacité de serving de Qwen et l'offre de production plus complète de GLM.
Flash-Next n'est pas l'API Qwen3.8-Flash de production
Ce détail de nommage change toute la comparaison.
La fiche modèle Qwen3.8-Flash-Next qualifie cette version d'« aperçu expérimental » de l'architecture qui sous-tendra Qwen4. Elle fournit les poids et la configuration pour les chercheurs et les auto-hébergeurs. Son contexte natif est de 262,144 tokens, extensible à un million de tokens avec YaRN.
La même fiche modèle indique aux utilisateurs d'inférence managée d'utiliser Qwen3.8-Flash à la place. Cette version formelle est basée sur Flash-Next mais ajoute des fonctionnalités de production comme un contexte d'un million de tokens par défaut et des outils intégrés officiels. Un benchmark ou un prix publié pour Qwen3.8-Flash ne doit donc pas être silencieusement requalifié comme un résultat Flash-Next.
GLM-5.3 Flash a une identité plus simple. Le checkpoint téléchargeable et l'API officielle utilisent le même nom de modèle, glm-5.3-flash. Les développeurs peuvent l'auto-héberger ou appeler une route managée sans devoir d'abord faire la traduction entre un checkpoint expérimental et un équivalent de production.
En clair : il s'agit en partie d'une comparaison de modèles et en partie d'une comparaison de déploiement. Qwen montre aux développeurs où va son architecture. Z.ai vend un modèle que les développeurs peuvent mettre derrière une API dès aujourd'hui.
Architecture : pourquoi 6B de paramètres actifs ne font pas de Qwen un petit modèle
Qwen3.8-Flash-Next n'active que six milliards de paramètres par token, contre 18 milliards pour GLM-5.3 Flash. Cela aide à expliquer son avantage de débit, mais ne signifie pas que le checkpoint Qwen occupe la mémoire d'un modèle 6B conventionnel.
Selon la fiche modèle de Qwen, Flash-Next contient un modèle de langage de 125B paramètres, une table d'embeddings n-gram de 51B paramètres et un composant de prédiction multi-token de 4B paramètres. Ses 48 couches répètent trois blocs Gated DeltaNet suivis d'un bloc Qwen Sparse Attention. Seul un sous-ensemble d'experts s'exécute pour chaque token, mais les experts inactifs et la table n-gram doivent toujours résider en mémoire, sur stockage ou dans un système d'offloading.
La table n-gram est la partie inhabituelle. Elle stocke des représentations pour les motifs courts de tokens fréquents afin que le réseau principal ne dépense pas le même calcul à les reconstruire. Qwen l'a conçue pour être plus facile à décharger que des poids MoE normaux. Le compromis est que l'efficacité de serving dépend désormais fortement de la capacité de RAM, de la bande passante SSD, de la quantification, du memory mapping et du support du moteur d'inférence.
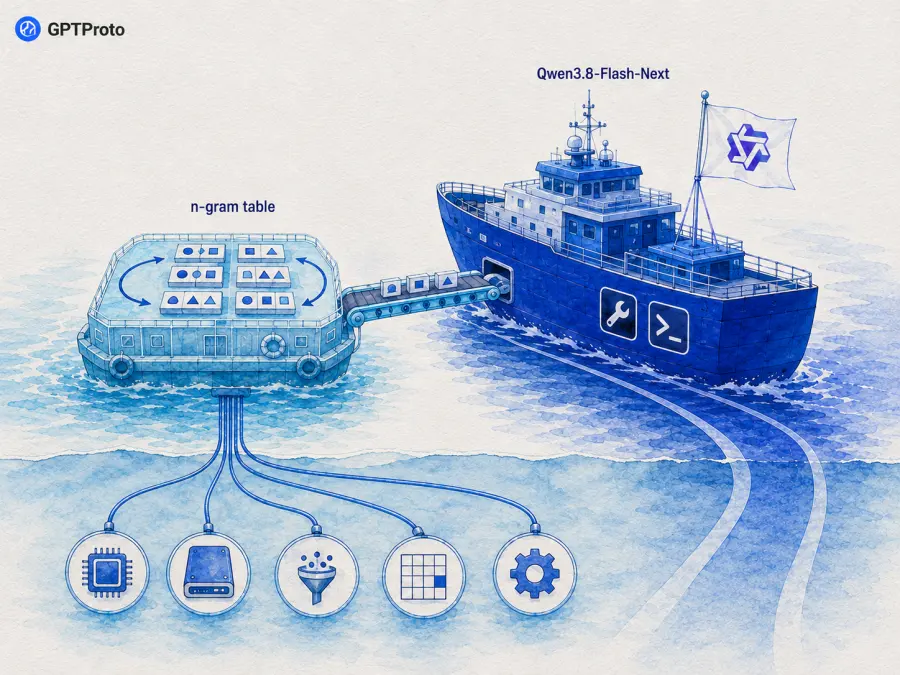
Les premiers retours de la communauté illustrent la différence. Certaines configurations en quatre bits occupaient environ 100GB. Une configuration quantifiée paginable a réduit la mémoire résidente à environ 65GB, tandis que d'autres utilisateurs faisaient tourner le modèle sur du matériel de 96GB en plaçant une partie de la table n-gram sur SSD. Ce sont des résultats prometteurs, mais ils demandent nettement plus de travail que le chargement d'un checkpoint 6B normal.
GLM-5.3 Flash est plus grand : 320B paramètres au total avec environ 18B actifs par token. Z.ai combine attention linéaire, attention sparse et Manifold-Constrained Hyper-Connections sur 45 couches. Le modèle a été entraîné sur un corpus multimodal de 30 000 milliards de tokens et accepte nativement le texte, les images, la vidéo et les fichiers.
La conclusion pratique est simple. Qwen dépense moins de calcul par token généré, mais son empreinte mémoire totale n'est pas petite. GLM nécessite une infrastructure d'auto-hébergement plus substantielle, mais les utilisateurs d'API n'ont pas du tout à exploiter cette infrastructure.
Benchmarks : GLM mène, mais pas assez pour clore le débat
Les tableaux de benchmarks des fournisseurs sont utiles pour comprendre ce que chaque laboratoire a optimisé. Ils constituent une pauvre preuve pour déclarer un vainqueur universel lorsque les frameworks d'évaluation, les prompts, les outils, les paramètres de contexte et les règles de notation diffèrent.
Artificial Analysis fournit la comparaison la plus claire :
| Métrique indépendante |
Qwen3.8-Flash-Next |
GLM-5.3 Flash |
Interprétation |
| Indice d'intelligence |
56 |
57 |
Quasiment à égalité |
| Vitesse de sortie |
87.4 tokens/s |
45.2 tokens/s |
Qwen renvoie plus vite les tokens générés |
| Temps jusqu'au premier token |
2.57 secondes |
1.54 secondes |
GLM démarre plus tôt |
| Prix mixte par million de tokens |
$0.09 |
$0.10 |
Presque à égalité selon la pondération 7:2:1 |
| Contexte natif |
256K |
1M |
GLM détient plus de contexte sans extrapolation |
Un avantage d'un point sur l'Intelligence Index prouve que GLM est compétitif, pas que Qwen perd toutes les tâches. Il importe aussi que Qwen ait utilisé plus de tokens de sortie dans l'évaluation : Artificial Analysis rapporte environ 200M pour Qwen contre 150M pour GLM. Un modèle peut avoir un débit annoncé faible et coûter plus cher par workflow terminé s'il raisonne plus longtemps.
Les résultats officiels en codage et agents pointent dans la même direction générale mais nécessitent plus de prudence :
| Benchmark rapporté par le fournisseur |
Qwen3.8-Flash-Next |
GLM-5.3 Flash |
Avertissement de comparaison |
| DeepSWE 1.1 |
58.7 |
63.4 |
La configuration d'évaluation doit être vérifiée |
| NL2Repo |
48.1 |
56.3 |
Rapporté par différents fournisseurs |
| Toolathlon Verified |
73.5 |
78.4 |
GLM rapporte Pass@1 moyenné sur trois exécutions |
| Agents' Last Exam |
24.3 Pass@1 |
26.3 |
Ne comparez pas le score séparé de 51.2 de Qwen avec Pass@1 |
Une comparaison qui ne devrait pas apparaître dans un article sérieux est le score HLE de 35.9 de Qwen face au score HLE with Tools de 55.3 de GLM. Ils ont des libellés similaires mais des conditions différentes. L'écart de 19.4 points paraît spectaculaire uniquement parce que le tableau masque le paramètre d'outil.
Ma lecture des preuves : GLM a aujourd'hui un léger avantage de qualité. Qwen a un net avantage de débit sur la route mesurée. Aucune de ces différences ne dispense de tester les modèles sur le dépôt réel, le schéma d'outils et les critères d'acceptation qui détermineront si un agent réussit.
Qwen3.8-Flash-Next vs GLM-5.3 Flash pour le codage
Pour le codage au niveau du dépôt, GLM-5.3 Flash est le choix par défaut plus sûr. Il mène les résultats DeepSWE et NL2Repo rapportés par le fournisseur, offre un contexte natif d'un million de tokens et est déjà exposé via une API formelle avec function calling et sortie structurée.
Cette combinaison compte plus que quelques points de benchmark. Un agent de codage doit lire répétitivement des fichiers, préserver des contraintes, appeler des outils, récupérer après des erreurs et continuer à travailler après l'échec du premier patch. Un modèle qui génère rapidement des tokens mais exige une intégration de serving immature peut perdre son avantage lorsque la boucle d'agent complète est prise en compte.
Qwen3.8-Flash-Next a encore un rôle de codage attrayant : éclaireur ou sous-agent. Son débit de génération plus élevé en fait un choix plausible pour l'exploration de dépôts, la proposition de plusieurs approches, la rédaction de fonctions isolées ou l'exécution de tâches parallèles à faible risque. Les équipes qui gèrent déjà l'inférence locale peuvent accepter la configuration supplémentaire en échange du contrôle de la quantification et du placement matériel.
La décision n'est donc pas « GLM code et Qwen non ». Les deux peuvent coder. Choisissez GLM lorsque l'achèvement des tâches et l'intégration managée passent en premier. Choisissez Qwen lorsque l'exploration locale rapide et le contrôle de l'infrastructure justifient le travail d'ingénierie.
Quel modèle est meilleur pour le codage frontend ?
Il n'existe pas encore de grand benchmark frontend indépendant qui compare proprement ces versions exactes. Une expérience communautaire utile montre toutefois pourquoi les scores de codage simples manquent une partie de l'histoire.
Un utilisateur de LocalLLaMA a donné aux versions quantifiées des deux modèles la même image de référence et a demandé à chacun de la reproduire sous forme de jeu vidéo ou de démo technique, en itérant pendant jusqu'à environ 90 minutes. L'utilisateur a rapporté que le résultat de GLM était plus proche de l'échelle de référence et plus détaillé dès le début. Qwen a emprunté une voie plus inhabituelle et a écrit un moteur de rendu logiciel à partir de zéro, tandis que GLM utilisait Canvas 2D.
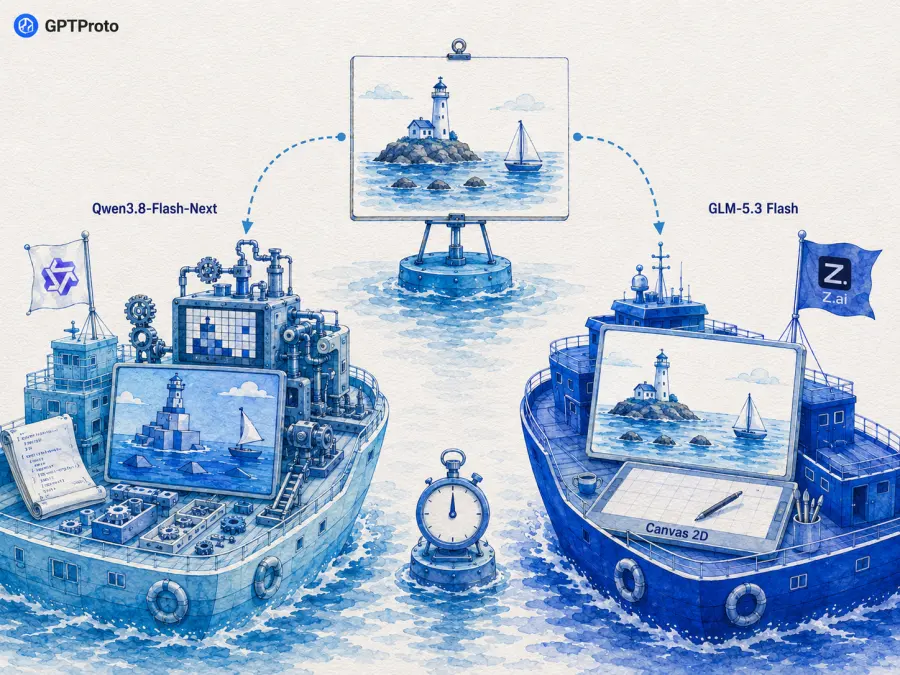
Après une correction demandée d'erreur console, GLM a étendu son résultat en un simulateur de marche en pixel art jouable. L'exécution a consommé environ 238K tokens et environ deux heures au total. C'est une persévérance impressionnante, mais cela montre aussi le coût de la génération frontend sur un horizon long : une démo réussie peut consommer bien plus de sortie qu'une table de débit de tokens ne le laisse entendre.
L'expérience ne prouve pas que GLM battra Qwen sur chaque tableau de bord React, scène Three.js ou composant Vue. Les modèles ont aussi choisi des approches techniques différentes, ce qui rend les sorties difficiles à noter sur un seul axe. Le résultat offre néanmoins un premier signal pratique :
Choisissez GLM lorsque la fidélité visuelle, la correspondance de capture d'écran et l'achèvement itératif comptent le plus.
Testez Qwen lorsqu'une implémentation non conventionnelle ou des alternatives générées localement peuvent être précieuses.
Pour l'instant, GLM-5.3 Flash remporte provisoirement la catégorie frontend. Le mot « provisoirement » compte.
Qwen3.8-Flash-Next vs GLM-5.3 Flash pour les agents
GLM a le meilleur argument pour les agents de production. Son API officielle prend en charge le function calling, le cache de contexte, la sortie structurée, les réponses en streaming et les arguments d'outils en streaming. Sa fenêtre native d'un million de tokens offre plus d'espace pour les dépôts, les résultats d'outils, les instructions système et un historique d'interaction long sans dépendre de l'extrapolation de contexte.
Son profil de benchmark soutient aussi ce positionnement. Z.ai rapporte 78.4 sur Toolathlon Verified et 26.3 sur Agents' Last Exam. Ces résultats restent rapportés par le fournisseur, mais ils s'alignent avec l'avantage indépendant d'un point sur l'Intelligence Index et le retour communautaire d'itération frontend soutenue.
L'avantage de Qwen est le débit. Un agent local qui appelle fréquemment le modèle pour de courtes étapes de planification, recherche, classification ou génération de brouillons pourrait bénéficier d'un décodage plus rapide. Flash-Next est aussi utile aux équipes qui étudient le comportement de l'attention sparse et des embeddings n-gram pendant de longues exécutions d'agents.
La limitation est la stratification produit. Les outils intégrés et le contexte par défaut d'un million de tokens promus pour Qwen3.8-Flash appartiennent à l'équivalent de production, pas automatiquement à chaque déploiement Flash-Next auto-hébergé. Avec le checkpoint ouvert, le function calling, la fiabilité JSON, la mise à l'échelle du contexte et la stabilité du serving dépendent en partie de la pile d'inférence et des templates choisis par le développeur.
Pour des agents de production de longue durée, choisissez GLM. Pour un sous-agent local expérimental, Qwen mérite un test.
Vitesse, contexte et déploiement local
Le mot « Flash » ne garantit pas le même type de vitesse.
Sur les routes first-party suivies par Artificial Analysis, Qwen3.8-Flash-Next a généré 87.4 tokens par seconde, contre 45.2 pour GLM-5.3 Flash. GLM avait néanmoins le temps jusqu'au premier token le plus faible : 1.54 seconde contre 2.57 secondes. Qwen était plus rapide une fois lancé ; GLM a démarré plus tôt.
L'hébergement peut inverser ou amplifier ces résultats. Artificial Analysis a mesuré des routes GLM allant d'environ 45 à plus de 290 tokens de sortie par seconde. Les poids du modèle ne sont qu'un composant. Le matériel, le batching, la quantification, le décodage spéculatif, la charge et le logiciel de serving affectent tous le chiffre que l'utilisateur voit finalement.
Un test communautaire NVFP4 distinct a rapporté les chiffres locaux suivants :
| Test local |
Qwen3.8-Flash-Next |
GLM-5.3 Flash |
| Flux unique |
47.6 tokens/s |
21.9–33.3 tokens/s |
| TTFT |
0.16 secondes |
0.43 secondes |
| Quatre flux simultanés, agrégé |
119.1 tokens/s |
50.6 tokens/s |
Ces chiffres proviennent d'une seule configuration matérielle et de quantification. Ils soutiennent l'histoire d'efficacité de Qwen, mais ne doivent pas être présentés comme une performance API universelle.
Le contexte est moins ambigu. Qwen prend nativement en charge 262,144 tokens et peut s'étendre à un million avec YaRN. GLM prend nativement en charge 1,048,576 tokens et jusqu'à 131,072 tokens de sortie. Pour un dépôt plus un historique d'outils qui dépasse réellement 256K, GLM offre la limite la plus propre. Pour un prompt de codage normal, une fenêtre d'un million de tokens inutilisée n'apporte aucun gain de qualité automatique.
Tarification : quel modèle est plus rentable ?
La tarification nécessite trois libellés : checkpoint expérimental, route hébergée suivie et équivalent de production. Les fusionner crée un tableau trompeur.
| Modèle ou route |
Entrée par million de tokens |
Sortie par million de tokens |
Qualification importante |
| Qwen3.8-Flash-Next, route suivie par Artificial Analysis |
$0.15 |
$0.47 |
Route hébergée observée, pas un prix catalogue durable de Flash-Next |
| GLM-5.3 Flash, prix standard officiel |
$0.15 |
$0.50 |
Exclut la promotion temporaire de lancement |
| GLM-5.3 Flash sur GPT Proto |
$0.135 |
$0.45 |
10 % en dessous du prix standard officiel |
Z.ai mène aussi une promotion temporaire de lancement à $0.075 par million de tokens d'entrée et $0.25 par million de tokens de sortie jusqu'au 9 septembre 2026. Toute personne achetant en direct pendant cette fenêtre devrait utiliser les chiffres promotionnels. Pour une comparaison destinée à rester utile après la semaine de lancement, le prix standard est la meilleure référence.
Considérez une charge de travail d'agent de codage qui traite 10M de tokens d'entrée et génère 2M de tokens de sortie, hors frais de cache :
Route suivie Qwen : 10 × $0.15 + 2 × $0.47 = $2.44
Tarif standard officiel GLM : 10 × $0.15 + 2 × $0.50 = $2.50
GLM via GPT Proto : 10 × $0.135 + 2 × $0.45 = $2.25
Avec ces tarifs hébergés, la route GLM de GPT Proto coûte $0.19 de moins que la route Qwen suivie pour le même volume de tokens. L'économie est réelle mais modeste. Une seule nouvelle tentative ou 100K tokens de raisonnement supplémentaires peuvent compter davantage.
L'auto-hébergement change la comptabilité plutôt que de l'éliminer. L'activation de six milliards de paramètres de Qwen devrait réduire le calcul par token, mais l'équipe paie toujours les GPU, la RAM, la capacité SSD, l'électricité, le temps d'ingénierie, la supervision et la capacité inactive. Le checkpoint plus grand de GLM élève encore ce plancher d'infrastructure. À faible trafic ou trafic irrégulier, une API coûtera souvent moins cher que d'exploiter l'un ou l'autre modèle. À utilisation élevée soutenue, Qwen local peut devenir attrayant—à condition que sa licence couvre le produit.
Pour un usage hébergé dans cette comparaison, GLM via GPT Proto est le choix rentable. Pour l'auto-hébergement, aucun gagnant honnête ne peut être nommé sans les hypothèses de matériel, d'utilisation, de quantification et de personnel.
Licence et risque de production
Les deux modèles publient des poids téléchargeables. Un seul utilise une licence logicielle permissive standard.
GLM-5.3 Flash est publié sous MIT. Les développeurs peuvent l'utiliser, le modifier, le distribuer et l'héberger commercialement tout en conservant l'avis de copyright et de licence requis.
Qwen3.8-Flash-Next utilise la Qwen Community License 1.0. La licence autorise de nombreux usages commerciaux, mais ajoute des conditions qui comptent pour les activités d'API et d'agents. Les produits dépassant 100 millions d'utilisateurs actifs mensuels ou $20 millions de revenus mensuels doivent afficher clairement le nom du modèle. Plus important encore, un licencié exerçant une activité de Model-as-a-Service ou d'AI Work Assistant doit obtenir une licence distincte de Qwen avant d'utiliser le logiciel commercialement, sauf pour un usage interne qui n'expose pas le modèle, ses sorties ou ses capacités à des tiers.
Cela ne rend pas Qwen inutilisable. Cela signifie que « open weights » ne doit pas être traduit par « hébergement commercial sans restriction ». Une équipe qui construit un outil d'analyse interne fait face à une question de licence différente d'une équipe qui vend une API ou un assistant de codage public.
| Question commerciale |
Qwen3.8-Flash-Next |
GLM-5.3 Flash |
| Poids téléchargeables |
Oui |
Oui |
| Licence permissive standard |
Non |
Oui, MIT |
| Revente MaaS/API |
Licence Qwen distincte requise |
Autorisé selon les conditions MIT |
| Activité d'AI Work Assistant |
Licence Qwen distincte requise |
Autorisé selon les conditions MIT |
| Obligation d'affichage pour les grands produits |
S'applique au-dessus des seuils indiqués |
Aucun seuil produit équivalent |
Pour une API publique, une plateforme d'agents commerciale ou un assistant de codage, GLM a le chemin de déploiement le plus clair.
Quel modèle choisir ?
| Cas d'usage |
Modèle recommandé |
Pourquoi |
| API de codage en production |
GLM-5.3 Flash |
API formelle, contexte natif 1M, licence MIT |
| Agent outillé de longue durée |
GLM-5.3 Flash |
Contexte natif plus grand et fonctionnalités API matures |
| Workflow de capture d'écran vers code |
GLM-5.3 Flash, provisoirement |
Meilleure fidélité visuelle dans un premier test communautaire |
| Génération locale à haut débit |
Qwen3.8-Flash-Next |
Vitesse de décodage mesurée plus élevée et 6B de paramètres actifs |
| Recherche sur l'architecture |
Qwen3.8-Flash-Next |
Aperçu de la prochaine architecture de Qwen |
| Éclaireur local ou sous-agent |
Qwen3.8-Flash-Next |
La génération rapide peut convenir au travail exploratoire parallèle |
| MaaS ou assistant IA public |
GLM-5.3 Flash |
La licence du checkpoint de Qwen nécessite une permission distincte |
| Tarif hébergé plus bas dans cette comparaison |
GLM sur GPT Proto |
$0.135/M en entrée et $0.45/M en sortie |
GLM-5.3 Flash est le meilleur choix par défaut pour la plupart des développeurs qui choisissent une API aujourd'hui. Qwen3.8-Flash-Next est l'expérience la plus intéressante, mais ce n'est pas le produit de production le plus complet.
Comment essayer GLM-5.3 Flash via GPT Proto
GPT Proto expose GLM-5.3 Flash via un endpoint chat-completions compatible OpenAI. Créez un compte, ajoutez du solde, générez une clé API et envoyez la requête suivante :
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Examinez cette fonction JavaScript, identifiez le bug et renvoyez une version corrigée."
      }
    ]
  }'
Gardez l'ID du modèle dans la configuration plutôt que de le coder en dur dans toute l'application. Cela facilite l'exécution de tests d'acceptation, la comparaison ultérieure avec un autre modèle ou l'acheminement différencié des requêtes difficiles.
GPT Proto fournit actuellement la route GLM-5.3 Flash discutée dans cet article. Cette comparaison n'implique pas que GPT Proto héberge Qwen3.8-Flash-Next.
Commencez à tester GLM-5.3 Flash à $0.135/M en entrée et $0.45/M en sortie.
Verdict final
GLM-5.3 Flash remporte cette comparaison pour l'usage en production. Son avance indépendante d'un point sur l'Intelligence Index n'est que d'un point, donc l'intelligence brute n'est pas l'avantage décisif. L'argument plus fort est opérationnel : une API formelle, un contexte natif d'un million de tokens, une large entrée multimodale, des fonctionnalités d'agent matures et une licence MIT.
Qwen3.8-Flash-Next l'emporte sur la vitesse de sortie mesurée et la nouveauté architecturale. C'est une option convaincante pour les chercheurs, les auto-hébergeurs et les équipes prêtes à ajuster une pile d'inférence précoce. Ses six milliards de paramètres activés sont significatifs, mais la table n-gram de 51B l'empêche de se comporter comme un petit checkpoint 6B en mémoire.
Si je devais choisir un modèle pour une API de codage ou d'agents en production aujourd'hui, je commencerais par GLM et testerais Qwen comme alternative expérimentale locale. Si j'étudiais des architectures sparse de nouvelle génération ou construisais un éclaireur local à haut débit, j'inverserais cet ordre.