Qwen 3.8 Max vs GLM 5.3 : la réponse courte
| Si votre priorité est... |
Meilleur point de départ |
Pourquoi |
| Codage à l'échelle d'un dépôt et agents de terminal |
GLM 5.3 |
Léger avantage dans les préférences de codage indépendantes, résultats d'agents plus solides rapportés par le fournisseur, coût de tokens inférieur |
| Codage frontend et génération d'UI |
Qwen 3.8 Max |
Avance claire dans Arena WebDev et Frontend |
| Capture d'écran vers code ou débogage visuel |
Qwen 3.8 Max |
Accepte les entrées image et vidéo ; GPT Proto GLM-5.3 est T2T uniquement |
| Coût API le plus bas |
GLM 5.3 |
$1.26/M en entrée et $3.96/M en sortie sur GPT Proto |
| Contrôle du raisonnement |
Qwen 3.8 Max |
Prend en charge les modes réflexion et non-réflexion ; GLM 5.3 raisonne toujours |
| Agents textuels à long contexte |
GLM 5.3 |
Contexte 1M, sortie 128K, coût inférieur et post-entraînement orienté agents |
| Un modèle pour les tâches mixtes texte et visuelles |
Qwen 3.8 Max |
Prise en charge d'entrées plus large avec la même classe de contexte 1M |
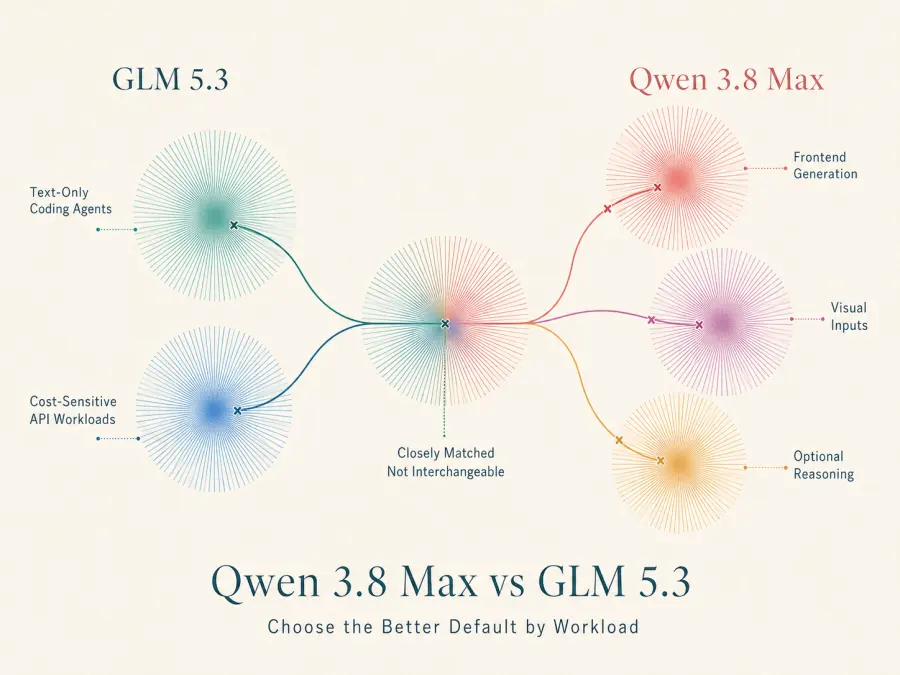
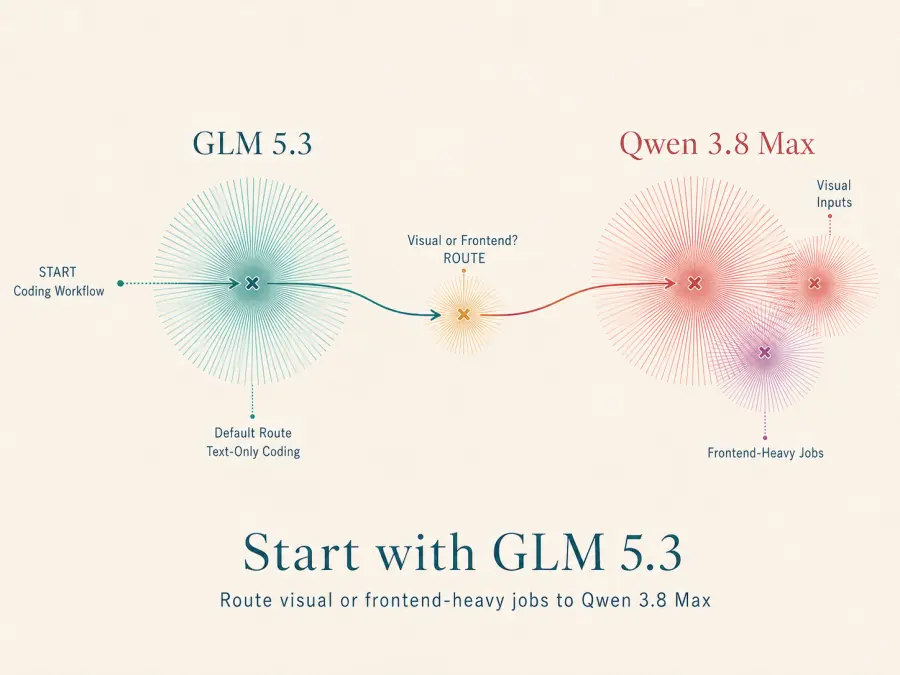
Pour un workflow de codage textuel, commencez par GLM 5.3 et dirigez les tâches visuelles ou à forte composante frontend vers Qwen 3.8 Max.
Qwen 3.8 Max vs GLM 5.3 en un coup d'œil
| Fonctionnalité |
Qwen 3.8 Max |
GLM 5.3 |
| Fournisseur |
Alibaba Cloud / Qwen |
Z.ai |
| ID de modèle API sur GPT Proto |
qwen3.8-max |
glm-5.3 |
| Entrée sur GPT Proto |
Texte, image, vidéo |
Texte uniquement |
| Sortie |
Texte |
Texte |
| Fenêtre de contexte |
1M tokens |
1M tokens |
| Sortie maximale |
131,072 tokens |
128K tokens |
| Raisonnement |
Réflexion ou non-réflexion |
Toujours activé ; l'effort peut être faible, élevé ou max |
| Appel de fonctions |
Oui |
Oui |
| Sortie structurée |
Oui |
Oui |
| Mise en cache des prompts |
Oui |
Oui |
| Prix d'entrée GPT Proto |
$1.80 par 1M tokens |
$1.26 par 1M tokens |
| Prix de sortie GPT Proto |
$5.40 par 1M tokens |
$3.96 par 1M tokens |
Documentation Qwen d'Alibaba décrit Qwen 3.8 Max comme un modèle amiral mixture-of-experts de 2,4 billions de paramètres avec une fenêtre de contexte d'un million de tokens. Il prend en charge les entrées visuelles, les appels d'outils, la sortie structurée et la mise en cache des prompts. Le service Max hébergé ne doit pas être confondu avec tous les modèles portant le nom Qwen 3.8.
Documentation GLM 5.3 de Z.ai indique que le modèle conserve l'architecture de base de GLM 5.2 et tire ses principaux gains du post-entraînement. Son objectif : le codage, les agents, l'utilisation d'outils, les tâches à long horizon et un raisonnement plus efficace. Sur GPT Proto, sa route est texte-vers-texte uniquement.
Comparaison des benchmarks : le gagnant change selon la tâche
Intelligence indépendante et coût
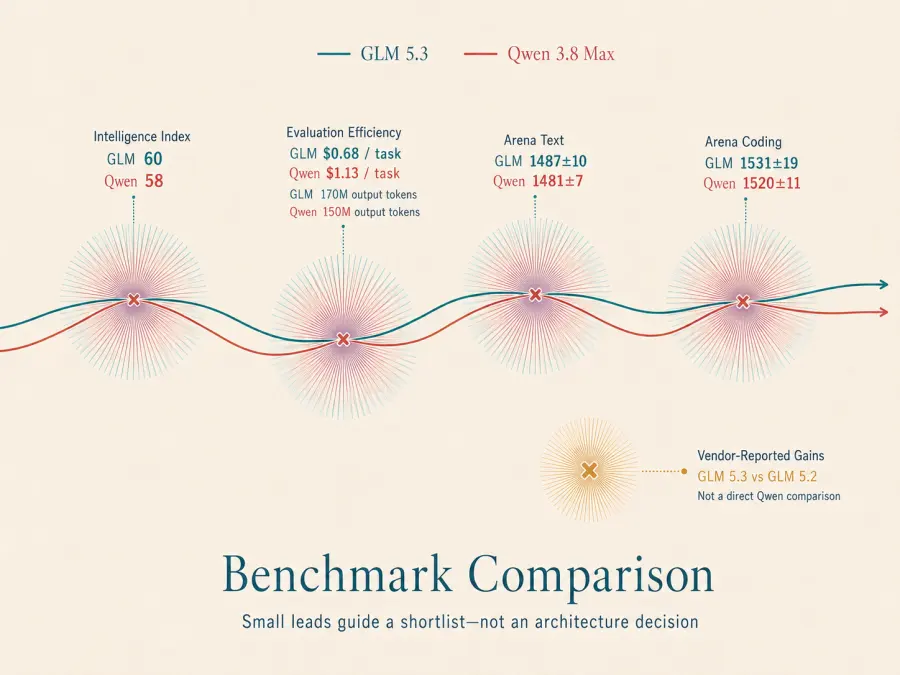
Artificial Analysis attribue à Qwen 3.8 Max un score de 58 à l'Intelligence Index et GLM 5.3 à effort de raisonnement maximal un score de 60. L'écart est faible, mais le résultat d'efficacité est plus intéressant : son coût rapporté par tâche évaluée est de $1.13 pour Qwen et de $0.68 pour GLM.
GLM a produit plus de tokens de sortie d'évaluation — environ 170 millions contre 150 millions — mais a quand même coûté moins par tâche. C'est une preuve utile pour les charges de travail d'agents, car un faible prix par token peut être annulé si un modèle nécessite de longues traces, des reprises ou des appels d'outils répétés. Ici, GLM a conservé l'avantage de coût tout en générant plus de tokens.
Ce sont des résultats contrôlés, pas une prédiction de votre facture de production. La mise en cache, les erreurs d'outils et les reprises peuvent changer le résultat.
Préférence humaine pour le texte et le codage
Sur le classement Arena Text, GLM 5.3 a obtenu 1487±10 et Qwen 3.8 Max 1481±7 dans l'instantané utilisé pour cette comparaison. Sur le sous-ensemble codage, GLM a obtenu 1531±19 contre 1520±11 pour Qwen.
Cela donne à GLM une avance indicative, pas un knockout. Les intervalles de confiance se chevauchent, et l'intervalle de codage de GLM est relativement large. Un écart de six points en texte ou de onze points en codage doit guider une présélection, pas trancher à lui seul une décision d'architecture.
Gains de codage et d'agents rapportés par le fournisseur
Z.ai rapporte des améliorations substantielles par rapport à GLM 5.2 : Terminal-Bench 3 passe de 4.6 à 28.3, DeepSWE 1.1 de 46.2 à 66.9, et Agents' Last Exam de 23.8 à 28.5. Son benchmark de code privé s'améliore apparemment de 23.4% à 34.5%, tandis que la sortie par tâche baisse d'environ 96K à 75K tokens.
Ces résultats soutiennent le positionnement du modèle pour des boucles de codage et d'agents plus longues. Ce sont aussi des comparaisons menées par le fournisseur contre GLM 5.2 — pas des tests directs et indépendants de Qwen 3.8 Max contre GLM 5.3. Considérez-les comme des preuves de progrès, pas comme la preuve que GLM gagne chaque tâche de codage.
Quel modèle est meilleur pour le codage ?
Pour le codage général, GLM 5.3 est le meilleur premier choix lorsque l'entrée est du texte. Il combine une avance modeste dans les données de préférence de codage d'Arena avec des prix API plus bas et un post-entraînement visant le travail sur dépôt, l'utilisation du terminal, les appels d'outils et les longues trajectoires d'agents.
Cela fait de GLM un bon choix pour :
Explorer un grand dépôt et proposer une modification multi-fichiers
Exécuter une boucle test-correction-test via un agent
Réviser des pull requests ou tracer des défauts backend
Générer des migrations, scripts et code de service
Traiter de longues spécifications textuelles ou des logs dans un contexte de 1M tokens
Qwen 3.8 Max reste compétitif pour le développement quotidien. Ses avantages pratiques sont le raisonnement optionnel et l'entrée visuelle. Un développeur peut utiliser le mode non-réflexion pour de courtes transformations ou une génération de code simple, puis activer un raisonnement plus profond pour l'architecture, le débogage ou des refactorisations complexes. Le raisonnement de GLM 5.3 ne peut pas être désactivé, même si son niveau d'effort peut être réduit.
Pour les tâches courtes et sensibles à la latence — renommer des symboles, écrire un petit test unitaire, traduire un schéma ou modifier un fichier de configuration — le chemin non-réflexion de Qwen peut être plus facile à contrôler. Pour les longues tâches autonomes où le coût en tokens et la persistance des outils comptent, GLM a le meilleur point de départ.
Qwen 3.8 Max vs GLM 5.3 pour le codage frontend
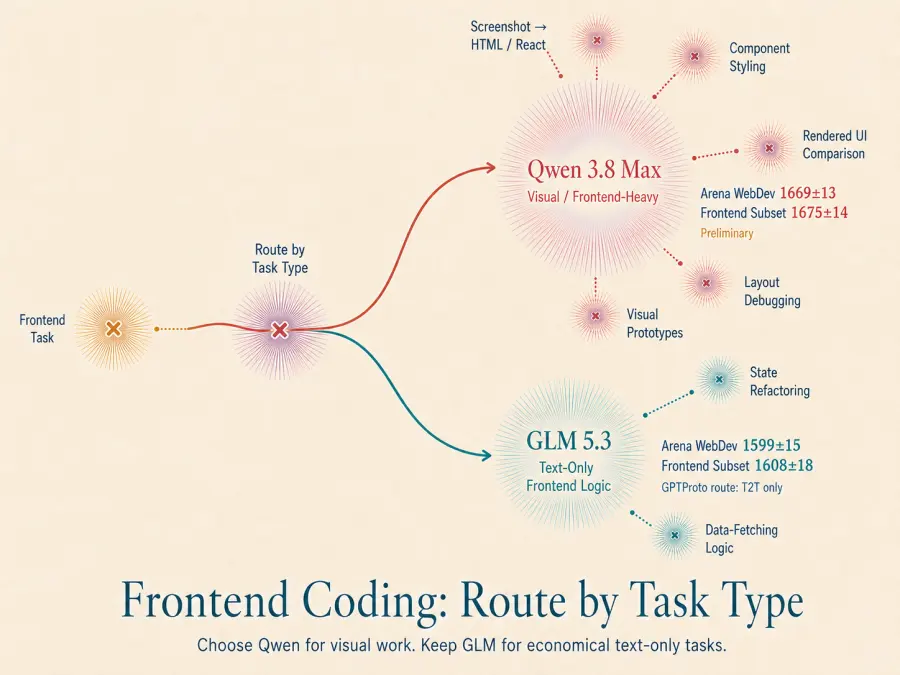
Le frontend est l'exception la plus claire à l'avantage général de GLM en codage. Sur Arena WebDev, Qwen 3.8 Max a obtenu 1669±13 contre 1599±15 pour GLM 5.3. Dans le sous-ensemble Frontend, Qwen a obtenu 1675±14 contre 1608±18 pour GLM.
Le résultat de Qwen était marqué préliminaire dans l'instantané du classement, il peut donc évoluer à mesure que d'autres votes arrivent. Même avec cette réserve, l'écart observé est bien plus grand que la différence sur les classements généraux de texte et de codage.
Qwen accepte aussi les captures d'écran et les entrées vidéo. Cela change ce qu'un workflow frontend peut inclure : une capture d'écran peut être associée à un brief de design, une page rendue peut être inspectée pour des défauts visuels, ou un court enregistrement d'interaction peut fournir du contexte pour un bug d'UI. Comme la route GPT Proto GLM-5.3 est T2T uniquement, elle ne peut pas recevoir directement ces artefacts visuels.
Choisissez Qwen 3.8 Max en premier pour :
Tâches capture d'écran vers HTML ou capture d'écran vers React
Style de composants et composition de page
Comparer une UI rendue avec une référence visuelle
Déboguer la mise en page, l'espacement ou le comportement responsive à partir d'images
Générer des prototypes où la préférence visuelle est le principal critère d'acceptation
Si la tâche frontend est principalement textuelle — comme refactoriser la gestion d'état ou écrire une logique de récupération de données — GLM peut rester l'option la plus économique. Routez selon le type de tâche, pas selon l'étiquette du dépôt.
Quel modèle est meilleur pour les agents ?
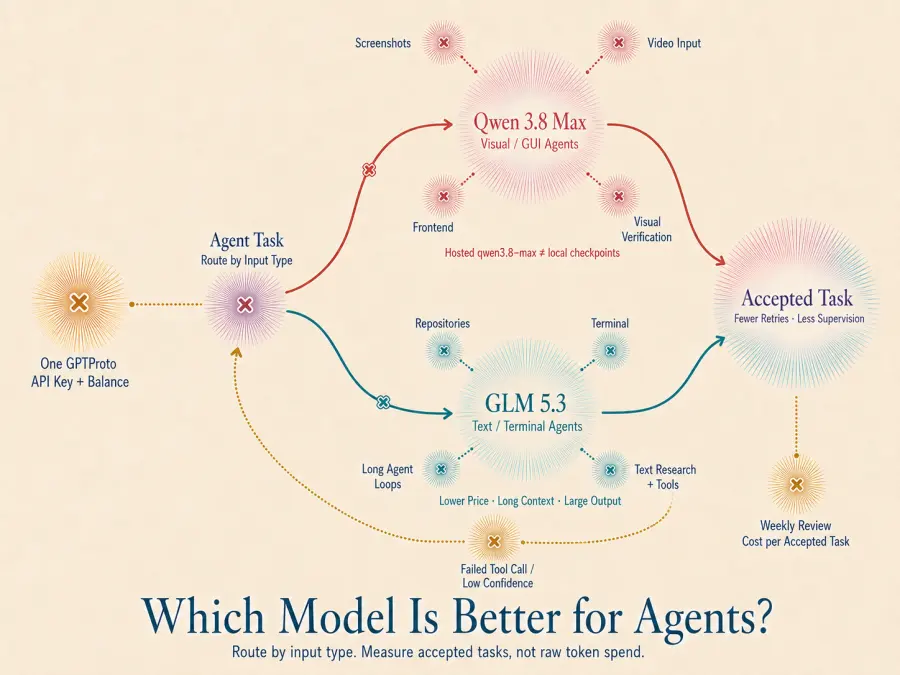
Pour les agents textuels et de terminal, GLM 5.3 a l'avantage. Son prix inférieur, son contexte long, sa grande allocation de sortie, l'appel de fonctions, la sortie structurée et son entraînement orienté agents en font un choix par défaut judicieux pour le codage autonome, la recherche sur des corpus textuels et les workflows pilotés par outils.
Pour les agents visuels ou conscients de l'interface graphique, Qwen 3.8 Max est le choix pratique car il peut recevoir des entrées image et vidéo. Un agent de navigateur qui doit inspecter une capture d'écran, un agent de support qui reçoit une image téléversée, ou un agent de codage qui compare une référence visuelle à une page rendue nécessite un canal d'entrée que GLM uniquement textuel ne fournit pas sur GPT Proto.
Les discussions de développeurs ajoutent une nuance importante. Une discussion Hacker News sur Qwen 3.8 revient sans cesse sur la consommation de tokens, les reprises et le framework d'agents. Le meilleur modèle est celui qui termine une tâche acceptée avec moins de tentatives échouées et moins de supervision — pas simplement celui qui a le prix le plus bas par million de tokens.
La même prudence s'applique aux publications sociales et aux discussions sur les modèles locaux. Les résultats pour Qwen3.8-27B ou un autre checkpoint Qwen téléchargeable ne sont pas des résultats pour le modèle hébergé qwen3.8-max. Des noms similaires ne rendent pas les modèles équivalents.
Une politique de routage pratique est la suivante :
Envoyez les tâches textuelles de dépôt, de terminal et d'agents longs à GLM 5.3.
Envoyez les tâches de capture d'écran, vidéo, frontend et vérification visuelle à Qwen 3.8 Max.
Gardez une règle de repli pour les appels d'outils échoués ou les sorties à faible confiance.
Revoyez le coût par tâche acceptée chaque semaine, pas seulement la dépense brute en tokens.
Les deux modèles sont disponibles sous une seule clé API et un seul solde GPT Proto, donc ce modèle de routage ne nécessite pas de maintenir deux intégrations de fournisseurs.
Tarification : quel modèle est le plus rentable ?
Aux prix vérifiés le 24 août 2026, GPT Proto liste :
| Modèle |
Entrée / 1M tokens |
Sortie / 1M tokens |
Lecture cache / 1M tokens |
| Qwen 3.8 Max |
$1.80 |
$5.40 |
$0.225 |
| GLM 5.3 |
$1.26 |
$3.96 |
$0.234 |
Qwen liste aussi les écritures de cache à $2.25 par million de tokens. Les deux routes GPT Proto sont 10% en dessous des prix catalogue directs des fournisseurs : Alibaba liste Qwen à $2 en entrée et $6 en sortie, tandis que Z.ai liste GLM à $1.40 en entrée et $4.40 en sortie par million de tokens.
Considérez une charge de travail utilisant 10 millions de tokens d'entrée non mis en cache et 2 millions de tokens de sortie :
GLM économise $8.28, soit environ 28.8%, dans cet exemple. Son avantage augmente lorsque la sortie représente une part importante de la facture. Le prix de lecture du cache de Qwen est toutefois légèrement inférieur, donc une charge de travail qui réutilise fréquemment un grand préfixe stable peut réduire l'écart.
Ne vous arrêtez pas à cette arithmétique. Pour chaque tâche de production, journalisez l'ID du modèle, la catégorie de tâche, les tokens d'entrée, les tokens de sortie, les tokens mis en cache, les tentatives, le résultat des tests, l'acceptation par le réviseur et la latence totale. Divisez la dépense totale par les tâches acceptées. Ce nombre capture les reprises et les échecs que la tarification par token manque.
Raisonnement, latence et contrôle de production
Qwen 3.8 Max offre un contrôle plus explicite sur la quantité de délibération nécessaire à une requête. Ses modes réflexion et non-réflexion permettent à une équipe de séparer les transformations rapides des tâches qui bénéficient d'un raisonnement plus profond. Alibaba documente une entrée maximale de 991,808 tokens en mode standard et de 983,616 tokens en mode réflexion, avec jusqu'à 131,072 tokens de sortie.
GLM 5.3 utilise toujours le raisonnement. Les développeurs peuvent régler son effort sur faible, élevé ou max, max étant la valeur par défaut documentée, mais ne peuvent pas désactiver le raisonnement. Cela peut améliorer la persistance sur les tâches d'agents difficiles tout en rendant les appels triviaux moins prévisibles en latence et en utilisation de tokens.
La décision opérationnelle est donc simple :
Choisissez Qwen lorsque vous avez besoin d'un chemin rapide et d'un chemin de raisonnement derrière un même ID de modèle.
Choisissez GLM lorsque la plupart des requêtes justifient déjà un raisonnement délibéré et que des prix de tokens plus bas comptent.
Évaluez des workflows complets lorsque la latence est une exigence stricte ; la vitesse de génération du modèle seule n'inclut pas l'exécution des outils, les reprises ou le temps d'attente en file.
Essayez les deux via un seul endpoint compatible OpenAI
Le moyen le plus rapide de décider est d'exécuter les mêmes prompts représentatifs via les deux routes. Cette requête cURL utilise l'endpoint Chat Completions compatible OpenAI de GPT Proto :
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "glm-5.3",
    "messages": [
      {
        "role": "user",
        "content": "Review this Python function for correctness and return JSON with issues, fixes, and tests: ..."
      }
    ]
  }'
Changez uniquement la valeur du modèle en qwen3.8-max pour exécuter le même prompt textuel via Qwen. Utilisez un vrai jeu de tâches plutôt que quelques démos attractives : incluez des modifications faciles, des changements de dépôt difficiles, des appels d'outils, des tâches à long contexte et des tâches frontend. Évaluez la justesse, les tests réussis, l'acceptation humaine, la latence et le total de tokens.
Poids ouverts et auto-hébergement ne sont pas la même question
Alibaba publie le checkpoint Qwen3.8-2.4T-A95B, mais ce checkpoint téléchargeable n'est pas identique au service hébergé Qwen 3.8 Max. L'API Max ajoute un contexte d'un million de tokens, une entrée visuelle, un fonctionnement non-réflexion et des capacités d'outils hébergées. Un benchmark local sur une variante Qwen3.8 plus petite ne doit pas être utilisé comme comparaison directe avec Max.
Z.ai a décrit une publication progressive des poids ouverts pour GLM 5.3, mais les poids de GLM 5.3 n'étaient pas téléchargeables publiquement au moment de la rédaction. Les équipes qui prennent une décision de déploiement aujourd'hui devraient évaluer l'API qui existe aujourd'hui, et ne pas supposer que les poids, licences, quantifications ou exigences de service promis sont déjà réglés.
Verdict final
Choisissez GLM 5.3 pour les agents de codage textuels, le travail sur dépôt, les longues tâches pilotées par outils et la facture API plus basse. Choisissez Qwen 3.8 Max pour le codage frontend, les entrées de captures d'écran ou vidéo, les agents visuels et les charges de travail qui nécessitent un raisonnement optionnel.
Si vous avez besoin d'un choix par défaut pour une plateforme de développement, GLM 5.3 offre le meilleur équilibre coût-capacité. Si votre produit passe du code aux interfaces visuelles, la prise en charge des entrées de Qwen et ses résultats de préférence frontend sont plus importants que la petite avance de GLM en intelligence générale.
La meilleure configuration de production peut utiliser les deux : commencez par GLM 5.3 pour les agents textuels, dirigez les tâches visuelles et frontend vers Qwen 3.8 Max, et gardez le modèle qui offre le coût le plus bas par tâche acceptée pour chaque catégorie.