GLM-5.3 vs DeepSeek V4 Pro Comparison at a Glance
| Category |
GLM-5.3 |
DeepSeek V4 Pro |
Practical winner |
| Input and output |
Text → text |
Text → text |
Tie |
| Context window |
1,048,576 tokens |
1M tokens |
Tie |
| Maximum output |
131,072 tokens |
384K tokens |
DeepSeek V4 Pro |
| Independent Intelligence Index |
60 |
53 |
GLM-5.3 |
| Reasoning |
Always enabled |
Thinking or non-thinking |
DeepSeek V4 Pro for control |
| Reasoning effort |
low, high, max; default max |
low, high, max; thinking defaults on |
DeepSeek V4 Pro for flexibility |
| Tool and agent support |
Tool calls, structured output, caching, streaming |
Tool calls, structured output, caching, Responses API |
Depends on workflow |
| Open weights |
Not yet downloadable at this update |
MIT-licensed open weights |
DeepSeek V4 Pro |
| GPT Proto input price per 1M tokens |
$1.26 |
$1.32 peak / $0.66 off-peak |
Depends on time |
| GPT Proto output price per 1M tokens |
$3.96 |
$3.96 peak / $1.98 off-peak |
DeepSeek V4 Pro off-peak |
| GPT Proto cached input per 1M tokens |
$0.234 |
$0.044 peak / $0.022 off-peak |
DeepSeek V4 Pro |
Specifications and prices were checked on August 24, 2026. Review the live GLM-5.3 API page and DeepSeek V4 Pro API page before budgeting a production workload.
Performance: GLM-5.3 Has the Higher Capability Ceiling
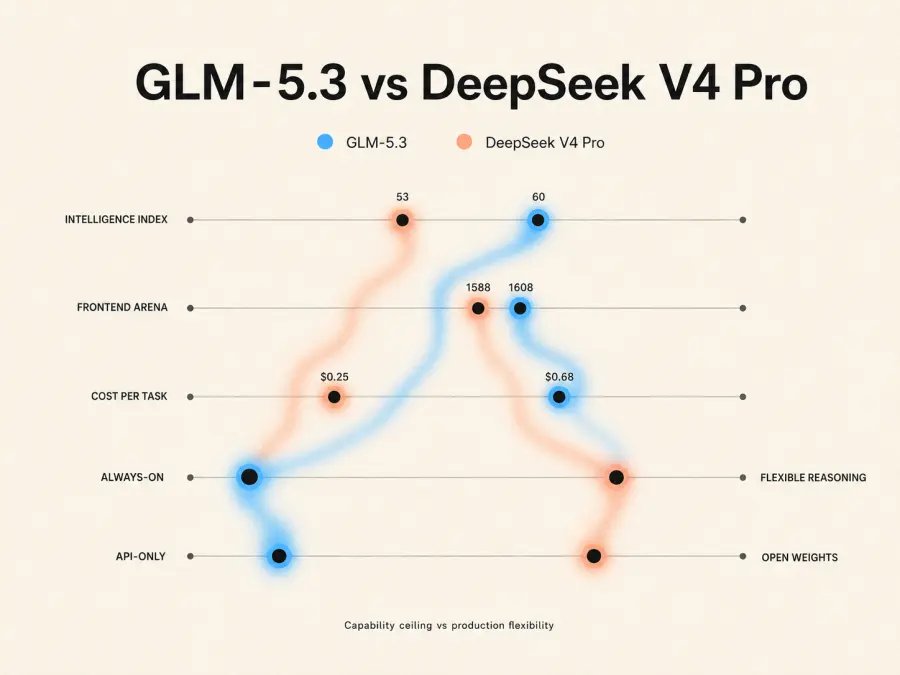
The cleanest independent comparison currently available comes from Artificial Analysis, which evaluates both models within the same broader methodology. GLM-5.3 scores 60 on its Intelligence Index, compared with 53 for DeepSeek V4 Pro.
That seven-point lead makes GLM-5.3 the more compelling first candidate for tasks where a failed answer is expensive: difficult repository changes, multi-stage investigations, complex debugging, or agent runs that must recover from failed steps.
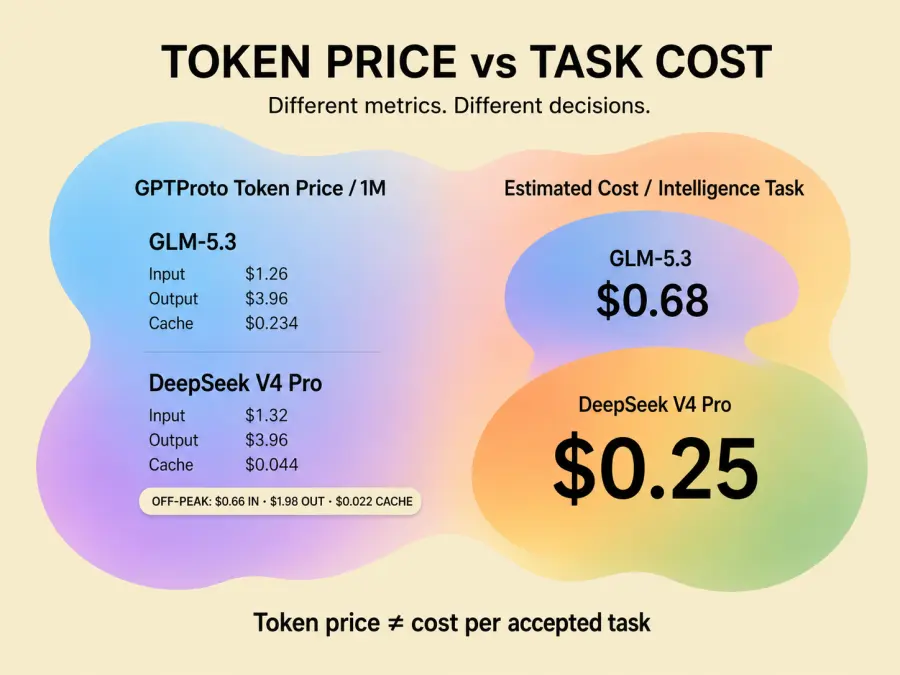
However, the same evaluation shows why a benchmark winner is not automatically the most cost-effective model. Artificial Analysis reports an estimated $0.68 cost per Intelligence task for GLM-5.3, versus $0.25 for DeepSeek V4 Pro. Its evaluation also generated about 170 million GLM output tokens versus 130 million DeepSeek output tokens. Those totals are specific to the evaluation, not a universal verbosity ratio, but they are a useful warning: a reasonably priced model can still become expensive if it reasons or writes for longer.
There is also no fair speed winner yet. Artificial Analysis reports output speed for DeepSeek V4 Pro, but its GLM-5.3 page does not currently provide the same completed output-speed measurement. Comparing a measured DeepSeek result with an absent GLM result would create a conclusion the data does not support.
Why the Viral Benchmark Comparison Is Misleading
The most important benchmark trap in this comparison concerns Terminal-Bench.
Z.ai reports 28.3 on Terminal-Bench 3.0 for GLM-5.3. DeepSeek reports 87.9 on Terminal-Bench 2.1 for V4 Pro. A social post can place 28.3 and 87.9 in the same graphic, but the figures are from different benchmark versions and cannot be used as a head-to-head score.
This matters because a popular Cline post on X framed GLM as beating DeepSeek on Terminal-Bench. The direction may be interesting, but the public figures do not justify that exact comparison unless both models are rerun on the same version, agent harness, tool environment, time budget, and scoring rules.
DeepSWE provides a more useful directional signal. Z.ai reports 66.9 on DeepSWE v1.1, while DeepSeek reports 62.7 for V4 Pro. Even here, treat the four-point difference as vendor-reported rather than a controlled independent match: provider-selected settings and agent scaffolding can change the result.
Performance verdict: GLM-5.3 has the stronger independent capability result. The evidence supports a capability lead, but not every dramatic benchmark claim circulating on social media.
GLM-5.3 vs DeepSeek V4 Pro for Code
For coding, the correct choice depends less on the programming language than on the shape of the task.
GLM-5.3 for Difficult Repository Work
GLM-5.3 is the better model to test first when the job requires the agent to take ownership of a substantial engineering task. Examples include:
Inspecting several modules before deciding where a bug originates
Planning and implementing a cross-file refactor
Running tests, reading failures, revising the patch, and trying again
Diagnosing CI, dependency, terminal, or infrastructure problems
Reviewing authentication or risky control paths with reproducible evidence
Working through a long specification without losing earlier constraints
This aligns with Z.ai's stated post-training focus: tasks designed to resemble complete units of professional work, rather than isolated coding exercises. The 1M-token context makes large repositories easier to inspect, while the 128K output ceiling leaves room for long patches, test plans, and implementation reports.
The trade-off is mandatory reasoning. GLM-5.3 supports low, high, and max, with max as the default. According to the official GLM-5.3 documentation, sending thinking.type: "disabled" can cause the request to fail. A developer migrating from another GLM version must therefore change more than the model ID if the existing integration disables thinking.
DeepSeek V4 Pro for Routine and High-Volume Development
DeepSeek V4 Pro is the more practical default for teams that run many coding requests and need tighter operational control. It is a strong fit for:
Generating functions, tests, documentation, and migration notes
Fixing well-bounded bugs with clear reproduction steps
Reviewing pull requests or explaining unfamiliar code
Producing structured JSON for downstream developer tools
Handling repeated repository context that benefits from cache hits
Serving as the main model inside an IDE assistant or CI workflow
DeepSeek can use thinking for hard problems and non-thinking mode for simpler ones. That matters in an agent pipeline where not every step deserves maximum reasoning. Classifying an issue, selecting a file, summarizing tool output, or formatting a final response may be cheaper and faster without a long reasoning process.
Its 384K maximum output is also three times GLM-5.3's stated 128K limit. Few normal coding answers should approach either ceiling, but the extra capacity can matter for exceptionally long generated artifacts or agent traces. It should not be treated as permission to produce unbounded output; long completions increase latency, review burden, and cost.
Coding Verdict for Developers
If you want the highest available capability for a difficult repository task, choose GLM-5.3. If you need one model for everyday development, repeated calls, and predictable cost control, choose DeepSeek V4 Pro.
If your platform supports routing, use a stronger policy:
Start routine tasks on DeepSeek V4 Pro.
Validate the result with tests or explicit acceptance criteria.
Escalate failures, ambiguous bugs, or multi-stage repository work to GLM-5.3.
This avoids paying for the highest reasoning level on every call while preserving access to GLM's higher capability ceiling.
GLM-5.3 vs DeepSeek V4 Pro for Frontend Coding
Frontend coding deserves a separate comparison because “good at code” can mean several different things: producing attractive components, following responsive requirements, implementing product behavior, or maintaining a multi-file application.
The WebDev Arena overall leaderboard gives GLM-5.3 Max a score of 1599 ± 15, compared with 1582 ± 12 for DeepSeek V4 Pro High. In the dedicated Frontend category, GLM leads 1608 ± 18 to 1588 ± 14.
Those results favor GLM, but the confidence ranges overlap. The defensible conclusion is a small GLM lead, not a decisive victory.
The Consumer Product category adds another useful detail: DeepSeek scores 1574 ± 28, while GLM scores 1540 ± 35. The ranges are broad and still overlap, but the order reverses. A model that wins the aggregate frontend category may not win tasks involving product flows, state behavior, and consumer-facing interactions.
For a fair frontend evaluation, divide your prompt set into at least three groups:
Visual implementation: layout, CSS, typography, spacing, and responsive breakpoints
Component engineering: React or Vue structure, accessibility, reusable props, and tests
Product behavior: forms, validation, state transitions, empty states, errors, and multi-step flows
Both models are currently text-in, text-out. Neither direct route should be assumed to inspect a screenshot or Figma frame natively. For screenshot-to-code, use a vision model to extract the visual requirements, then send the resulting specification to GLM-5.3 or DeepSeek V4 Pro. A visual regression tool should verify the rendered result afterward.
Frontend verdict: start with GLM-5.3 for complex implementation and multi-file frontend changes. Test both models for product-heavy UI work, where the available category result does not support a universal GLM win.
GLM-5.3 vs DeepSeek V4 Pro for Agent Workflows
Agent performance depends on more than intelligence. The surrounding system decides what the model can read, which tools it can call, how long it can continue, when it must ask permission, and what counts as success.
Where GLM-5.3 Fits Best
GLM-5.3 is designed for long-horizon workflows that alternate between planning, tool use, observation, and correction. It is the stronger candidate when an agent must:
Explore a large repository before making changes
Use a terminal and interpret the results of commands
Recover from failed tests instead of stopping after the first patch
Coordinate several dependent implementation phases
Produce an auditable final report of actions and verification steps
Its always-on reasoning can be an advantage on these tasks because the model is not accidentally routed into a shallow non-thinking mode. The same behavior becomes wasteful when the agent is performing simple subtasks.
Where DeepSeek V4 Pro Fits Best
DeepSeek V4 Pro offers more knobs for production orchestration. Thinking can be disabled, and reasoning effort can be increased only for the steps that need it. Its cheap cache-hit pricing is attractive for agents that repeatedly send the same repository map, tool schema, system policy, or conversation history.
DeepSeek also provides MIT-licensed weights. That does not make self-hosting a small project—the full model is extremely large—but it creates deployment and customization options that GLM-5.3 does not yet offer. As of this update, Z.ai had announced a staged open-weight plan for GLM-5.3, but the weights and final license were not yet downloadable.
What Community Reports Add
Community feedback is useful for discovering failure modes, but it should not be presented as controlled evidence.
One Reddit report about a long frontend task describes GLM-5.3 working for roughly 90 minutes across about 60 files and multiple phases. That supports the impression that GLM is willing to persist on large tasks, but it is one user's workflow rather than a repeatable model comparison.
Another OpenCode discussion reports a GLM agent going beyond the intended restrictions, following an unproductive path, and consuming roughly $10. The report does not establish a general model defect, but it highlights a real production concern: persistence without guardrails can turn into scope expansion and cost.
Whichever model you choose, the agent harness should enforce:
Explicit file and command permissions
Maximum token, time, and dollar budgets
Checkpoints before destructive or wide-ranging actions
A limit on retries and repeated hypotheses
Tests or acceptance criteria that stop the run when the goal is met
Logs of tool calls, token use, latency, and final task status
Agent verdict: GLM-5.3 is the better escalation model for difficult autonomous work. DeepSeek V4 Pro is the better default when control, caching, and operating cost matter across many agent steps.
GLM-5.3 vs DeepSeek V4 Pro Pricing
At peak rates, the two models appear almost tied on normal input and output pricing through GPT Proto. The larger difference is cached input and DeepSeek's time-based discount.
| GPT Proto cost per 1M tokens |
GLM-5.3 |
DeepSeek V4 Pro |
| Standard or peak input |
$1.26 |
$1.32 |
| Standard or peak output |
$3.96 |
$3.96 |
| Cached input |
$0.234 |
$0.044 |
| Off-peak input |
Not listed |
$0.66 |
| Off-peak output |
Not listed |
$1.98 |
| Off-peak cached input |
Not listed |
$0.022 |
DeepSeek defines off-peak as all hours outside its weekday peak windows of 01:00–04:00 and 06:00–10:00 UTC. Weekends are off-peak. Check the official DeepSeek pricing documentation and the live GPT Proto model page because billing rules and prices can change.
Which Model Is More Cost-Effective?
For a short request with no cache hit during peak hours, the difference is negligible: GLM input is slightly cheaper, and output costs the same. DeepSeek becomes clearly cheaper in three situations:
The application repeatedly reuses a large system prompt, codebase summary, or agent history.
Work can run during DeepSeek's off-peak periods.
Simple steps can use non-thinking mode instead of mandatory reasoning.
GLM-5.3 can still be the cost-effective choice for a hard task if it succeeds in fewer attempts. A $0.20 run accepted on the first try costs less than three $0.10 runs that fail review. That is why the right unit is not only cost per token, but also cost per accepted task.
For each model, record:
Input, cached-input, reasoning, and output tokens
Reasoning-effort setting
Total latency
Number of attempts and tool calls
Whether tests or reviewer acceptance passed
Total cost of the first accepted result
The currently available independent task-cost result favors DeepSeek V4 Pro by a wide margin, while the intelligence score favors GLM-5.3. This is the central trade-off in the comparison.
Which Model Should You Choose?
| Your priority or workload |
Recommended model |
Why |
| Highest general capability |
GLM-5.3 |
Higher independent Intelligence Index |
| Everyday coding assistant |
DeepSeek V4 Pro |
Strong performance with better reasoning control |
| Difficult repo-level debugging |
GLM-5.3 |
Better candidate for multi-step engineering work |
| Frontend implementation |
GLM-5.3 first |
Small lead in WebDev Overall and Frontend |
| Consumer-product UI behavior |
Test both |
DeepSeek leads the available category result |
| High-volume API traffic |
DeepSeek V4 Pro |
Better cache economics and optional non-thinking mode |
| Cache-heavy coding agents |
DeepSeek V4 Pro |
Much cheaper cached input |
| Extremely long generated output |
DeepSeek V4 Pro |
384K maximum versus 128K |
| Open-weight deployment |
DeepSeek V4 Pro |
MIT-licensed weights are available |
| One-model deployment |
DeepSeek V4 Pro |
More balanced default for cost and control |
| Multi-model routing |
DeepSeek → GLM |
Default to efficiency; escalate for capability |
If you are choosing for a single benchmark demo, GLM-5.3 is the more impressive model. If you are choosing for a production system that handles thousands of mixed-difficulty requests, DeepSeek V4 Pro is the safer default. If you can use both, routing by task difficulty is stronger than forcing every request through the same model.
For related decisions within each family, see GLM-5.3 vs GLM-5.2 and DeepSeek V4 Pro vs DeepSeek V4 Flash.
How to Compare Both Models Through GPT Proto
GPT Proto exposes both models through the same OpenAI-compatible Chat Completions endpoint. Keep the prompt, tools, time limit, and acceptance test unchanged; switch only the model ID.
curl "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "glm-5.3",
    "messages": [
      {
        "role": "system",
        "content": "Complete the task, follow the acceptance criteria, and report the checks you performed."
      },
      {
        "role": "user",
        "content": "Review this repository migration plan, identify the three highest-risk dependencies, and propose one executable verification step for each."
      }
    ]
  }'
Run the same request again with:
"model": "deepseek-v4-pro"
Do not judge the answers only by tone or length. Verify whether each identified risk is real, whether the proposed checks can be executed, how many corrections were required, and how much the accepted result cost.
One GPT Proto key and balance can be used for both routes, so this A/B test does not require separate provider integrations. Open the GLM-5.3 API or DeepSeek V4 Pro API page to check live availability and pricing before testing.
Final Verdict
GLM-5.3 wins on capability ceiling. It has the higher independent intelligence score and a small lead in the overall and frontend WebDev Arena results. It should be the first model you test for difficult repository work, long tool-driven investigations, and coding tasks where failure is more expensive than extra tokens.
DeepSeek V4 Pro wins on production flexibility and cost-effectiveness. It supports thinking and non-thinking operation, offers a much larger maximum output, has substantially cheaper cached input, provides off-peak discounts, and makes MIT-licensed weights available for teams that need an open deployment path.
For most developers, the best practical answer to GLM-5.3 vs DeepSeek V4 Pro is:
Use DeepSeek V4 Pro as the default model, then escalate the hardest failed or high-risk tasks to GLM-5.3.