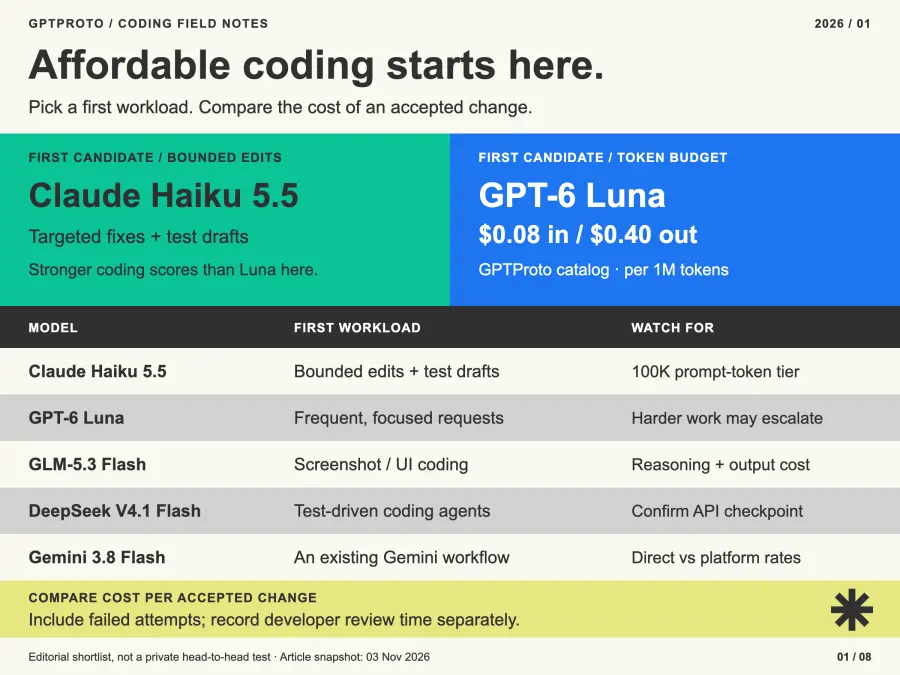
Aperçu des LLM de codage abordables
| Modèle |
Première charge de travail à évaluer |
Principal compromis |
| Claude Haiku 5.5 |
Modifications de code délimitées, ébauches de tests et sous-tâches de codage |
Son niveau de prix bas s'arrête au-delà de 100 000 jetons de prompt |
| GPT-6 Luna |
Requêtes de codage fréquentes et à portée limitée |
Le travail complexe sur les dépôts peut nécessiter une escalade |
| GLM-5.3 Flash |
Tâches de codage impliquant des captures d'écran ou des références d'interface utilisateur |
L'effort de raisonnement et la longueur de sortie affectent la facture |
| DeepSeek V4.1 Flash |
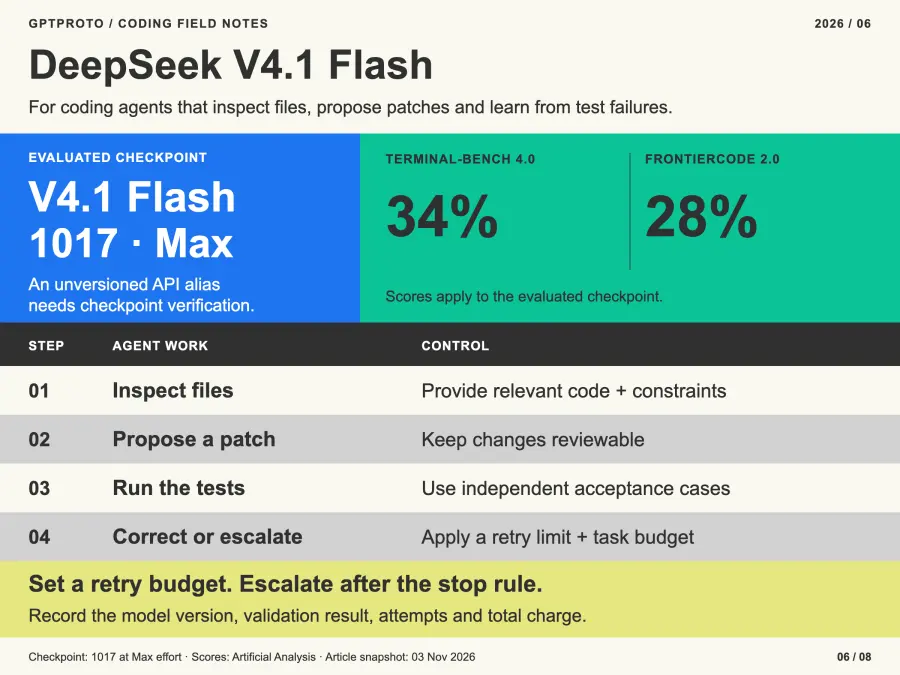
Agents de codage avec tests et limites de tentatives |
Confirmez le point de contrôle servi par l'alias de l'API |
| Gemini 3.8 Flash |
Codage au sein d'un flux de travail Gemini existant |
Les tarifs promotionnels des fournisseurs directs diffèrent des devis des plateformes |
Si vous choisissez le fournisseur ainsi que le modèle, notre comparaison des plateformes d'API IA pour les développeurs couvre les questions plus larges d'accès, de facturation, d'intégration et de contrôles de production.
Comment nous comparons le coût et la capacité de codage
Un modèle de codage LLM abordable doit avoir une capacité suffisante pour la tâche avant que son prix par jeton ne devienne utile. Nous donnons la priorité aux preuves spécifiques au codage, puis nous vérifions le coût de la charge de travail, les niveaux de contexte, la compatibilité des outils et une page de modèle GPT Proto disponible.
Les résultats suivants proviennent d'Artificial Analysis. Terminal-Bench 4.0 évalue le codage agentique et l'utilisation du terminal ; FrontierCode 2.0 évalue l'ingénierie logicielle dans les dépôts open-source. Différentes configurations peuvent modifier les résultats, c'est pourquoi le paramètre évalué est indiqué à côté de chaque modèle.
| Modèle évalué |
Terminal-Bench 4.0 |
FrontierCode 2.0 |
| Claude Haiku 5.5 Max |
33 % |
35 % |
| GPT-6 Luna Max |
13 % |
25 % |
| GLM-5.3 Flash tel qu'indiqué |
33 % |
18 % |
| DeepSeek V4.1 Flash 1017 Max |
34 % |
28 % |
| Gemini 3.8 Flash High |
20 % |
19 % |
Les comparaisons sous-jacentes sont Haiku contre Luna, DeepSeek contre GLM Flash et Haiku contre Gemini. Ces pourcentages décrivent ces évaluations, et non le taux de réussite attendu de votre dépôt. Ils n'établissent pas non plus la latence ou la disponibilité de GPT Proto.
Les estimations de prix ci-dessous maintiennent l'utilisation des jetons constante pour exposer l'arithmétique de facturation. Les modèles réels peuvent utiliser des nombres de jetons différents pour le même prompt, surtout lorsque le raisonnement est activé.
Les 5 meilleurs LLM abordables pour le codage
1. Claude Haiku 5.5 pour les tâches de codage délimitées
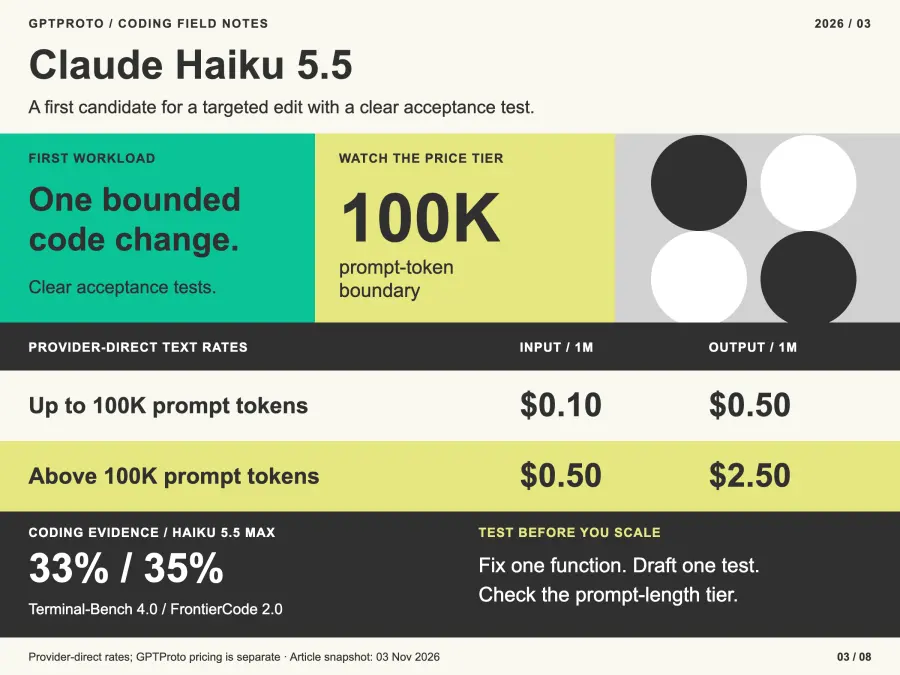
Claude Haiku 5.5 est notre premier candidat pour une modification ciblée avec un test d'acceptation clair et une invite inférieure à 100 000 jetons. Ses résultats en matière de codage justifient une évaluation avant de payer pour un modèle Claude plus important.
L'annonce de sortie d'Anthropic positionne Haiku comme un modèle destiné aux tâches répétitives et aux sous-tâches de codage, aux côtés de Sonnet et Opus. Cela suggère un périmètre de départ pratique : corriger une fonction, rédiger un test ou enquêter sur une défaillance isolée.
La limite de coût importante est la longueur de l'invite. Les tarifs d'entrée/sortie en amont passent de 0,10 $/0,50 $ à 0,50 $/2,50 $ par million de jetons au-delà de 100 000 jetons d'invite. Une grande fenêtre de contexte ne rend pas le niveau le plus économique disponible sur l'ensemble de cette fenêtre.
2. GPT-6 Luna pour les requêtes fréquentes et ciblées
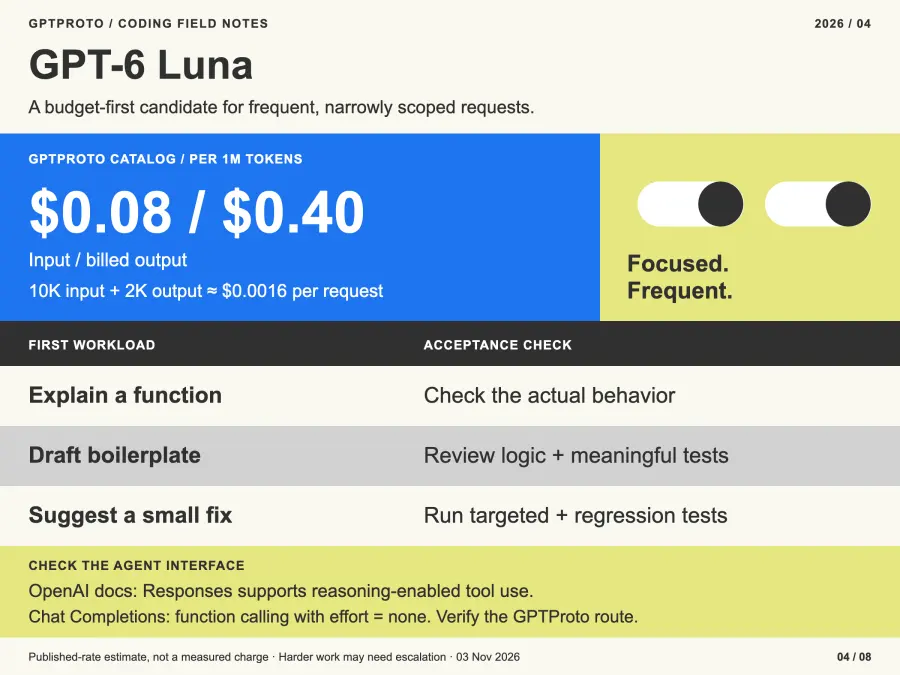
GPT-6 Luna est le candidat privilégiant le budget pour les requêtes répétées et limitées : expliquer une fonction, rédiger du code standard ou suggérer une petite correction que des tests existants peuvent évaluer.
Son tarif catalogue GPT Proto publié est de 0,08 $ en entrée et 0,40 $ en sortie par million de jetons. Les scores de codage publics sont inférieurs à ceux de Haiku, nous ferions donc en sorte que Luna joue un rôle plus large grâce à une évaluation spécifique à la tâche.
Vérifiez la surface d'intégration lors de la création d'un agent. La documentation du modèle OpenAI spécifie l'utilisation d'outils activés par le raisonnement via les réponses ; les complétions de chat permettent l'appel de fonctions avec un effort de raisonnement défini sur aucun. Confirmez ce que la route GPT Proto expose avant de traiter le changement de modèle comme une simple modification de configuration.
3. GLM-5.3 Flash pour le codage visuel économique
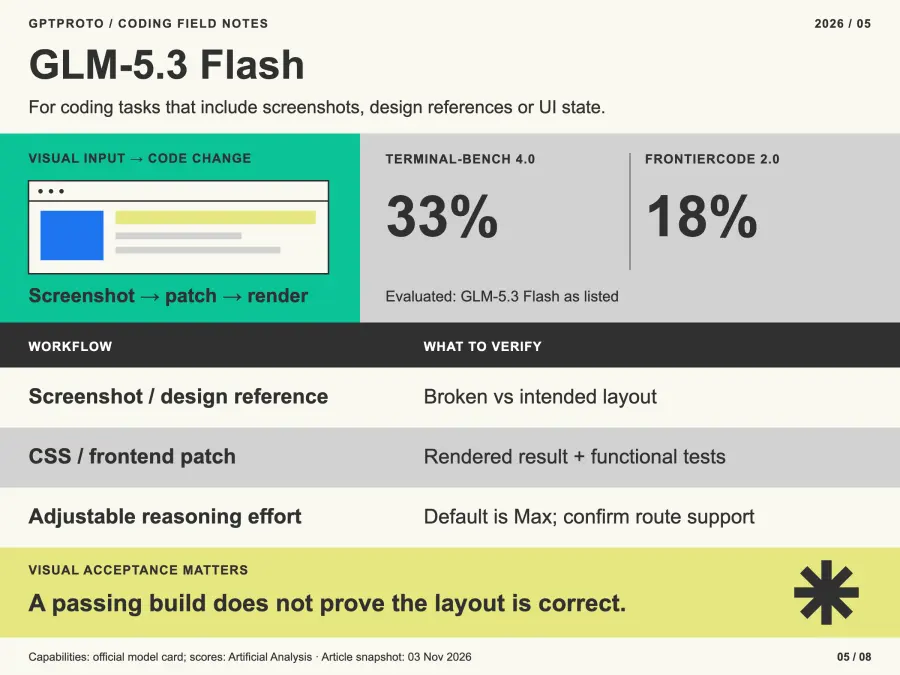
GLM-5.3 Flash a sa place dans la liste restreinte lorsqu'une tâche de codage inclut une capture d'écran, une référence de conception ou une interface rendue. Par exemple, un assistant frontend peut avoir besoin de comparer une mise en page défectueuse avec l'état souhaité avant de proposer des modifications CSS.
La fiche officielle du modèle GLM-5.3 Flash documente l'entrée multimodale, les poids ouverts et l'effort de raisonnement réglable. Son effort par défaut publié est au maximum. N'utilisez un autre paramètre qu'après avoir vérifié comment la route hébergée le prend en charge.
Ses deux scores de codage diffèrent considérablement. C'est une raison pour tester votre combinaison de tâches plutôt que de traiter un benchmark terminal comme un classement universel d'édition de code. Les correctifs visuels nécessitent également une comparaison rendue ; la compilation seule ne peut pas établir que la mise en page est correcte.
4. DeepSeek V4.1 Flash pour les agents de codage pilotés par les tests
DeepSeek Flash mérite d'être évalué pour les agents qui inspectent des fichiers, proposent des modifications, reçoivent des échecs de tests et réessayent dans le cadre d'un budget défini.
L'annonce de sortie du 17 octobre décrit des améliorations en matière de performances de codage, de vitesse d'exécution des tâches et de longueur de sortie. Les résultats indépendants de notre tableau se réfèrent spécifiquement à la version V4.1 Flash 1017 en mode « Max effort ». Un alias sans version ne prouve pas, en soi, que votre plateforme utilise ce point de contrôle spécifique ; enregistrez la version résolue lorsque cela est possible.
Pour une vue d'ensemble plus large de DeepSeek, GLM, Qwen et Kimi, consultez notre comparatif des LLM chinois pour le codage. Gardez les candidats les plus robustes à disposition lorsqu'une modification complexe de dépôt épuise l'option budgétaire.
5. Gemini 3.8 Flash pour les flux de travail Gemini existants
Gemini 3.8 Flash est un candidat à envisager si votre application utilise déjà Gemini ou combine du code avec du matériel visuel. Évaluez-le dans ce flux de travail existant avant d'ajouter une autre intégration spécifique à un fournisseur.
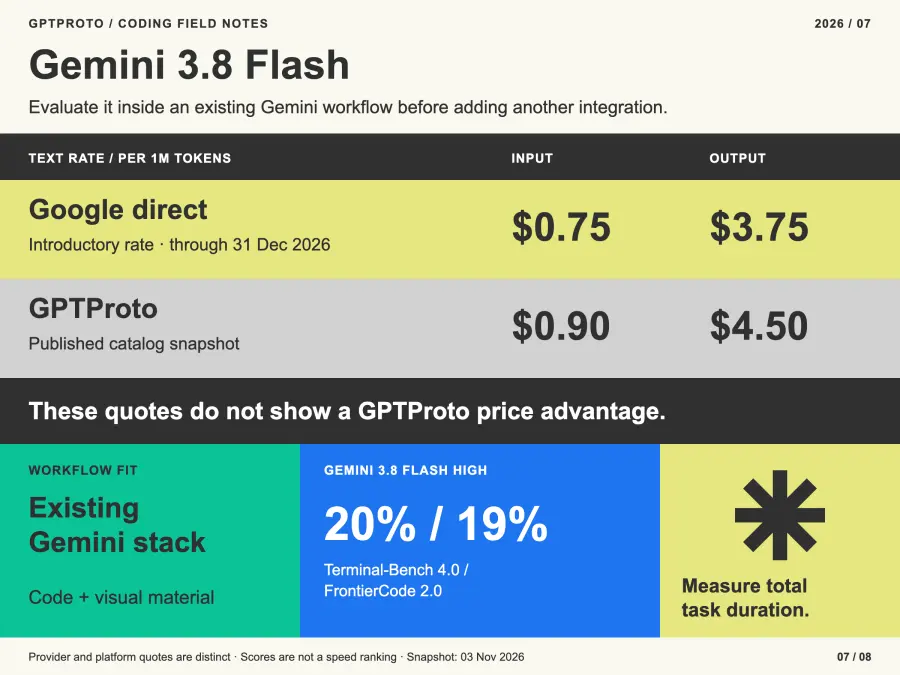
La mise à jour du modèle de Google documente une capacité de réflexion ajustable et un tarif d'introduction direct fournisseur de 0,75 $ en entrée / 3,75 $ en sortie par million de jetons jusqu'au 31 décembre 2026. L'instantané du catalogue GPT Proto publié indique 0,90 $ / 4,50 $. Ces chiffres ne permettent pas d'affirmer que GPT Proto est moins cher que la promotion actuelle de Google.
Nous inclurions Gemini pour son adéquation avec les flux de travail, et non pour lui décerner un titre de vitesse basé sur le terme « Flash ». Mesurez le temps nécessaire pour obtenir une réponse exploitable ainsi que la durée totale de la tâche sur vos invites.
Comparaison des tarifs de l'API LLM pour le codage
Ce tableau utilise les tarifs publics directs des fournisseurs dans les conditions indiquées, et non les tarifs de facturation de GPT Proto. Le fait de rendre la source et la charge de travail explicites permet de rendre la comparaison reproductible.
La petite requête contient 10 000 jetons d'entrée et 2 000 jetons de sortie facturés. La référence du référentiel contient 200 000 jetons d'entrée et 20 000 jetons de sortie facturés. Les deux supposent l'absence de cache ; la sortie facturée doit inclure les jetons de raisonnement le cas échéant.
| Modèle et condition tarifaire |
Entrée / sortie pour 1M de jetons |
Petite requête |
Référence du référentiel |
| Haiku 5.5 jusqu'à 100K jetons de prompt |
0,10 $ / 0,50 $ |
0,0020 $ |
Utiliser le niveau suivant |
| Haiku 5.5 au-delà de 100K jetons de prompt |
0,50 $ / 2,50 $ |
Non applicable |
0,1500 $ |
| GPT-6 Luna dans son niveau de contexte de base |
0,10 $ / 0,50 $ |
0,0020 $ |
0,0300 $ |
| GLM-5.3 Flash au tarif standard publié |
0,15 $ / 0,50 $ |
0,0025 $ |
0,0400 $ |
| DeepSeek Flash au tarif de pointe en amont |
0,30 $ / 1,20 $ |
0,0054 $ |
0,0840 $ |
| Gemini 3.8 Flash au tarif direct d'introduction |
0,75 $ / 3,75 $ |
0,0150 $ |
0,2250 $ |
Les preuves tarifaires proviennent de la documentation des modèles liés et des comparaisons indépendantes ci-dessus. Les notes de version de DeepSeek confirment que les tarifs des jetons hors pointe sont la moitié des tarifs de pointe. Luna applique des tarifs plus élevés pour la requête complète au-delà de 272K jetons d'entrée. Les tarifs d'introduction de Gemini se terminent en 2026. Vérifiez la route et la date applicables avant d'établir votre budget.
Pour l'accès à GPT Proto, utilisez le panneau de tarification en direct sur les pages des modèles liés. Deux exemples de catalogue clairs sont Luna à 0,08 $/0,40 $ et Haiku à 0,09 $/0,45 $ dans le niveau de prix bas. La même petite requête est estimée à 0,0016 $ et 0,0018 $ respectivement. Il s'agit de calculs basés sur les tarifs publiés, et non de frais mesurés.
Pour une petite application effectuant 10 000 petites requêtes par mois, l'exemple Luna ou Haiku de niveau inférieur en amont totalise 20 $ avant les tentatives et autres frais. Cette estimation cesse d'être utile si l'application envoie une quantité différente de contexte ou génère des sorties beaucoup plus longues.
La mise en cache nécessite son propre calcul : ajoutez l'entrée non mise en cache, les lectures de cache, toute écriture ou stockage de cache, et la sortie facturée. Un préfixe de référentiel stable peut aider, mais la modification du prompt ou l'absence de cache modifie les économies.
Le test Haiku 5.5 de Simon Willison fournit un exemple concret de la façon dont différents paramètres d'effort modifient le temps et le coût. Il traite également des changements de tokenizer. La leçon pour la budgétisation est de mesurer l'utilisation réelle plutôt que de supposer que chaque modèle facture le même nombre de jetons pour un texte identique.
Quel modèle correspond à votre tâche de codage
| Tâche |
Candidats initiaux |
Vérification d'acceptation |
| Modification de code ou correction de bug ciblée |
Haiku 5.5 et Luna |
Tests ciblés et tests de régression existants |
| Rédaction de tests unitaires ou de code récurrent (boilerplate) |
Luna et Haiku 5.5 |
Vérifier les assertions et valider les cas d'échec significatifs |
| Correction d'interface frontend |
GLM-5.3 Flash et Gemini 3.8 Flash |
Comparaison du rendu et tests fonctionnels |
| Agent de codage multi-étapes |
DeepSeek Flash et Haiku 5.5 |
Tâche terminée, appels d'outils valides, nombre de tentatives et coût total |
Ce sont des points de départ pour l'évaluation. Un test généré qui répète simplement l'hypothèse erronée du modèle peut réussir alors que la fonctionnalité reste défectueuse. Conservez des cas d'acceptation indépendants et inspectez les modifications apportées aux tests eux-mêmes.
Pour les agents qui effectuent également des recherches documentaires, classifient des requêtes ou gèrent des tâches de support, notre guide des API LLM abordables pour les agents IA couvre un éventail de charges de travail plus large.
Quand un modèle de codage premium est justifié
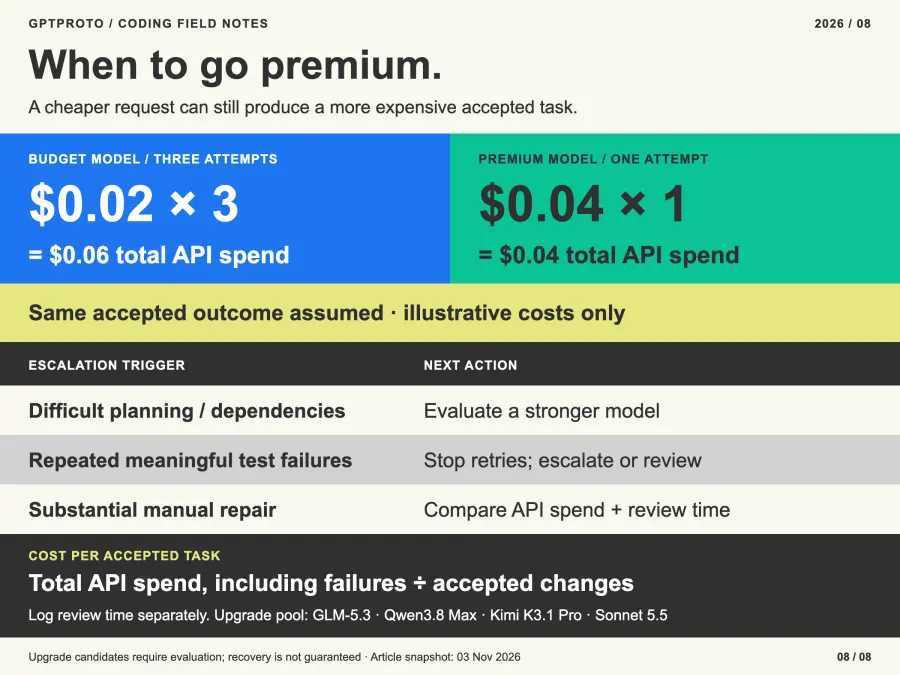
Passez à un modèle supérieur lorsque la tâche nécessite une planification complexe, échoue de manière répétée à des tests significatifs ou demande une réparation manuelle substantielle. GLM-5.3, Qwen3.8 Max, Kimi K3.1 Pro et Claude Sonnet 5.5 peuvent constituer un pool d'évaluation distinct pour ce travail. Leur inclusion ici est une piste d'amélioration à explorer, et non une garantie qu'ils résoudront systématiquement les tâches ayant échoué avec des modèles économiques.
Utilisez le coût par tâche acceptée : dépense totale en API pour l'évaluation divisée par le nombre de changements acceptés. Incluez les dépenses liées aux tentatives infructueuses. Enregistrez le temps de revue séparément afin qu'une facture API basse ne masque pas un nettoyage coûteux par les développeurs.
Pour une comparaison illustrative, trois tentatives à 0,02 $ coûtent 0,06 $. Une tentative à 0,04 $ qui termine la même tâche immédiatement coûte moins cher au total. Vos taux de réussite mesurés détermineront si ce compromis est avantageux.
Comment utiliser les modèles économiques sans tentatives infinies
Définissez la vérification d'acceptation et la règle d'arrêt avant la première requête. Une politique de départ pratique consiste à effectuer une tentative initiale, une correction basée sur l'échec du test, puis une escalade ou une revue humaine. Ajustez cette politique en fonction des résultats observés et du budget alloué à la tâche.
L'application doit enregistrer le modèle et le point de contrôle, les paramètres de raisonnement, l'utilisation des jetons, le temps écoulé, le résultat de la validation et la charge totale. Le modèle propose un correctif ; votre exécuteur lance les tests ; votre logique de routage décide de la suite des opérations.
Une API multi-modèles simplifie l'accès et la facturation. La réussite des tests, le routage conscient du budget et l'escalade automatique nécessitent toujours des fonctionnalités de plateforme vérifiées ou une logique applicative. Notre guide des passerelles IA pour les développeurs compare les différentes couches d'accès et de contrôle.
Essayez un modèle de codage abordable via GPT Proto
Ouvrez la page d'un modèle présélectionné, choisissez Essayer ce modèle, et examinez le démarrage rapide et la tarification actuels. Préparez une clé API et un solde. Si le panneau propose Copier le Markdown pour l'IA, transmettez ce guide à votre assistant de codage avec la tâche et les critères d'acceptation. Gardez la clé réelle dans votre environnement local ou votre gestionnaire de secrets serveur.
Pour un premier exercice reproductible, corrigez cette fonction de pagination : les pages commencent à un, page et per_page sont des entiers, les valeurs inférieures à un doivent lever une ValueError, et la liste d'entrée doit rester inchangée.
Enregistrez ce qui suit sous le nom request_patch.py dans un nouveau dossier de travail. Il utilise la bibliothèque standard de Python, demande une fonction candidate, vérifie sa syntaxe et l'enregistre pour examen. Il n'exécute pas le code renvoyé.
import ast
import json
import os
import time
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.request import Request, urlopen

key = os.environ.get("GPTPROTO_API_KEY")
if not key:
    raise SystemExit("Définissez GPTPROTO_API_KEY dans votre environnement.")

source = """def paginate(items, page, per_page):
    start = page * per_page
    return items[start:start + per_page]
"""
task = (
    "Corrigez paginate. Les pages commencent à un. page et per_page sont "
    "des entiers ; levez une ValueError si l'un ou l'autre est inférieur à 1. Retournez une "
    "liste vide au-delà de la dernière page. Ne modifiez pas items. Gardez "
    "la signature. Retournez uniquement la fonction, sans Markdown "
    "ou explications.\n\n" + source
)
payload = {
    "model": os.environ.get("GPTPROTO_MODEL", "gpt-6-luna"),
    "messages": [{"role": "user", "content": task}],
}
request = Request(
    "https://gptproto.com/v1/chat/completions",
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Authorization": f"Bearer {key}",
        "Content-Type": "application/json",
    },
    method="POST",
)
started = time.perf_counter()
try:
    with urlopen(request, timeout=60) as response:
        result = json.load(response)
except HTTPError as exc:
    raise SystemExit(f"L'API a renvoyé une erreur HTTP {exc.code}.") from exc
except (URLError, TimeoutError) as exc:
    raise SystemExit("La requête a échoué ou a expiré.") from exc

try:
    code = result["choices"][0]["message"]["content"]
except (KeyError, IndexError, TypeError) as exc:
    raise SystemExit("Aucun texte candidat dans la réponse de l'API.") from exc
if not isinstance(code, str) or not code.strip():
    raise SystemExit("La réponse ne contenait aucun code Python.")
code = code.strip()
try:
    ast.parse(code)
except SyntaxError as exc:
    raise SystemExit("Examinez la réponse ; ce n'est pas du Python pur.") from exc

Path("candidate.py").write_text(code + "\n", encoding="utf-8")
print("candidate.py enregistré. Examinez-le avant d'exécuter les tests.")
print("Secondes :", round(time.perf_counter() - started, 2))
print("Utilisation :", json.dumps(result.get("usage", {})))
Enregistrez ces vérifications d'acceptation sous le nom test_candidate.py :
import unittest
from candidate import paginate


class PaginationTests(unittest.TestCase):
    def test_pages(self):
        items = [0, 1, 2, 3, 4]
        self.assertEqual(paginate(items, 1, 2), [0, 1])
        self.assertEqual(paginate(items, 2, 2), [2, 3])
        self.assertEqual(paginate(items, 3, 2), [4])
        self.assertEqual(paginate(items, 4, 2), [])
        self.assertEqual(items, [0, 1, 2, 3, 4])

    def test_empty_input(self):
        self.assertEqual(paginate([], 1, 2), [])

    def test_invalid_values(self):
        for page, per_page in [(0, 2), (-1, 2), (1, 0), (1, -1)]:
            with self.subTest(page=page, per_page=per_page):
                with self.assertRaises(ValueError):
                    paginate([0, 1], page, per_page)


if __name__ == "__main__":
    unittest.main()
Une fois la clé d'environnement configurée, exécutez python request_patch.py. Examinez candidate.py, puis exécutez python -m unittest -v test_candidate.py. Une vérification de syntaxe établit uniquement que Python peut analyser la sortie ; les tests évaluent le comportement déclaré. Ce petit exercice n'est pas un benchmark à l'échelle d'un dépôt.
Répétez l'opération avec un autre ID de modèle documenté via GPTPROTO_MODEL. Enregistrez les échecs ainsi que les réussites, et utilisez l'utilisation renvoyée avec le tarif de facturation applicable pour comparer les coûts. Un délai d'attente ou une tentative échouée doit tout de même figurer dans le rapport d'évaluation.
Choisissez une tâche précise, gardez ses critères d'acceptation fixes et comparez deux candidats. Ouvrez la page de l'API Claude Haiku 5.5 ou la page de l'API GPT-6 Luna pour consulter les tarifs actuels et lancer votre première requête de codage.