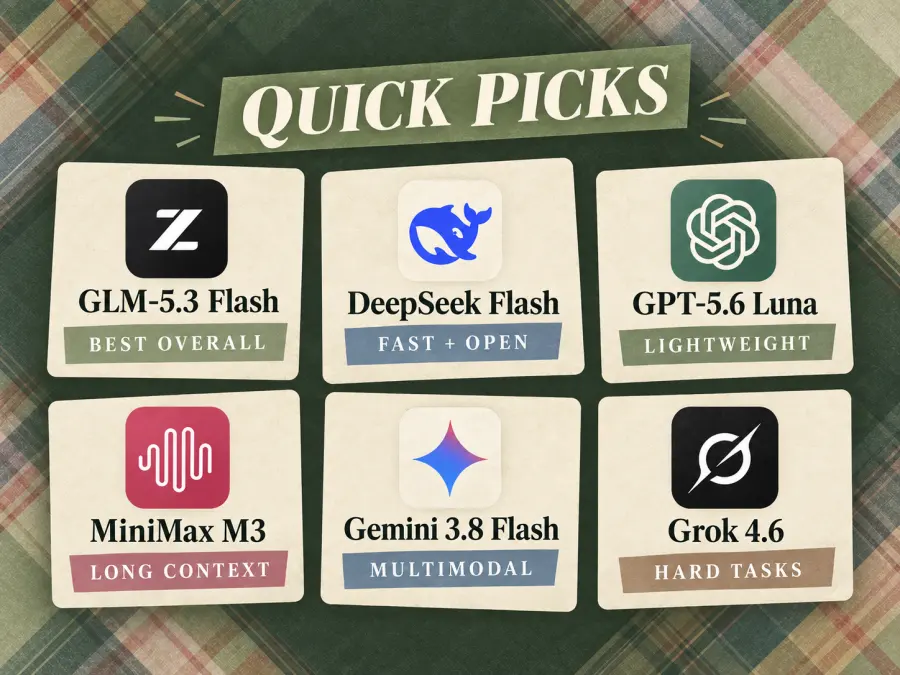
Les API LLM abordables pour agents en un coup d'œil
| Rang |
Modèle |
Chaîne de modèle GPT Proto |
Prix d'entrée/sortie GPT Proto par million de tokens |
Contexte |
Idéal pour |
| 1 |
GLM-5.3 Flash |
glm-5.3-flash |
$0.15 / $0.50 |
Jusqu'à 1M |
Meilleure API agent abordable globale |
| 2 |
DeepSeek Flash |
deepseek-flash |
$0.30 / $1.20 |
Jusqu'à 1M |
Agents rapides, à poids ouverts, gourmands en entrée |
| 3 |
GPT-5.6 Luna |
gpt-5.6-luna |
Confirmez le tarif GPT Proto en direct avant publication |
Environ 1M |
Appels d'agents légers et à grand volume |
| 4 |
MiniMax M3 |
MiniMax-M3 |
$0.48 / $0.96 |
Environ 1M |
Agents documentaires à long contexte |
| 5 |
Gemini 3.8 Flash |
gemini-3.8-flash |
$0.90 / $4.50 |
Environ 1M |
Agents multimodaux rapides |
| 6 |
Grok 4.6 |
grok-4.6 |
$1.20 / $3.60 |
500K |
Escalade difficile en plusieurs étapes |
Les prix ont été vérifiés le 15 septembre 2026. Les tarifs API et les remises promotionnelles peuvent changer, donc confirmez la page du modèle en direct avant d'estimer un budget de production.
Comparez avant de vous engager : Parcourez les modèles d'IA disponibles sur GPT Proto et gardez les ID des modèles présélectionnés derrière une configuration afin de pouvoir changer sans reconstruire tout l'agent.
Comment nous avons classé ces LLM abordables pour l'IA agentique
Simon Willison propose une définition pratique utile : un agent LLM exécute des outils en boucle pour atteindre un objectif. Cette boucle change la façon dont l'abordabilité doit être mesurée. Une comparaison classique de chatbots peut se concentrer sur le coût d'une réponse ; une comparaison d'agents doit aussi compter les appels d'outils, les résultats d'outils, les tentatives, les tokens de raisonnement et les exécutions infructueuses.
Nous avons utilisé l'ordre d'évaluation suivant.
1. Le modèle doit passer un seuil de capacités d'agent
Un modèle n'était pas inclus simplement parce qu'il avait un prix par token bas. Chaque option présélectionnée devait avoir une voie documentée pour l'appel de fonctions ou l'utilisation d'outils, ainsi qu'un moyen utilisable de renvoyer des données structurées ou de poursuivre un flux de travail multi-tours.
2. Les preuves publiques sur les agents comptent plus qu'un score de connaissance générale
Le Berkeley Function Calling Leaderboard est particulièrement utile pour comprendre ce qu'une évaluation d'utilisation d'outils doit inspecter : sélection correcte des fonctions, arguments valides, comportement multi-tours et cas où le modèle doit éviter d'appeler un outil. Son classement public a toutefois été mis à jour pour la dernière fois le 12 avril 2026, ce qui précède la plupart des modèles de cet article. Nous utilisons donc sa méthodologie plutôt que d'attribuer ses anciens scores aux versions plus récentes.
Nous faisons également référence à Artificial Analysis. Son Intelligence Index inclut le travail de connaissance agentique, le travail réel, l'automatisation SaaS, l'utilisation du terminal et les évaluations à long contexte. Il reste un indice mixte — pas un score pur d'appel de fonctions — et doit être traité comme une preuve de présélection plutôt qu'une garantie pour un agent particulier.
3. Le coût par tâche réussie compte plus que le prix par token
La métrique de production utile est :
Coût par tâche réussie = Coût API total de toutes les tentatives et reprises / Tâches acceptées terminées
Ce calcul doit inclure l'entrée non mise en cache, l'entrée mise en cache, la sortie, les tokens de raisonnement cachés ou facturés le cas échéant, les tentatives échouées et les appels de récupération. Si un modèle termine 90 tâches sur 100 et qu'un autre en termine 60, comparer uniquement leurs tarifs par token affichés masque le coût de réparation des 40 autres tâches.
4. La vitesse, la verbosité et la friction d'intégration affectent le coût
Les tokens de sortie par seconde ne mesurent que la phase de génération. Ils ne capturent pas le temps jusqu'à la première réponse, le raisonnement interne, l'exécution des outils, les délais de limitation de débit ou les appels répétés. Un modèle verbeux peut aussi transformer un prix de sortie bas en une facture finale plus élevée.
Enfin, des API similaires ont toujours des règles spécifiques à chaque modèle. Les champs de raisonnement, les paramètres d'échantillonnage non pris en charge, les ID de réponse de fonction et la capitalisation des noms de modèles peuvent tous casser un flux de travail autrement portable. C'est pourquoi la chaîne de modèle GPT Proto exacte est incluse pour chaque entrée.
1. GLM-5.3 Flash — Meilleure API LLM abordable globale pour les agents
GLM-5.3 Flash offre actuellement le meilleur équilibre entre des tarifs par token bas et des fonctionnalités d'agent documentées dans cette liste. Sur GPT Proto, le modèle est listé à 0,15 $ par million de tokens d'entrée, 0,03 $ par million de tokens d'entrée mis en cache et 0,50 $ par million de tokens de sortie.
Le modèle accepte le texte, les images, la vidéo et les fichiers et peut renvoyer du texte ou des appels d'outils. Il prend en charge l'appel de fonctions, le JSON structuré, la mise en cache du contexte, le streaming des réponses et les arguments d'outils en streaming. Sa grande fenêtre de contexte est utile lorsqu'un agent doit conserver des documents, des résultats d'outils antérieurs, des captures d'écran ou un long historique de travail.
La présélection indépendante est encourageante. Artificial Analysis rapporte un score d'Intelligence Index de 42 et une vitesse de sortie d'environ 107 tokens par seconde. Le modèle a généré plus de tokens de sortie que la médiane de comparaison lors de cette évaluation, donc les équipes devraient tout de même définir des limites de sortie et d'étapes.
Le principal compromis est que le raisonnement est toujours activé. Cela peut aider sur des décisions d'outils ambiguës, mais constitue une surcharge inutile pour une classification ou une extraction de base. « Flash » ne doit pas être interprété comme la preuve que chaque requête aura la latence de bout en bout la plus faible.
Choisissez GLM-5.3 Flash lorsque :
un agent a besoin d'appels de fonctions peu coûteux à un volume significatif ;
un flux de travail combine du texte avec des captures d'écran, des vidéos, des graphiques ou des fichiers ;
la sortie structurée et les arguments d'outils en streaming comptent ;
les poids ouverts et l'accès hébergé sont tous deux des options utiles.
Évitez de l'utiliser comme seul modèle lorsque : le flux de travail inclut de nombreuses requêtes triviales où un raisonnement toujours actif ajoute du coût sans améliorer les taux d'acceptation.
Pour la plupart des équipes, glm-5.3-flash est le premier modèle le plus judicieux à évaluer.
2. DeepSeek Flash — Meilleur modèle rapide à poids ouverts pour les agents pilotés par outils
La chaîne de modèle GPT Proto deepseek-flash route actuellement vers DeepSeek V4.1 Flash. La route prend en charge l'entrée texte et image, les appels d'outils, la sortie JSON, le streaming, le fonctionnement avec et sans réflexion, et une fenêtre de contexte allant jusqu'à un million de tokens.
Son tarif GPT Proto est de 0,30 $ par million de tokens d'entrée, 0,006 $ par million de tokens de lecture de cache et 1,20 $ par million de tokens de sortie. Ce tarif de lecture de cache extrêmement bas est pertinent pour les agents qui réutilisent de manière répétée des instructions stables, des descriptions d'outils ou du matériel de référence.
Artificial Analysis a mesuré un score d'Intelligence Index de 40 et environ 222 tokens de sortie par seconde. Il était sensiblement plus rapide que GLM-5.3 Flash dans cette mesure, bien qu'il ait également été très verbeux sur l'ensemble d'évaluation. Un modèle rapide peut tout de même générer une facture élevée s'il produit plus de tokens que nécessaire pour la tâche.
DeepSeek Flash est particulièrement attrayant pour les agents gourmands en entrée. Son contexte d'un million de tokens, son plafond de sortie élevé, sa compréhension des images et ses modes de raisonnement commutables le rendent adapté à l'analyse de documents, aux flux de travail assistés par captures d'écran, à l'inspection de dépôts et à l'automatisation multi-étapes.
Il y a un détail de compatibilité important. Dans le flux de travail d'outils en mode réflexion natif de DeepSeek, le reasoning_content antérieur peut devoir être conservé lorsque des messages ultérieurs sont envoyés. Confirmez comment la route GPT Proto mappe ce champ avant de déplacer une boucle d'outils avec état en production.
Choisissez DeepSeek Flash lorsque :
les prompts mis en cache constituent une grande partie de votre trafic d'agent ;
vous avez besoin d'une vitesse de génération élevée et de poids ouverts ;
le même agent alterne entre un travail de routine sans réflexion et un raisonnement plus difficile ;
une entrée longue ou des preuves visuelles doivent rester dans le contexte de travail.
Surveillez : une sortie excessive, un état de raisonnement manquant dans les requêtes multi-tours et des arguments d'outils qui passent l'analyse JSON mais échouent à votre validation métier.
3. GPT-5.6 Luna — Idéal pour les agents légers à grand volume
GPT-5.6 Luna est le membre de la famille GPT-5.6 sensible aux coûts. Il est destiné aux tâches fréquentes telles que la classification, l'extraction, le résumé, le routage et le chat destiné aux utilisateurs. Ces tâches apparaissent souvent au début d'un flux de travail d'agent, avant qu'un modèle plus coûteux ne soit nécessaire.
Le modèle accepte le texte, les images et les documents, prend en charge un contexte d'environ un million de tokens et fonctionne avec les prompts de style OpenAI, les schémas JSON et les définitions d'outils. Artificial Analysis rapporte un score d'Intelligence Index de 38 et une vitesse de sortie d'environ 116 tokens par seconde. Son prix de référence officiel actuel est de 0,20 $ par million de tokens d'entrée et 1,20 $ par million de tokens de sortie.
Luna ne doit pas automatiquement contrôler chaque partie d'un agent complexe. Son meilleur rôle est souvent la première couche peu coûteuse :
classer la requête ;
extraire ou normaliser les champs requis ;
tenter un appel d'outil simple ;
valider le résultat ;
escalader uniquement si la requête échoue ou dépasse un seuil de complexité.
Cette conception empêche un modèle plus puissant de traiter des milliers de requêtes simples tout en protégeant les flux de travail difficiles contre des tentatives répétées de faible qualité.
Choisissez GPT-5.6 Luna lorsque : le volume, le travail structuré prévisible et la compatibilité avec un agent existant de style OpenAI sont plus importants que la performance maximale sur un horizon long.
Escaladez au lieu de réessayer indéfiniment lorsque : le modèle ne peut pas se remettre d'un résultat d'outil échoué, perd des détails clés au fond du contexte ou viole de manière répétée un schéma de sortie strict.
4. MiniMax M3 — Meilleure API abordable pour les agents documentaires à long contexte
MiniMax M3 est conçu pour le codage soutenu et le travail d'agent sur un contexte d'environ un million de tokens. Sur GPT Proto, utilisez la chaîne de modèle exacte sensible à la casse MiniMax-M3. Le prix indiqué est de 0,48 $ par million de tokens d'entrée et 0,96 $ par million de tokens de sortie.
Le modèle prend en charge l'utilisation d'outils et la décomposition de tâches en plusieurs étapes. Sa capacité de contexte en fait un candidat pratique pour les agents de recherche, la revue de contrats, la comparaison de politiques, les historiques d'assistance volumineux et les flux de travail qui doivent conserver les résultats de nombreux documents.
Artificial Analysis attribue à MiniMax M3 un score d'Intelligence Index de 30, environ 107 tokens de sortie par seconde et un total de tokens de sortie inférieur à plusieurs autres modèles de cette liste. Cette concision relative peut compter dans les boucles d'agents, car chaque tour de modèle supplémentaire devient du contexte pour la requête suivante.
Le compromis est la capacité. Le score composite indépendant de MiniMax M3's est inférieur à celui des autres candidats principaux, donc son long contexte ne doit pas être confondu avec un raisonnement uniformément plus fort. Plus de contexte n'aide que lorsque les bonnes preuves sont récupérées, que les instructions restent claires et que le modèle peut utiliser correctement les informations.
Choisissez MiniMax M3 lorsque :
l'agent doit conserver une grande collection de documents ou un long historique de travail ;
le coût de sortie et la concision des réponses comptent ;
le flux de travail peut valider les résultats intermédiaires ;
vous voulez un modèle à poids ouverts mais préférez un accès API hébergé.
Testez soigneusement lorsque : la réussite dépend d'un raisonnement subtil entre documents plutôt que de la localisation et de la transformation d'informations.
5. Gemini 3.8 Flash — Meilleure API d'agent multimodal rapide
Gemini 3.8 Flash est le candidat le plus solide ici lorsqu'un agent doit traiter du texte, des images, de l'audio, de la vidéo et des PDF. Il prend en charge l'appel de fonctions, la sortie structurée, la mise en cache et des niveaux de réflexion ajustables. Sur GPT Proto, la chaîne de modèle est gemini-3.8-flash, avec des tarifs indiqués de 0,90 $ par million de tokens d'entrée, 0,09 $ par million de tokens d'entrée mis en cache et 4,50 $ par million de tokens de sortie.
Sa caractéristique principale est la vitesse. Artificial Analysis a mesuré environ 303 tokens de sortie par seconde avec un score d'Intelligence Index de 41. Il était le modèle le plus rapide de sa classe de comparaison au moment de la mesure.
Cela n'en fait pas l'option la moins chère. Artificial Analysis a également trouvé le modèle verbeux, tandis que son tarif de sortie GPT Proto est considérablement plus élevé que celui de GLM-5.3 Flash, DeepSeek Flash et MiniMax M3. Un long agent multimodal qui raisonne, appelle des outils et vérifie son propre travail peut consommer beaucoup plus de sortie qu'une courte requête de chat.
Gemini 3.8 Flash est idéal lorsque ses capacités remplacent des étapes de prétraitement supplémentaires. Par exemple, un agent d'assistance qui peut inspecter une vidéo, lire un PDF et appeler un système client dans un même flux de travail peut être plus simple qu'un pipeline qui nécessite des modèles distincts de transcription, de vision et de langage.
Choisissez Gemini 3.8 Flash lorsque :
l'audio, la vidéo, les captures d'écran, les graphiques ou les PDF sont au cœur de la tâche ;
la réactivité face à l'utilisateur compte ;
un raisonnement ajustable aide à équilibrer les requêtes de routine et difficiles ;
une seule requête multimodale peut remplacer plusieurs appels de prétraitement.
Surveillez : une utilisation élevée de tokens de sortie et la différence entre une génération rapide et la latence totale du flux de travail.
6. Grok 4.6 — Meilleur modèle d'escalade abordable pour les tâches difficiles
Grok 4.6 n'est pas le modèle par défaut le moins cher de ce classement. Il est inclus parce qu'un modèle peut rester rentable lorsqu'il évite des échecs coûteux sur des travaux difficiles.
La route GPT Proto grok-4.6 prend en charge l'entrée texte et image, l'appel de fonctions, la sortie structurée, quatre niveaux de raisonnement et une fenêtre de contexte de 500 000 tokens. Les tarifs GPT Proto standard sont listés à 1,20 $ par million de tokens d'entrée, 0,30 $ par million de tokens d'entrée mis en cache et 3,60 $ par million de tokens de sortie.
Artificial Analysis rapporte un score d'Intelligence Index de 44 — le plus élevé de cette présélection — mais une vitesse de génération d'environ 59 tokens par seconde. Sa sortie était moins verbeuse que plusieurs alternatives moins coûteuses, mais la latence et le prix des tokens le rendent inadapté à chaque requête de routine.
Le rôle pratique est l'escalade. Un modèle moins coûteux peut d'abord tenter la tâche, et l'agent peut router vers Grok 4.6 lorsque la validation échoue, que le plan nécessite de nombreuses étapes dépendantes ou que le coût d'un résultat incomplet dépasse la dépense API supplémentaire.
Choisissez Grok 4.6 lorsque :
l'agent doit persister à travers un flux de travail difficile en plusieurs étapes ;
des preuves visuelles et un raisonnement doivent être combinés ;
un résultat échoué créerait plus de coût qu'une requête plus chère ;
l'application peut sélectionner un effort de raisonnement inférieur pour les étapes plus simples.
Ne l'utilisez pas par défaut pour : l'extraction de base, la réécriture, le routage ou tout autre travail à grand volume déjà géré de manière fiable par un modèle moins cher.
Pourquoi le LLM absolument le moins cher n'est pas classé premier
GPT Proto liste des modèles avec des prix par token inférieurs à chaque entrée principale de ce guide. Par exemple, Doubao Seed 1.6 Flash a un tarif d'entrée affiché bien plus bas. Cela le rend intéressant pour des charges de travail ciblées, mais cela n'établit pas qu'il s'agit de l'API LLM la moins chère pour un agent.
Avant qu'un modèle entre dans un classement d'agents, il doit démontrer quatre choses :
il peut sélectionner le bon outil parmi des alternatives réalistes ;
ses arguments satisfont systématiquement le schéma requis et les règles métier ;
il peut continuer après avoir reçu un résultat d'outil ou une erreur ;
il évite les appels d'outils inutiles lorsqu'aucune fonction disponible ne convient.
Un tableau de prix ne peut pas répondre à ces questions. Un score de raisonnement général non plus. Un modèle ultra-bon marché peut être excellent pour la classification, l'étiquetage ou la réécriture tout en restant un mauvais contrôleur pour un flux de travail qui peut modifier une base de données ou envoyer un message externe.
La règle de décision plus sûre est simple : établissez d'abord un seuil de taux d'acceptation, puis comparez le coût parmi les modèles qui le franchissent.
Une stratégie pratique de routage de modèles à faible coût
De nombreux agents de production devraient utiliser plus d'un modèle. Cela ne signifie pas nécessairement plusieurs agents autonomes. Il peut s'agir d'une simple règle de routage au sein d'une application.
| Tâche de l'agent |
Commencez par |
Escaladez lorsque |
| Classification, extraction et routage des requêtes |
GPT-5.6 Luna |
La sortie échoue à la validation du schéma ou la requête est ambiguë |
| Flux de travail général piloté par outils |
GLM-5.3 Flash |
Plusieurs décisions dépendantes ou étapes de récupération sont nécessaires |
| Travail rapide, mis en cache, gourmand en entrée |
DeepSeek Flash |
Le modèle perd l'état ou ne peut pas vérifier le résultat |
| Grande session documentaire ou de connaissance |
MiniMax M3 |
Un raisonnement subtil entre documents échoue aux contrôles d'acceptation |
| Flux de travail audio, vidéo, PDF ou visuel |
Gemini 3.8 Flash |
La tâche devient un plan difficile à long horizon |
| Travail difficile en plusieurs étapes |
Grok 4.6 |
Une approbation humaine est requise pour l'action suivante |
Une boucle d'agent à coût maîtrisé peut suivre cinq règles :
Commencez par le modèle le moins cher qui a réussi votre évaluation de tâche.
Validez chaque réponse structurée et argument d'outil avant exécution.
Limitez le nombre maximal d'étapes de modèle, de tokens de sortie, de temps écoulé et de coût total.
Escaladez après un échec défini au lieu de répéter indéfiniment le même modèle.
Exigez une confirmation humaine pour les actions irréversibles, financières, modifiant les permissions ou visibles à l'extérieur.
Comme les modèles présélectionnés sont disponibles via un catalogue de modèles GPT Proto unique, une application peut conserver un seul compte et un seul identifiant API tout en sélectionnant une chaîne de modèle différente pour chaque requête. La logique d'orchestration appartient toujours à l'application ou au framework d'agent ; la clé API seule ne crée ni ne coordonne plusieurs agents.
Requête minimale d'appel d'outil avec GPT Proto
L'exemple ci-dessous donne à GLM-5.3 Flash une définition de fonction. Le modèle peut proposer un appel, mais votre application — pas le modèle — doit exécuter la fonction, valider les permissions et renvoyer le résultat à la conversation.
curl https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Où est la commande A-1042 ?"
      }
    ],
    "tools": [
      {
        "type": "function",
        "function": {
          "name": "get_order_status",
          "description": "Renvoie le statut actuel d'une commande.",
          "parameters": {
            "type": "object",
            "properties": {
              "order_id": {
                "type": "string",
                "description": "L'identifiant de la commande."
              }
            },
            "required": ["order_id"],
            "additionalProperties": false
          }
        }
      }
    ],
    "tool_choice": "auto"
  }'
Si la réponse contient un tool_call, l'application doit :
confirmer que la fonction demandée est autorisée ;
valider order_id par rapport au schéma JSON et aux règles métier ;
exécuter get_order_status dans l'application ;
renvoyer le résultat de l'outil avec le bon identifiant d'appel ;
laisser le modèle produire la réponse finale destinée à l'utilisateur.
Changer la valeur model vous permet d'envoyer la même requête d'évaluation vers une autre route compatible. Ne basculez pas le trafic de production uniquement parce que la requête réussit une fois ; des exécutions répétées sont nécessaires pour exposer des choix d'outils et des arguments incohérents.
Comment tester une API LLM abordable pour votre agent
Une petite évaluation est plus utile qu'un grand benchmark générique si elle reflète vos outils réels. Commencez par quatre catégories :
Sélection d'un seul outil : donnez au modèle plusieurs outils similaires et vérifiez s'il choisit le bon.
Appels parallèles : demandez des informations qui nécessitent deux appels d'outils indépendants et vérifiez qu'aucun n'est omis.
Pertinence sans outil : incluez des requêtes qui ne peuvent pas ou ne devraient pas utiliser de fonction disponible.
Récupération : renvoyez une erreur d'outil réaliste et vérifiez si le modèle corrige la requête sans entrer dans une boucle incontrôlée.
Exécutez chaque cas au moins cinq fois par modèle avec le même prompt, les mêmes outils, le même contexte, le même réglage de raisonnement, la même limite de sortie et les mêmes critères d'acceptation. Enregistrez :
taux de tâches acceptées ;
taux de sélection correcte des outils ;
taux d'arguments valides selon le schéma ;
appels inutiles ;
succès de récupération ;
nombre total d'étapes de modèle ;
tokens d'entrée, d'entrée mise en cache, de raisonnement et de sortie ;
temps jusqu'à la première réponse et temps total du flux de travail ;
coût total, y compris les échecs et les reprises.
Avec six modèles, quatre tâches et cinq répétitions, la comparaison minimale contient 120 exécutions. Dix répétitions sont préférables lorsque la décision affecte un trafic de production significatif.
Ce que disent les constructeurs d'agents sur la latence
Les rapports de la communauté ajoutent un contexte que les pages de tarification ne peuvent pas fournir. Dans une discussion de la communauté AI Agents, un simple système de récupération aurait répondu en moins d'une seconde, tandis qu'une version plus agentique a pris presque trois secondes. Pour l'assistance client, cette différence a été décrite comme un facteur décisif.
D'autres participants n'étaient pas d'accord avec la conclusion universelle. Ils ont noté que les utilisateurs de la recherche et de l'analyse interne peuvent accepter des attentes beaucoup plus longues lorsque l'utilisation d'outils améliore matériellement la réponse. La leçon utile n'est pas que trois secondes sont toujours trop lentes. C'est que le même modèle peut être abordable pour un agent et inadapté pour un autre, car la latence, la qualité et les coûts d'échec ont des valeurs différentes.
Traitez les commentaires de la communauté comme des rapports d'expérience, pas comme des résultats de benchmark. Utilisez-les pour identifier des cas d'échec pour votre propre évaluation.
Recommandation finale
Pour la plupart des agents pilotés par outils sensibles aux coûts, commencez par évaluer GLM-5.3 Flash. Il combine le tarif de sortie confirmé le plus bas de la présélection principale avec l'appel de fonctions, la sortie structurée, les entrées multimodales, la mise en cache et une grande fenêtre de contexte.
Choisissez DeepSeek Flash lorsque la vitesse, les poids ouverts, le raisonnement commutable ou des lectures de cache très bon marché comptent. Utilisez GPT-5.6 Luna pour les étapes légères à grand volume après avoir confirmé le tarif GPT Proto en direct. Sélectionnez MiniMax M3 pour les longues sessions documentaires, Gemini 3.8 Flash pour les flux de travail multimodaux rapides, et Grok 4.6 comme modèle d'escalade lorsque des tâches plus difficiles justifient son prix plus élevé.
Le meilleur LLM abordable pour un agent est le modèle le moins cher qui termine de manière fiable votre tâche — pas le modèle avec le plus petit nombre dans un tableau de prix.
Construisez une présélection avec une seule API : Explorez les modèles LLM sur GPT Proto, testez le même schéma d'outils sur les candidats et routez chaque tâche vers le modèle le moins coûteux qui atteint son seuil d'acceptation.