Claude vs ChatGPT pour le codage : verdict rapide
Le meilleur choix dépend de votre façon de coder et de la part de la tâche que vous souhaitez que l’IA accomplisse de manière autonome.
| Tâche de codage |
Meilleur point de départ |
Pourquoi |
| Petites fonctions et scripts |
Égalité |
La qualité du prompt et le niveau du modèle comptent généralement plus que le fournisseur |
| Programmation en binôme interactive |
Claude Code |
Retour rapide et personnalisation approfondie du terminal |
| Longs travaux de codage autonomes |
Codex |
Flux de travail solides de délégation et de revue, et en arrière-plan |
| Génération frontend et UI |
Claude |
Un léger avantage qualitatif pour l’implémentation visuelle et l’itération |
| Débogage intensif en terminal |
ChatGPT/Codex |
GPT-5.6 Sol mène de justesse la comparaison partagée Terminal-Bench |
| Refactorisation à l’échelle du dépôt |
Claude Opus 5 |
Fortes performances de migration de code et d’ingénierie multi-fichiers |
| Développement Python |
Égalité |
Le gagnant change selon la tâche, les bibliothèques, les tests et l’accès au dépôt |
| Grandes bases de code |
Claude, léger avantage |
Fort raisonnement sur le dépôt, bien que les deux familles prennent désormais en charge de très grands contextes |
| Abonnement de codage d’entrée de gamme |
ChatGPT Plus |
Son allocation Codex publiée est généralement plus facile à estimer et à étendre |
| Déploiement d’API |
Dépend du niveau du modèle |
Le coût par résultat accepté compte plus que la requête individuelle la moins chère |
Choisissez Claude pour une collaboration étroite et des modifications importantes et interconnectées. Choisissez ChatGPT avec Codex lorsque vous préférez déléguer et réviser. Les équipes API doivent évaluer les modèles individuellement plutôt que de considérer l’un ou l’autre fournisseur comme un produit fixe.
Que comparons-nous : Claude, ChatGPT, Claude Code ou Codex ?
La différence entre Claude et ChatGPT commence par la surface produit.
Claude.ai et ChatGPT sont des applications générales pour expliquer, générer et réviser du code. Claude Code et Codex sont des agents de codage capables d’inspecter des dépôts, de modifier des fichiers, d’exécuter des commandes et des tests, et de corriger les échecs. Cela transforme la tâche : passer de « écrire du code » à « produire et vérifier une modification fonctionnelle ».
Les API constituent une autre couche : l’application environnante sélectionne les fichiers et les outils, exécute les commandes, renvoie les erreurs et décide quand le travail est terminé. Un modèle qui écrit une fonction correcte dans le chat peut donc se comporter différemment au sein d’un agent. Une comparaison équitable entre Claude AI et ChatGPT doit évaluer à la fois le modèle et son environnement de travail.
Modèles Claude et GPT actuels pour le codage
Un guide actuel Claude vs ChatGPT pour le codage doit comparer des niveaux de modèles équivalents. Anthropic recommande Claude Opus 5 pour la plupart des charges de travail complexes et Fable 5.1 pour les travaux à long horizon particulièrement exigeants. OpenAI positionne GPT-5.6 Sol comme son modèle phare pour le codage complexe, avec Terra et Luna pour les charges plus légères.
| Modèle |
Idéal pour le codage |
Fenêtre de contexte |
Principal compromis |
| Claude Fable 5.1 |
Codage agentique exigeant et de longue durée |
1M tokens |
Prix d’API Claude le plus élevé et latence plus lente |
| Claude Opus 5 |
Codage complexe, migrations et travail sur dépôt |
1M tokens |
Plus cher que les modèles de milieu de gamme |
| Claude Sonnet 5 |
Codage quotidien avec une latence plus faible |
1M tokens |
Plafond plus bas sur les tâches d’ingénierie les plus difficiles |
| GPT-5.6 Sol |
Codage complexe, agents et travail en terminal |
1.05M tokens |
Coût et latence plus élevés que les modèles GPT plus petits |
| GPT-5.6 Terra |
Tâches de développement et de production quotidiennes |
1.05M tokens |
Moins performant que Sol sur les travaux les plus difficiles |
| GPT-5.6 Luna |
Scripts ciblés et transformations à grand volume |
1.05M tokens |
Non destiné aux tâches d’ingénierie les plus ambiguës |
Vous pouvez consulter la famille de modèles Claude et la famille de modèles OpenAI sur GPT Proto. Pour les charges de codage difficiles, les pages individuelles les plus pertinentes sont Claude Fable 5.1, Claude Opus 5, et GPT-5.6 Sol. Pour les travaux de production routiniers, GPT-5.6 Terra est un point de comparaison plus économique.
Faites correspondre les modèles à la charge de travail, puis mesurez le coût total nécessaire pour obtenir un résultat acceptable.
Ce que les benchmarks de codage montrent réellement
Les preuves actuelles issues des benchmarks ne soutiennent pas de gagnant universel. Claude mène certaines évaluations de dépôt et de génération de code, tandis que GPT-5.6 Sol mène de justesse un benchmark terminal partagé.
| Benchmark |
Résultat Claude |
Résultat GPT |
Ce que cela suggère |
| Terminal-Bench 2.1 |
Fable 5.1: 85.02% |
GPT-5.6 Sol: 85.77% |
GPT détient une légère avance sur les tâches d’agent en terminal |
| SWE-bench Verified |
Opus 5: 97.00% |
GPT-5.6 Sol: 96.20% |
Les deux sont très compétitifs sur de vrais problèmes de dépôt |
| Vibe Code Bench |
Fable 5.1: 90.26% |
GPT-5.6 Sol: 80.50% |
Claude montre un avantage dans la génération d’applications de bout en bout |
| LiveCodeBench |
Fable 5.1: 90.52% |
— |
Forte résolution de problèmes de code, mais pas une comparaison produit complète |
Ces résultats proviennent des évaluations Vals de Claude Fable 5.1, Claude Opus 5, et GPT-5.6 Sol, mais ils nécessitent encore du contexte.
Par exemple, Fable 5.1 a été évalué avec des fallbacks Claude côté serveur pour les refus. Vals rapporte que son score Terminal-Bench 2.1 passe de 85.02% à 79.03% lorsque les tâches assistées par fallback sont comptées comme des échecs. Les paramètres d’évaluation diffèrent également : Fable 5.1 et GPT-5.6 Sol ont utilisé l’effort maximal, tandis qu’Opus 5 a utilisé un effort élevé pour Terminal-Bench.
Claude est particulièrement performant sur les évaluations de génération de code, de migration et de création d’applications. GPT-5.6 Sol est proche sur la résolution de dépôt et légèrement en avance sur le benchmark terminal partagé. Ces écarts peuvent s’inverser avec des agents, des outils ou des bases de code différents.
Claude vs ChatGPT pour la génération de code
Pour les petites tâches de génération de code clairement spécifiées, Claude et ChatGPT sont suffisamment proches pour qu’il n’y ait pas de gagnant universel fiable. Les deux peuvent générer des fonctions, des transformations de données, des gestionnaires d’API, des cas de test et de petites applications lorsque le prompt contient les exigences pertinentes.
Claude est un bon point de départ pour la planification de mise en œuvre et la coordination sur plusieurs fichiers. ChatGPT est tout aussi pratique pour des scripts ciblés, des sorties structurées et des tâches avec une définition précise de ce qui est terminé. Dans Codex, les modèles GPT peuvent implémenter et vérifier des modifications plutôt que simplement suggérer du code.
Lorsque vous comparez Claude ou ChatGPT pour la programmation, donnez aux deux les mêmes versions de langage et de dépendances, les fichiers modifiables, le comportement attendu, les contraintes de compatibilité et les tests requis. Une réponse plus courte peut rester meilleure si le code passe du premier coup. Mesurez la sortie acceptée, pas l’impression que la réponse donne.
Claude vs ChatGPT pour le débogage
Claude vs ChatGPT pour le débogage n’est pas une seule comparaison. Déboguer une trace de pile collée est différent de trouver une régression répartie dans un dépôt inconnu. 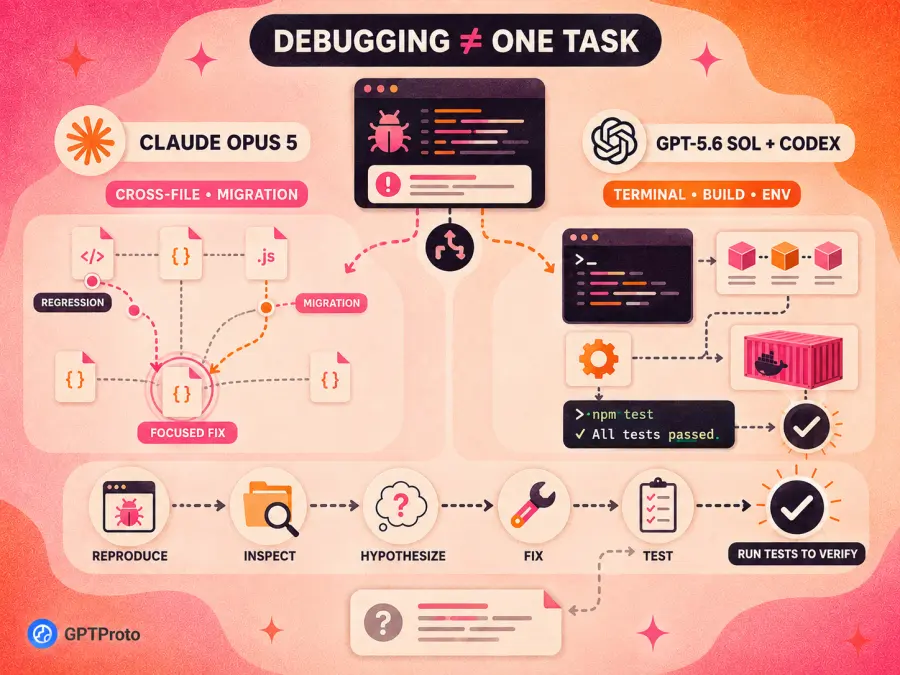
Pour un seul message d’erreur, les deux produits peuvent généralement expliquer les causes probables et proposer des vérifications. Le résultat dépend fortement de l’inclusion par l’utilisateur du code environnant, de la version d’exécution, des versions des dépendances, des données d’entrée et de l’erreur complète plutôt que de sa seule dernière ligne.
Pour les problèmes de terminal, de dépendances, de build et d’environnement, GPT-5.6 Sol avec Codex est un bon point de départ. Sa légère avance sur Terminal-Bench suggère une force sur les tâches nécessitant une interaction en ligne de commande, bien que la différence avec Fable 5.1 soit inférieure à un point de pourcentage dans les paramètres rapportés.
Pour les bugs logiques multi-fichiers, les migrations et les régressions architecturales, Claude Opus 5 est un premier choix raisonnable. Ses solides résultats sur le dépôt et la migration de code indiquent qu’il peut être efficace lorsqu’un correctif dépend de la compréhension des relations entre plusieurs modules.
En pratique, la qualité du débogage dépend de la capacité de l’agent à reproduire la panne, inspecter les fichiers pertinents, formuler une hypothèse testable, appliquer un correctif ciblé et exécuter les tests concernés. S’il ne peut pas accéder à l’environnement, considérez sa réponse comme une hypothèse—pas comme un correctif vérifié.
Claude vs ChatGPT pour le codage frontend
Claude dispose d’un léger avantage qualitatif pour le codage frontend, surtout lorsque la tâche consiste à traduire une direction visuelle en composants, mises en page, comportement responsive, animations ou états interactifs. Les premiers rapports autour de Claude Opus 5 ont également mis en avant des améliorations dans les builds d’applications full-stack, y compris le travail visuel et interactif.
Cela ne signifie pas que chaque sortie de Claude sera soignée. Les deux produits peuvent se rabattre sur des cartes génériques, des dégradés et des mises en page pensées pour le desktop lorsque le brief est vague. Donnez-leur la même référence de design, les mêmes tailles de viewport, le même framework, les mêmes règles de marque, les mêmes états d’interaction, les mêmes exigences d’accessibilité et les mêmes critères d’acceptation.
Aucun modèle ne devrait juger sa propre sortie visuelle uniquement à partir du code source. Les performances s’améliorent lorsque l’agent peut lancer la page, inspecter les captures d’écran, les comparer à la référence et réviser le CSS. Claude peut fournir la meilleure première tentative ; le meilleur flux de travail est celui qui inclut une vérification visuelle.
Claude vs ChatGPT pour Python
Il n’y a pas de gagnant général pour Claude vs ChatGPT pour Python, car « le codage Python » couvre tout, d’un script de dix lignes pour renommer des fichiers à un grand service Django ou un pipeline d’apprentissage automatique.
| Tâche Python |
Meilleur point de départ |
| Petit script d’automatisation |
Claude ou ChatGPT |
| Nettoyage et transformation de données |
Un modèle équilibré comme Sonnet 5 ou GPT-5.6 Terra |
| Refactorisation d’une grande application Python |
Claude Opus 5 |
| Dépannage de CLI, de package ou d’environnement |
GPT-5.6 Sol avec Codex |
| Explication longue de notebook |
Claude est souvent plus facile à suivre |
| Transformation répétitive à grand volume |
Un modèle plus petit et moins cher après validation |
Évaluez les deux dans le même environnement et vérifiez la compatibilité des dépendances, les cas limites, la gestion des fichiers, les vérifications de type, le linting et les résultats pytest. Une explication propre compte moins qu’un comportement vérifié.
Claude vs ChatGPT pour les grandes bases de code
Claude est le premier choix le plus solide pour de nombreuses analyses à l’échelle du dépôt, migrations de code et modifications coordonnées de plusieurs fichiers. Claude Opus 5 est très performant sur les benchmarks de migration de code et de dépôt, tandis que Fable 5.1 est destiné aux travaux agentiques exigeants et de longue durée.
Cependant, la taille de la fenêtre de contexte ne suffit pas à établir cet avantage. Les modèles phares actuels de Claude offrent jusqu’à une fenêtre de contexte de 1M de tokens, tandis que la famille GPT-5.6 offre environ 1.05M de tokens. Les deux sont suffisamment grands pour contenir du code substantiel, mais insérer aveuglément un dépôt entier peut gaspiller des tokens et masquer les dépendances pertinentes.
La performance sur une grande base de code dépend de la capacité de l’agent à cartographier le dépôt, localiser les fichiers pertinents, suivre les instructions du projet, préserver les interfaces et vérifier ses modifications. Une sélection et une compaction efficaces du contexte peuvent compter plus que le maximum annoncé.
Choisissez Claude Opus 5 lorsque la tâche implique une migration large, un raisonnement architectural ou des changements coordonnés entre modules interconnectés. Choisissez GPT-5.6 Sol avec Codex lorsque la tâche est bien spécifiée, intensive en terminal et adaptée à une exécution autonome plus longue. Pour l’une ou l’autre option, divisez les très grands changements en étapes vérifiables et exigez des tests à chaque frontière.
Claude Code vs Codex : l’agent peut compter autant que le modèle
Claude Code et Codex diffèrent par leur flux de travail, avant même de considérer leurs modèles par défaut.
| Dimension |
Claude Code |
Codex |
| Flux de travail typique |
Développement interactif en terminal |
Déléguer, exécuter et réviser |
| Instructions du dépôt |
CLAUDE.md |
AGENTS.md |
| Personnalisation |
Hooks avancés, compétences et configuration d’agent |
Davantage de valeurs par défaut gérées et de contrôles de sandbox |
| Style de retour |
Rapide et interactif |
Plus réfléchi et autonome |
| Bon ajustement |
Développeurs qui restent étroitement impliqués |
Travail en arrière-plan, revue et tâches parallèles |
| Principal compromis |
Les sessions complexes peuvent consommer rapidement les limites |
Certaines tâches prennent plus de temps à terminer |
Un test tiers utile de Composio aide à séparer le harnais du modèle sous-jacent. L’évaluateur a exécuté le même modèle DeepSeek V4 Flash via Claude Code et Codex, en utilisant 30 tâches multi-applications identiques, la même configuration MCP hébergée, un raisonnement maximal et une limite de 900 secondes par tâche.
| Résultat |
Claude Code |
Codex |
| Tâches réussies |
16/30 |
16/30 |
| Temps de complétion médian |
122.7 secondes |
245.0 secondes |
| Appels d’outils |
358 |
448 |
| Coût total estimé |
$3.116 |
$1.294 |
| Coût par succès |
$0.195 |
$0.081 |
Les deux harnais ont obtenu le même nombre de réussites. Claude Code a terminé en environ la moitié du temps médian, tandis que Codex a coûté environ 58 % de moins. La comparaison complète de Composio soutient une conclusion nuancée : Claude Code offrait un retour plus rapide dans cette configuration, tandis que Codex étirait davantage le budget. Cela ne prouve pas que les modèles Claude sont plus intelligents, car le test utilisait le même modèle tiers dans les deux outils.
Taux d’utilisation de Claude Pro comparés à ChatGPT Pro
Les taux d’utilisation de Claude Pro comparés à ChatGPT Pro sont souvent décrits avec des décomptes de messages fixes trompeurs. Les deux fournisseurs font varier la consommation selon le modèle sélectionné, la longueur du contexte, l’effort de raisonnement, les outils et la complexité de la tâche.
La comparaison de prix actuelle la plus proche est :
| Prix mensuel |
Forfait Anthropic |
Forfait OpenAI |
| $20 |
Claude Pro |
ChatGPT Plus |
| $100 |
Claude Max 5x |
ChatGPT Pro 5x |
| $200 |
Claude Max 20x |
ChatGPT Pro 20x |
L’utilisation de Claude est partagée entre Claude.ai, Claude Desktop et Claude Code. Ses forfaits combinent des limites de session de cinq heures avec des limites hebdomadaires ; les utilisateurs peuvent attendre une réinitialisation, passer à un forfait supérieur ou activer des crédits d’utilisation facturés séparément.
ChatGPT Work et Codex partagent également le budget d’utilisation applicable. OpenAI publie de larges estimations pour les messages Codex locaux par fenêtre de cinq heures. Pour GPT-5.6 Sol, les plages actuelles sont d’environ 10–100 sur Plus, 50–500 sur Pro 5x et 200–2 000 sur Pro 20x. Les tâches cloud peuvent consommer plus que les messages locaux, et deux tâches apparemment similaires peuvent utiliser des quantités différentes.
Ce sont des plages de planification, pas des garanties. Une longue tâche sur dépôt peut consommer plus de capacité que plusieurs modifications ciblées. À 20 $, ChatGPT Plus est généralement le point de départ le plus sûr pour un usage soutenu d’agents ; les utilisateurs intensifs de Claude Code peuvent avoir besoin de la capacité Max ou de crédits d’utilisation. À 100 $ et 200 $, le flux de travail préféré compte plus que le multiplicateur affiché.
API Claude vs ChatGPT pour les développeurs
Les forfaits d’abonnement sont destinés aux personnes qui travaillent dans les produits Claude ou ChatGPT. Les développeurs qui créent une application devraient plutôt comparer les modèles d’API et la facturation à l’usage.
| Charge de travail |
Option Claude |
Option GPT |
| Travaux agentiques les plus difficiles à long horizon |
Claude Fable 5.1 |
GPT-5.6 Sol |
| Codage quotidien complexe |
Claude Opus 5 |
GPT-5.6 Sol |
| Charge de production équilibrée |
Claude Sonnet 5 |
GPT-5.6 Terra |
| Tâches ciblées à grand volume |
Claude Haiku 4.5 |
GPT-5.6 Luna |
Les prix officiels des tokens peuvent aider à choisir un modèle initial, mais ils ne révèlent pas le coût complet d’un flux de travail de codage. Un modèle plus performant peut terminer avec moins de tentatives. Un modèle moins cher peut être économique pour des tâches répétitives, mais coûteux si les ingénieurs doivent réparer son résultat à plusieurs reprises.
Sur votre propre ensemble de tâches, suivez la complétion du premier passage, les tests réussis, les tentatives, les interventions humaines, les appels d’outils échoués, le total de tokens, le temps et le coût par résultat accepté. Le gagnant peut changer selon l’étape : Claude pourrait gérer l’analyse du dépôt, GPT l’implémentation intensive en terminal, et un modèle plus petit les transformations répétitives.
Pouvez-vous utiliser les modèles Claude et GPT ensemble ?
Vous n’avez pas besoin de choisir un seul fournisseur pour chaque charge de travail de codage. Les applications peuvent router les tâches selon la complexité, la latence, le coût ou le type de travail d’ingénierie concerné.
GPT Proto donne accès aux familles de modèles Claude et GPT via une seule clé API et un solde partagé. Cela facilite l’envoi des mêmes tâches d’évaluation aux deux fournisseurs, la comparaison de la qualité et du coût, et le changement de modèle sans maintenir de comptes de facturation fournisseur séparés.
Cela ne signifie pas qu’une clé GPT Proto remplace un abonnement Claude ou ChatGPT dans chaque client de codage natif. Les développeurs peuvent appeler les API Claude et GPT prises en charge depuis leurs propres applications ; la compatibilité client dépend toujours de la prise en charge des points de terminaison personnalisés et du schéma de requête.
Claude ou ChatGPT pour le codage : décision finale
Choisissez Claude si vous passez la plupart de votre temps dans un flux de travail interactif en terminal, si l’implémentation frontend vous importe, ou si vous avez besoin d’un modèle capable de raisonner sur un grand dépôt interconnecté. Claude Opus 5 est le point de départ judicieux pour la plupart des travaux de développement complexes, tandis que Fable 5.1 est destiné aux tâches les plus difficiles à long horizon.
Choisissez ChatGPT avec Codex si vous préférez les flux de travail de délégation et de revue, les tâches autonomes intensives en terminal, ou un accès au codage intégré à un abonnement ChatGPT plus large. GPT-5.6 Sol est l’option GPT la plus solide pour les travaux difficiles, tandis que Terra et Luna peuvent réduire les coûts pour les tâches plus claires et plus répétitives.
Pour le développement d’API, tranchez la décision Claude vs ChatGPT pour le codage avec vos propres tests d’acceptation. Exécutez les mêmes tâches, outils et tests sur des niveaux comparables, puis mesurez les résultats réussis, les corrections, la latence et le coût. Les preuves publiques montrent deux familles très compétitives—pas un champion permanent.