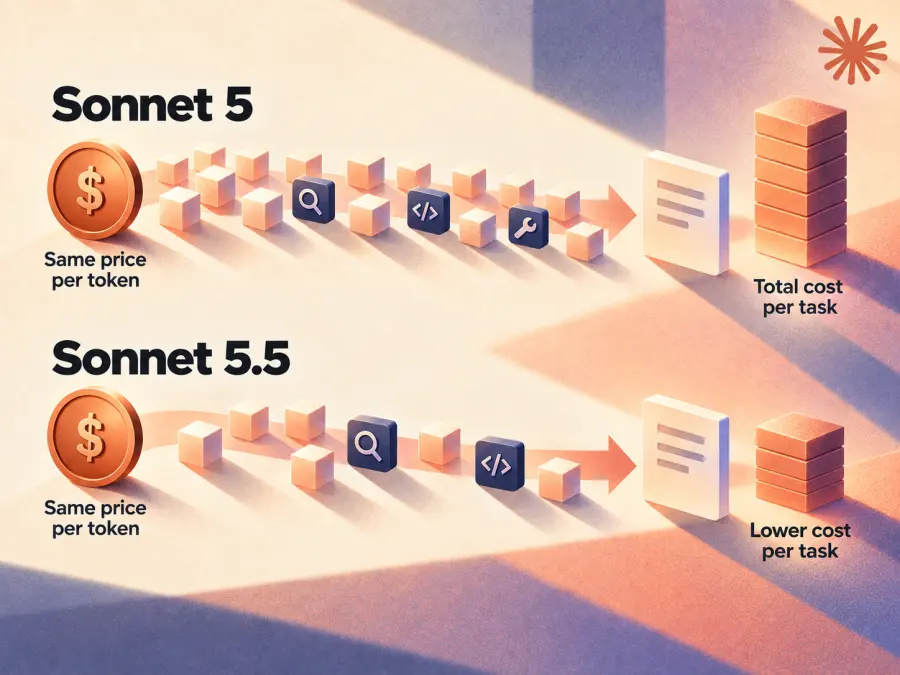
Claude Sonnet 5.5 a le même prix API par token que Sonnet 5. Anthropic affirme néanmoins que le nouveau modèle peut coûter moins cher pour terminer une tâche. Cela semble contradictoire jusqu'à ce que l'on sépare le prix de chaque token du nombre de tokens et d'appels d'outils qu'une tâche nécessite réellement.
La réponse courte : Claude Sonnet 5.5 est la mise à jour du 28 septembre 2026 d'Anthropic pour son modèle Sonnet destiné au code, au travail documentaire et à d'autres tâches avec un objectif clair. Il accepte le texte et les images, renvoie du texte, et est disponible dans Claude Code et via l'API Claude. Anthropic signale une sortie plus rapide et de meilleurs résultats que Sonnet 5 sur plusieurs évaluations. Ces résultats sont des raisons de tester une mise à niveau, pas des garanties pour chaque base de code ou flux de travail. La page du modèle Claude Sonnet 5.5 sur GPTProto est l'endroit où vérifier sa disponibilité sur la plateforme et l'essayer lorsque la fiche est active. L'annonce d'Anthropic présente la sortie et ses affirmations.
Qu'est-ce que Claude Sonnet 5.5 ?
Sonnet est le niveau intermédiaire de la gamme actuelle de Claude. Sonnet 5.5 est conçu pour traiter rapidement des tâches définies et répétables : implémenter une fonctionnalité spécifiée, corriger un bug, vérifier un document par rapport à des sources, ou produire une présentation à partir d'un brief. Anthropic positionne Opus 5.5 pour les travaux plus difficiles et ouverts qui nécessitent un jugement soutenu. La distinction compte davantage que le numéro de version. Un score élevé à un test de codage ne fait pas de Sonnet le meilleur choix pour chaque décision d'architecture.
| Spécifications |
Claude Sonnet 5.5 |
| Date de sortie |
28 septembre 2026 |
| ID du modèle Claude API |
claude-sonnet-5-5 |
| Fenêtre de contexte |
1 million de tokens |
| Sortie maximale |
128 000 tokens sur les requêtes standard |
| Modalités |
Entrée texte et image ; sortie texte |
| Réflexion |
Adaptatif, activé par défaut |
Ce sont les spécifications publiées d'Anthropic. Une fenêtre de contexte de 1 million de tokens est importante, mais ce n'est pas un nouvel avantage par rapport à Sonnet 5, qui prend également en charge 1 million de tokens. Une grande fenêtre ne prouve pas non plus que chaque détail d'une longue entrée sera utilisé correctement. Sonnet 5.5 conserve également le tokenizer de Sonnet 5, donc un texte identique a le même nombre de tokens sur ces deux modèles. documentation de migration d'Anthropic rend ce dernier point explicite.
Qu'est-ce qui a changé par rapport à Sonnet 5 ?
Le changement utile réside dans la quantité de travail que Sonnet 5.5 peut accomplir pour une durée et une puissance de calcul données. Anthropic affirme qu'il génère des sorties plus de 30 % plus rapidement que Sonnet 5. Dans son évaluation de codage agentique Terminal-Bench 4.0, Sonnet 5.5 a obtenu 70,6 %, contre 10,3 % pour Sonnet 5. Il indique également que le nouveau modèle regroupe plus souvent les appels d'outils, ce qui réduit le nombre d'étapes nécessaires pour certaines tâches de codage. Ce sont les résultats d'Anthropic, mesurés dans des configurations de test spécifiques.
Il existe une vérification externe, mais elle pose une question différente. Sur CursorBench 4.0, Sonnet 5.5 avec un effort élevé a obtenu 47,8 % à un coût signalé de 1,67 $ par tâche évaluée ; Sonnet 5 avec un effort élevé a obtenu 30,8 % à 3,48 $. Cela soutient une amélioration dans l'environnement de codage de Cursor. Cela ne prédit pas l'économie exacte pour un client API utilisant un autre agent, prompt ou dépôt.
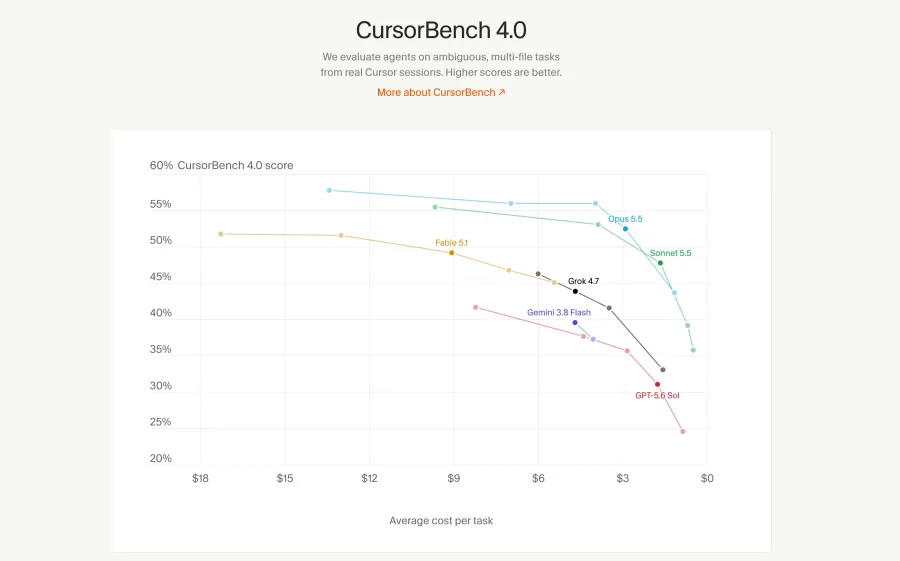
La mise à niveau est donc plus intéressante qu'une simple montée de version pour les équipes de développement. Le compromis est qu'un bon résultat de benchmark doit encore résister à vos propres tests. Si vous voulez le point de départ du modèle précédent, consultez notre guide Sonnet 5 et page API Sonnet 5.
Tarification de Sonnet 5.5 : même tarif catalogue, potentiellement moins de tokens par tâche
Aux tarifs API publiés d'Anthropic, Sonnet 5.5 coûte le même prix par million de tokens que Sonnet 5. Le tarif Sonnet 5.5 de GPT Proto est 10 % inférieur à ces tarifs d'entrée et de sortie :
| Par million de tokens |
Tarif catalogue Anthropic |
GPT Proto Sonnet 5.5 |
| Entrée |
2,00 $ |
1,80 $ |
| Sortie |
10,00 $ |
9,00 $ |
Anthropic facture les lectures de cache à 0,20 $ par million de tokens ; les écritures de cache et les autres frais ont leurs propres tarifs. Consultez la page du modèle GPT Proto pour ses détails de facturation en direct avant d'estimer une charge de travail avec cache. Les tarifs Anthropic et le fait qu'ils correspondent à Sonnet 5 proviennent de l'annonce de sortie. Les tarifs d'entrée et de sortie de GPT Proto ci-dessus reflètent sa remise de 10 % sur le modèle.
Voici un calcul volontairement simple. Si une requête utilise 100 000 tokens d'entrée ordinaires et 20 000 tokens de sortie, sans frais de cache ni d'outils, le coût en tokens serait de 0,40 $ aux tarifs catalogue d'Anthropic et de 0,36 $ aux tarifs annoncés de GPT Proto. Il s'agit d'une comparaison pour une utilisation identique de tokens. Séparément, Anthropic indique que Sonnet 5.5 a utilisé moins de tokens pour accomplir des tâches typiques lors de ses tests, réduisant le coût par tâche terminée de jusqu'à 30 % par rapport à Sonnet 5. Votre résultat dépend de la tâche et du réglage d'effort ; 30 % n'est pas une réduction du tarif des tokens, et cela ne doit pas être ajouté mécaniquement à la remise de 10 % de GPT Proto. Consultez la tarification GPT Proto pour les informations de facturation au niveau du compte.
Sonnet 5.5 est-il bon pour le codage et disponible dans Claude Code ?
Oui. guide des modèles Claude Code d'Anthropic répertorie Sonnet 5.5. Utilisez /model dans Claude Code pour le sélectionner, ou démarrez une session avec claude --model claude-sonnet-5-5. Claude Code et les applications Claude utilisent par défaut l'effort moyen pour ce modèle ; l'API Claude utilise par défaut l'effort élevé. L'effort contrôle la durée pendant laquelle le modèle travaille sur un problème, ce qui affecte la qualité, le temps et la sortie facturée. Les valeurs par défaut comptent donc lorsqu'une personne cite un score obtenu avec un effort maximal comme s'il décrivait une session Claude Code ordinaire.
Dans un test comparatif précoce d'un développeur, l'auteur a exécuté dix tâches de codage personnelles trois fois par configuration avec un effort élevé dans Claude Code et pi-agent. Sonnet 5.5 a utilisé moins de tours et de tokens de sortie que Sonnet 5 dans cette configuration. L'auteur a également noté que les modèles plus récents réussissaient déjà presque toutes les tâches, ce qui limite ce que le test pouvait dire sur les travaux difficiles. C'est une observation utile sur le flux de travail, pas un taux de réussite universel.
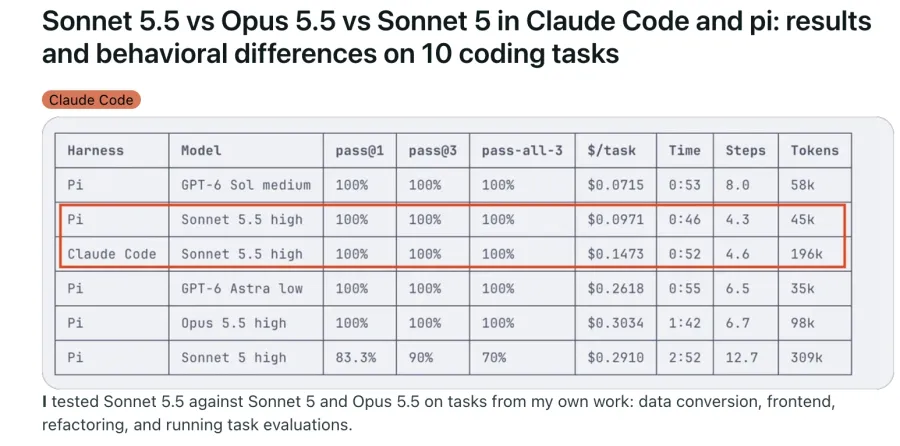
Pour une implémentation bien spécifiée et la correction de bugs, je testerais d'abord Sonnet 5.5. Pour un changement d'architecture ambigu ou une revue où une erreur subtile coûte cher, testez aussi Claude Opus 5.5. Anthropic dit elle-même qu'Opus reste plus fort sur les travaux complexes et ouverts, malgré les scores élevés de Sonnet 5.5 sur des benchmarks individuels. Sa discussion de sortie trace clairement cette frontière.
Devriez-vous mettre à niveau une intégration Sonnet 5 existante ?
Probablement, si votre propre évaluation s'améliore. Mais changer la chaîne de modèle n'est que la première étape pour une intégration API existante. guide de migration Sonnet 5.5 d'Anthropic documente les paramètres de requête qui peuvent renvoyer une erreur 400 après le changement :
| Si votre intégration Sonnet 5 fait ceci |
Vérifiez avant de changer |
Envoie thinking: {"type":"disabled"} |
Sonnet 5.5 utilise between_tools pour son réglage de réflexion le plus bas. |
Force un outil particulier avec tool_choice |
Sonnet 5.5 rejette les choix forcés tool et any ; examinez l'approche documentée auto. |
| Utilise une version plus ancienne de l'outil d'utilisation de l'ordinateur |
L'ensemble d'outils accepté diffère selon la plateforme ; suivez le tableau de migration pour la vôtre. |
| Suppose que le premier bloc de réponse est du texte |
Lisez les blocs par type et préservez les blocs de réflexion dans les boucles d'outils. |
Il y a aussi un changement plus discret : les niveaux d'effort ont été recalibrés. High sur Sonnet 5.5 ne consomme pas nécessairement la même quantité de travail que High sur Sonnet 5. Anthropic recommande de relancer vos propres évaluations pour la qualité, la latence et le coût plutôt que de conserver un réglage précédent. Cela est particulièrement pertinent si votre agent effectue des appels d'outils répétés ou si vous analysez la sortie du modèle dans un format fixe.
Pour une requête de chat GPT Proto de base, utilisez l'action Essayer ce modèle de la page du modèle et le panneau Utilisation de l'API pour confirmer que Sonnet 5.5 est actif et que l'ID de modèle affiché est claude-sonnet-5-5. Une fois qu'il est actif, la requête standard de complétion de chat GPT Proto a cette forme :
curl --request POST 'https://gptproto.com/v1/chat/completions' \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "claude-sonnet-5-5",
    "messages": [{"role": "user", "content": "Summarize the risks in this project brief in three sentences."}]
  }'
Définissez GPTPROTO_API_KEY avec votre propre clé avant de l'exécuter. GPT Proto affiche ce format de requête sur ses pages de modèles Claude existantes ; la page du modèle Sonnet 5.5 est la source finale pour sa chaîne de modèle en direct et sa disponibilité. Les options spécifiques au fournisseur pour l'API Claude Messages nécessitent des vérifications de compatibilité distinctes lorsqu'elles sont utilisées via un endpoint compatible OpenAI.
Comment Sonnet 5.5 se compare-t-il aux autres modèles ?
Un article explicatif ne peut pas trancher chaque recherche « versus » avec un seul classement. La comparaison change selon la tâche, la configuration de l'agent, l'effort et le prix mesurés. Voici trois points de référence utiles mais étroits :
| Question |
Ce qu'un test comparable dit |
Ce qu'il ne peut pas établir |
| Sonnet 5.5 vs GPT-6 Astra |
Dans l'évaluation Code Migration de Vals AI, Sonnet 5.5 a obtenu 69,83 % et Astra 67,74 %. |
Quel modèle est meilleur pour toutes les tâches de codage, de recherche ou d'écriture. |
| Sonnet 5.5 vs GLM-5.3 |
Sur CursorBench 4.0, Sonnet 5.5 High a obtenu 47,8 % et GLM-5.3 High 38,0 %. |
Performance ou coût dans votre propre agent et dépôt. |
| Sonnet 5.5 vs Claude Fable 5.1 |
Sur le Vals Index, Sonnet 5.5 a obtenu 69,22 % et Fable 5.1 68,83 %. |
Un vainqueur global fiable à partir d'un petit écart de score composite. |
Les résultats d'Astra et Fable proviennent de l'évaluation de Vals AI, qui indique avoir utilisé l'effort Max pour la plupart des tests. Le résultat GLM provient de le benchmark propre à Cursor. Ne combinez pas les scores de ces deux sources dans un seul classement. Si une alternative spécifique est moins chère ou correspond déjà à votre pile, le test pertinent est de savoir si Sonnet 5.5 termine votre tâche plus précisément ou avec moins de dépenses totales.
Qui devrait essayer Sonnet 5.5 ?
Commencez par un travail qui a une ligne d'arrivée visible : une modification de code définie, un bug avec un test qui échoue, un document avec un paquet de sources, ou une analyse répétable. Exécutez le même petit lot de tâches réelles avec Sonnet 5 et 5.5 à des réglages d'effort explicites. Suivez si la réponse est correcte, si le modèle a vérifié son travail, combien de temps cela a pris et combien de tokens ont été facturés. Cela vous donne une bien meilleure décision de mise à niveau que de choisir le plus grand pourcentage du jour de lancement.
Sonnet 5.5 est un bon candidat pour ces tâches délimitées. Il est moins prudent de supposer qu'un seul benchmark en fait un substitut à Opus pour les travaux ouverts, ou que l'économie maximale annoncée par Anthropic apparaîtra sur chaque facture. Lorsque la page API Sonnet 5.5 sur GPT Proto sera active, vous pourrez le tester aux côtés des autres modèles liés ci-dessus avec le même compte et comparer vos propres résultats.