Qu’est-ce qu’un fournisseur d’API LLM ?
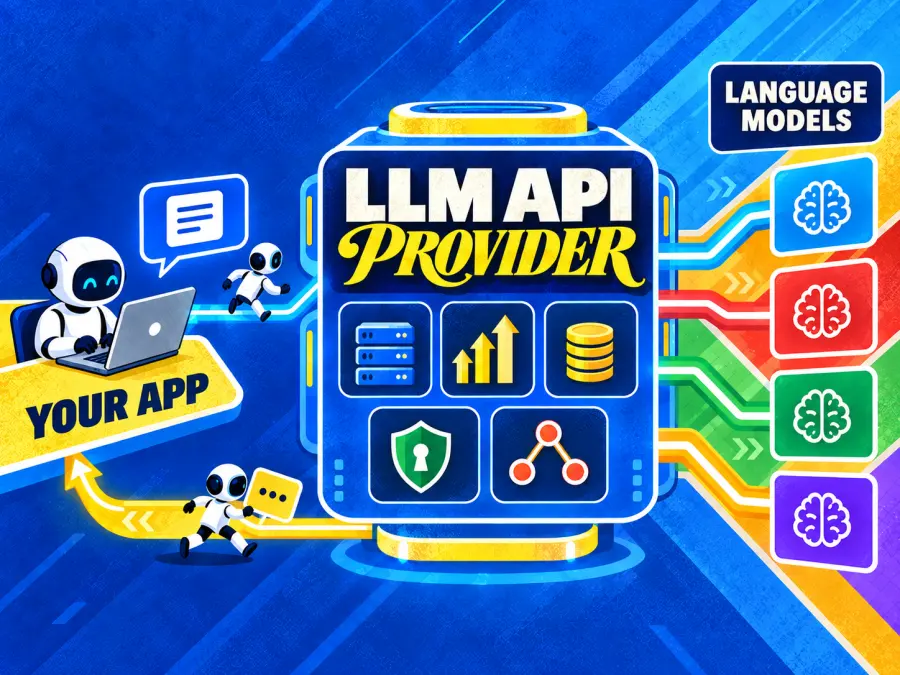
Un fournisseur d’API LLM donne aux développeurs un accès hébergé à des modèles de langage sans qu’ils aient à provisionner et exploiter l’infrastructure d’inférence sous-jacente. Le fournisseur gère le déploiement, la mise à l’échelle, la mesure, l’authentification et—selon la plateforme—le routage, l’observabilité, les contrôles de sécurité ou l’ajustement fin.
Ce terme couvre plusieurs types d’activités différents :
API de modèles de première partie desservent des modèles construits par la même entreprise, comme un laboratoire de modèles exposant ses propres modèles de pointe.
Fournisseurs d’API multi-modèles regroupent des modèles de plusieurs créateurs derrière un seul compte et souvent une seule convention d’API.
Routeurs et passerelles envoient une requête à l’un de plusieurs hôtes sous-jacents selon le prix, la disponibilité, la latence ou des règles définies par l’utilisateur.
Plateformes cloud IA managées combinent l’accès aux modèles avec l’identité d’entreprise, la mise en réseau privée, la gouvernance et d’autres services cloud.
Spécialistes de l’inférence optimisent des modèles ouverts sélectionnés pour la vitesse, le coût, l’ajustement fin ou le déploiement dédié.
Ces catégories se chevauchent. L’important n’est pas simplement, « Ce fournisseur liste-t-il le modèle ? », mais, « Peut-il fournir le modèle avec le protocole, l’économie, la fiabilité et les contrôles exigés par notre application ? »
Comment nous avons classé les meilleurs fournisseurs d’API LLM
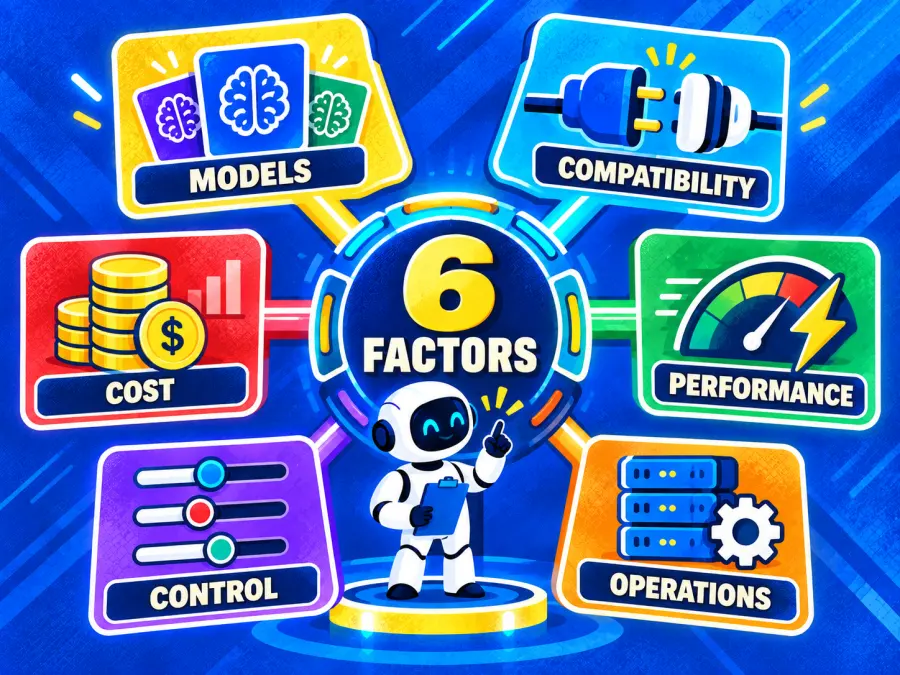
Nous avons évalué chaque fournisseur selon six groupes de facteurs :
Choix de modèles : le nombre et la variété de modèles utiles, pas seulement la taille brute du catalogue
Compatibilité : cohérence de l’API, outils, sorties structurées et streaming
Coût réel : tarifs par token, frais de plateforme, mise en cache, remises par lots et nouvelles tentatives
Performance : temps jusqu’au premier token, débit, latence de queue et comportement de capacité
Contrôle : épinglage du fournisseur, règles de repli, sémantique des erreurs et cycle de vie des modèles
Opérations : identité, régions, mise en réseau, gouvernance, documentation et effort de migration
Aucun fournisseur ne gagne sur tous les facteurs. Notre classement privilégie la meilleure plateforme généraliste pour les équipes qui valorisent un large accès aux modèles, puis identifie les cas où un fournisseur plus spécialisé est le meilleur choix.
Comparaison des fournisseurs d’API LLM
| Rang |
Fournisseur |
Idéal pour |
Profil du catalogue |
Approche API |
Principal compromis |
| 1 |
GPT Proto |
Une clé API pour les modèles LLM et multimodaux |
232 modèles au total, dont 124 modèles textuels au moment de l’évaluation |
Point de terminaison de chat compatible OpenAI pour les LLM pris en charge ; API spécifiques aux tâches pour les autres modalités |
Plateforme plus récente avec un écosystème d’entreprise plus restreint que les hyperscalers |
| 2 |
OpenRouter |
Choix maximal de LLM et routage entre fournisseurs |
Plus de 500 modèles de plus de 80 fournisseurs |
API routée compatible OpenAI avec préférences de fournisseur et replis |
Le routage peut compliquer la mise en cache, la cohérence des performances et l’attribution des coûts |
| 3 |
Amazon Bedrock |
Gouvernance AWS et déploiement en entreprise |
Plus de 100 modèles via Bedrock Marketplace |
Interfaces managées cohérentes, y compris l’API Converse |
Les concepts AWS, la disponibilité régionale et le comportement propre à chaque modèle ajoutent de la complexité |
| 4 |
Together AI |
Modèles ouverts, ajustement fin et expérimentation |
Large catalogue de modèles ouverts |
API serverless compatible OpenAI, plus ajustement fin et options dédiées |
La prise en charge des fonctionnalités varie selon le modèle |
| 5 |
Fireworks AI |
Inférence de modèles ouverts en production |
Plus de 100 modèles disponibles |
API compatibles OpenAI avec déploiement serverless et dédié |
La meilleure adéquation se concentre sur les charges de travail de modèles ouverts |
| 6 |
GroqCloud |
Génération très rapide sur un catalogue ciblé |
Sélection de modèles plus restreinte et organisée |
API principalement compatible OpenAI |
Choix plus étroit et lacunes de compatibilité documentées |
Les totaux de catalogue sont indicatifs et non directement comparables. Une entreprise peut compter les versions de modèles, les modalités, les fournisseurs ou les modèles ajustés différemment d’une autre. La disponibilité évolue aussi plus vite qu’une liste annuelle ne peut le capturer.
1. GPT Proto — Meilleur fournisseur global d’API LLM multi-modèles
GPT Proto se classe premier pour les développeurs qui veulent un seul compte et une seule clé API pouvant aller au-delà de la génération de texte. Au moment de l’évaluation, son catalogue affichait 232 modèles, dont 124 modèles textuels, ainsi que des options d’image, de vidéo et d’audio.
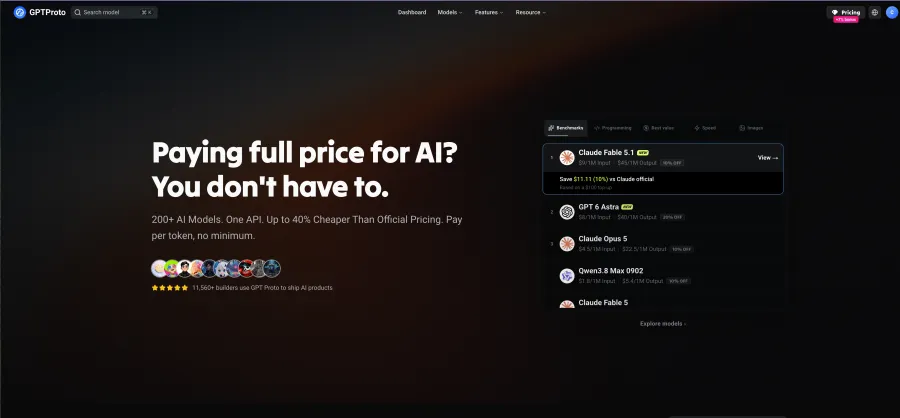
Pour les LLM pris en charge, GPT Proto expose un schéma de complétions de chat compatible OpenAI. Les développeurs peuvent parcourir le catalogue de modèles textuels, consulter les tarifs propres à chaque modèle et tester un modèle avant l’intégration.
Chaque page de modèle expose les tarifs d’entrée et de sortie. L’API GLM-5.3, par exemple, était listée à 1,26 $ par million de tokens d’entrée et 3,96 $ par million de tokens de sortie lors de l’évaluation—10 % en dessous des tarifs directs Z.ai affichés. Les prix peuvent changer, alors consultez la page du modèle.
GPT Proto n’est pas le gagnant par défaut pour chaque entreprise : Bedrock offre une gouvernance AWS plus poussée, OpenRouter un plus large catalogue LLM routé, et les spécialistes peuvent mieux performer pour un modèle ouvert spécifique. Son avantage est une étendue pratique à travers les familles de modèles et les modalités.
Idéal pour : Produits SaaS, agences IA, prototypes évoluant vers la production et applications multimodales.
Attention à : Considérez la compatibilité OpenAI comme spécifique au modèle et au point de terminaison. Les modèles d’image et de vidéo utilisent des corps de requête spécifiques aux tâches plutôt que le format de chat LLM.
2. OpenRouter — Idéal pour l’étendue du catalogue LLM et le routage
OpenRouter est le meilleur choix lorsque l’étendue du catalogue est l’exigence principale. Son offre publiée dépasse 500 modèles auprès de plus de 80 fournisseurs. Un seul point de terminaison peut router les requêtes entre les hôtes sous-jacents, et les développeurs peuvent définir des préférences de fournisseur, autoriser les replis ou utiliser la sélection automatique.
Le compromis est que le routage devient partie intégrante du comportement de l’application. Un même nom de modèle peut s’exécuter sur un hôte, une pile matérielle ou une variante de modèle différents. Cela peut modifier la latence, le contexte pris en charge, la gestion des erreurs et l’économie du cache de prompts. OpenRouter indique aussi des frais de 5,5 % sur les achats de crédits pour son offre standard pay-as-you-go, à inclure dans les calculs de coût total.
Dans de récentes discussions de développeurs, les utilisateurs ont signalé une cohérence de cache inférieure lorsque le trafic changeait de fournisseur. Une analyse communautaire distincte a examiné des milliers d’échanges. Ces rapports sont anecdotiques, mais les équipes avec des prompts longs répétés devraient tester des configurations avec fournisseur épinglé et repli désactivé par rapport au routage par défaut.
Idéal pour : découverte de modèles, large accès aux LLM, routage de repli et applications qui peuvent bénéficier du choix du fournisseur au moment de la requête.
Attention à : frais de plateforme, différences au niveau des fournisseurs, échecs de cache et tension entre repli automatique et performances déterministes.
3. Amazon Bedrock — Idéal pour les entreprises centrées sur AWS
Amazon Bedrock est l’option la plus convaincante ici pour les organisations déjà présentes dans AWS. Bedrock Marketplace annonce l’accès à plus de 100 modèles, tandis que des services tels qu’Agents, Knowledge Bases et Guardrails relient l’inférence de modèles à une pile managée plus large.
Sa valeur centrale est la gouvernance plutôt que le nombre brut de modèles. Les clients AWS peuvent aligner l’accès aux modèles sur leurs schémas familiers d’identité, de journalisation, de région, de réseau, d’achat et de sécurité. L’API Converse donne aux modèles pris en charge une interface plus cohérente basée sur les messages, réduisant certaines différences d’intégration entre fournisseurs. AWS indique aussi que le contenu envoyé via cette API n’est pas stocké, une considération importante pour l’évaluation en entreprise.
La cohérence ne signifie pas que chaque modèle se comporte de manière identique. La disponibilité varie selon la région, la prise en charge des capacités diffère, et les concepts de compte AWS ou de limite de service ajoutent du travail. Ces coûts ont moins de sens pour une petite équipe qui n’a besoin que d’une clé et d’un point de terminaison de chat.
Idéal pour : charges de travail réglementées, équipes AWS établies et entreprises qui veulent un accès aux modèles à l’intérieur d’un périmètre de gouvernance cloud existant.
Attention à : disponibilité propre à chaque région, fonctionnalités propres à chaque modèle, quotas de service et surcharge d’architecture cloud.
4. Together AI — Idéal pour l’expérimentation et l’ajustement fin de modèles ouverts
Together AI est un solide fournisseur d’API de modèles LLM pour les équipes travaillant principalement avec des modèles ouverts. Son service serverless utilise une tarification par token sans provisionner de réplicas ni s’engager sur un coût de déploiement minimum. La plateforme prend aussi en charge l’ajustement fin et les points de terminaison dédiés, offrant aux équipes un chemin de l’évaluation rapide à un déploiement plus contrôlé.
L’interface compatible OpenAI réduit l’effort de migration pour les charges de travail de chat standard. Together publie aussi des indicateurs de capacités pour des fonctionnalités telles que l’appel de fonctions et les sorties structurées. Ces indicateurs comptent parce que la prise en charge des fonctionnalités n’est pas uniforme dans le catalogue ; un modèle excellent pour la génération simple peut ne pas satisfaire un workflow d’agent qui dépend d’un JSON strict ou d’appels d’outils fiables.
Together offre plus de profondeur qu’un simple routeur pour les équipes qui veulent ajuster finement un modèle ouvert, le tester via un point de terminaison hébergé, puis choisir plus tard un service dédié. Les équipes doivent toujours sélectionner le bon modèle, le bon mode de service et le bon ensemble de fonctionnalités.
Idéal pour : recherche sur les modèles ouverts, ajustement fin, évaluation et équipes susceptibles de passer du serverless à l’inférence dédiée.
Attention à : prise en charge par modèle des outils, de la sortie structurée, du contexte et des modes de service.
5. Fireworks AI — Idéal pour le déploiement de modèles ouverts en production
Fireworks AI se concentre sur le service de modèles ouverts pour un usage en production. Elle liste plus de 100 modèles disponibles et propose à la fois un accès serverless et des déploiements dédiés. Sa surface d’API inclut des interfaces Chat Completions et de style Responses compatibles OpenAI, ce qui peut réduire les modifications de code nécessaires pour les applications LLM courantes.
La plateforme est particulièrement pertinente lorsqu’une équipe veut commencer par l’inférence serverless à la tarification par token, puis déplacer une charge de travail stable vers une capacité plus isolée. L’inférence par lots est facturée à 50 % des tarifs serverless pour les charges de travail pouvant attendre, créant un chemin d’optimisation clair pour l’enrichissement hors ligne, la classification, le résumé et les traitements de données.
benchmarks d’inférence indépendants montrent aussi pourquoi aucun fournisseur ne devrait recevoir une étiquette permanente de « rapidité ». Les performances varient selon le modèle, la région, la charge et la méthode de mesure. Testez la paire exacte fournisseur-modèle avec des prompts réalistes plutôt que de transférer un résultat d’un modèle à toute la plateforme.
Idéal pour : inférence de modèles ouverts en production, charges de travail pouvant nécessiter une capacité dédiée et tâches par lots tolérantes aux délais.
Attention à : variation des performances d’un modèle à l’autre et adéquation entre déploiement serverless, par lots ou dédié et la charge de travail.
6. GroqCloud — Idéal pour la génération de texte à faible latence
GroqCloud est le spécialiste de cette liste. Son catalogue ciblé fonctionne sur l’architecture d’inférence de Groq, et des mesures publiques ont placé à plusieurs reprises les modèles pris en charge parmi les plus rapides pour la génération de tokens. Cela le rend attrayant pour les agents interactifs, les pipelines vocaux, les outils de codage et d’autres expériences où les utilisateurs ressentent chaque pause.
Groq décrit son API comme principalement compatible OpenAI, et le qualificatif compte. Sa documentation identifie des champs non pris en charge, notamment logprobs, logit_bias, top_logprobs et messages[].name ; n doit être défini sur 1. Le traitement Flex permet des limites de débit bien plus élevées, mais peut renvoyer une réponse 498 capacity_exceeded lorsque la capacité est indisponible. Les modèles en aperçu peuvent aussi être abandonnés avec un préavis court.
Choisissez GroqCloud lorsqu’un modèle pris en charge correspond à la tâche et que la latence a une valeur produit mesurable. Ne le choisissez pas uniquement parce qu’un framework dispose déjà d’un adaptateur OpenAI.
Idéal pour : assistants en temps réel, boucles d’agents, applications vocales et génération sensible à la latence sur les modèles pris en charge.
Attention à : sélection de modèles plus restreinte, champs de requête non pris en charge, comportement de capacité et risque lié au cycle de vie des modèles en aperçu.
Pourquoi le même LLM peut se comporter différemment selon les fournisseurs
Une étude de mesure de 2026, « Quand le même modèle n’est-il pas le même service ? », soutient qu’un modèle hébergé doit être traité comme un objet de service propre à un fournisseur. Son comportement observé inclut la variante du modèle, le protocole, la capacité de contexte, le prix, la latence, le débit, la fiabilité et la faisabilité de la tâche—pas seulement le nom du modèle.
Cette distinction donne aux développeurs un meilleur cadre de comparaison des fournisseurs d’API LLM :
Identité et version du modèle
Deux points de terminaison peuvent afficher la même famille de modèles tout en servant des checkpoints, quantifications, niveaux de précision ou calendriers de mise à jour différents. Demandez si l’identifiant du modèle est épinglé à une version et ce qui se passe lorsqu’un modèle amont change.
Compatibilité au-delà de l’URL de base
« Compatible OpenAI » signifie souvent que le fournisseur accepte une requête de complétions de chat familière. Cela ne garantit pas la prise en charge de chaque paramètre, schéma d’outil, événement de streaming, champ de réponse ou code d’erreur. Créez un test de contrat pour les fonctionnalités que votre application utilise réellement.
Stabilité du routage et du cache
Le routage automatique peut améliorer la disponibilité, mais le changement de fournisseur peut réduire la réutilisation du cache de prompts. Si un contexte répété domine votre facture d’entrée, testez un hôte fixe par rapport au trafic routé. Comparez le coût effectif par tâche terminée, et non le prix annoncé par million de tokens.
Latence, débit et erreurs
Mesurez toute la distribution. La latence P50 décrit un appel typique ; P95 ou P99 expose les queues lentes. Suivez le temps jusqu’au premier token séparément de la vitesse de génération. Enregistrez les limites de débit, les délais d’attente, les erreurs de capacité et le succès des nouvelles tentatives, car un point de terminaison bon marché qui nécessite de fréquentes reprises peut coûter cher en calcul et en patience des utilisateurs.
La même étude donne une indication utile du gain potentiel : dans les cas mesurés, le routage a réduit le coût d’une charge de travail Qwen3-32B de 37,8 %, tandis que le choix du fournisseur a augmenté le débit d’une charge de travail DeepSeek-V3.2 d’environ 90 %. Ces résultats dépendent de la charge de travail, mais ils montrent pourquoi la couche fournisseur mérite sa propre évaluation.
Quel fournisseur d’API LLM choisir ?
Utilisez le classement comme une présélection, puis décidez selon la charge de travail :
Choisissez GPT Proto pour un large accès au texte et aux médias avec une seule clé.
Choisissez OpenRouter pour un choix maximal de LLM et le routage entre fournisseurs.
Choisissez Amazon Bedrock pour la gouvernance AWS et les services managés.
Choisissez Together AI pour l’expérimentation et l’ajustement fin de modèles ouverts.
Choisissez Fireworks AI pour le déploiement de modèles ouverts en production.
Choisissez GroqCloud pour la génération sensible à la latence sur les modèles pris en charge.
Gardez une API de première partie dans la comparaison lorsqu’un modèle propriétaire est une dépendance stable. Sinon, testez au moins deux fournisseurs avec des conversations en cache, des appels d’outils, des réponses structurées, une concurrence de pointe et des échecs—pas seulement de courts prompts de démonstration.
Comment accéder à plusieurs LLM avec une seule clé API GPT Proto
Commencez dans le catalogue de modèles textuels de GPT Proto, ouvrez une page de modèle et utilisez l’option Essayer ce modèle du modèle pour confirmer la sortie avant l’intégration. Après avoir créé une clé API, envoyez une requête standard de complétions de chat :
export GPTPROTO_API_KEY="replace_with_your_key"

curl https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3",
    "messages": [
      {
        "role": "user",
        "content": "Return a JSON comparison of two caching strategies."
      }
    ]
  }'
Pour un autre LLM compatible, remplacez la valeur model par l’identifiant indiqué sur sa page de modèle. Gardez la sélection du modèle dans la configuration plutôt que de la coder en dur dans toute l’application, et validez la prise en charge des fonctionnalités avant de changer. Les modèles d’image, de vidéo et d’audio utilisent leurs points de terminaison et corps de requête spécifiques aux tâches.
Verdict final
Le meilleur fournisseur d’API LLM est celui qui transforme le bon modèle en un service fiable pour votre charge de travail. La qualité du modèle fixe le plafond, mais la compatibilité, le comportement du cache, la latence, la gestion des erreurs, la politique de cycle de vie et le coût total déterminent ce que les utilisateurs vivent réellement.
Pour un usage quotidien étendu, GPT Proto offre le point de départ le plus équilibré dans cette comparaison de six fournisseurs : une clé, un large catalogue textuel, des pages de modèles transparentes et l’accès à d’autres API de médias génératifs. OpenRouter l’emporte sur l’étendue des LLM routés ; Amazon Bedrock sur les contrôles d’entreprise AWS ; Together AI et Fireworks AI sur différentes étapes du cycle de vie des modèles ouverts ; et GroqCloud sur l’inférence axée sur la vitesse.
Présélectionnez la catégorie de fournisseur qui correspond à vos besoins d’exploitation, puis évaluez la combinaison exacte fournisseur-modèle-tâche. En 2026, cette combinaison de services—pas seulement le logo ou le nom du modèle—est l’unité qu’il vaut la peine de choisir.