Qu'est-ce que Hunyuan 4 — ou Hy4 Preview ?
Hy4 preview est un grand modèle de langage à poids ouverts développé par l'équipe Tencent Hy. Il est conçu principalement pour les travaux de productivité de longue durée : ingénierie logicielle, analyse de documents, modélisation financière, développement de jeux, recherche scientifique et agents qui doivent planifier, appeler des outils et vérifier les résultats sur plusieurs étapes.
C'est un modèle textuel. La famille Hunyuan plus large de Tencent inclut des systèmes d'image, de vidéo et de 3D, mais ces capacités au niveau de la famille ne doivent pas être attribuées à Hy4 preview lui-même. La fiche actuelle de TokenHub couvre l'entrée et la sortie de texte, ainsi que le raisonnement, la sortie structurée, l'appel de fonctions et la mise en cache des prompts.
| Spécifications |
Hy4 preview |
| Développeur |
Tencent Hy Team |
| Date de sortie |
28 août 2026 |
| Statut de version |
Aperçu |
| Architecture |
Mixture-of-Experts |
| Paramètres totaux |
770B |
| Paramètres actifs |
49B par token |
| Couches de backbone |
78 |
| Fenêtre de contexte |
1M de tokens |
| Entrée API maximale |
960K tokens |
| Sortie API maximale |
64K tokens |
| Modalité d'entrée |
Texte |
| Modalité de sortie |
Texte |
| ID de modèle API |
hy4-preview |
| Licence |
Apache 2.0 |
| Disponibilité GPT Proto |
Bientôt disponible |
Hy4 Preview est-il identique à Hunyuan-4B ?
Non. Les noms se ressemblent, mais désignent des modèles très différents.
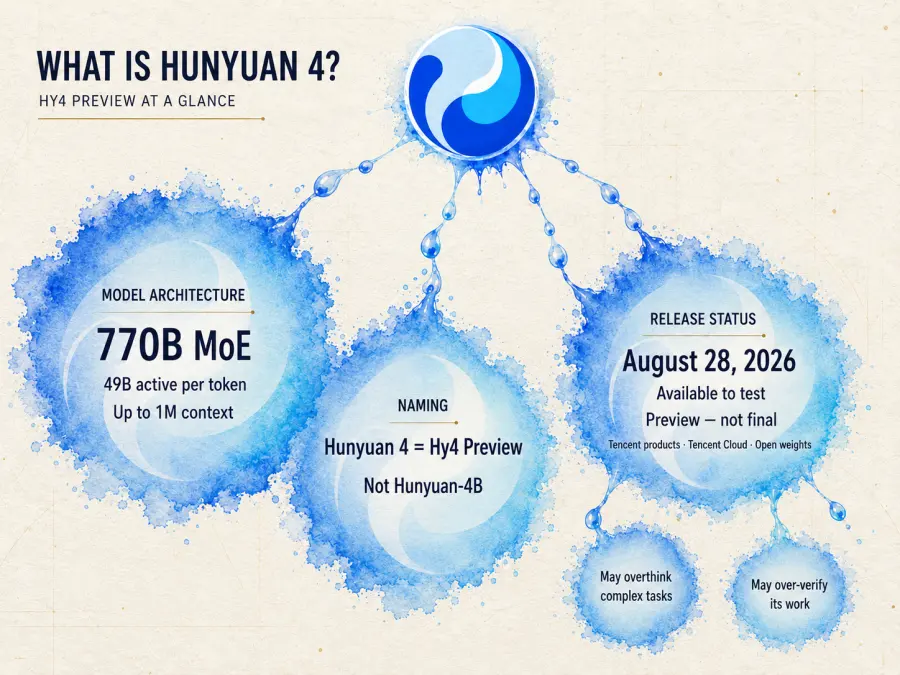
Hunyuan-4B est un membre à quatre milliards de paramètres de la famille de modèles denses antérieure de Tencent. Le « 4B » fait référence au nombre de paramètres. Hy4 preview est le fleuron de nouvelle génération de Tencent avec 770 milliards de paramètres totaux et une architecture Mixture-of-Experts.
Utiliser « Hunyuan 4 » sans le mot « preview » est compréhensible pour la recherche, mais la documentation technique devrait utiliser Hy4 preview pour éviter toute confusion.
Pourquoi est-il appelé Hy4 « Preview » ?
Tencent publie des modèles preview avant que la génération finale ne soit terminée afin que l'équipe puisse recueillir des retours issus de véritables flux de travail de codage, de recherche et de productivité. Hy4 preview est donc plus qu'une démonstration fermée — les poids, la documentation et l'API hébergée sont déjà disponibles — mais son comportement et sa configuration de service peuvent encore changer.
Tencent n'a pas annoncé de date de sortie finale pour Hy4. Son annonce de lancement indique seulement que d'autres modèles de la série Hy4 devraient arriver bientôt. Tout mois exact qui circule actuellement pour la version finale relève de la spéculation.
L'étiquette preview s'accompagne également de deux limitations divulguées :
Ces comportements peuvent améliorer la fiabilité sur un problème d'ingénierie difficile. Le compromis est une latence plus élevée et potentiellement plus de tokens de sortie sur des tâches qu'un modèle plus petit ou plus rapide pourrait traiter directement.
Mon interprétation est simple : Hy4 preview est prêt pour l'évaluation, pas pour une migration aveugle. Une équipe peut l'exécuter sur une charge de travail fantôme dès aujourd'hui, mais le remplacement d'un modèle de production existant devrait attendre qu'il réussisse les propres tests de régression de cette équipe.
Comment fonctionne Hy4 Preview ?
Hy4 preview est grand, même selon les standards actuels des modèles ouverts, mais ses 770 milliards de paramètres ne sont pas tous utilisés pour chaque token.
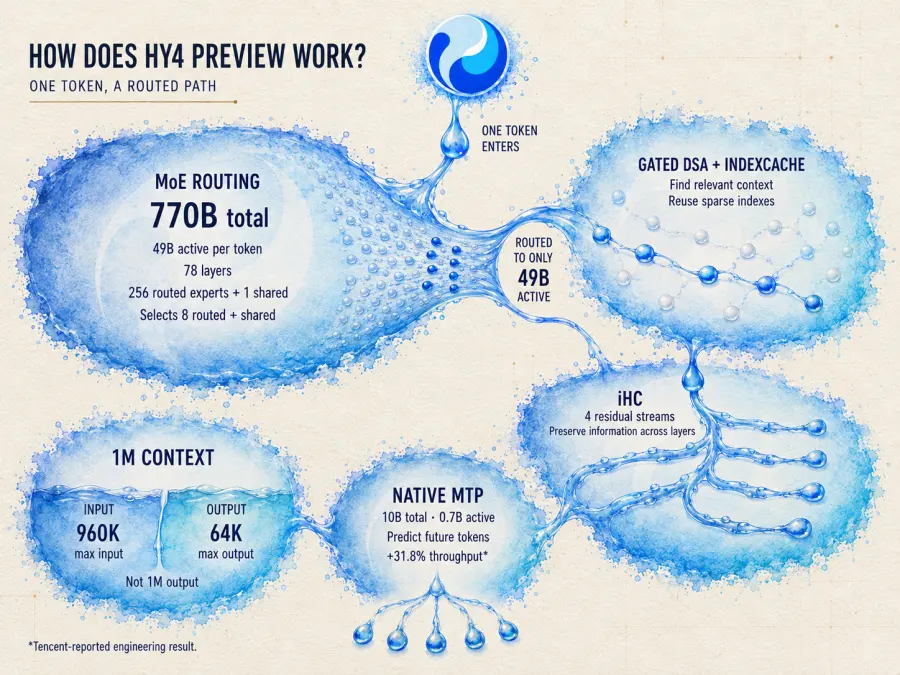
770B de paramètres totaux, 49B actifs
Le modèle utilise une architecture Mixture-of-Experts. Une façon simple de se le représenter est de penser à une grande organisation technique : de nombreuses équipes spécialisées existent, mais seuls les spécialistes pertinents pour le problème en cours sont convoqués à chaque réunion.
Hy4 preview possède un backbone de 78 couches. La première couche utilise un réseau feed-forward dense standard, tandis que les 77 autres couches utilisent des blocs MoE. Chacun de ces blocs contient 256 experts routés et un expert partagé. Pour chaque token, le modèle sélectionne huit experts routés aux côtés de l'expert partagé.
Cette sélection réduit le calcul par token par rapport à l'activation des 770 milliards de paramètres. Cela ne rend pas le modèle petit pour autant. Les poids complets doivent toujours être stockés, transférés et distribués lors de l'auto-hébergement.
Gated DSA et IndexCache
Hy4 preview utilise Gated DeepSeek Sparse Attention, ou Gated DSA, avec IndexCache. Au lieu de traiter chaque token précédent comme également pertinent, l'attention sparse tente d'identifier les parties d'un long contexte qui comptent le plus pour l'étape en cours.
IndexCache réutilise les index d'attention sparse entre les couches. L'objectif est de réduire le travail répété lorsque le modèle traite des documents ou des bases de code très longs.
iHC et flux résiduels multiples
Le modèle utilise également des identity Hyper-Connections, abrégées en iHC. Son backbone maintient quatre flux résiduels pour élargir la façon dont l'information peut circuler entre les couches.
Pour la plupart des utilisateurs d'API, le nom importe moins que le résultat visé : le modèle est conçu pour préserver et transformer l'information au fil de tâches longues et à plusieurs étapes, plutôt que de répondre uniquement à des prompts courts et isolés.
MTP natif pour le décodage spéculatif
En dehors du backbone principal, Tencent inclut une couche native Multi-Token Prediction avec 10 milliards de paramètres totaux et 0,7 milliard de paramètres actifs. Elle peut prédire plusieurs tokens futurs pour le décodage spéculatif, ce qui peut améliorer le débit de génération lorsque la pile de service le prend en charge.
Tencent indique également que Hy4 preview a aidé à analyser et optimiser certaines parties de son propre système d'inférence. Des changements impliquant la fusion d'opérateurs et la communication ont augmenté le débit de bout en bout de 31,8 % par rapport à la base de référence de Tencent. Il s'agit d'un résultat d'ingénierie rapporté par le fournisseur, et non encore d'un benchmark de service reproduit indépendamment.
Une fenêtre de contexte de 1M ne signifie pas 1M de tokens de sortie
La fenêtre de contexte annoncée est d'un million de tokens, mais les limites hébergées sont plus précises :
Entrée maximale : 960K tokens
Sortie maximale : 64K tokens
Fenêtre de contexte totale : environ 1M de tokens
Cela représente une capacité d'entrée suffisante pour de grands dépôts, des collections de documents ou de longs historiques d'agents. Cela ne signifie pas que le modèle peut générer une réponse d'un million de tokens. La documentation TokenHub de Tencent plafonne la sortie à 64K tokens.
Principales fonctionnalités de Hunyuan 4
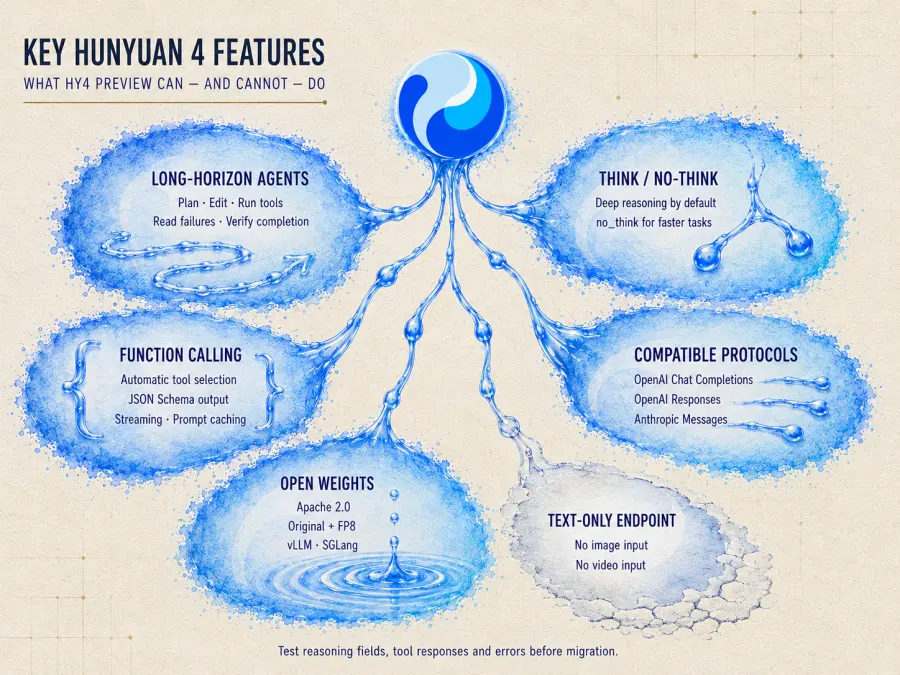
Codage et travail d'agent sur long horizon
Tencent positionne Hy4 preview pour des tâches de codage qui exigent plus que la génération d'une seule fonction. Sa charge de travail prévue inclut la compréhension d'un dépôt, la planification des changements, l'édition de fichiers, l'exécution d'outils, la lecture des échecs et la vérification qu'une tâche est réellement terminée.
C'est une distinction importante. Un modèle peut bien performer sur des questions de code isolées tout en perdant le fil de l'état après dix appels d'outils. Hy4 preview est entraîné et évalué autour de la boucle complète.
Tencent a également co-conçu le modèle avec des produits tels que CodeBuddy et WorkBuddy. Cela donne à ses tests internes une pertinence plus pratique qu'une collection de questions à choix multiples, bien qu'ils restent des évaluations menées par Tencent.
Modes de raisonnement High et No-Think
Hy4 preview prend en charge à la fois le raisonnement approfondi et les modes de réponse directe. Le raisonnement approfondi est activé par défaut dans l'exemple de déploiement officiel et est destiné aux tâches difficiles de codage, de mathématiques et de recherche.
Pour les travaux plus simples, les développeurs peuvent désactiver le raisonnement étendu avec no_think ou le paramètre API correspondant. Cela est utile pour :
Laisser le raisonnement approfondi activé pour chaque requête peut gaspiller du temps et des tokens de sortie. Les limitations connues du modèle rendent cette décision de routage particulièrement importante.
Appel de fonctions et sortie structurée
Le modèle hébergé prend en charge l'appel de fonctions, la sélection automatique d'outils et la sortie contrainte par JSON Schema. Ces fonctionnalités rendent Hy4 preview adapté aux agents qui doivent interagir avec la recherche, des bases de données, des environnements de développement ou des services internes.
Il prend également en charge le streaming et la mise en cache des prompts. Le streaming améliore le temps de réponse perçu pour les générations longues, tandis que la tarification des entrées mises en cache peut réduire le coût de l'envoi répété du même prompt système, du contexte de dépôt ou de documents de référence.
Protocoles compatibles OpenAI et Anthropic
Tencent Cloud documente la prise en charge de :
OpenAI Chat Completions
OpenAI Responses
Anthropic Messages
Une application existante peut donc être en mesure de tester Hy4 preview en changeant son URL de base, son authentification et son ID de modèle au lieu de réécrire toute la structure des requêtes.
Cela ne garantit pas un comportement identique. Les champs de raisonnement, les réponses d'appel d'outil, la sortie maximale et la gestion des erreurs doivent encore être testés avant de déplacer le trafic.
Poids ouverts sous Apache 2.0
Tencent a publié à la fois le modèle original et une version FP8 sous licence Apache 2.0. Les développeurs peuvent inspecter le modèle, le déployer avec vLLM ou SGLang, l'affiner et créer des versions quantifiées.
Les recettes FP8 officielles utilisent un parallélisme tensoriel à huit voies. Les poids ouverts suppriment la dépendance à un point de terminaison hébergé unique, mais ils ne suppriment pas l'exigence d'infrastructure. Un modèle de 770B reste un projet de déploiement sérieux.
Hunyuan 4 prend-il en charge les images ou la vidéo ?
Le point de terminaison Hy4 preview actuel est uniquement textuel.
C'est l'une de ses limites les plus évidentes par rapport aux modèles de codage multimodaux plus récents. Il ne peut pas inspecter directement une capture d'écran, lire une maquette d'interface ou raisonner sur un enregistrement vidéo via le point de terminaison documenté.
Pour un dépôt ou un flux de travail documentaire uniquement textuel, cela peut ne pas avoir d'importance. Pour un agent frontend qui doit inspecter une sortie visuelle, cela peut décider du choix du modèle avant même de considérer les scores de benchmark.
Tarification et disponibilité de Hunyuan 4
La tarification internationale officielle de Tencent est :
| Type de token |
Prix de Hy4 preview |
| Entrée |
0,834 $ par 1M de tokens |
| Sortie |
2,501 $ par 1M de tokens |
| Entrée mise en cache |
0,042 $ par 1M de tokens |
L'entrée mise en cache coûte environ 5 % du tarif d'entrée standard. Cela peut modifier sensiblement le coût d'un agent qui lit répétitivement les mêmes instructions de projet ou documents.
Hy4 preview est actuellement accessible via Tencent Cloud TokenHub et des produits Tencent, notamment WorkBuddy, CodeBuddy, Yuanbao et ima. Tencent a également proposé un essai de deux semaines pendant la période de lancement via WorkBuddy et CodeBuddy. Comme il s'agit d'une promotion temporaire, elle ne doit pas être considérée comme le niveau gratuit permanent du modèle.
L'auto-hébergement est-il moins cher ?
Peut-être à volume élevé et soutenu. Pas automatiquement.
Les poids originaux sont suffisamment volumineux pour exiger une infrastructure spécialisée, et les exemples de déploiement FP8 officiels répartissent le modèle sur huit GPU. L'auto-hébergement ajoute aussi du temps d'ingénierie, de la surveillance, des mises à niveau, du stockage, du réseau et de la capacité inactive.
AngelSlim a publié un GGUF quantifié STQ1 de 229 Go aux côtés d'une version Q4 de 467 Go. Le téléchargement plus petit rend l'expérimentation locale plus réaliste, mais des membres de la communauté ont correctement remis en question la transposition de la rétention moyenne des benchmarks au codage en contexte long et aux appels d'outils répétés. De petites erreurs peuvent s'accumuler sur une longue exécution d'agent même lorsque les tests courts restent stables.
Pour de nombreuses équipes, le tarif hébergé par token sera plus facile à évaluer que l'économie d'infrastructure d'un déploiement sur huit GPU.
Benchmarks de Hunyuan 4 : quelle est la puissance de Hy4 Preview ?
Hy4 preview dispose d'une vaste annexe de benchmarks, mais presque tous les chiffres du jour de lancement proviennent de Tencent. Cela ne les rend pas inutiles. Cela signifie qu'ils doivent être étiquetés correctement.
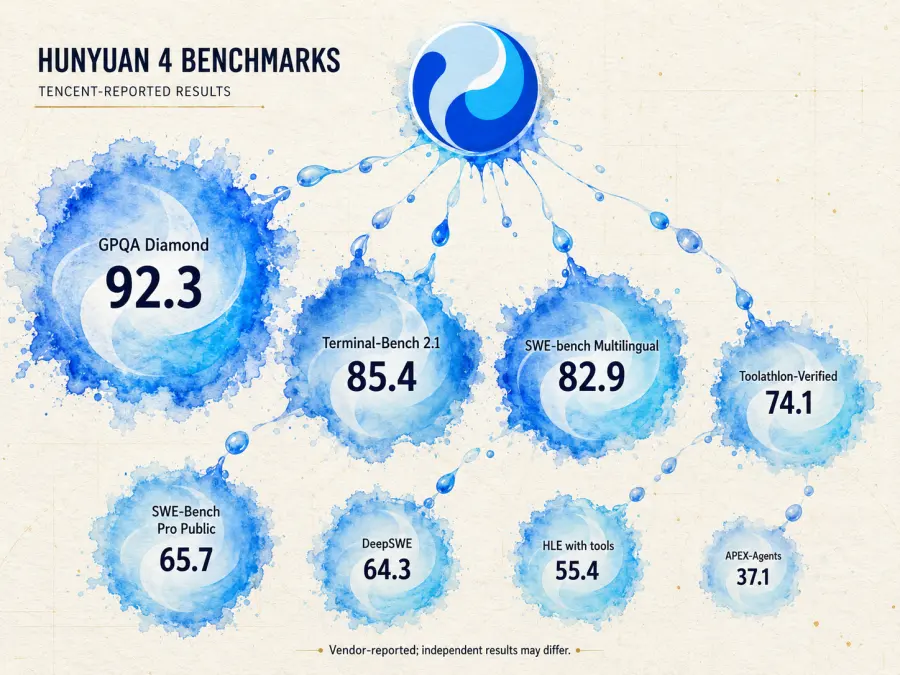
Les résultats sélectionnés rapportés par Tencent incluent :
| Benchmark |
Hy4 preview |
Statut des preuves |
| GPQA Diamond |
92,3 |
Rapporté par le fournisseur |
| Terminal-Bench 2.1 |
85,4 |
Rapporté par le fournisseur |
| SWE-bench Multilingual |
82,9 |
Rapporté par le fournisseur |
| Toolathlon-Verified |
74,1 |
Rapporté par le fournisseur |
| SWE-Bench Pro Public |
65,7 |
Rapporté par le fournisseur |
| DeepSWE |
64,3 |
Rapporté par le fournisseur |
| HLE avec outils |
55,4 |
Rapporté par le fournisseur |
| APEX-Agents |
37,1 |
Rapporté par le fournisseur |
Ces résultats suggèrent que le codage, l'utilisation d'outils et le raisonnement scientifique sont centraux dans l'entraînement du modèle. Ils ne prouvent pas le même classement dans un autre cadre d'agent, budget d'outils ou configuration de service.
[Emplacement d'image : benchmarks sélectionnés de Hy4 preview séparés entre preuves rapportées par le fournisseur et preuves externes]
Test aveugle interne de Tencent sur 203 tâches
Tencent a également demandé à 163 experts internes d'évaluer les sorties du modèle sur 203 tâches d'ingénierie.
| Modèle |
Score moyen |
| Hy4 preview |
2,99 / 4 |
| Kimi K3 |
2,94 / 4 |
| GLM‑5.3 |
2,92 / 4 |
Face à GLM‑5.3, Hy4 preview a enregistré 46,8 % de victoires, 12,8 % d'égalités et 40,4 % de défaites. Face à Kimi K3, il a enregistré 51,2 % de victoires, 7,9 % d'égalités et 40,9 % de défaites.
C'est une avance étroite dans l'environnement de productivité propre à Tencent — pas la preuve que Hy4 preview est universellement meilleur.
Il y a aussi une erreur de nommage facile à éviter : Tencent a comparé Hy4 preview avec GLM‑5.3 et Kimi K3. Il ne l'a pas comparé à GLM‑5.3 Flash ou MiniMax M3 dans ce test aveugle.
Premières preuves d'Arena WebDev
L'AutoEval WebDev précoce d'Arena a placé GLM‑5.3 Flash à 1 634 points et Hy4 preview à 1 633. Une différence d'un point équivaut effectivement à une égalité à ce stade.
Les deux scores ont été produits via AutoEval, où un modèle de récompense entraîné sur des préférences humaines attribue les votes. Ils n'étaient pas encore fondés sur suffisamment de votes humains en direct pour un classement public stable. La conclusion utile est que Hy4 preview semble compétitif en génération frontend — pas qu'il a définitivement gagné ou perdu.
Que disent les premiers utilisateurs de Hy4 Preview ?
La réaction précoce de la communauté est plus mesurée que plusieurs gros titres de lancement.
Un fil LocalLLaMA très discuté plaçait généralement Hy4 preview autour du niveau de GLM‑5.3. Les utilisateurs ont remarqué l'importante amélioration par rapport à Hy3, mais ont remis en question la capacité du propre graphique de Tencent à soutenir une conclusion générale selon laquelle il « bat GLM et Kimi ». Ils se sont aussi concentrés sur la difficulté pratique d'exécuter des poids de 770B hors d'un environnement de centre de données.
Cette réaction est raisonnable. Hy4 preview ressemble à un modèle ouvert sérieux, mais les affirmations les plus spectaculaires dépendent encore de la configuration de test propre à Tencent.
Une petite comparaison FlappyBench
Un test communautaire a comparé Hy4 preview, Kimi K3 et GLM‑5.3 sur une tâche de design de style Flappy Bird :
| Modèle |
Coût d'exécution rapporté |
Observation du testeur |
| Hy4 preview |
0,0480 $ |
Interface et gameplay les plus distinctifs |
| Kimi K3 |
0,0740 $ |
Gameplay le plus difficile |
| GLM‑5.3 |
0,0184 $ |
Gameplay fluide et coût le plus bas |
Les commentateurs n'étaient pas d'accord avec l'interprétation initiale. Certains préféraient Kimi K3 parce que le gameplay plus difficile était plus proche du jeu original, tandis qu'un autre commentateur a noté que le prompt n'était pas fourni avec assez de détails pour juger la comparaison.
Ce désaccord est utile. Il montre pourquoi le « meilleur résultat frontend » dépend des critères d'acceptation. La distinctivité visuelle, la fidélité, la difficulté et le coût sont des métriques différentes. Un prompt partagé ne peut pas trancher les quatre.
Hunyuan 4 vs GLM‑5.3 Flash, MiniMax M3 et DeepSeek V4 Pro
Hy4 preview rejoint un groupe dense de modèles chinois conçus pour le codage, les agents et les charges de travail d'un million de tokens.
| Facteur de décision |
Hy4 preview |
GLM‑5.3 Flash |
MiniMax M3 |
DeepSeek V4 Pro |
| Étape de version |
Aperçu |
Publié |
Publié |
Publié |
| Fenêtre de contexte |
1M |
1M |
1M |
1M |
| Sortie maximale documentée |
64K |
Dépend de la route |
Jusqu'à environ 512K |
384K |
| Entrée GPT Proto |
Pas encore disponible |
Texte, image, vidéo, document |
Texte, image, document |
Texte |
| Principal atout |
Agents textuels difficiles et recherche |
Codage multimodal rapide |
Longues exécutions d'agents multimodaux |
Codage et raisonnement STEM |
| Licence ouverte |
Apache 2.0 |
MIT |
MiniMax Community |
MIT |
| Prix d'entrée GPT Proto |
Bientôt disponible |
0,15 $/1M |
0,48 $/1M |
Voir la page du modèle en direct |
| Prix de sortie GPT Proto |
Bientôt disponible |
0,50 $/1M |
0,96 $/1M |
Voir la page du modèle en direct |
Les prix GPT Proto de ce tableau se rapportent aux routes GPT Proto disponibles, tandis que le prix de Hy4 évoqué précédemment est le tarif officiel de Tencent. Les prix en direct peuvent changer et doivent être vérifiés sur chaque page de modèle avant le déploiement.
Hunyuan 4 vs GLM‑5.3 Flash
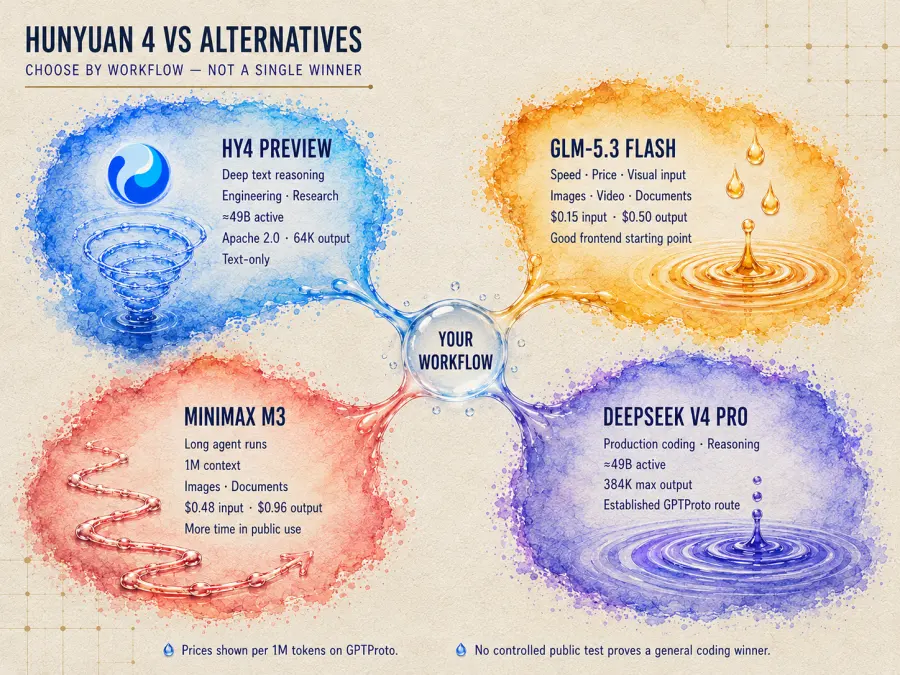
Hy4 preview est le candidat le plus intéressant pour les tâches difficiles, uniquement textuelles, d'ingénierie ou de recherche, où une équipe accepte de troquer du temps de réponse contre un raisonnement plus profond.
GLM‑5.3 Flash est le choix le plus pratique lorsque le prix, la vitesse de réponse ou l'entrée visuelle comptent. Sa route GPT Proto accepte les images, les vidéos et les documents, tandis que Hy4 preview accepte actuellement du texte. Il coûte aussi 0,15 $ par million de tokens d'entrée et 0,50 $ par million de tokens de sortie sur GPT Proto — bien en dessous du tarif officiel actuel de Hy4.
Les premiers scores Arena WebDev sont presque identiques. Pour le codage frontend, je commencerais par GLM‑5.3 Flash parce qu'il peut inspecter des références visuelles et coûte moins cher, puis je testerais Hy4 sur les cas les plus difficiles de planification et de débogage textuels.
Hunyuan 4 vs MiniMax M3
MiniMax M3 est un autre modèle MoE d'un million de tokens conçu pour de longues exécutions d'agents. Sur GPT Proto, il coûte 0,48 $ par million de tokens d'entrée et 0,96 $ par million de tokens de sortie. L'entrée image et document est disponible via sa route multimodale.
Hy4 preview offre une licence Apache 2.0 et de solides premiers résultats sur les benchmarks d'utilisation d'outils et d'ingénierie. MiniMax M3 a un prix hébergé plus bas sur GPT Proto, une sortie documentée plus longue et plus de temps d'utilisation publique.
Pour un nouvel agent de recherche uniquement textuel, Hy4 mérite d'être ajouté à l'ensemble d'évaluation. Pour un flux de production sensible aux coûts ou un agent qui doit inspecter des images et des fichiers, MiniMax M3 est actuellement plus facile à justifier.
Hunyuan 4 vs DeepSeek V4 Pro
DeepSeek V4 Pro et Hy4 preview activent tous deux environ 49 milliards de paramètres par token et ciblent des tâches difficiles de codage et de raisonnement. DeepSeek V4 Pro a un nombre total de paramètres plus élevé et une sortie maximale documentée de 384K tokens, contre 64K pour Hy4 preview.
Hy4 offre des poids Apache 2.0 et l'intégration WorkBuddy/CodeBuddy de Tencent. DeepSeek V4 Pro dispose déjà d'une route GPT Proto établie et convient mieux aux équipes qui ont besoin d'un point de terminaison de production maintenant.
Il n'existe pas de test comparatif public suffisamment contrôlé pour déclarer un gagnant général en codage. Testez l'édition de dépôt, la récupération après échec et le coût total sur la même charge de travail.
À quoi pouvez-vous utiliser Hunyuan 4 ?
Hy4 preview est le mieux adapté aux tâches suffisamment difficiles pour justifier son processus de raisonnement plus long.
Codage à l'échelle d'un dépôt
Un agent de développement peut utiliser la grande fenêtre de contexte pour lire la documentation du projet, les fichiers source, les échecs de tests et les changements précédents dans une même session de travail. Le test le plus utile n'est pas de savoir s'il écrit correctement une fonction, mais s'il préserve l'état du projet après des éditions répétées.
Analyse de documents longs et analyse financière
Tencent a entraîné le modèle autour de flux de travail bureautiques et analytiques impliquant des documents, des feuilles de calcul, des équations et des modèles financiers. Son contexte d'un million de tokens le rend pertinent pour de grandes collections de contenus à forte composante textuelle.
Les données privées ou réglementées nécessitent toujours un examen distinct des politiques de conservation, de localisation et d'accès du fournisseur d'hébergement choisi.
Agents de recherche utilisant des outils
Hy4 preview prend en charge l'appel de fonctions et le raisonnement étendu, ce qui lui permet de rechercher, d'exécuter des expériences, d'inspecter des résultats et de réviser une approche. Tencent indique l'utiliser en recherche en IA, dynamique moléculaire, physique de la matière condensée et mathématiques.
Ce sont des tâches à forte variance. L'examen humain reste nécessaire, en particulier lorsque le modèle génère des affirmations scientifiques ou interprète des résultats expérimentaux.
Prototypage de jeux
Tencent démontre Hy4 preview travaillant avec des moteurs de jeu pour créer et réviser des prototypes jouables. C'est un bon test d'Agent car cela combine code, logique d'interaction, gestion d'état et débogage.
Une démo jouable n'est pas un jeu prêt pour la production. La licence des assets, la performance, la compatibilité de plateforme et une transmission propre du projet nécessitent encore des vérifications distinctes.
Charges de travail où un autre modèle est plus pertinent
Hy4 preview ne devrait pas être le choix par défaut lorsque :
L'agent doit inspecter des captures d'écran, des images ou des vidéos.
La tâche est une courte demande de classification ou d'extraction.
La faible latence compte plus que le raisonnement approfondi.
L'équipe ne peut pas tolérer des changements de comportement au stade Preview.
Le matériel local ne peut pas prendre en charge un très grand modèle.
Le système de production manque d'une suite de régression spécifique au modèle.
Hunyuan 4 vaut-il la peine d'être utilisé maintenant ?
Hy4 preview vaut la peine d'être testé, mais il est trop tôt pour le traiter comme le remplacement automatique de GLM‑5.3 Flash, MiniMax M3 ou DeepSeek V4 Pro.
Le modèle est le plus convaincant pour les équipes qui évaluent des agents à poids ouverts et uniquement textuels sur de longues bases de code, du matériel de recherche ou des flux d'outils complexes. Sa licence Apache 2.0, son contexte d'un million de tokens et ses premiers résultats d'ingénierie sont des avantages significatifs.
Les coûts sont tout aussi réels. C'est un grand modèle, son prix hébergé actuel est plus élevé que plusieurs alternatives chinoises rapides, sa sortie est plafonnée à 64K tokens, et Tencent a déjà reconnu un sur-raisonnement et une vérification excessive.
Utilisez-le maintenant si vous disposez de votre propre ensemble d'évaluation et pouvez l'exécuter à côté d'un modèle de production existant. Attendez si vous avez besoin d'une latence stable, d'une entrée multimodale ou d'un modèle qui a déjà accumulé des mois de tests indépendants.
Hy4 preview arrive bientôt sur GPT Proto. En attendant, les développeurs peuvent comparer GLM‑5.3 Flash, MiniMax M3 et DeepSeek V4 Pro via un seul compte et un solde partagé.