MiniMax M3 vs DeepSeek V4 Flash : Verdict rapide
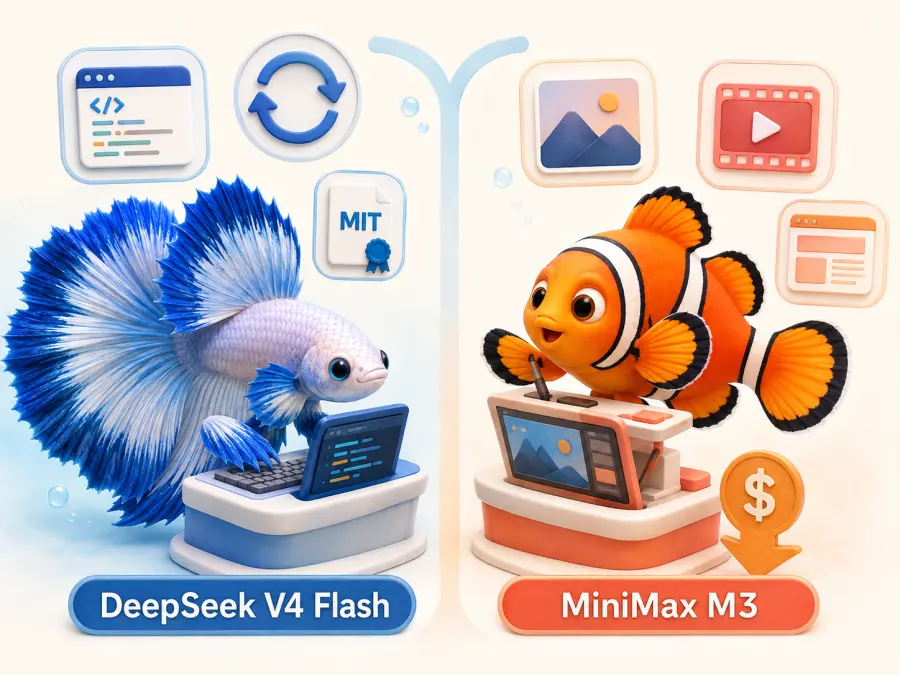
DeepSeek V4 Flash est le meilleur choix par défaut pour la plupart des développeurs en texte uniquement. Sa version max-reasoning domine l’indice indépendant Intelligence Index, écrit légèrement plus vite, utilise une licence MIT et offre des lectures de cache peu coûteuses — utile lorsque les agents renvoient le contexte du dépôt et les schémas d’outils.
MiniMax M3 est plus polyvalent. Il accepte les images et la vidéo, prend en charge une sortie maximale plus importante et coûte actuellement moins cher par token de sortie sur GPT Proto. Il convient à la conversion capture d’écran en code, au débogage visuel et aux sorties longues.
| Votre charge de travail |
Modèle recommandé |
| Codage en texte uniquement |
DeepSeek V4 Flash |
| Agents de dépôt avec contexte répété |
DeepSeek V4 Flash |
| Capture d’écran en code |
MiniMax M3 |
| Débogage visuel frontend |
MiniMax M3 |
| Appels à sortie intensive pendant les heures de pointe de DeepSeek |
MiniMax M3 |
| Tâches par lots planifiées hors pointe |
DeepSeek V4 Flash |
| Auto-hébergement commercial |
DeepSeek V4 Flash |
| Entrée native d’images et de vidéos |
MiniMax M3 |
Pour le code à haut risque, aucun des deux modèles ne doit être sélectionné uniquement en fonction de son classement. Les modifications d’authentification, les migrations de base de données, les travaux d’infrastructure et les refactorisations multi-services nécessitent des tests, des vérifications statiques ou une revue séparée, car le coût de réparation d’une seule mauvaise modification peut dépasser les économies de tokens de dizaines d’appels réussis.
Essayez MiniMax M3 sur GPT Proto ou essayez DeepSeek V4 Flash sur GPT Proto.
MiniMax M3 vs DeepSeek V4 Flash en un coup d’œil
Le tableau ci-dessous utilise les versions hébergées actuelles et les tarifs GPT Proto disponibles le 28 août 2026. Les prix et les limites d’hébergement peuvent changer, les pages de modèles en direct doivent donc rester la référence finale avant le déploiement.
| Spécification |
MiniMax M3 |
DeepSeek V4 Flash 0731 |
| Sortie |
1er juin 2026 |
Mise à jour de l’API du 31 juillet 2026 |
| Architecture |
428B au total / 23B actifs |
284B au total / 13B actifs |
| Fenêtre de contexte |
1 048 576 tokens ; minimum garanti de 512K |
1 048 576 tokens combinés |
| Sortie maximale |
Environ 512K tokens |
Jusqu’à 384K tokens |
| Entrée native |
Texte, image et vidéo |
Texte |
| Sortie |
Texte |
Texte |
| Contrôle du raisonnement |
Activé, adaptatif ou désactivé |
Sans réflexion, faible, élevé ou max |
| Appel d’outils |
Oui |
Oui |
| Prix des entrées fraîches GPT Proto |
0,48 USD / 1M tokens |
0,44 USD / 1M tokens en pointe |
| Prix de sortie GPT Proto |
0,96 USD / 1M tokens |
1,32 USD / 1M tokens en pointe |
| Tarif du cache GPT Proto |
0,10 USD écriture / 0,10 USD lecture par 1M |
0,014 USD lecture par 1M en pointe |
| Licence |
Licence communautaire MiniMax |
MIT |
| Idéal pour |
Flux de travail multimodaux et visuels |
Codage textuel et boucles d’agents répétées |
MiniMax est nativement multimodal, mais GPT Proto sépare les appels texte de sa route image-vers-texte. Le DeepSeek V4 Flash standard est texte-vers-texte ; deepseek-v4-flash-vision-exp est un modèle expérimental distinct.
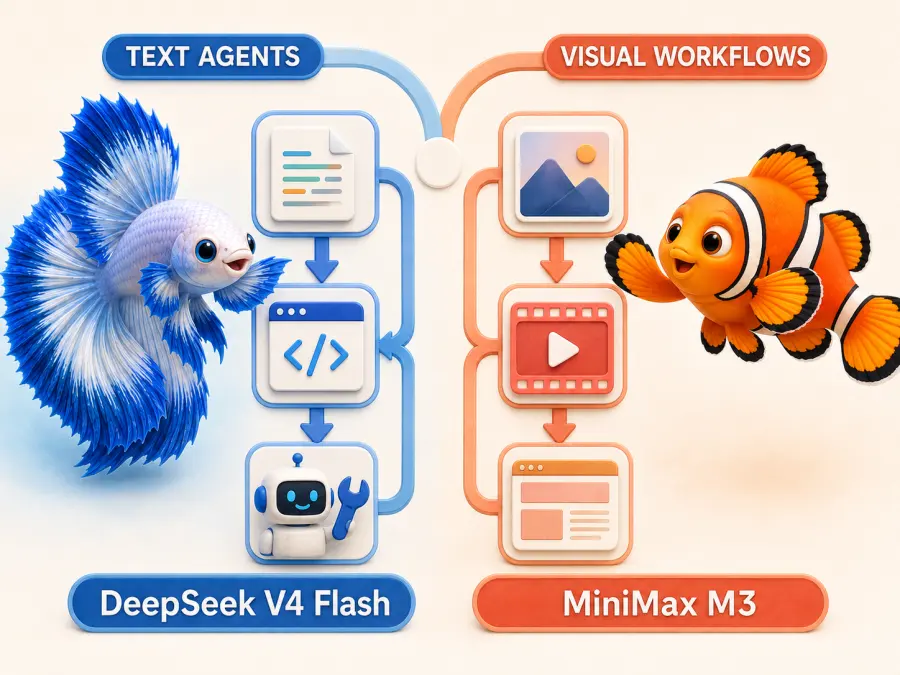
Les objectifs de conception derrière le tableau sont différents. MiniMax a construit M3 autour de MiniMax Sparse Attention et d’un entraînement natif sur texte, image et vidéo. DeepSeek a construit le plus petit palier V4 Flash pour une inférence textuelle efficace, puis a utilisé la mise à jour post-entraînement 0731 pour renforcer les agents et ajouter la prise en charge native de l’API Responses. MiniMax offre des entrées plus larges ; DeepSeek offre une route plus étroite, axée sur le texte, avec des lectures de cache moins chères et une licence MIT.
Comparaison des benchmarks : le mode de raisonnement change le gagnant
La comparaison indépendante la plus claire provient d’Artificial Analysis. Avec DeepSeek réglé sur le raisonnement maximal, il devance MiniMax M3 sur l’Intelligence Index et est légèrement plus rapide.
| Métrique indépendante |
MiniMax M3 |
DeepSeek V4 Flash 0731, raisonnement max |
| Indice Intelligence d’Artificial Analysis |
45 |
52 |
| Vitesse de sortie |
114 tokens/s |
119 tokens/s |
| Temps jusqu’au premier token |
1,17 seconde |
1,12 seconde |
| Fenêtre de contexte |
1M tokens |
1M tokens |
La différence d’intelligence est significative ; l’écart de vitesse est faible et le débit hébergé peut varier. Le résultat le plus révélateur apparaît lorsque DeepSeek fonctionne sans raisonnement : Artificial Analysis classe MiniMax M3 à 45 et DeepSeek V4 Flash sans raisonnement à 29. « La performance de DeepSeek V4 Flash » est donc incomplète si le réglage de raisonnement n’est pas précisé. Le raisonnement maximal est la comparaison pertinente pour le code complexe et la planification d’agents ; le mode sans réflexion convient aux tâches délimitées telles que la classification, l’extraction et l’autocomplétion.
Les graphiques des fournisseurs ajoutent du contexte mais ne constituent pas un test comparatif équitable. MiniMax rapporte 59,0 % sur SWE-Bench Pro, 66,0 sur Terminal-Bench 2.1 et 74,2 sur MCP Atlas. DeepSeek rapporte 82,7 sur Terminal-Bench 2.1, 54,2 sur NL2Repo et 70,3 sur Toolathlon Verified. Les entreprises ont utilisé des infrastructures, des échafaudages, des frameworks d’évaluation et des réglages différents, donc comparer directement 82,7 à 66,0 serait trompeur.
La conclusion défendable est plus étroite : la comparaison indépendante favorise DeepSeek avec le raisonnement maximal. Les graphiques de lancement ne nous disent pas quel modèle accomplira une tâche de dépôt particulière avec moins de corrections.
MiniMax M3 vs DeepSeek V4 Flash pour le codage
Pour les petites tâches de codage vérifiables, DeepSeek est le meilleur point de départ. Les tests unitaires, la conversion de schémas, l’explication de code, les corrections de bugs isolés et les modifications répétitives bénéficient de son score de raisonnement et de son tarif de cache — surtout lorsque des tests, des linters ou des validateurs peuvent vérifier le résultat.
Le travail à l’échelle du dépôt est moins simple. La capacité n’est pas synonyme de compréhension fiable : un agent doit suivre les règles du dépôt, éviter les modifications sans rapport, se remettre après des commandes échouées et maintenir un plan. Je commencerais quand même par DeepSeek pour le travail de dépôt en texte uniquement, car son résultat en raisonnement maximal est plus fort et les lectures de cache sont peu coûteuses. MiniMax devient plus attractif lorsque la tâche inclut des captures d’écran, des diagrammes, des ressources de conception ou d’autres entrées visuelles.
Un premier patch moins cher n’est pas moins cher s’il nécessite une récupération manuelle. Pour les modifications à haut risque, comparez le nombre total d’appels, les outils échoués, les corrections, les tests et le temps jusqu’à un livrable accepté.
Lequel est meilleur pour le codage frontend ?
« Le codage frontend » peut décrire deux tâches différentes, et de nombreuses comparaisons les mélangent.
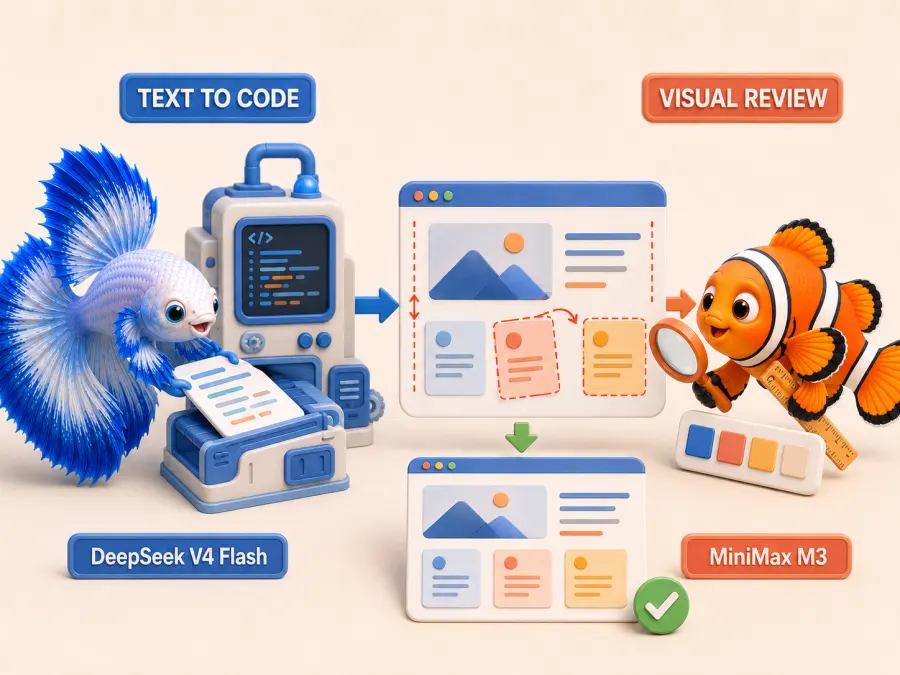
La première est le texte-vers-code. Un développeur fournit une spécification écrite et demande un composant React, du CSS réactif, de la logique d’état, des corrections d’accessibilité ou une mise en page. Il n’y a aucune image à inspecter pour le modèle. Pour cette charge de travail, DeepSeek V4 Flash est le choix par défaut le plus solide, d’après la comparaison indépendante actuelle des raisonnements et son adéquation avec les agents de codage textuels.
La seconde est l’itération frontend visuelle. Le modèle reçoit une capture d’écran, une page rendue ou un enregistrement d’écran et doit identifier les erreurs d’espacement, de couleur ou d’alignement. MiniMax M3 possède ici la capacité décisive, car le DeepSeek V4 Flash standard ne peut pas accepter d’entrée visuelle.
Cette distinction produit une conclusion plus précise que « MiniMax est meilleur pour le frontend ». MiniMax M3 n’est pas automatiquement le meilleur codeur frontend. C’est le meilleur modèle frontend visuel. DeepSeek reste le meilleur choix par défaut en texte uniquement, tandis que MiniMax gère la boucle de retour qui commence après le rendu de la page.
Quel modèle est meilleur pour les agents IA ?
Les deux modèles peuvent appeler des outils, renvoyer des arguments structurés, lire des résultats et poursuivre une tâche en plusieurs étapes. DeepSeek est le choix par défaut pratique pour les agents textuels qui recherchent dans des dépôts, inspectent des journaux, génèrent des tests ou exécutent des flux de données répétables. Son tarif de cache compte parce que ces systèmes renvoient les mêmes instructions et définitions d’outils. MiniMax convient aux agents qui doivent interpréter des graphiques, des écrans d’application, des références de conception ou des enregistrements avant de choisir l’action suivante.
Le suivi des instructions est la partie la moins confortable des deux histoires. Dans une discussion communautaire sur MiniMax M3, des utilisateurs ont déclaré devoir se battre avec le modèle au sujet des règles et des instructions, bien que d’autres utilisateurs aient décrit de bons résultats dans des flux d’agents de codage. DeepSeek 0731 a reçu des critiques similaires : des développeurs ont signalé des problèmes pour suivre des règles, des compétences et des instructions subtiles non liées au codage dans un fil axé sur le codage et une discussion distincte sur la fiabilité.
Ce sont des anecdotes, pas des évaluations contrôlées. Elles expliquent pourquoi le test de migration final doit utiliser votre prompt système réel, les règles de votre dépôt, le schéma de vos outils et vos instructions de récupération d’erreur. Un flux de travail mixte judicieux envoie l’implémentation textuelle et les sous-tâches répétitives à DeepSeek, puis route l’analyse de captures d’écran et le débogage visuel vers MiniMax.
Tarification : quel modèle est réellement plus rentable ?
Le prix des tokens seul donne une réponse erronée, car ces modèles ont des tarifs différents pour l’entrée, la sortie, le cache et selon l’heure. Les calculs suivants utilisent les tarifs GPT Proto affichés le 28 août 2026.
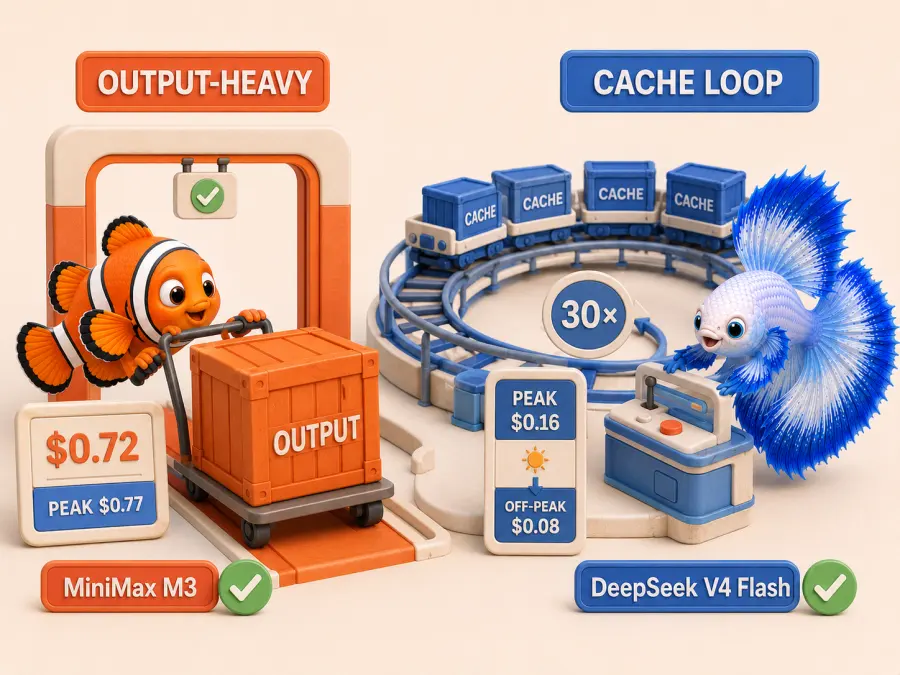
MiniMax M3 a des tarifs fixes de 0,48 USD par million de tokens d’entrée fraîche et de 0,96 USD par million de tokens de sortie. Les écritures et lectures de cache sont actuellement de 0,10 USD par million chacune.
DeepSeek V4 Flash a des tarifs de pointe de 0,44 USD par million de tokens d’entrée fraîche, 0,014 USD par million de tokens de lecture de cache et 1,32 USD par million de tokens de sortie. Les appels hors pointe sont facturés à la moitié de ces tarifs. GPT Proto définit actuellement les fenêtres hors pointe en heure de Pékin comme 18:00–09:00 et 12:00–14:00 ; la facturation réelle suit l’heure de la requête.
Exemple 1 : requête à sortie intensive sans cache
Supposons qu’une requête utilise un million de tokens d’entrée fraîche et produise 250 000 tokens de sortie.
| Modèle et moment |
Coût estimé |
| MiniMax M3 |
0,7200 USD |
| DeepSeek V4 Flash en pointe |
0,7700 USD |
| DeepSeek V4 Flash hors pointe |
0,3850 USD |
MiniMax est environ 0,05 USD moins cher pendant la période de pointe de DeepSeek, car son tarif de sortie est plus bas. Une fois que le même appel DeepSeek passe hors pointe, DeepSeek coûte près de moitié moins que MiniMax.
Exemple 2 : agent de codage à cache intensif
Supposons maintenant une session d’agent de codage de 30 tours. Chaque tour lit 100 000 tokens en cache, ajoute 3 000 tokens d’entrée fraîche et produit 2 000 tokens de sortie. L’estimation MiniMax inclut également une écriture de cache initiale de 100 000 tokens.
| Modèle et moment |
Coût estimé sur 30 tours |
| MiniMax M3 |
0,4108 USD |
| DeepSeek V4 Flash en pointe |
0,1608 USD |
| DeepSeek V4 Flash hors pointe |
0,0804 USD |
C’est la distinction de tarification que la plupart des tableaux comparatifs simples manquent. MiniMax M3 peut gagner sur les requêtes sans cache à sortie intensive. DeepSeek V4 Flash gagne généralement sur les boucles d’agents à cache intensif, même aux tarifs de pointe. Planifier les tâches différables hors pointe creuse encore l’écart.
Ce sont des estimations, pas des factures issues d’un test en direct apparié. Les équipes doivent recalculer avec leur propre ratio de tokens, taux de succès du cache, tentatives et taux de tâches acceptées.
Fenêtre de contexte, multimodalité et déploiement
Les deux modèles annoncent environ un million de tokens de contexte, mais il s’agit d’un budget de fonctionnement combiné. Pour DeepSeek, l’entrée, l’historique, les résultats d’outils, le raisonnement et la sortie partagent la fenêtre de 1 048 576 tokens ; la sortie maximale va jusqu’à 384K. MiniMax indique le même contexte principal, un minimum garanti de 512K et une sortie maximale d’environ 512K. Les agents à contexte long doivent tout de même réserver de la marge de sortie et sélectionner les fichiers pertinents plutôt que d’envoyer un dépôt non filtré.
La multimodalité n’est pas une égalité. MiniMax accepte le texte, les images et la vidéo ; DeepSeek V4 Flash accepte le texte. Un flux de travail DeepSeek qui a besoin de captures d’écran doit router l’étape visuelle vers un autre modèle, comme le modèle Vision Exp hébergé séparément.
Les licences créent la dernière différence. DeepSeek publie ses poids V4 Flash sous la licence MIT, plus facile pour l’auto-hébergement commercial, la redistribution et la modification. MiniMax publie M3 sous la licence communautaire MiniMax, qui ajoute des conditions d’attribution, de mention et d’autorisation liées aux revenus. Les utilisateurs d’API hébergées peuvent se soucier principalement de la disponibilité des routes et des conditions de données ; les équipes d’auto-hébergement doivent examiner la licence des poids avant le déploiement.
Quel modèle choisir ?
Choisissez MiniMax M3 lorsque l’agent doit inspecter des images ou de la vidéo, que le travail frontend inclut des retours sur page rendue, ou que les appels aux heures de pointe génèrent une sortie substantielle. Choisissez DeepSeek V4 Flash lorsque le flux de travail est textuel, que le cache compte, que les tâches par lots peuvent s’exécuter hors pointe, ou qu’une licence MIT est requise. Utilisez les deux lorsque l’application se divise naturellement entre implémentation textuelle et revue visuelle.
Exécuter MiniMax M3 et DeepSeek V4 Flash avec une seule clé API
Tester les deux modèles ne devrait pas nécessiter deux soldes de compte séparés ni deux couches d’intégration. GPT Proto donne accès à MiniMax M3 et DeepSeek V4 Flash via le même compte et un solde partagé.
Pour les appels texte, les deux s’intègrent à une structure d’application compatible OpenAI. Changez l’ID du modèle, gardez la tâche et les critères d’acceptation fixes, et enregistrez l’achèvement, les appels d’outils échoués, les corrections, la latence, l’utilisation des tokens et le coût total. Avant de migrer le trafic, exécutez des tests canari pour le streaming, les arguments d’outils, l’analyse JSON, les réglages de raisonnement, les tentatives et le comportement de tokens maximum.
Essayez les deux modèles sur GPT Proto
Utilisez une seule clé et un seul solde partagé pour comparer les deux modèles sur le travail que votre application effectue réellement.
Verdict final
DeepSeek V4 Flash 0731 est le meilleur choix par défaut pour le codage en texte uniquement et les agents à cache intensif. Il domine la comparaison indépendante actuelle en raisonnement maximal, utilise une licence MIT et devient particulièrement peu coûteux lorsqu’une application réutilise le contexte ou planifie les appels hors pointe.
MiniMax M3 est le meilleur choix lorsque le flux de travail nécessite une entrée image ou vidéo, des retours frontend visuels, une sortie plus longue ou un tarif de sortie plus bas aux heures de pointe. Son avantage est l’étendue, pas l’affirmation générale qu’il écrit un meilleur code.
Pour le travail en production, choisissez en fonction du coût par tâche acceptée plutôt que du prix des tokens seul : achèvement, respect des instructions, vérifications réussies et effort de récupération.