Qu’est-ce que GLM-5.3 Flash ?
Z.ai décrit GLM-5.3 Flash comme un modèle conçu pour le codage, les agents multimodaux et les tâches professionnelles impliquant des interfaces, des documents, des graphiques et d’autres informations visuelles. Contrairement à GLM-5.3, qui est un modèle textuel amélioré principalement par un post-entraînement supplémentaire, Flash utilise un nouveau modèle de base entraîné sur un corpus multimodal de 30 000 milliards de tokens.
Voici les principales spécifications au lancement :
| Spécification |
GLM-5.3 Flash |
| Développeur |
Z.ai / Zhipu AI |
| Date de sortie |
26 août 2026 |
| Architecture |
Mélange d’experts avec attention hybride linéaire et parcimonieuse |
| Paramètres totaux |
320B |
| Paramètres actifs |
18B par token |
| Couches Transformer |
45 |
| Fenêtre de contexte |
1 048 576 tokens |
| Sortie maximale |
131 072 tokens |
| Entrée |
Texte, images, vidéo et fichiers |
| Sortie |
Texte |
| Raisonnement |
Toujours activé ; efforts faible, élevé et maximal |
| ID officiel du modèle |
glm-5.3-flash |
| Licence des poids |
MIT |
Les poids officiels du modèle sont disponibles sous licence MIT. Cela rend le modèle open-weight et utilisable commercialement selon les termes de la licence. Cela ne rend pas l’inférence hébergée gratuite : le calcul, le stockage et les tokens API coûtent toujours de l’argent.
GLM-5.3 Flash est-il le modèle phare de Z.ai ?
Non. Z.ai positionne GLM-5.3 comme son modèle textuel phare, tandis que GLM-5.3 Flash occupe une place différente : une inférence moins coûteuse et une entrée multimodale native.
Cette distinction est importante car les deux modèles ne partagent pas la même base. GLM-5.3 est une mise à niveau par post-entraînement construite sur la base GLM-5.2. GLM-5.3 Flash a été entraîné comme un nouveau modèle de base multimodal. Qualifier Flash de réglage moins cher de GLM-5.3 passe à côté de la différence architecturale la plus importante.
Quelle est la relation entre GLM-5.3 Flash et OxAlpha ?
OxAlpha était l’identité d’aperçu anonyme de GLM-5.3 Flash.
Avant la sortie officielle, Z.ai servait le modèle sous le nom ox-alpha via OpenCode et une route d’aperçu publique. L’entreprise affirme avoir utilisé ce lancement anonyme pour recueillir des retours sans placer la marque GLM devant les utilisateurs. Selon Z.ai, OxAlpha est devenu le modèle le plus utilisé sur ces services pendant sa semaine d’aperçu, le trafic étant servi sur des puces d’IA chinoises.
Ce n’était pas le premier test de modèle anonyme de Z.ai. L’approche sépare une partie du comportement des utilisateurs des attentes liées à la marque, bien que l’accès gratuit, le placement dans les outils de codage et la curiosité influencent toujours l’usage.
Le mystère a tout de même produit des preuves utiles. Le CEO de Stripe, Patrick Collison, a essayé le modèle et a écrit que « c’est très impressionnant ». Un petit test de codage communautaire a rapporté huit tâches de dépôt réussies sur dix. Ce titre a circulé rapidement, mais l’échantillon était minuscule et la comparaison utilisait une tentative OxAlpha contre quatre tentatives pour les modèles de référence.
Un test communautaire public DeepSWE ultérieur offre un meilleur contexte : OxAlpha a résolu 66 tâches sur 113, soit 58,4 %, en utilisant une configuration documentée de mini-agent d’ingénierie logicielle. Il a aussi perdu certaines tâches à cause du formatage des appels d’outils plutôt que de la solution de code sous-jacente. Il s’agit encore d’une seule exécution communautaire, pas d’un classement universel des modèles. Mais 113 tâches nous apprennent plus que dix.
La réaction sur Reddit a suivi le même schéma. Les fils de révélation dans r/LocalLLaMA et r/singularity ont attiré des centaines de votes. Les développeurs ont apprécié la licence MIT et le prix des tokens ; les utilisateurs de modèles locaux ont fait remarquer qu’un checkpoint de 320B n’est pas de taille pour un ordinateur de bureau. D’autres ont signalé une planification incohérente ou des réponses d’aperçu lentes. Ce sont des anecdotes, mais elles identifient les bons tests : rétention des instructions, fiabilité des agents, latence et utilisation totale des tokens.
Le conseil pratique est simple : OxAlpha et GLM-5.3 Flash appartiennent à la même ligne de modèles, mais les résultats d’OxAlpha décrivent une période d’aperçu anonyme. Utilisez ces rapports comme premières preuves de terrain, puis validez le modèle publié sur votre propre dépôt et votre flux de travail.
Qu’est-ce qui a changé dans GLM-5.3 Flash ?
L’efficacité du modèle vient de plus que l’activation d’un nombre réduit d’experts.
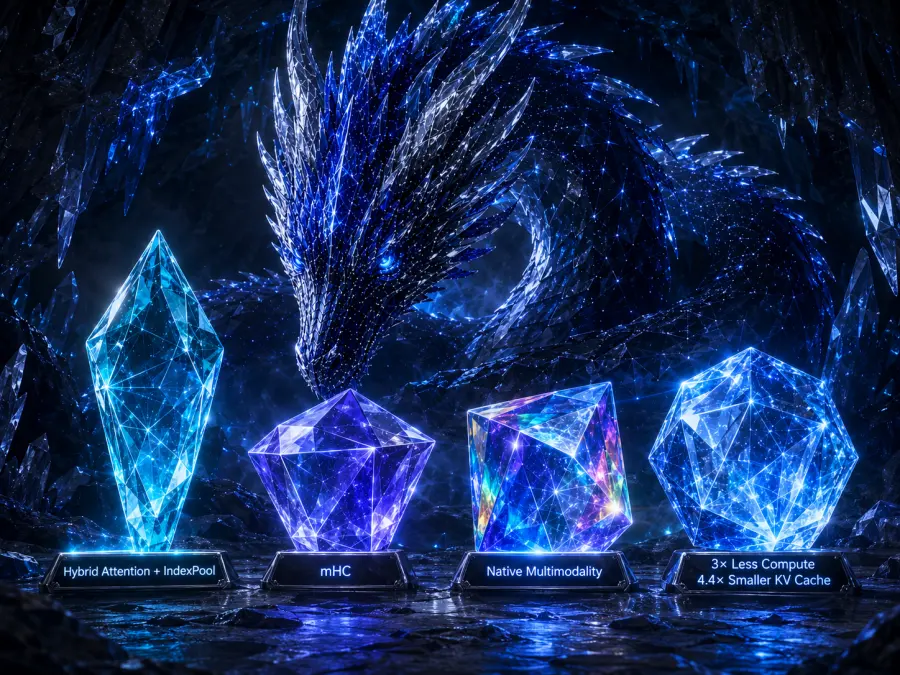
Premièrement, GLM-5.3 Flash combine l’attention linéaire pour les dépendances locales avec l’attention parcimonieuse pour récupérer des informations dans des parties éloignées du contexte. Z.ai a aussi introduit IndexPool, qui regroupe quatre vecteurs de clé d’indexeur en un seul. Cela réduit le coût en mémoire et en latence de la recherche des tokens pertinents dans une invite d’un million de tokens.
Deuxièmement, le modèle utilise les Hyper-Connexions à Contraintes de Variété, ou mHC. En clair, mHC modifie la façon dont l’information est mélangée entre les couches afin que Z.ai puisse mettre le modèle à l’échelle tout en gardant l’entraînement et l’inférence stables.
Troisièmement, la multimodalité fait partie du pré-entraînement plutôt que d’un adaptateur d’image ajouté après la finalisation d’un modèle textuel. Un agent de codage peut inspecter une page rendue, remarquer une mise en page cassée, modifier le code et vérifier le rendu suivant. La même boucle s’applique à l’utilisation du navigateur, à l’exploitation du bureau, aux graphiques et aux documents.
Z.ai calcule que Flash utilise environ trois fois moins de calcul d’attention que GLM-5.3 et un cache KV moyen 4,4 fois plus petit. Ce sont des calculs du fournisseur, pas des mesures indépendantes de service. Ils expliquent toutefois comment un modèle de 320B au total peut être proposé à un prix par token bien inférieur.
Une phrase résume le compromis : moins cher à appeler, pas nécessairement plus rapide à regarder.
Que peut faire GLM-5.3 Flash ?
GLM-5.3 Flash est conçu pour les tâches où le raisonnement linguistique et le retour visuel se rencontrent.
Pour les agents de codage, cela inclut l’analyse de dépôt, le débogage, le travail en terminal, l’appel de fonctions et les modifications de longue durée qui nécessitent plusieurs étapes d’outils. La vision native ajoute la réplication frontend à partir de captures d’écran, l’inspection d’interfaces rendues, l’utilisation du navigateur, le développement de jeux et les vérifications visuelles pour les scènes 3D. Un modèle uniquement textuel peut écrire du CSS ; un modèle multimodal peut aussi regarder le résultat.
Pour le travail de bureau, il peut interpréter des PDF, des feuilles de calcul, des présentations, des tableaux de bord, des diagrammes et des captures d’écran. Il peut localiser un graphique, le comparer au texte environnant, renvoyer du JSON structuré et transmettre le résultat à un autre outil. La fenêtre d’un million de tokens offre de la place pour de grands dépôts ou de longs rapports, même si son utilisation augmente le coût d’entrée et la latence.
L’ensemble des fonctionnalités de l’API comprend l’appel de fonctions, la sortie structurée, le streaming, la mise en cache du contexte, l’utilisation du navigateur et l’utilisation de l’ordinateur. Le raisonnement reste activé, avec des niveaux d’effort faible, élevé et maximal. Un effort moindre est le meilleur point de départ pour l’extraction routinière ; l’effort maximal est destiné aux tâches de codage et d’agent difficiles. Plus de raisonnement peut améliorer une réponse difficile, mais cela ajoute aussi des tokens et du temps.
GLM-5.3 Flash prend-il en charge l’entrée vidéo ?
Oui. GLM-5.3 Flash prend en charge l’entrée vidéo native et renvoie du texte.
L’entrée vidéo est importante lorsque l’information est temporelle plutôt que contenue dans une seule image. Le modèle peut analyser un enregistrement d’écran, identifier la séquence qui a causé une erreur d’interface, résumer une démonstration, localiser des événements dans une réunion ou transformer un tutoriel en instructions ordonnées. Il peut aussi combiner vidéo et code — par exemple, examiner une interaction cassée et suggérer des modifications frontend.
Il s’agit de compréhension vidéo, pas de génération vidéo. GLM-5.3 Flash peut décrire, raisonner et agir sur des informations issues de la vidéo, mais il ne produit pas de nouveau fichier vidéo.
Tarification de GLM-5.3 Flash
Z.ai a lancé GLM-5.3 Flash avec une promotion temporaire de 50 %. La promotion se termine à 24 h 00 le 9 septembre 2026, UTC+8. Le prix de déploiement de GPT Proto est calculé à partir du tarif catalogue standard de Z.ai, et non de la promotion temporaire.
| Pour 1 M de tokens |
Z.ai standard |
Promotion de lancement Z.ai |
Prix de déploiement GPT Proto |
| Nouvelle entrée |
$0.15 |
$0.075 |
$0.015 |
| Entrée mise en cache |
$0.03 |
$0.015 |
$0.003 |
| Sortie |
$0.50 |
$0.25 |
$0.05 |
Budgétisez sur le tarif standard, pas sur le tarif de lancement. Les promotions expirent ; les charges de production, généralement pas.
Le prix standard est bien inférieur au tarif d’entrée de 1,40 $ et de sortie de 4,40 $ de GLM-5.3. Mais le prix des tokens ne représente qu’une partie de la facture. Artificial Analysis a trouvé le modèle inhabituellement verbeux dans son évaluation Intelligence Index. Un modèle qui émet plus de tokens de raisonnement et de réponse peut effacer une partie de son avantage apparent par token. La mise en cache du contexte aide lorsqu’un agent de codage renvoie répétitivement le même contexte de dépôt, mais les nouvelles invites et la sortie générée comptent toujours.
À 0,015 $ par million de nouveaux tokens d’entrée et 0,05 $ par million de tokens de sortie, le prix de déploiement de GPT Proto représente 10 % du tarif standard de Z.ai — une réduction de 90 %. Vous pouvez consulter les dernières disponibilités et les détails de facturation sur la page du modèle GLM-5.3 Flash API.
Quelle est la qualité de GLM-5.3 Flash ?
Il y a deux réponses : les benchmarks de lancement de Z.ai et les premières mesures indépendantes. Il ne faut pas les fusionner en une seule affirmation.
Résultats de benchmark publiés par Z.ai
Z.ai rapporte les résultats suivants. La comparaison est utile pour identifier les forces visées, mais elle reste une évaluation réalisée par le fournisseur.
| Benchmark |
GLM-5.3 Flash |
GLM-5.2 |
DeepSeek V4 Vision Exp |
Claude Opus 4.8 |
| Terminal-Bench 2.1 |
84.3 |
81.0 |
83.9 |
85.0 |
| DeepSWE v1.1 |
63.4 |
46.2 |
59.3 |
58.0 |
| Toolathlon Verified |
78.4 |
59.9 |
75.9 |
76.2 |
| AutomationBench |
48.8 |
26.2 |
38.8 |
41.0 |
| Chartography avec outils |
78.0 |
— |
64.3 |
75.0 |
Ces résultats soutiennent une conclusion plus étroite que « Flash bat Opus ». Le modèle de Z.ai semble compétitif en codage, utilisation d’outils et tâches d’agent visuel, mais Opus 4.8 mène encore certaines lignes, notamment Terminal-Bench et NL2Repo. Plus important encore, ce tableau compare Opus 4.8 — pas Claude Opus 5.
Ce que montrent les tests indépendants
Au 27 août, Artificial Analysis attribue à GLM-5.3 Flash un score Intelligence Index de 57. Il a mesuré une sortie d’environ 50 tokens par seconde et estimé un coût d’environ 0,09 $ par tâche Intelligence Index au tarif catalogue. L’évaluation a aussi qualifié le modèle de plus lent que la moyenne et de très verbeux dans sa classe de comparaison.
C’est un bon résultat pour le prix. Ce n’est pas la preuve que Flash est le modèle le plus rapide ou le plus fort globalement.
GLM-5.3 Flash vs GLM-5.3, DeepSeek V4 Pro et Claude Opus 5
Le tableau ci-dessous utilise le même évaluateur indépendant et les variantes de raisonnement à effort maximal lorsqu’elles sont disponibles. Ce sont des instantanés de service changeants, donc considérez les chiffres de vitesse comme des mesures, pas comme des spécifications permanentes.
| Modèle |
Intelligence Index |
Vitesse de sortie |
Coût par tâche |
Entrée / sortie catalogue |
| GLM-5.3 Flash |
57 |
~50 tok/s |
$0.09 |
$0.15 / $0.50 |
| GLM-5.3 |
60 |
~87 tok/s |
$0.68 |
$1.40 / $4.40 |
| DeepSeek V4 Pro 0813 |
53 |
~67 tok/s |
$0.27 |
$1.32 / $3.96 |
| Claude Opus 5 |
63 |
~55 tok/s |
$2.34 |
$5.00 / $25.00 |
Choisissez GLM-5.3 Flash lorsque vous avez besoin d’une entrée image ou vidéo, de poids ouverts ou du coût par token le plus bas. Choisissez GLM-5.3 lorsque le travail est uniquement textuel et que les trois points Intelligence Index supplémentaires, les meilleurs scores de codage et la sortie plus rapide justifient le prix.
Ce n’est pas un chemin de mise à niveau classique où le suffixe plus récent remplace l’ancien modèle. Les deux branches optimisent des contraintes différentes. Consultez GLM-5.3 sur GPT Proto si votre charge de travail actuelle est du codage uniquement textuel ou du travail d’agent à long terme.
GLM-5.3 Flash vs DeepSeek V4 Pro
GLM-5.3 Flash a obtenu quatre points de plus dans l’instantané indépendant et coûte moins cher au tarif catalogue. Il accepte aussi des entrées visuelles, tandis que la route testée de DeepSeek V4 Pro est uniquement textuelle. DeepSeek V4 Pro générait une sortie plus rapidement et peut rester plus adapté aux pipelines de texte et de codage établis où la multimodalité n’apporte aucune valeur.
Ne choisissez pas sur la seule base d’un score composite. Exécutez la même tâche de dépôt avec des tests d’acceptation fixes et un enregistrement des nouvelles tentatives et des tokens. Vous pouvez examiner DeepSeek V4 Pro sur GPT Proto avant de tester les deux flux de travail.
GLM-5.3 Flash vs DeepSeek V4 Flash Vision Exp
Ce sont des concurrents plus proches en termes de forme produit : les deux ciblent le codage à moindre coût et les tâches visuelles. Dans l’évaluation de Z.ai elle-même, GLM-5.3 Flash a obtenu 63,4 contre 59,3 sur DeepSWE et 78,0 contre 64,3 sur Chartography avec outils. Considérez ces chiffres comme des affirmations de Z.ai jusqu’à ce que les modèles fassent l’objet d’une comparaison indépendante contrôlée d’agents visuels.
GLM-5.3 Flash dispose de poids sous licence MIT, d’une entrée vidéo et fichier native, et d’une fenêtre de contexte d’un million de tokens. DeepSeek V4 Flash Vision Exp reste une branche de vision expérimentale et peut être plus pertinent pour les équipes utilisant déjà la famille de modèles environnante. Consultez DeepSeek V4 Flash Vision Exp sur GPT Proto.
GLM-5.3 Flash vs Claude Opus 5
Claude Opus 5 reste plus fort dans le composite indépendant : 63 contre 57. Son prix catalogue en amont est aussi bien plus élevé, à 5 $ par million de tokens d’entrée et 25 $ par million de tokens de sortie. GLM-5.3 Flash est le choix économique ; Opus 5 est le choix axé sur la qualité lorsqu’une tâche échouée coûte plus cher que la facture de tokens.
La correction clé est méthodologique. Le graphique de lancement de Z.ai compare Flash à Opus 4.8, il ne peut donc pas étayer l’affirmation selon laquelle GLM-5.3 Flash bat Opus 5. Pour l’option Opus actuelle, consultez Claude Opus 5 sur GPT Proto.
Pouvez-vous exécuter GLM-5.3 Flash en local ?
Oui, mais « 18B actifs » ne signifie pas que le modèle tient comme un modèle dense de 18B.
Pensez aux 320B paramètres comme à un entrepôt et aux 18B paramètres actifs comme aux étagères consultées pour une commande. Le routeur réduit le calcul par token, mais l’entrepôt a toujours besoin d’un endroit où loger.
Le checkpoint FP8 fait environ 328 Go en stockage décimal, soit environ 306 Gio. Le guide de déploiement KTransformers spécifique au modèle recommande au moins 350 Go de mémoire système disponible avant de tenir compte de tout le reste exécuté sur la machine. Z.ai liste aussi SGLang, vLLM et TokenSpeed comme options d’inférence prises en charge.
Donc la description honnête n’est pas « un petit modèle local ». C’est un grand modèle efficace en calcul qui peut être auto-hébergé par des équipes disposant d’une sérieuse capacité mémoire. Pour la plupart des développeurs individuels et des petites équipes, l’accès à l’API hébergée sera plus simple que de stocker et servir le checkpoint complet.
Pas cher à appeler. Cher à posséder.
Comment accéder à GLM-5.3 Flash
Au lancement, les développeurs peuvent utiliser le modèle hébergé de Z.ai avec l’ID glm-5.3-flash, y accéder via des forfaits de codage éligibles, ou télécharger les poids sous licence MIT pour un service local.
L’API GLM-5.3 Flash sur GPT Proto est maintenant déployée avec les entrées natives texte, image, vidéo et fichier du modèle. Elle utilise le solde partagé de GPT Proto et est facturée à 10 % du tarif catalogue standard de Z.ai.
Pour des alternatives, utilisez GLM-5.3 pour le codage axé sur le texte, DeepSeek V4 Pro pour les flux de travail texte et agent, ou Claude Opus 5 lorsque la capacité compte plus que le prix des tokens.
GLM-5.3 Flash vaut-il la peine d’être utilisé ?
Oui — si votre charge de travail bénéficie réellement de la combinaison d’entrée multimodale, de contexte long et de prix bas des tokens.
GLM-5.3 Flash est un bon candidat pour les agents de codage visuel, les grands documents, la compréhension vidéo et les tâches d’agent par lots où GLM-5.3 ou Opus 5 coûteraient trop cher. Les poids MIT offrent aussi une voie d’auto-hébergement.
Il est moins adapté lorsque vous avez besoin de la réponse visible la plus rapide, que vous attendez un petit checkpoint local ou que vous voulez le meilleur score de raisonnement disponible quel que soit le prix. GLM-5.3 est plus rapide dans la mesure indépendante actuelle. Opus 5 obtient un score plus élevé. Les deux coûtent plus cher.
Mon interprétation est que Z.ai a choisi le bon compromis. GLM-5.3 Flash ne remplace pas le modèle phare. Il rend économique une autre classe de charge de travail : les agents multimodaux qui doivent regarder, raisonner, appeler des outils et continuer sans facturer les tarifs du modèle phare pour chaque token.