Plusieurs pages publiées immédiatement après le lancement de DeepSeek V4 Flash Vision Exp citent déjà le mauvais prix. C’est dire à quelle vitesse cette sortie évolue.
DeepSeek V4 Flash Vision Exp est une version expérimentale de V4 Flash qui peut accepter des images en plus du texte. Il peut inspecter des captures d’écran, lire le texte dans les images, analyser des graphiques et transmettre le résultat à des outils. DeepSeek l’a publié le 21 août 2026 sous l’ID de modèle deepseek-v4-flash-vision-exp. 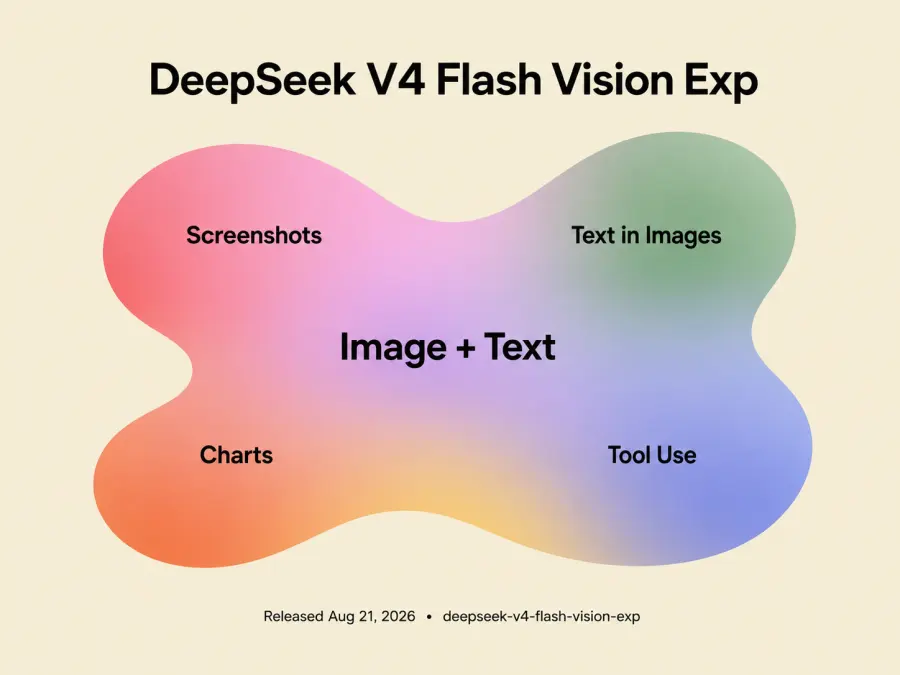
La distinction importante, c’est ce qu’il n’est pas. Il ne s’agit pas d’un nouveau générateur d’images, ni d’une mise à niveau globale pour toutes les charges de travail V4 Flash. DeepSeek le positionne comme une branche expérimentale compatible avec la vision, avec à peu près les mêmes capacités de texte que V4 Flash. Si votre application n’envoie jamais d’image, le modèle texte standard reste le choix le plus simple.
DeepSeek V4 Flash Vision Exp est désormais disponible via GPTProto. Les développeurs peuvent envoyer du texte et des images en entrée via la route GPTProto du modèle, en utilisant le même compte, la même clé API et le même solde partagé que pour les autres modèles pris en charge. La page du modèle en direct affiche actuellement le tarif standard de 0,44 $ par million de tokens d’entrée et de 1,32 $ par million de tokens de sortie, avec également des tarifs hors pointe basés sur les horaires.
Le modèle reste expérimental. Avant d’acheminer le trafic de production vers lui, testez le format d’image exact, les limites de requêtes, la latence et le comportement de repli indiqués dans le guide de démarrage rapide en direct de GPTProto.
Qu'est-ce qui a changé par rapport à DeepSeek V4 Flash ?
La mise à niveau est ciblée mais utile : V4 Flash peut désormais recevoir du contexte visuel. Une requête peut contenir du texte ainsi qu'une ou plusieurs images JPEG, PNG, GIF ou WebP. DeepSeek expose cette capacité via ses API Chat Completions et Responses compatibles OpenAI, ainsi que son API Messages compatible Anthropic.
Les images peuvent arriver de trois manières :
Une URL de données Base64 intégrée dans la requête.
Une URL HTTP ou HTTPS accessible publiquement.
Un file_id créé via l'API Files.
La troisième option est importante lorsqu'un agent doit inspecter plusieurs fois la même capture d'écran. Téléchargez-la une fois, réutilisez l'identifiant et évitez d'envoyer le fichier entier à chaque requête. DeepSeek indique que les téléchargements via l'API Files sont gratuits, mais pas l'inférence : l'image est toujours convertie en tokens d'entrée et facturée avec le texte qui l'accompagne.
Voici la répartition pratique entre les trois routes V4 actuelles :
| Modèle |
Entrée image |
Contexte officiel / sortie max |
Entrée / sortie en cas d'échec de cache au pic |
Adéquation pratique |
| DeepSeek V4 Flash Vision Exp |
Oui |
1M / 384K |
0,44 $ / 1,32 $ par million de tokens |
Expériences sur captures d'écran, graphiques, images de documents et agents GUI |
| DeepSeek V4 Flash |
Non |
1M / 384K |
0,44 $ / 1,32 $ par million de tokens |
Texte à haut volume, extraction, chat et sous-tâches d'agent routinières |
| DeepSeek V4 Pro |
Non |
1M / 384K |
1,32 $ / 3,96 $ par million de tokens |
Codage plus difficile, raisonnement et tâches d'agent plus longues |
Ce sont les tarifs officiels actuels aux heures pleines, et non une promesse que les prix resteront inchangés. DeepSeek se réserve explicitement le droit de les ajuster.
Mon analyse pratique est simple. Choisissez Vision Exp parce que vous avez besoin d'entrée d'image, pas parce que Vision sonne comme un niveau supérieur. Choisissez V4 Flash lorsque le travail est uniquement textuel et sensible aux coûts. Déplacez les tâches textuelles difficiles vers V4 Pro lorsque la qualité de raisonnement ajoutée vaut environ trois fois le prix officiel des tokens.
Fonctionnalités de DeepSeek V4 Flash Vision Exp — et ses limites réelles
La courte liste de fonctionnalités semble généreuse : texte et images mélangés, appels d'outils, sortie JSON, mode de réflexion sélectionnable, trois formats d'API et le même contexte de 1M de tokens que celui affiché pour les autres modèles V4. Les limites déterminent si ces fonctionnalités survivent au contact d'une charge de travail en production.
| Méthode d'entrée |
Limite |
Utilisation optimale |
Base64 ou file_data en ligne |
Corps entier de la requête : 48 MiB |
Images locales et requêtes à usage unique |
| URL externe |
URL : 8 192 caractères ; image : 32 MiB ; téléchargement : 60 secondes |
Images publiques déjà hébergées |
API Files file_id |
Image : 64 MiB |
Images réutilisées ou requêtes qui dépasseraient la limite de corps en ligne |
Le placement des images dépend du format d'API. Dans les requêtes Chat Completions et Messages compatibles Anthropic, le contenu image doit figurer dans un message utilisateur. L'API Responses peut également recevoir des images dans les messages développeur et dans les sorties d'appels d'outils prises en charge. Les images placées dans des messages système ou assistant renvoient une erreur 400. L'envoi d'une image aux routes V4 Flash ou V4 Pro uniquement textuelles renvoie également une erreur, car ces modèles n'acceptent pas d'entrée image native.
Vision Exp prend en charge les réglages de détail low, high, original et auto pour les entrées image_url, mais le modèle applique toujours son processus de redimensionnement documenté. Les images en dessous d'une échelle totale d'environ 384×384 pixels sont agrandies. Les images plus grandes sont réduites tout en conservant le rapport d'aspect jusqu'à ce que leur nombre total de pixels soit à peu près équivalent à 800×800.
Ce redimensionnement produit un plafond de 384 tokens d'entrée par image. Cela rend le coût prévisible. Le compromis est la résolution : les petites étiquettes, les feuilles de calcul denses, les annotations fines sur les diagrammes et le petit texte d'interface peuvent ne pas survivre à la réduction. Une source de 5 000×5 000 n'achète pas plus de tokens d'image qu'une source de 2 000×2 000.
Une autre limite est facile à manquer. Vision Exp ne prend pas en charge la complétion FIM, tandis que V4 Flash et V4 Pro la prennent en charge en mode non-réflexion. Les développeurs qui créent des outils de complétion de code en ligne ne doivent pas considérer la route vision comme un remplacement direct.
Tarification de DeepSeek V4 Flash Vision Exp
J'ai consulté le tableau de tarification en direct de DeepSeek le 24 août 2026. Les tarifs sont :
| Type de token |
Heures creuses |
Heures pleines |
| Entrée avec succès de cache |
0,007 $ par 1M |
0,014 $ par 1M |
| Entrée avec échec de cache |
0,22 $ par 1M |
0,44 $ par 1M |
| Sortie |
0,66 $ par 1M |
1,32 $ par 1M |
Les heures pleines s'étendent de 01:00 à 04:00 et de 06:00 à 10:00 UTC, du lundi au vendredi. Toute autre période, y compris les week-ends, utilise le tarif heures creuses à moitié prix.
Certains articles explicatifs récemment indexés citent encore 0,14 $ par million de tokens d'entrée et 0,28 $ par million de tokens de sortie. Ne construisez pas un budget sur ces chiffres. Ils ne correspondent plus au tableau officiel.
Au plafond documenté de 384 tokens par image, le calcul de l'entrée uniquement image est :
Heures creuses : 384 × 0,22 $ / 1 000 000 = 0,00008448 $ par image
Heures pleines : 384 × 0,44 $ / 1 000 000 = 0,00016896 $ par image
Cela représente environ 0,08448 $ à 0,16896 $ pour 1 000 images avant le texte et la sortie. C'est bon marché, mais le titre peut être trompeur. Une réponse de 1 000 tokens coûte 0,00132 $ au tarif de sortie en heures pleines — près de huit fois la charge d'entrée maximale pour une image. Des réponses concises et un max_tokens contrôlé peuvent compter davantage que d'économiser quelques tokens sur l'image.
Le chiffre de 384 est aussi un maximum, pas un coût fixe par image. L'utilisation réelle des tokens dépend des dimensions après l'étape de redimensionnement de DeepSeek.
DeepSeek V4 Flash Vision Exp vs Opus 4.8
DeepSeek affirme que Vision Exp rapproche les performances des agents multimodaux de celles d'Opus 4.8. Son propre graphique de référence soutient une affirmation plus nuancée : les modèles échangent des victoires sur quatre évaluations d'agents multimodaux sélectionnées.
| Benchmark d'agents multimodaux |
Vision Exp |
Opus 4.8 |
Score plus élevé |
| ApexBench, Pass@1 |
36.5 |
39.4 |
Opus 4.8 |
| Agents' Last Exam |
27.3 |
25.7 |
Vision Exp |
| Chartography |
64.3 |
65.0 |
Opus 4.8 |
| ZeroBench, Pass@5 |
35.0 |
34.0 |
Vision Exp |
Deux victoires chacun. C'est compétitif, mais cela ne prouve pas que Vision Exp égale Opus 4.8 en termes de précision OCR, de taux d'hallucination visuelle, de lecture de petits textes, de navigation dans l'interface ou d'agents de longue durée.
Les résultats des agents textuels ajoutent du contexte. Le graphique de DeepSeek contient sept évaluations textuelles. Vision Exp ne devance Opus 4.8 que sur DeepSWE, 59,3 contre 58,0. Il est en retard sur Terminal Bench 2.1, NL2Repo, Cybergym, Toolathlon-Verified, DSBench-Hard et AutomationBench.
Ces chiffres proviennent également de DeepSeek, et non d'un évaluateur indépendant. L'entreprise a exécuté ses modèles en mode Minimal avec une longueur de sortie maximale, top_p=0.95 et temperature=1.0. Au 24 août, je n'ai pas trouvé Vision Exp dans les résultats d'Artificial Analysis ou de LMArena. Ma conclusion est donc provisoire : les données de lancement justifient de tester le modèle, pas de déclarer un vainqueur global.
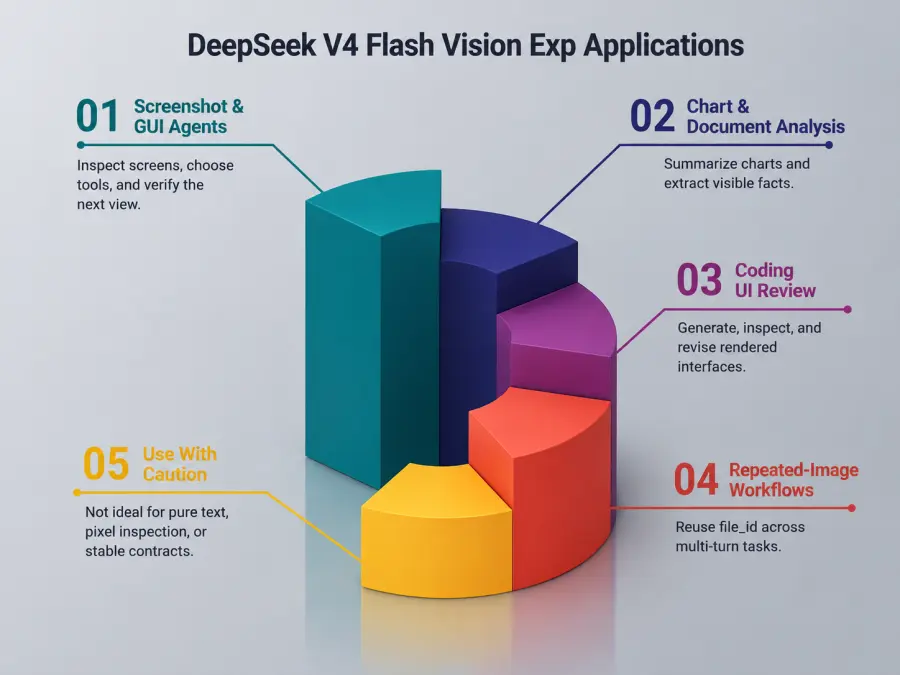
Applications de DeepSeek V4 Flash Vision Exp
Agents de capture d'écran et d'interface graphique
Un agent navigateur ou bureau peut inspecter un écran, décider quel outil appeler et examiner la capture d'écran suivante. Le faible plafond de tokens d'image maintient le coût des observations répétées à un niveau bas. Le coût est la précision visuelle, alors testez les petites étiquettes, le texte d'erreur et les menus denses avant de faire confiance aux clics autonomes.
Analyse de graphiques et d'images de documents
Le modèle peut résumer des graphiques, extraire des faits visibles et les combiner avec des instructions textuelles. Il devrait fonctionner au mieux sur des pages propres et lisibles. Les petits caractères numérisés et les grandes feuilles de calcul sont plus risqués, car les images sont redimensionnées avant l'inférence.
Agents de codage qui examinent les interfaces
Un agent de codage peut générer une page, inspecter le résultat rendu, puis réviser le code. Cela comble une lacune laissée par V4 Flash uniquement textuel. Néanmoins, une capture d'écran n'est pas un arbre DOM : le modèle peut remarquer un bouton mal placé sans identifier la règle CSS exacte qui en est la cause.
Flux de travail avec images répétées
L'API Files convient aux catalogues de produits, à la révision de documents ou à tout flux qui fait référence à une image sur plusieurs tours. Réutiliser un file_id économise de la bande passante de requête. Cela ne supprime pas les frais de tokens d'image lorsque le modèle traite à nouveau ce fichier.
Quand ne pas l'utiliser
Vision Exp est un choix par défaut faible pour le texte pur, l'inspection au niveau des pixels ou les systèmes qui exigent un contrat de modèle stable. Le suffixe -exp compte. Conservez des tests de régression, journalisez le comportement du modèle et maintenez une route de secours si un flux visuel affecte l'argent, les autorisations ou les données client.
Comment utiliser DeepSeek V4 Flash Vision Exp via l'API
DeepSeek V4 Flash Vision Exp est disponible via le point de terminaison compatible OpenAI de GPT Proto. L'exemple Python suivant envoie une image de graphique publique accompagnée d'une instruction textuelle :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4-flash-vision-exp",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": "Lisez ce graphique et listez les trois conclusions les plus importantes."
                },
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://api-docs.deepseek.com/img/v4_260821_benchmark_en.png"
                    }
                }
            ]
        }
    ],
)

print(response.choices[0].message.content)
L'exemple utilise l'image de référence publique de DeepSeek, il peut donc être exécuté sans préparer d'image au préalable. Pour un fichier local, encodez-le en URL de données Base64 ; pour un fichier volumineux ou utilisé de façon répétée, téléchargez-le d'abord et envoyez son file_id. Le guide de l'API Vision de DeepSeek documente les trois formats.
Utiliser Vision Exp via GPT Proto
GPT Proto expose désormais DeepSeek V4 Flash Vision Exp comme une route multimodale avec entrée texte et image, et sortie texte. Le tarif standard actuel est de 0,44 $ par million de tokens d'entrée et de 1,32 $ par million de tokens de sortie. Les tokens d'image s'ajoutent à la facture d'entrée texte, DeepSeek documentant un plafond de 384 tokens d'entrée par image.
L'avantage pratique est la consolidation des comptes : la même clé GPT Proto et le même solde partagé peuvent également appeler les modèles uniquement textuels DeepSeek V4 Flash et DeepSeek V4 Pro. Cela facilite le routage des tâches visuelles vers Vision Exp tout en conservant le travail textuel routinier sur le modèle Flash stable.
DeepSeek V4 Flash Vision Exp vaut-il la peine d'être utilisé ?
Oui — pour tester des agents conscients des images où le coût d'entrée et les captures d'écran répétées comptent. Non — comme mise à niveau automatique pour une application uniquement textuelle.
Les forces confirmées sont une large compatibilité API, une utilisation prévisible des tokens d'image, un contexte de 1M de tokens et des résultats rapportés par le fournisseur qui sont au moins compétitifs avec Opus 4.8 sur quatre tests d'agents multimodaux. Les coûts sont un contrat expérimental, un redimensionnement agressif des images, aucun résultat de benchmark indépendant pour l'instant, et des performances mitigées face à Opus plutôt qu'une victoire nette.
Si votre charge de travail est uniquement textuelle, commencez par DeepSeek V4 Flash et faites monter les demandes difficiles de codage ou de raisonnement vers DeepSeek V4 Pro. Si des captures d'écran, des graphiques, des rendus d'interface ou des images de documents contiennent des informations dont l'agent a besoin, testez l'DeepSeek V4 Flash Vision Exp API directement via GPT Proto.
Ne faites pas passer la route expérimentale en production en vous basant uniquement sur quatre benchmarks rapportés par le fournisseur. Testez-la d'abord sur vos propres petits textes, tableaux de bord denses, bugs visuels et workflows d'outils à plusieurs étapes.