Aperçu des meilleurs modèles LLM chinois
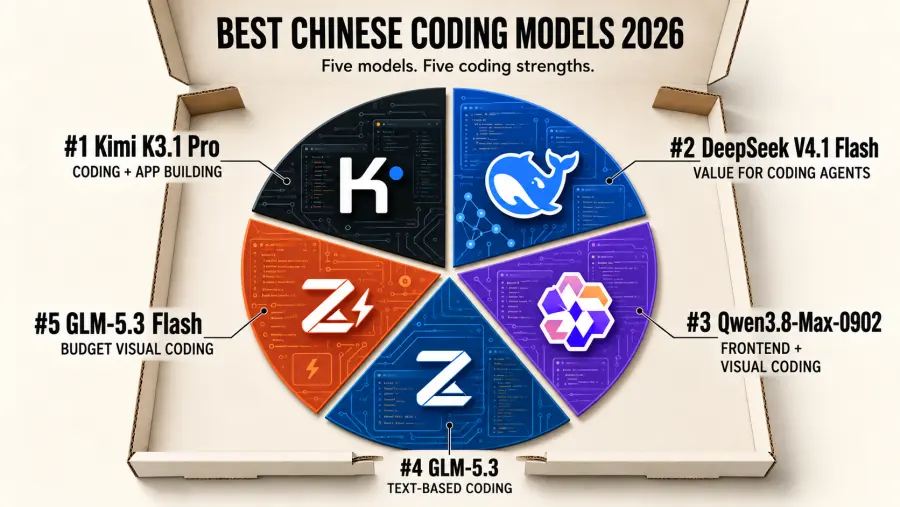
| Rang |
Modèle |
Utilisation recommandée |
Compromis principal |
| 1 |
Kimi K3.1 Pro |
Codage complexe, création d'applications et tâches d'agents étendues |
Tarifs par jeton plus élevés que les candidats économiques |
| 2 |
DeepSeek V4.1 Flash |
Agents de codage soucieux des coûts et travail d'implémentation répétitif |
Confirmez le point de contrôle utilisé avant d'appliquer les résultats du benchmark 1017 |
| 3 |
Qwen3.8-Max-0902 |
Implémentation frontend et débogage visuel |
Tarifs par jeton plus élevés que DeepSeek et GLM Flash |
| 4 |
GLM-5.3 |
Investigation de référentiel basée sur le texte et tâches de terminal |
La preuve visuelle native nécessite une autre approche |
| 5 |
GLM-5.3 Flash |
Codage visuel économique et sous-tâches fréquentes d'agents |
Testez les tâches difficiles avant d'en faire le seul modèle de production |
La comparaison des prix figure ci-dessous. Séparer le prix des capacités permet de mieux comprendre pourquoi un modèle plus coûteux peut tout de même valoir la peine d'être testé pour une tâche spécifique.
Les mesures de vitesse proviennent de l'API de chaque créateur de modèle, telles que mesurées par Artificial Analysis. Ce sont des instantanés utiles, et non des garanties de latence pour GPT Proto. La charge du fournisseur, la longueur de l'invite, l'effort de raisonnement, le comportement du cache et la longueur de la sortie peuvent tous modifier les performances en production.
La colonne de modalité décrit les routes exposées par GPT Proto. Un point de contrôle téléchargeable et une API hébergée portant un nom similaire peuvent ne pas exposer des fonctionnalités identiques.
Comment nous avons classé les modèles de codage chinois
Un nombre élevé de paramètres ou une fenêtre contextuelle d'un million de jetons ne vous indique pas si un modèle peut mener à bien une tâche sur un dépôt. Les cinq modèles de ce classement appartiennent à peu près à la même catégorie de contexte long. Leurs différences pratiques se situent ailleurs.
Nous avons pris en compte six questions :
Comment le modèle se comporte-t-il lors d'évaluations indépendantes, plutôt que de se baser uniquement sur les graphiques de référence de ses développeurs ?
Peut-il gérer le codage multi-fichiers, le travail sur terminal, les appels d'outils et les boucles planifier-exécuter-vérifier ?
Peut-il inspecter des captures d'écran, des diagrammes, des documents ou des flux de produits enregistrés lorsque les preuves ne sont pas uniquement textuelles ?
Quel est le coût réel d'une tâche API une fois les jetons de sortie, le raisonnement et les tentatives probables inclus ?
Les poids du modèle sont-ils réellement téléchargeables et quelle licence régit le déploiement commercial ?
Existe-t-il une route GPT Proto en direct que les lecteurs peuvent tester via le même compte et le même format d'API ?
Le classement actuel Artificial Analysis indique des scores d'Intelligence Index de 46 pour Kimi K3.1 Pro, 34 pour Qwen3.8 Max 0902, et 32 chacun pour DeepSeek V4.1 Flash 1017 au raisonnement maximal et GLM-5.3 au raisonnement maximal. L'indice est une mesure de capacité globale. Il ne mesure pas directement le coût de correction d'un bug dans votre application.
Ces scores appartiennent à l'Intelligence Index v5.0. Ne les combinez pas avec des versions antérieures de l'indice et n'interprétez pas un changement entre les versions d'évaluation comme un déclin du modèle lui-même. Nous évitons également d'attribuer à GLM-5.3 Flash un ancien score d'indice lorsque le classement actuel n'affiche pas de valeur comparable.
Les résultats en matière de codage peuvent varier. Dans la comparaison DeepSeek–GLM d'Artificial Analysis, GLM est en tête sur Terminal-Bench 4.0, tandis que DeepSeek est en tête sur FrontierCode 2.0. Cette divergence explique pourquoi cette liste restreinte inclut des recommandations spécifiques aux tâches et accorde une importance au coût dans l'ordre de classement.
1. Kimi K3.1 Pro : Le meilleur candidat global pour le codage
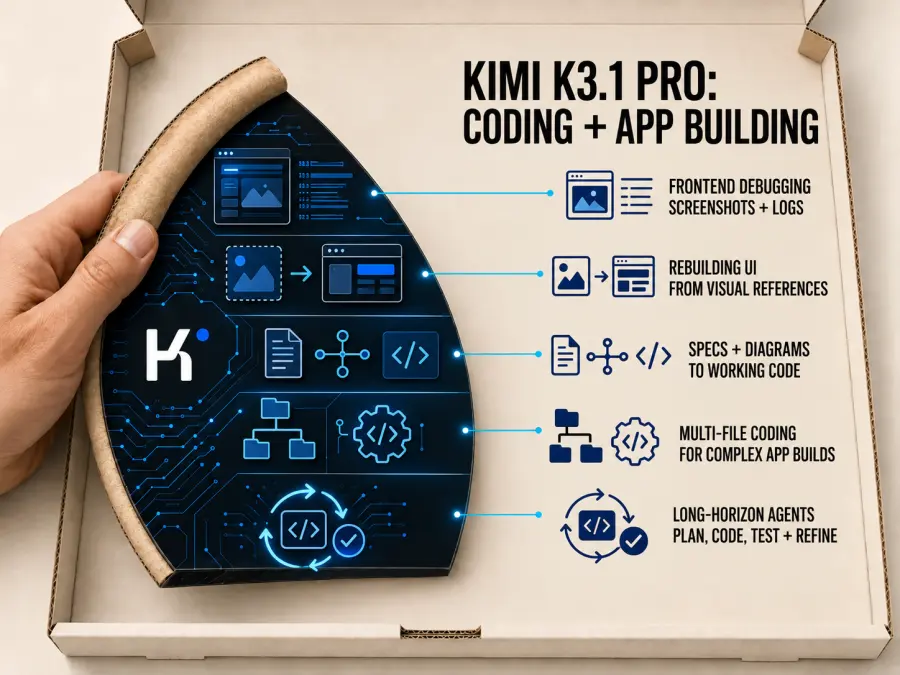
Kimi K3.1 Pro prend la première place car cette nouvelle version apporte des preuves plus solides pour les travaux logiciels complexes et étendus. Le blog technique de Moonshot rapporte un score de 65,7 % sur Terminal-Bench 4.0 et de 61,2 % sur son benchmark interne Kimi Code Bench 3.0 Long-horizon, contre 55,95 % pour K3 sur ce dernier. Il s'agit de résultats rapportés par le fournisseur.
Il existe également un signal indépendant : Artificial Analysis enregistre environ 67 % sur Terminal-Bench 4.0. Ce résultat appartient à son propre protocole d'évaluation ; il doit rester distinct des chiffres de Moonshot.
Je testerais K3.1 Pro en priorité lorsqu'un agent doit comprendre une application inconnue, modifier plusieurs fichiers connectés et continuer à travailler après l'échec d'un test. Pour les développeurs d'applications, la question utile est de savoir s'il peut fournir une fonctionnalité conforme au cahier des charges après implémentation et correction.
Sa route GPT Proto accepte des entrées textuelles et visuelles. Cela en fait un candidat pour les travaux combinant code source, référence de conception et interface rendue. Il est toujours préférable de commencer par une tâche délimitée : définissez le comportement attendu et donnez à l'agent un moyen de le vérifier.
Le coût plus élevé en jetons est le compromis. Réservez-le aux travaux où une meilleure qualité de complétion justifie la dépense. Gardez également le statut de déploiement précis : à la date de cette mise à jour, Moonshot prévoit la sortie des poids complets de K3.1 Pro pour le 4 novembre. Les poids K3 existants ne garantissent pas que K3.1 Pro est déjà téléchargeable.
Verdict : Commencez par Kimi K3.1 Pro pour une fonctionnalité difficile ou une construction d'application, puis comparez les changements acceptés et le coût total avec un candidat moins onéreux.
2. DeepSeek V4.1 Flash : Le meilleur rapport qualité-prix pour les agents de codage
DeepSeek mérite une position plus élevée lorsque l'objectif est de maintenir une capacité de codage utile dans le cadre d'un budget de production reproductible. C'est un candidat idéal pour les agents qui lisent du code, proposent des correctifs, inspectent les résultats des tests et effectuent une nouvelle tentative.
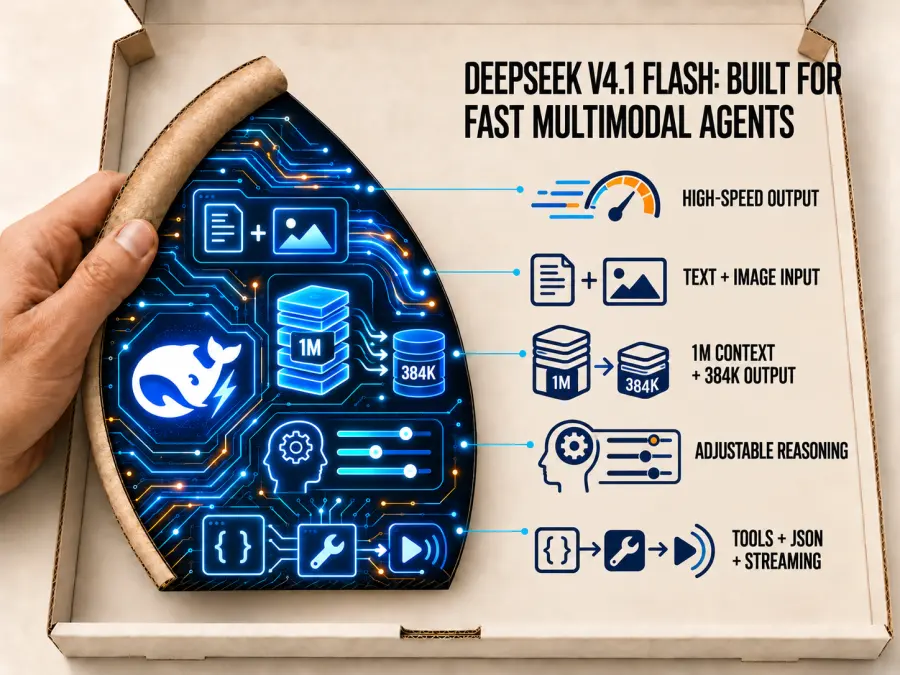
La fiche technique de DeepSeek V4.1 Flash 1017 rapporte des améliorations par rapport à la version précédente de V4.1 Flash : Terminal-Bench 4.0 passe de 31,2 à 42,3, DeepSWE v1.1 de 74,2 à 77,0, et ProgramBench de 20,3 à 29,1. Il s'agit des évaluations rapportées par DeepSeek, et non d'une reproduction par GPT Proto.
Cette mise à jour renforce l'intérêt d'inclure DeepSeek dans un essai de codage. Cela ne rend pas tous les autres modèles obsolètes. Les évaluations de codage indépendantes montrent toujours des gagnants différents selon la tâche, et un agent de production doit être jugé sur les outils et les limites qu'il utilisera réellement.
Gardez la distinction de route explicite. GPT Proto expose DeepSeek Flash via deepseek-flash ; sa page publique décrit V4.1 Flash sans identifier le point de contrôle 1017. Confirmez la révision déployée avant de traiter les nouveaux résultats comme des preuves concernant ce point de terminaison exact.
Verdict : Testez DeepSeek comme modèle d'implémentation axé sur la valeur. Enregistrez la révision du modèle ainsi que le taux de réussite, les tentatives, la latence et les dépenses afin qu'une mise à jour ultérieure de l'alias ne rende pas la comparaison ambiguë.
3. Qwen3.8-Max-0902 : le meilleur choix pour le frontend et le débogage visuel
Qwen reste un choix utile lorsqu'une tâche de codage commence par quelque chose de visible : une page de référence, une mise en page défectueuse, un graphique ou une séquence d'états d'interface. La voie Qwen3.8-Max-0902 prend en charge l'entrée multimodale, permettant à une application de combiner du matériel visuel avec du code et des instructions.
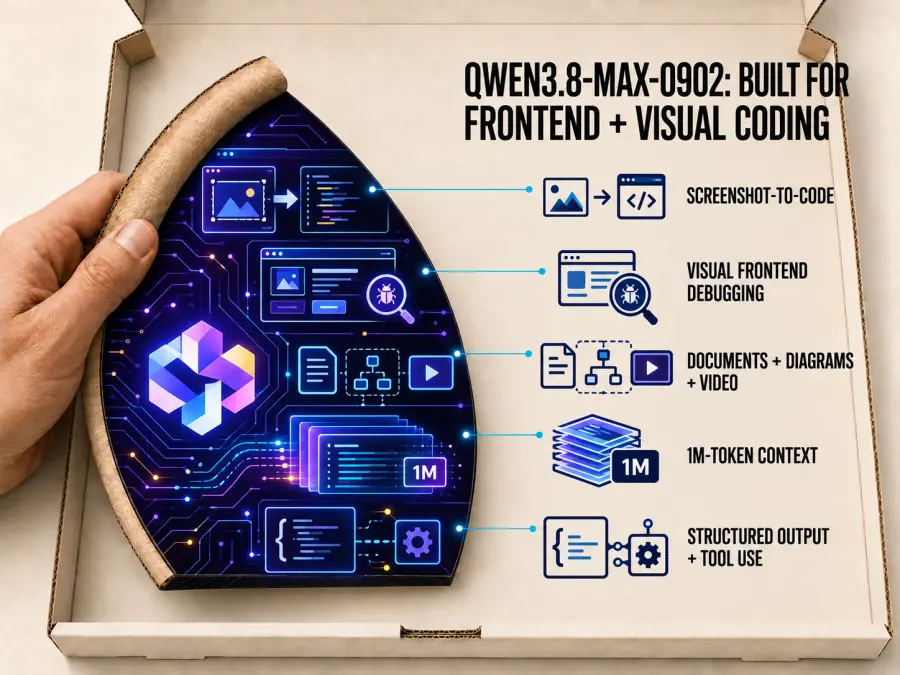
Pour une évaluation frontend, donnez-lui la même référence de conception et le même accès au dépôt que les autres candidats. Demandez à l'agent d'implémenter la page, de la rendre, de vérifier les états importants et de corriger le résultat. Jugez l'espacement, la hiérarchie, la réactivité et les interactions fonctionnelles en plus de la correction du code.
C'est pourquoi Qwen conserve une place dédiée ici, même après la mise à jour de Kimi. Une sélection frontend nécessite des critères d'acceptation visuels, et un score d'intelligence générale ne décrit que partiellement ce travail. Il s'agit de notre recommandation de flux de travail ; ce n'est pas une affirmation selon laquelle Qwen a remporté un nouveau test frontend à cinq modèles.
Le compromis en termes de coût est simple : ses tarifs de jetons affichés sont plus élevés que ceux de DeepSeek et de GLM Flash. Pour un petit correctif textuel, incluez l'une de ces voies moins coûteuses dans l'essai. Gardez également l'instantané hébergé 0902 exact séparé de tout point de contrôle téléchargeable associé lors de la documentation des fonctionnalités.
Verdict : Ajoutez Qwen à votre liste de présélection lorsque la correspondance avec un brief visuel est essentielle à la réussite de l'implémentation.
4. GLM-5.3 : le meilleur choix pour le travail sur dépôt basé sur le texte
GLM-5.3 reste pertinent pour l'investigation de code, les tâches de terminal et les changements dont les preuves sont disponibles sous forme de texte. Le classement mis à jour donne à Kimi la recommandation globale tout en conservant GLM comme candidat ciblé pour le codage.
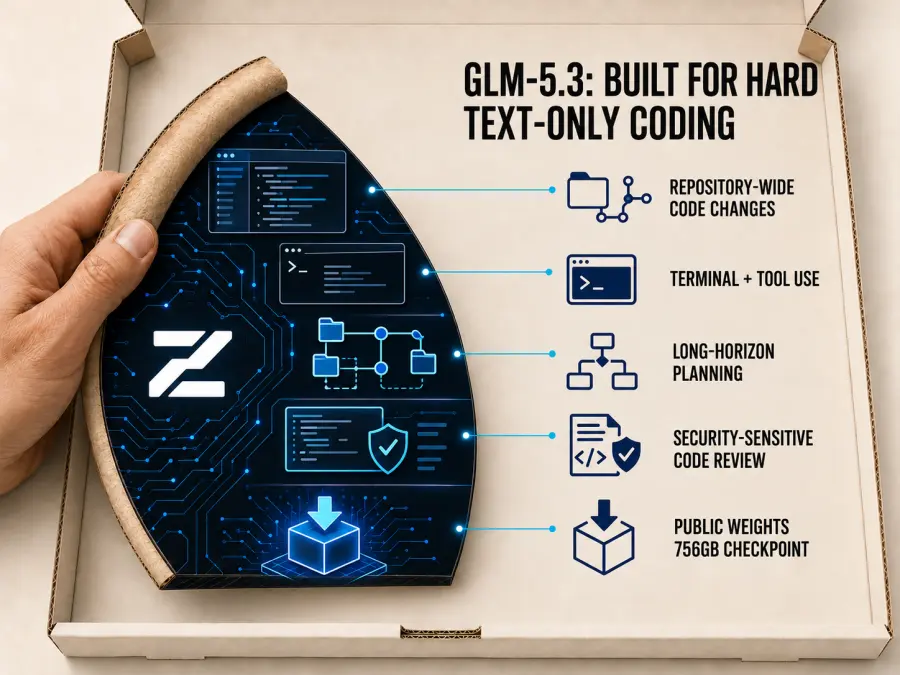
La comparaison indépendante DeepSeek–GLM illustre sa position : GLM obtient un score de 42 % sur Terminal-Bench 4.0 contre 34 % pour DeepSeek 1017, tandis que FrontierCode 2.0 favorise DeepSeek, 28 % contre 22 %. Ces résultats décrivent la configuration de cet évaluateur, ils ne doivent donc pas être substitués aux exécutions configurées différemment par les fournisseurs.
Je garderais GLM dans un essai impliquant une intégration backend défaillante, une dépendance inconnue ou un changement de dépôt nécessitant plusieurs cycles de commande et de test. Les critères d'acceptation doivent inclure un test de reproduction réussi et une explication de ce qui a changé.
La page GPT Proto GLM-5.3 documente l'entrée et la sortie de texte. Si l'agent doit inspecter directement une capture d'écran, utilisez une voie visuelle pour cette étape. Ses tarifs de jetons plus élevés que les modèles économiques rendent également les tentatives répétées dignes d'être mesurées.
Verdict : Conservez GLM-5.3 pour les flux de travail de dépôt et de terminal où il réussit vos tests de manière cohérente. Comparez-le avec Kimi pour les tâches difficiles et avec DeepSeek pour le coût.
5. GLM-5.3 Flash : le meilleur candidat économique pour le codage visuel
GLM-5.3 Flash conserve sa place, car les appels fréquents aux agents peuvent rendre les tarifs des jetons plus importants qu'une légère différence de capacité globale. Il affiche les tarifs d'entrée et de sortie les plus bas parmi ces cinq entrées GPT Proto dans l'aperçu des prix ci-dessous.
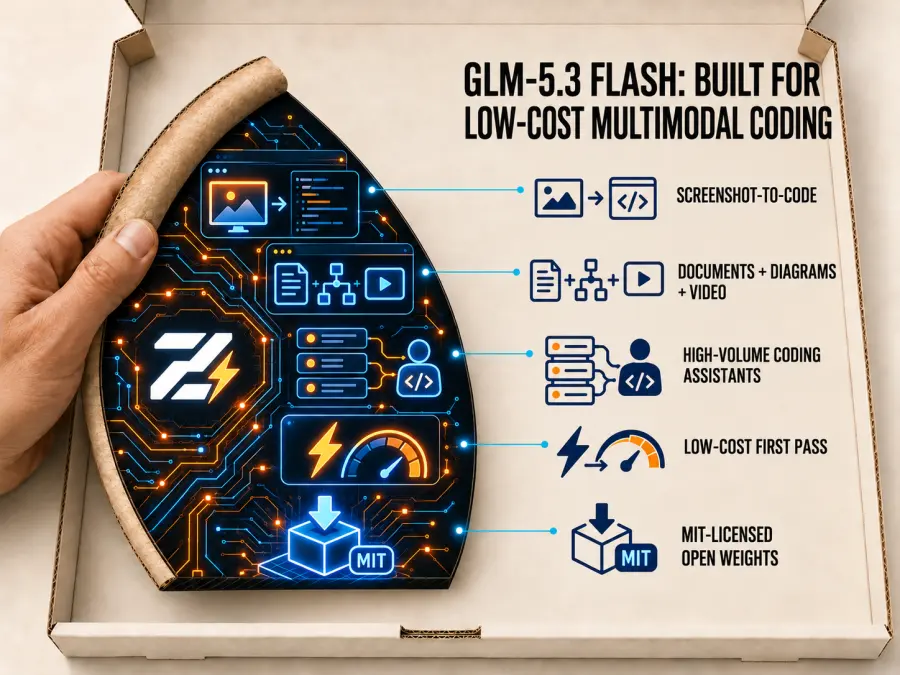
La page du modèle documente les entrées texte, image, vidéo et fichier, ainsi que les poids sous licence MIT. Elle explique également que Flash utilise une base multimodale différente de celle du GLM-5.3 standard. Considérez les deux comme des candidats distincts lors de l'élaboration d'une politique de routage.
Une évaluation pratique assignerait à Flash un problème délimité, une vérification de mise en page visuelle ou une implémentation initiale. Conservez les mêmes tests d'acceptation que ceux utilisés pour les modèles plus grands. Si le résultat échoue, comptabilisez la tentative infructueuse et l'escalade dans le coût total.
Les tarifs bas laissent une marge de manœuvre pour l'itération, mais des tentatives répétées et improductives peuvent effacer cet avantage. Mesurez la fréquence de réussite de la tâche avant de le choisir comme option par défaut. Le raisonnement est toujours activé sur le modèle documenté, alors incluez l'utilisation des jetons de raisonnement et le temps de réponse dans cette vérification.
Verdict : Testez GLM-5.3 Flash comme option économique par défaut pour le codage visuel et les sous-tâches récurrentes, avec un chemin d'escalade clair en cas d'échec.
Mentions honorables
MiniMax M3.1 Flash
Le candidat actuel de MiniMax mérite une attention particulière au-delà de l'ancienne entrée M3. L'annonce de sortie du 19 octobre rapporte 73,7 % sur DeepSWE v1.1 et met l'accent sur une exécution d'agent à moindre coût. Cela rend M3.1 Flash pertinent pour la même discussion budgétaire que DeepSeek et GLM Flash.
Gardez-le dans votre liste de recherche jusqu'à ce que la route GPT Proto exacte, l'ID du modèle, la tarification et les fonctionnalités prises en charge soient confirmés. Un point de terminaison MiniMax M3 existant ne doit pas être étiqueté M3.1 Flash sans vérification.
Xiaomi MiMo-V2.6 et autres modèles émergents
MiMo-V2.6 mérite d'être surveillé ; Artificial Analysis inclut MiMo-V2.6-Pro dans ses évaluations. Donnez à un nouveau modèle une place dans la liste principale après avoir vérifié à la fois ses preuves de performance sur les tâches et le chemin d'accès réel recommandé.
Les anciens déploiements de Kimi K3 et DeepSeek V4 Pro peuvent toujours valoir la peine d'être conservés lorsqu'une application dépend d'un comportement validé. Testez un remplacement sur ces mêmes tâches avant de déplacer le trafic existant.
Modèles à surveiller
Step 5 Preview et la famille MiMo-V2.6 de Xiaomi sont de nouveaux modèles chinois pertinents, mais ils ne sont pas inclus dans le classement principal car GPT Proto ne disposait pas de routes actives confirmées pour eux au moment de cette mise à jour. Ajoutez-les à la liste classée uniquement après que la page exacte du modèle, la chaîne API, le prix et les champs de requête pris en charge soient en ligne et testés.
Une tâche de codage réelle, cinq choix différents
Envisagez l'ajout d'une facturation par abonnement à une application SaaS TypeScript existante. L'agent doit comprendre le modèle utilisateur actuel, implémenter un flux de paiement, gérer les événements webhook en toute sécurité, mettre à jour les autorisations de compte et vérifier le résultat.
| Exigence |
Candidat à évaluer |
Points à vérifier |
| Implémenter la fonctionnalité connectée dans plusieurs fichiers |
Kimi K3.1 Pro |
Comportement correct, changements cohérents et récupération après des tests échoués |
| Exécuter des tentatives répétées d'implémentation et de correction |
DeepSeek V4.1 Flash |
Correctifs acceptés par dollar ; enregistrer la révision fournie |
| Faire correspondre l'interface de facturation à une référence de conception |
Qwen3.8-Max-0902 |
Précision visuelle, comportement réactif et états de fonctionnement |
| Diagnostiquer les échecs du backend et du terminal |
GLM-5.3 |
Qualité de reproduction, utilisation des commandes et résultats des tests |
| Gérer l'implémentation limitée ou les vérifications visuelles à moindre coût |
GLM-5.3 Flash |
Taux d'échec, tentatives et coût incluant les escalades |
Pour cet exemple, un bouton de paiement esthétique n'est qu'une partie du résultat. Le webhook doit être vérifié, les événements en double ne doivent pas accorder d'avantages en double, et les changements d'abonnement doivent mettre à jour le compte correct. Rédigez ces tests d'acceptation avant de comparer les modèles.
Combien coûterait la même tâche de codage ?
Pour une comparaison simple du coût en jetons, supposons 100 000 jetons d'entrée non mis en cache et 20 000 jetons de sortie facturables par tentative. Ce qui suit utilise les panneaux de tarification affichés par GPT Proto consultés le 29 octobre 2026. Les tarifs sont en USD par million de jetons ; aucune économie liée au cache ou aux heures creuses n'est supposée.
| Modèle |
Entrée / 1M |
Sortie / 1M |
Coût illustratif en jetons |
| Kimi K3.1 Pro |
2,00 $ |
10,00 $ |
0,4000 $ |
| DeepSeek Flash |
0,24 $ |
0,96 $ |
0,0432 $ |
| Qwen3.8-Max-0902 |
1,40 $ |
4,20 $ |
0,2240 $ |
| GLM-5.3 |
1,19 $ |
3,74 $ |
0,1938 $ |
| GLM-5.3 Flash |
0,1275 $ |
0,425 $ |
0,02125 $ |
Le calcul est 0,1 × tarif d'entrée + 0,02 × tarif de sortie. La ligne DeepSeek indique le prix de la route GPT Proto affichée ; elle n'établit pas le point de contrôle servi par cet alias.
Il s'agit de frais de jetons illustratifs. La sortie réelle doit inclure le raisonnement facturable le cas échéant, et une tâche complète peut impliquer plus de tours, de résultats d'outils, de tentatives ou un autre modèle. Consultez le panneau de tarification en direct lors de la planification de vos dépenses.
Mesurez les dépenses totales de l'API divisées par les changements qui réussissent vos tests d'acceptation. Cela donne une comparaison plus utile que de supposer que chaque modèle termine la tâche avec le même nombre de jetons.
Pourquoi le gagnant des benchmarks n'est peut-être pas le meilleur agent de codage
Votre agent de codage contrôle les fichiers que le modèle voit, la manière dont les outils sont appelés, le moment où les tests sont exécutés et ce qui se passe après un échec. Modifier cette configuration peut changer le résultat, même si le modèle reste le même.
Avant de comparer les candidats, maintenez constants le dépôt, les instructions de tâche, les outils, les tests d'acceptation et la limite de temps. Autorisez chaque modèle à utiliser le format de requête qu'il exige et enregistrez ses paramètres de raisonnement. Mesurez ensuite les tâches terminées, les régressions, les tentatives, le temps écoulé et les dépenses liées à l'API.
Pour cette sélection, utilisez Kimi pour tester le plafond de capacité, DeepSeek et GLM Flash pour tester l'économie de production, Qwen pour l'acceptation visuelle et GLM pour l'exécution de dépôts basée sur le texte. Laissez les résultats déterminer quelles étapes partagent un modèle et lesquelles nécessitent une approche différente.
Quel modèle de codage chinois devriez-vous utiliser ?
Choisissez Kimi K3.1 Pro en priorité lorsque la réalisation d'une fonctionnalité ou d'une application complexe est l'objectif principal et que vous pouvez justifier un budget par jeton plus élevé.
Choisissez DeepSeek V4.1 Flash lorsque les appels répétés de l'agent rendent le coût important. Confirmez la révision déployée avant de baser un déploiement sur des preuves spécifiques à la version 1017.
Choisissez Qwen3.8-Max-0902 lorsque l'implémentation doit correspondre à des captures d'écran, des mises en page ou d'autres références visuelles.
Choisissez GLM-5.3 lorsque votre évaluation se concentre sur le code source, la sortie du terminal et le comportement du backend.
Choisissez GLM-5.3 Flash lorsque vous souhaitez un candidat au codage visuel à faible tarif et que vous pouvez détecter les échecs avant de les escalader.
Pour une comparaison initiale, utilisez une tâche limitée qui dispose déjà d'un test d'acceptation fiable. Un petit changement vérifié vous donne des preuves de déploiement plus utiles qu'une grande application générée que personne n'a vérifiée.
Comment appeler ces modèles LLM chinois via une API unique
Ouvrez la page du modèle que vous souhaitez essayer, puis utilisez Essayer ce modèle → Démarrage rapide. Créez ou sélectionnez une clé API GPT Proto, et utilisez Copier le Markdown pour l'IA pour fournir les instructions d'intégration actuelles à votre assistant de codage.
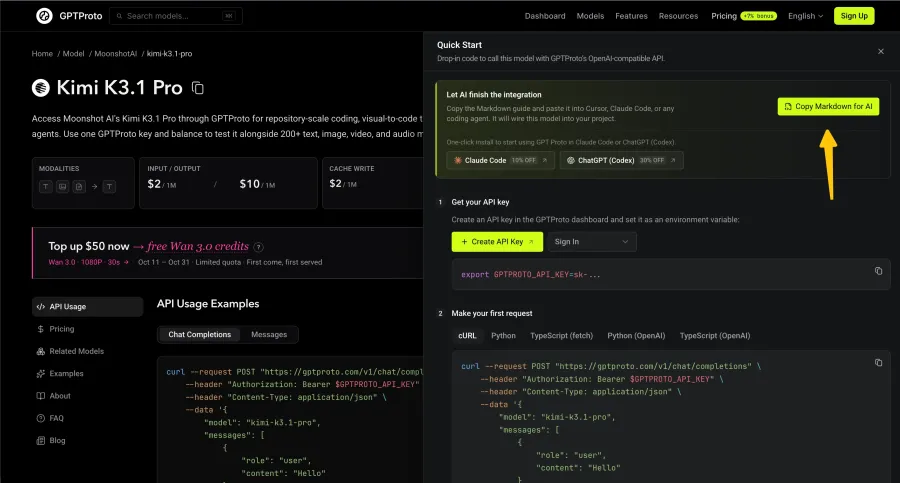
Demandez-lui d'inspecter votre projet, de suivre le point de terminaison et les champs de requête copiés, de conserver la clé dans la configuration côté serveur et d'ajouter une petite vérification de connexion. Configurez la clé réelle localement plutôt que de la coller dans une invite ou un dépôt public.
Les identifiants de modèle ci-dessous correspondent aux routes GPT Proto publiques examinées pour cette mise à jour :
| Modèle |
Identifiant de modèle GPT Proto |
| Kimi K3.1 Pro |
kimi-k3.1-pro |
| DeepSeek Flash |
deepseek-flash |
| Qwen3.8-Max-0902 |
qwen3.8-max-0902 |
| GLM-5.3 |
glm-5.3 |
| GLM-5.3 Flash |
glm-5.3-flash |
Utilisez le guide de la page du modèle en direct pour chaque route. Les modèles peuvent différer en termes de champs de raisonnement, de gestion des appels d'outils et de format de requête multimodale ; changer la chaîne de caractères du modèle n'est donc qu'une partie de la migration. Une requête unique réussie doit être suivie d'un test d'utilisation d'outils multi-tours avant une mise en production.
La connexion d'une API de modèle à votre application est également une tâche distincte du changement du modèle qui alimente votre assistant de codage. Vérifiez le format de connexion pris en charge par le client pour ce dernier.
Comparez tous les modèles GPT Proto avant d'assigner du trafic de production. Une seule clé API et un solde partagé peuvent être utilisés pour évaluer différents modèles pris en charge sans avoir à maintenir une intégration et un compte prépayé distincts pour chaque fournisseur.
Ouvrez Kimi K3.1 Pro pour commencer avec une tâche de codage difficile, ou comparez DeepSeek Flash et GLM-5.3 Flash lorsque le coût des appels répétés est la priorité. Utilisez le guide d'intégration de la page du modèle et vérifiez un petit changement avant d'étendre la charge de travail.