Bezahlbare Coding-LLMs auf einen Blick
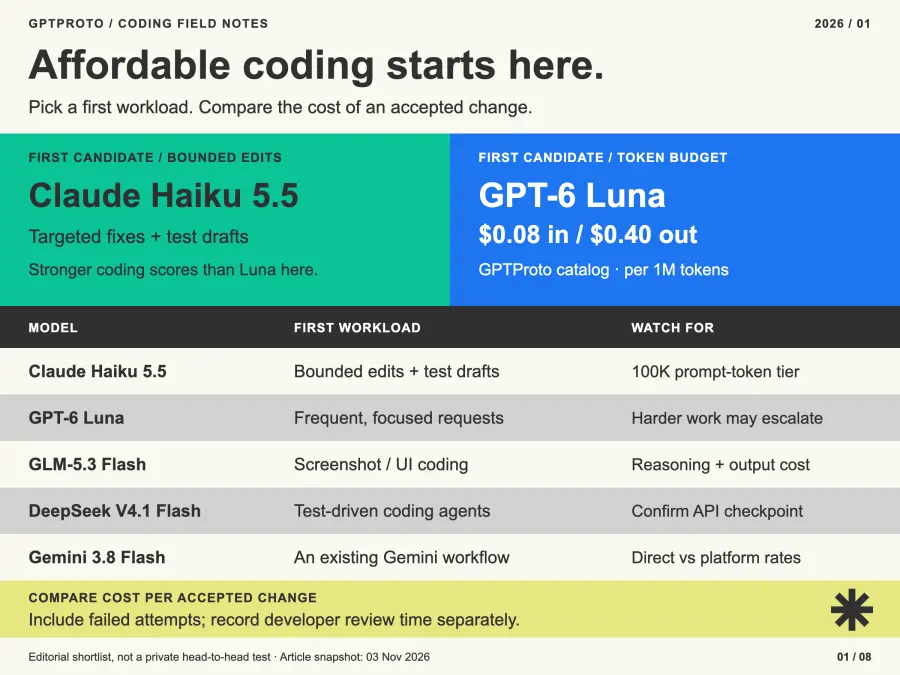
| Modell |
Erster zu evaluierender Workload |
Haupt-Abwägung |
| Claude Haiku 5.5 |
Begrenzte Code-Bearbeitungen, Testentwürfe und Coding-Teilaufgaben |
Die günstige Preisstufe endet bei über 100.000 Prompt-Token |
| GPT-6 Luna |
Häufige, eng gefasste Coding-Anfragen |
Komplexere Repository-Arbeiten erfordern möglicherweise eine Eskalation |
| GLM-5.3 Flash |
Coding-Aufgaben mit Screenshots oder UI-Referenzen |
Reasoning-Aufwand und Ausgabelänge beeinflussen die Kosten |
| DeepSeek V4.1 Flash |
Coding-Agenten mit Tests und Wiederholungs-Limits |
Überprüfen Sie den vom API-Alias bereitgestellten Checkpoint |
| Gemini 3.8 Flash |
Coding innerhalb eines bestehenden Gemini-Workflows |
Direkte Anbieter-Aktionspreise unterscheiden sich von Plattform-Angeboten |
Wenn Sie sowohl den Anbieter als auch das Modell auswählen, deckt unser Vergleich von KI-API-Plattformen für Entwickler die umfassenderen Fragen zu Zugriff, Abrechnung, Integration und Produktionskontrollen ab.
Wie wir Kosten und Coding-Fähigkeiten vergleichen
Ein bezahlbares LLM-Coding-Modell muss über genügend Fähigkeiten für die Aufgabe verfügen, bevor sein Token-Preis relevant wird. Wir priorisieren Coding-spezifische Nachweise und prüfen dann Workload-Kosten, Kontext-Stufen, Tool-Kompatibilität und eine verfügbare GPT Proto-Modellseite.
Die folgenden Ergebnisse stammen von Artificial Analysis. Terminal-Bench 4.0 evaluiert agentisches Coding und Terminal-Nutzung; FrontierCode 2.0 evaluiert Software-Engineering in Open-Source-Repositories. Unterschiedliche Konfigurationen können die Ergebnisse verändern, daher wird die evaluierte Einstellung neben jedem Modell aufgeführt.
| Evaluiertes Modell |
Terminal-Bench 4.0 |
FrontierCode 2.0 |
| Claude Haiku 5.5 Max |
33% |
35% |
| GPT-6 Luna Max |
13% |
25% |
| GLM-5.3 Flash wie gelistet |
33% |
18% |
| DeepSeek V4.1 Flash 1017 Max |
34% |
28% |
| Gemini 3.8 Flash High |
20% |
19% |
Die zugrunde liegenden Vergleiche sind Haiku versus Luna, DeepSeek versus GLM Flash und Haiku versus Gemini. Diese Prozentsätze beschreiben diese Evaluierungen, nicht die erwartete Erfolgsrate Ihres Repositorys. Sie begründen auch keine GPT Proto-Latenz oder -Verfügbarkeit.
Die untenstehenden Preisschätzungen halten die Token-Nutzung konstant, um die Abrechnungsarithmetik aufzuzeigen. Tatsächliche Modelle können für denselben Prompt unterschiedliche Token-Anzahlen verwenden, insbesondere wenn Reasoning aktiviert ist.
Die 5 besten bezahlbaren LLMs für Coding
1. Claude Haiku 5.5 für begrenzte Programmieraufgaben
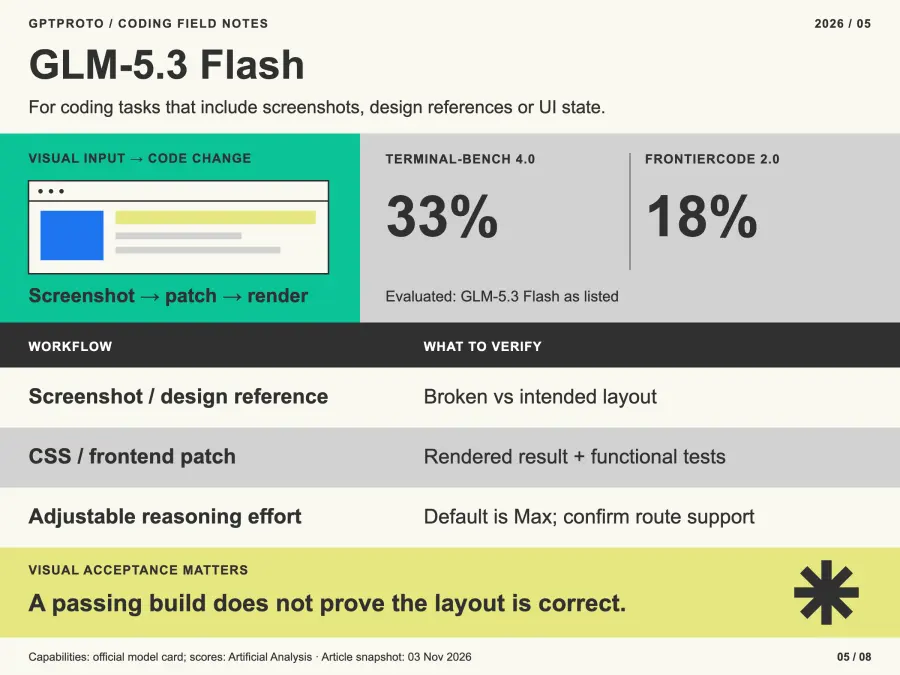
Claude Haiku 5.5 ist unser erster Kandidat für gezielte Bearbeitungen mit einem klaren Abnahmetest und einem Prompt unter 100.000 Token. Aufgrund der Coding-Ergebnisse lohnt es sich, dieses Modell zu evaluieren, bevor man für ein größeres Claude-Modell bezahlt.
Die Veröffentlichungsankündigung von Anthropic positioniert Haiku neben Sonnet und Opus als Modell für repetitive Arbeiten und Coding-Teilaufgaben. Das deutet auf einen praktischen Startbereich hin: eine Funktion korrigieren, einen Test entwerfen oder einen isolierten Fehler untersuchen.
Die wichtige Kostengrenze ist die Prompt-Länge. Die Upstream-Input-/Output-Raten steigen von 0,10 $/0,50 $ auf 0,50 $/2,50 $ pro Million Token bei mehr als 100.000 Prompt-Token. Ein großes Kontextfenster bedeutet nicht, dass der günstigste Tarif über das gesamte Fenster hinweg verfügbar ist.
2. GPT-6 Luna für häufige, fokussierte Anfragen
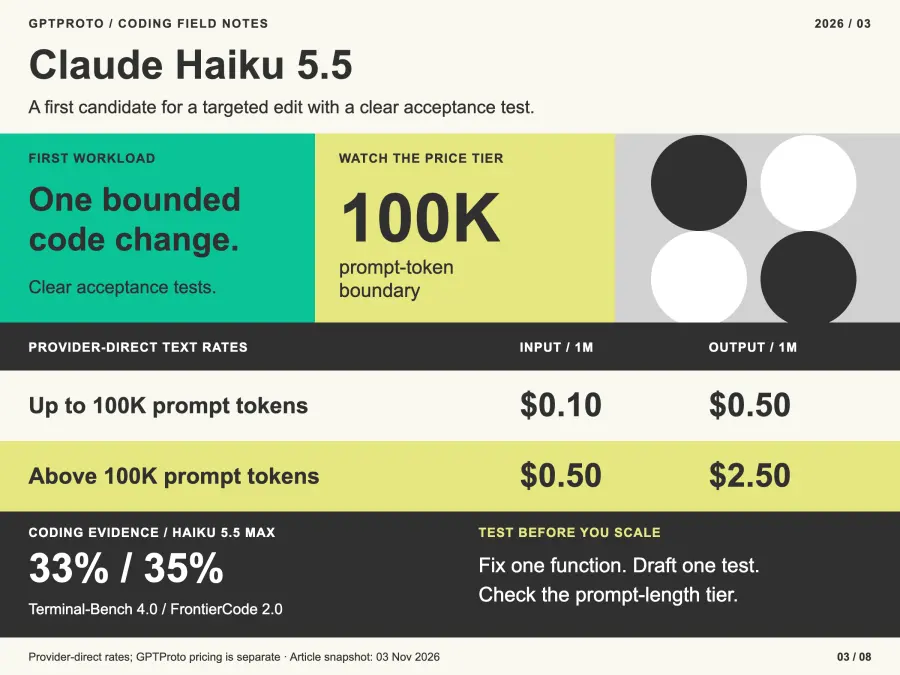
GPT-6 Luna ist der budgetorientierte Kandidat für wiederholte, begrenzte Anfragen: eine Funktion erklären, Boilerplate-Code entwerfen oder eine kleine Korrektur vorschlagen, die durch bestehende Tests bewertet werden kann.
Die veröffentlichte GPT Proto-Katalograte liegt bei 0,08 $ für Input und 0,40 $ für Output pro Million Token. Die öffentlichen Coding-Scores sind niedriger als die von Haiku, daher würden wir Luna durch aufgabenbezogene Evaluierung eine breitere Rolle zuweisen.
Überprüfen Sie die Integrationsschnittstelle beim Aufbau eines Agenten. Die OpenAI-Modelldokumentation spezifiziert die Nutzung von Tools mit Reasoning-Unterstützung durch Responses; Chat Completions erlaubt Funktionsaufrufe, wobei der Reasoning-Aufwand auf „none“ gesetzt ist. Bestätigen Sie, was die GPT Proto-Route bereitstellt, bevor Sie einen Modellwechsel als reine Konfigurationsänderung betrachten.
3. GLM-5.3 Flash für visuelles Coding mit kleinem Budget
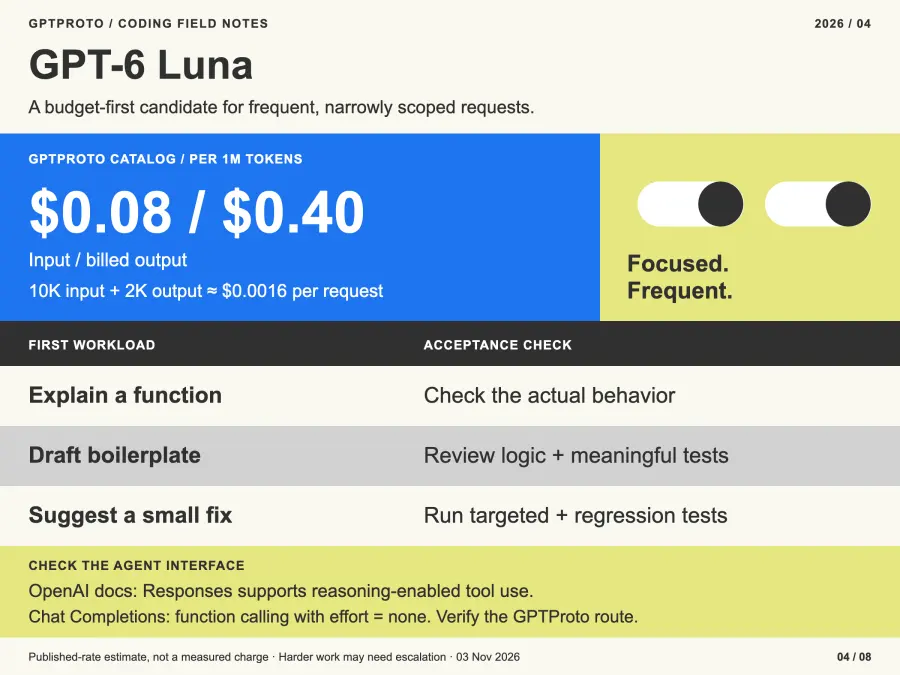
GLM-5.3 Flash gehört auf die engere Wahl, wenn eine Programmieraufgabe einen Screenshot, eine Designreferenz oder eine gerenderte Schnittstelle beinhaltet. Ein Frontend-Assistent muss beispielsweise ein fehlerhaftes Layout mit dem beabsichtigten Zustand vergleichen, bevor er CSS-Änderungen vorschlägt.
Die offizielle GLM-5.3 Flash-Modellkarte dokumentiert multimodalen Input, offene Gewichte und anpassbaren Reasoning-Aufwand. Der veröffentlichte Standardaufwand ist „max“. Verwenden Sie eine andere Einstellung erst, nachdem Sie geprüft haben, wie die gehostete Route dies unterstützt.
Die beiden Coding-Scores unterscheiden sich erheblich. Das ist ein Grund, Ihren Aufgabenmix zu testen, anstatt einen einzelnen Terminal-Benchmark als universelles Ranking für Code-Bearbeitung zu betrachten. Visuelle Korrekturen erfordern zudem einen gerenderten Vergleich; die Kompilierung allein kann nicht bestätigen, dass das Layout korrekt ist.
4. DeepSeek V4.1 Flash für testgetriebene Coding-Agenten
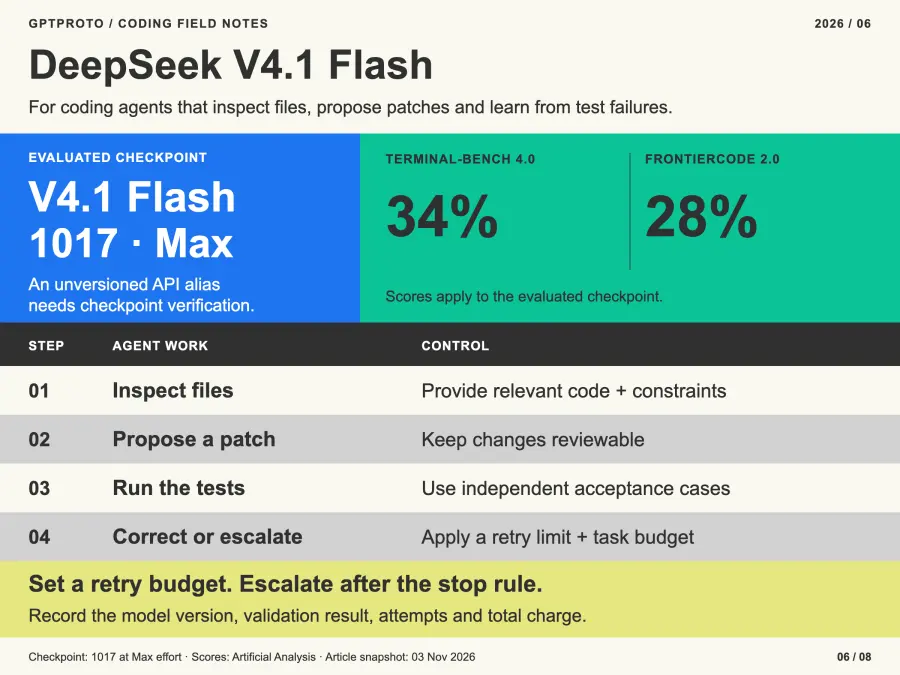
DeepSeek Flash ist eine Überlegung wert für Agenten, die Dateien untersuchen, Änderungen vorschlagen, Testfehler empfangen und innerhalb eines definierten Budgets erneut versuchen.
Die Veröffentlichungsankündigung vom 17. Oktober beschreibt Verbesserungen bei der Coding-Leistung, der Geschwindigkeit der Aufgabenabwicklung und der Ausgabelänge. Die unabhängigen Ergebnisse in unserer Tabelle beziehen sich spezifisch auf V4.1 Flash 1017 bei maximalem Aufwand. Ein versionsloser Alias beweist für sich genommen nicht, dass Ihre Plattform diesen Checkpoint bereitstellt; protokollieren Sie die aufgelöste Version, sofern verfügbar.
Für einen breiteren Überblick über DeepSeek, GLM, Qwen und Kimi, siehe unseren Vergleich chinesischer LLMs für das Programmieren. Halten Sie die stärkeren Kandidaten bereit, wenn eine schwierige Repository-Änderung das Budget-Limit ausschöpft.
5. Gemini 3.8 Flash für bestehende Gemini-Workflows
Gemini 3.8 Flash ist ein Kandidat, wenn Ihre Anwendung bereits Gemini verwendet oder Code mit visuellem Material kombiniert. Evaluieren Sie es in diesem bestehenden Workflow, bevor Sie eine weitere anbieterspezifische Integration hinzufügen.
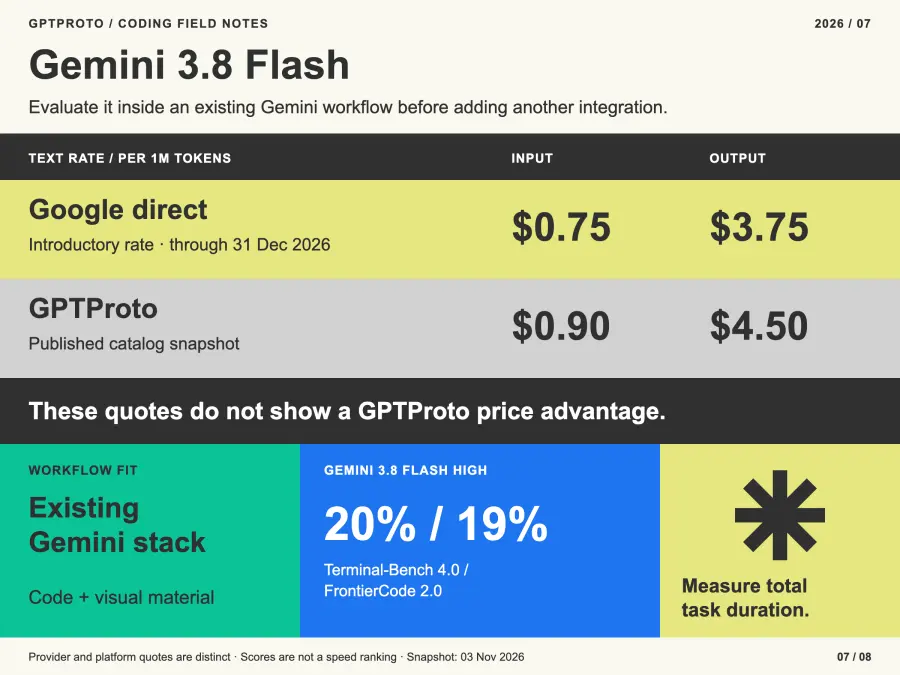
Das Modell-Update von Google dokumentiert anpassbares Denken und einen einführenden Direkt-Anbieter-Tarif von 0,75 $ Input / 3,75 $ Output pro Million Token bis zum 31. Dezember 2026. Der veröffentlichte GPT Proto-Katalog-Snapshot liegt bei 0,90 $ / 4,50 $. Diese Zahlen stützen nicht die Behauptung, dass GPT Proto günstiger ist als die aktuelle Aktion von Google.
Wir würden Gemini aufgrund der Workflow-Passung einbeziehen, nicht um ihm einen Geschwindigkeitstitel aufgrund des Wortes Flash zu verleihen. Messen Sie die Zeit bis zu einer brauchbaren Antwort und die Gesamtaufgabendauer bei Ihren Prompts.
Preisvergleich der Coding-LLM-APIs
Diese Tabelle verwendet öffentliche Texttarife der Anbieter unter den angegebenen Bedingungen, nicht die Abrechnungstarife von GPT Proto. Die explizite Angabe von Quelle und Arbeitslast macht den Vergleich reproduzierbar.
Die kleine Anfrage enthält 10.000 Eingabe- und 2.000 abgerechnete Ausgabetoken. Die Repository-Baseline enthält 200.000 Eingabe- und 20.000 abgerechnete Ausgabetoken. Bei beiden wird davon ausgegangen, dass keine Cache-Treffer vorliegen; die abgerechnete Ausgabe muss gegebenenfalls Reasoning-Token enthalten.
| Modell- und Preisbedingung |
Eingabe / Ausgabe pro 1 Mio. Token |
Kleine Anfrage |
Repository-Baseline |
| Haiku 5.5 bei bis zu 100.000 Prompt-Token |
$0,10 / $0,50 |
$0,0020 |
Nächste Stufe verwenden |
| Haiku 5.5 über 100.000 Prompt-Token |
$0,50 / $2,50 |
Nicht anwendbar |
$0,1500 |
| GPT-6 Luna innerhalb der Basis-Kontextstufe |
$0,10 / $0,50 |
$0,0020 |
$0,0300 |
| GLM-5.3 Flash zum veröffentlichten Standardtarif |
$0,15 / $0,50 |
$0,0025 |
$0,0400 |
| DeepSeek Flash zum Upstream-Spitzentarif |
$0,30 / $1,20 |
$0,0054 |
$0,0840 |
| Gemini 3.8 Flash zum direkten Einführungstarif |
$0,75 / $3,75 |
$0,0150 |
$0,2250 |
Die Nachweise für die Tarife stammen aus der verlinkten Modelldokumentation und den oben genannten unabhängigen Vergleichen. DeepSeeks Release-Notes bestätigen, dass die Token-Tarife außerhalb der Spitzenzeiten die Hälfte der Spitzentarife betragen. Luna wendet bei über 272.000 Eingabe-Token höhere Tarife auf die gesamte Anfrage an. Die Einführungstarife von Gemini enden im Jahr 2026. Überprüfen Sie den anwendbaren Pfad und das Datum, bevor Sie ein Budget erstellen.
Für den Zugriff auf GPT Proto verwenden Sie das Live-Preismodul auf den verlinkten Modellseiten. Zwei klare Katalogbeispiele sind Luna mit $0,08/$0,40 und Haiku mit $0,09/$0,45 in der günstigen Preisstufe. Die gleiche kleine Anfrage wird auf $0,0016 bzw. $0,0018 geschätzt. Dies sind Berechnungen auf Basis veröffentlichter Tarife, keine tatsächlichen Abrechnungsbeträge.
Für eine kleine Anwendung, die 10.000 kleine Anfragen pro Monat stellt, belaufen sich die Kosten für das Upstream-Modell Luna oder das Haiku-Modell der günstigen Stufe auf insgesamt $20 vor Wiederholungsversuchen und anderen Gebühren. Diese Schätzung ist nicht mehr nützlich, wenn die Anwendung eine andere Menge an Kontext sendet oder wesentlich längere Ausgaben generiert.
Caching erfordert eine eigene Berechnung: Addieren Sie nicht zwischengespeicherte Eingaben, Cache-Lesevorgänge, etwaige Cache-Schreibvorgänge oder Speicherplatz sowie die abgerechnete Ausgabe. Ein stabiles Repository-Präfix kann helfen, aber das Ändern des Prompts oder ein Cache-Fehlschlag verringert die Einsparungen.
Der Entwickler Simon Willisons Haiku 5.5-Test liefert ein konkretes Beispiel dafür, wie unterschiedliche Aufwandseinstellungen Zeit und Kosten verändern. Er erörtert auch Änderungen am Tokenizer. Die Lektion für die Budgetierung lautet, den tatsächlichen Verbrauch zu messen, anstatt davon auszugehen, dass jedes Modell die gleiche Anzahl an Token für identischen Text berechnet.
Welches Modell passt zu Ihrer Programmieraufgabe
| Aufgabe |
Startkandidaten |
Abnahmeprüfung |
| Eine isolierte Code-Änderung oder Fehlerbehebung |
Haiku 5.5 und Luna |
Gezielte Tests sowie bestehende Regressionstests |
| Entwurf von Unit-Tests oder Boilerplate-Code |
Luna und Haiku 5.5 |
Assertions überprüfen und aussagekräftige Fehlerfälle verifizieren |
| Ein visueller Frontend-Fix |
GLM-5.3 Flash und Gemini 3.8 Flash |
Gerenderter Vergleich sowie Funktionstests |
| Ein mehrstufiger Coding-Agent |
DeepSeek Flash und Haiku 5.5 |
Abgeschlossene Aufgabe, gültige Tool-Aufrufe, Anzahl der Wiederholungsversuche und Gesamtkosten |
Dies sind Ausgangspunkte für die Evaluierung. Ein generierter Test, der lediglich die fehlerhafte Annahme des Modells wiederholt, kann bestehen, während das Feature weiterhin fehlerhaft bleibt. Bewahren Sie unabhängige Abnahmefälle auf und überprüfen Sie die Tests selbst.
Für Agenten, die auch Dokumente durchsuchen, Anfragen klassifizieren oder Support-Aufgaben übernehmen, deckt unser Leitfaden zu kostengünstigen LLM-APIs für KI-Agenten das breitere Spektrum an Arbeitslasten ab.
Wann sich ein Premium-Coding-Modell lohnt
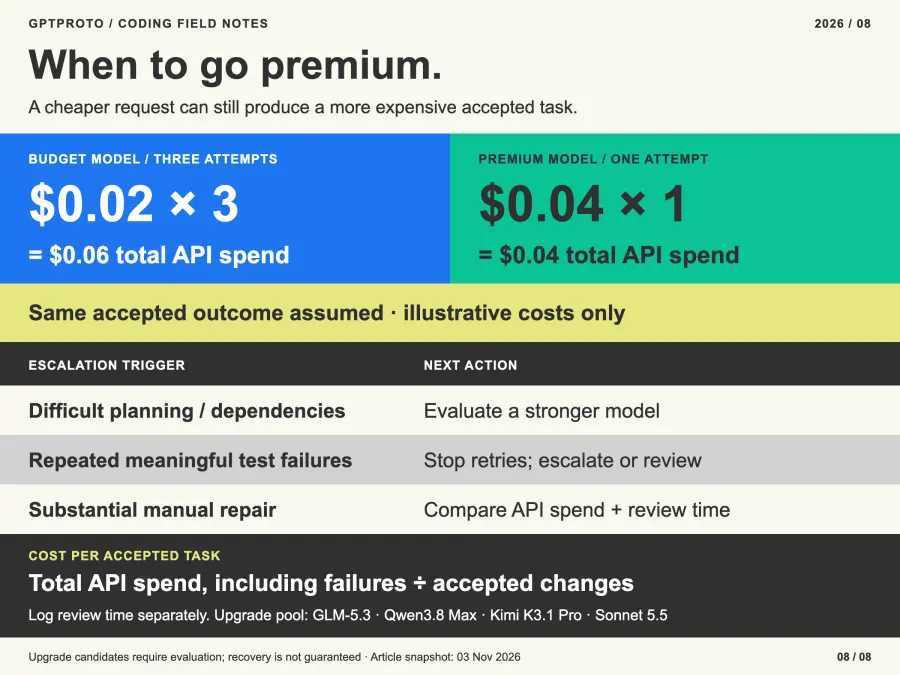
Eskalieren Sie, wenn die Aufgabe schwierige Planung erfordert, wiederholt an aussagekräftigen Tests scheitert oder umfangreiche manuelle Nachbesserungen benötigt. GLM-5.3, Qwen3.8 Max, Kimi K3.1 Pro und Claude Sonnet 5.5 können einen separaten Evaluierungspool für diese Arbeit bilden. Ihre Aufnahme hier ist ein Upgrade-Pfad zur Untersuchung, kein Versprechen, dass sie gescheiterte Aufgaben von Budget-Modellen immer retten können.
Verwenden Sie die Kosten pro akzeptierter Aufgabe: Gesamte API-Ausgaben für die Evaluierung geteilt durch die Anzahl der akzeptierten Änderungen. Beziehen Sie die Ausgaben für fehlgeschlagene Versuche mit ein. Erfassen Sie die Überprüfungszeit separat, damit eine niedrige API-Rechnung keine teure Bereinigung durch Entwickler verschleiert.
Zum anschaulichen Vergleich: Drei Versuche zu je 0,02 $ kosten 0,06 $. Ein Versuch zu 0,04 $, der dieselbe Aufgabe sofort abschließt, kostet insgesamt weniger. Ihre gemessenen Erfolgsraten entscheiden darüber, ob sich dieser Kompromiss lohnt.
So nutzen Sie Budget-Modelle ohne endlose Wiederholungsversuche
Legen Sie die Abnahmeprüfung und die Abbruchregel vor der ersten Anfrage fest. Eine praktische Ausgangsstrategie ist ein erster Versuch, eine Korrektur basierend auf dem Testfehler und anschließend eine Eskalation oder manuelle Überprüfung. Passen Sie diese Strategie basierend auf den beobachteten Ergebnissen und dem Aufgabenbudget an.
Die Anwendung sollte das Modell und den Checkpoint, die Reasoning-Einstellung, den Token-Verbrauch, die verstrichene Zeit, das Validierungsergebnis und die Gesamtkosten aufzeichnen. Das Modell schlägt einen Patch vor; Ihr Runner führt Tests aus; Ihre Routing-Logik entscheidet, was als Nächstes geschieht.
Eine Multi-Modell-API vereinfacht den Zugriff und die Abrechnung. Bestehende Tests, budgetbewusstes Routing und automatische Eskalation erfordern dennoch verifizierte Plattformfunktionen oder Anwendungslogik. Unser Leitfaden zu KI-Gateways für Entwickler vergleicht die verschiedenen Zugriffs- und Steuerungsebenen.
Probieren Sie ein kostengünstiges Programmiermodell über GPT Proto aus
Öffnen Sie die Seite eines Modells aus der engeren Auswahl, wählen Sie Dieses Modell ausprobieren und überprüfen Sie den aktuellen Quick Start sowie die Preisgestaltung. Halten Sie einen API-Schlüssel und ein Guthaben bereit. Wenn das Panel Markdown für KI kopieren anbietet, geben Sie diese Anleitung zusammen mit der Aufgabe und den Abnahmekriterien an Ihren Programmierassistenten weiter. Bewahren Sie den echten Schlüssel in Ihrer lokalen Umgebung oder Ihrem Server-Secret-Store auf.
Für eine reproduzierbare erste Übung korrigieren Sie diese Paginierungsfunktion: Seiten beginnen bei eins, page und per_page sind Ganzzahlen, Werte unter eins müssen einen ValueError auslösen und die Eingabeliste darf unverändert bleiben.
Speichern Sie das Folgende als request_patch.py in einem neuen Arbeitsordner. Es verwendet die Standardbibliothek von Python, fordert eine Kandidatenfunktion an, prüft deren Syntax und speichert sie zur Überprüfung. Der zurückgegebene Code wird nicht ausgeführt.
import ast
import json
import os
import time
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.request import Request, urlopen

key = os.environ.get("GPTPROTO_API_KEY")
if not key:
    raise SystemExit("Setzen Sie GPTPROTO_API_KEY in Ihrer Umgebung.")

source = """def paginate(items, page, per_page):
    start = page * per_page
    return items[start:start + per_page]
"""
task = (
    "Korrigiere paginate. Seiten beginnen bei eins. page und per_page sind "
    "Ganzzahlen; löse einen ValueError aus, wenn einer der Werte unter 1 liegt. Gib eine "
    "leere Liste zurück, wenn die Seite außerhalb des Bereichs liegt. Verändere items nicht. Behalte "
    "die Signatur bei. Gib nur die Funktion zurück, ohne Markdown "
    "oder Erklärungen.\n\n" + source
)
payload = {
    "model": os.environ.get("GPTPROTO_MODEL", "gpt-6-luna"),
    "messages": [{"role": "user", "content": task}],
}
request = Request(
    "https://gptproto.com/v1/chat/completions",
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Authorization": f"Bearer {key}",
        "Content-Type": "application/json",
    },
    method="POST",
)
started = time.perf_counter()
try:
    with urlopen(request, timeout=60) as response:
        result = json.load(response)
except HTTPError as exc:
    raise SystemExit(f"API gab HTTP {exc.code} zurück.") from exc
except (URLError, TimeoutError) as exc:
    raise SystemExit("Anfrage fehlgeschlagen oder Zeitüberschreitung.") from exc

try:
    code = result["choices"][0]["message"]["content"]
except (KeyError, IndexError, TypeError) as exc:
    raise SystemExit("Kein Kandidatentext in der API-Antwort.") from exc
if not isinstance(code, str) or not code.strip():
    raise SystemExit("Die Antwort enthielt keinen Python-Code.")
code = code.strip()
try:
    ast.parse(code)
except SyntaxError as exc:
    raise SystemExit("Überprüfen Sie die Antwort; es ist kein reines Python.") from exc

Path("candidate.py").write_text(code + "\n", encoding="utf-8")
print("candidate.py gespeichert. Überprüfen Sie diese vor dem Ausführen der Tests.")
print("Sekunden:", round(time.perf_counter() - started, 2))
print("Nutzung:", json.dumps(result.get("usage", {})))
Speichern Sie diese Abnahmeprüfungen als test_candidate.py:
import unittest
from candidate import paginate


class PaginationTests(unittest.TestCase):
    def test_pages(self):
        items = [0, 1, 2, 3, 4]
        self.assertEqual(paginate(items, 1, 2), [0, 1])
        self.assertEqual(paginate(items, 2, 2), [2, 3])
        self.assertEqual(paginate(items, 3, 2), [4])
        self.assertEqual(paginate(items, 4, 2), [])
        self.assertEqual(items, [0, 1, 2, 3, 4])

    def test_empty_input(self):
        self.assertEqual(paginate([], 1, 2), [])

    def test_invalid_values(self):
        for page, per_page in [(0, 2), (-1, 2), (1, 0), (1, -1)]:
            with self.subTest(page=page, per_page=per_page):
                with self.assertRaises(ValueError):
                    paginate([0, 1], page, per_page)


if __name__ == "__main__":
    unittest.main()
Sobald der Umgebungsschlüssel konfiguriert ist, führen Sie python request_patch.py aus. Überprüfen Sie candidate.py und führen Sie dann python -m unittest -v test_candidate.py aus. Eine Syntaxprüfung stellt lediglich sicher, dass Python die Ausgabe parsen kann; die Tests bewerten das angegebene Verhalten. Diese kleine Übung ist kein Benchmark auf Repository-Ebene.
Wiederholen Sie dies mit einer anderen dokumentierten Modell-ID über GPTPROTO_MODEL. Protokollieren Sie sowohl Fehler als auch Erfolge und verwenden Sie die zurückgegebene Nutzung zusammen mit dem geltenden Abrechnungssatz, um die Kosten zu vergleichen. Ein Timeout oder ein fehlgeschlagener Versuch gehört ebenfalls in das Bewertungsprotokoll.
Wählen Sie eine eng gefasste Aufgabe, behalten Sie deren Akzeptanzprüfungen bei und vergleichen Sie zwei Kandidaten. Öffnen Sie die Claude Haiku 5.5 API-Seite oder die GPT-6 Luna API-Seite, um die aktuellen Preise zu überprüfen und Ihre erste Programmier-Anfrage zu starten.