僵硬的 AI 臉孔與令人信服的表演之間的差異,很少在於情緒詞本身,而在於轉換過程。
「她看起來很悲傷」要求的是一個面部姿勢。「她努力不讓自己哭出來,抿緊雙唇,吞嚥一次,直到下眼瞼邊緣聚起淚光後才終於失控」則是給模型一段需要隨時間演繹的表演。
同樣的規則也適用於尷尬、憤怒、恐懼、如釋重負和忍住笑。不要只描述最後的表情,而要明確指出是什麼觸發了情緒、角色如何試圖掩飾、哪些不由自主的反應洩漏出來,以及情緒高峰過後還留下什麼。
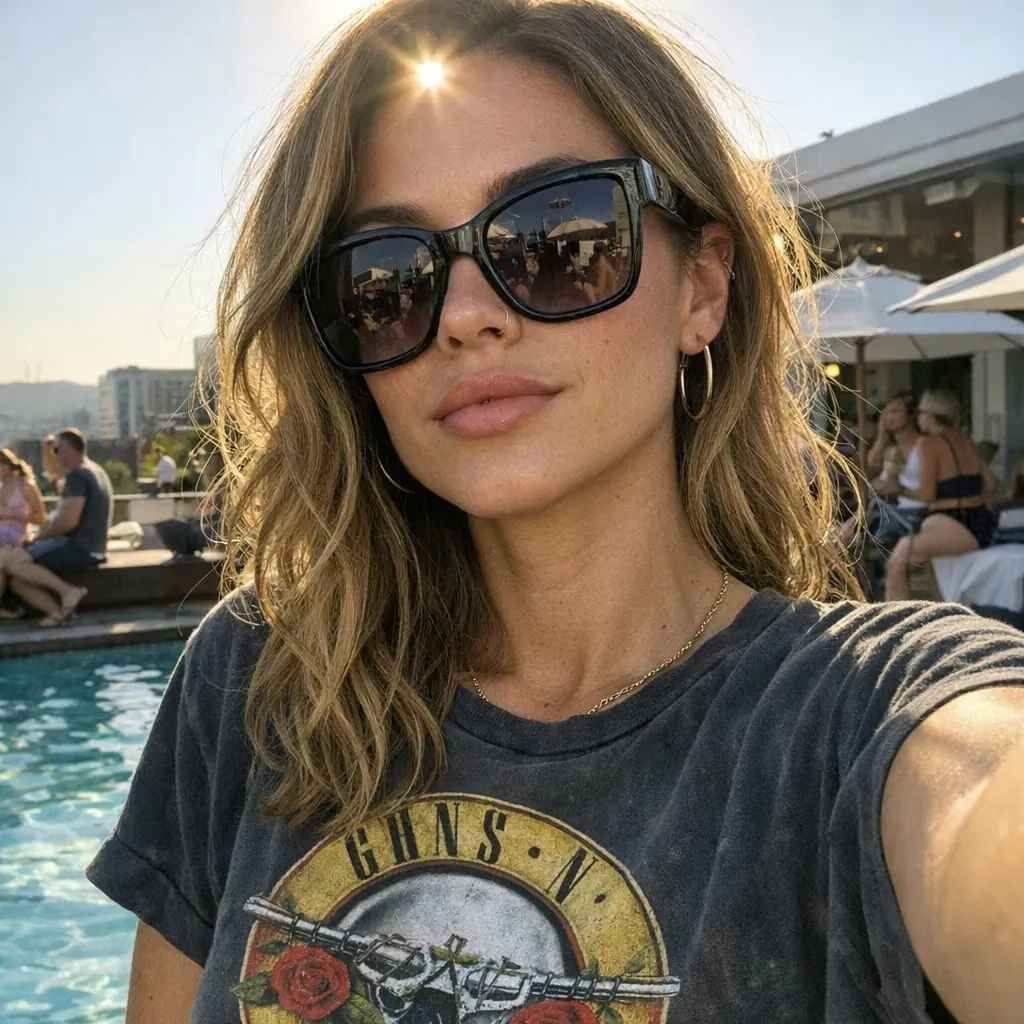
這兩個 Seedance 2.5 範例使用不同的輸入,但都遵循相同的情緒弧線:
觸發 → 抗拒 → 洩漏 → 釋放 → 餘韻
這個五拍結構,是本 Seedance 2.5 情感面部表情提示詞指南中最具可重複使用價值的部分。
為什麼「她看起來很悲傷」通常只會產生扁平的 AI 表情
情緒詞描述的是一種狀態,而影片需要的是變化。
如果提示詞以「非常悲傷」開始並以「非常悲傷」結束,Seedance 2.5 就沒有明確理由在每一秒之間改變眉毛、眼瞼、嘴巴、呼吸或姿勢。結果可能在視覺上很吸引人,但臉部往往會鎖定在同一個表情。
三種提示詞錯誤造成了大多數扁平的情緒影片:
提示詞說出了情緒,卻沒有描述可見的身體反應。
角色在第一秒就達到最高強度,沒有留下情緒發展的空間。
走路、對話、手部動作、鏡頭移動和背景事件都在與面部爭奪注意力。
將抽象指示改為可觀察的行為:
| 薄弱指示 |
更好的可見指示 |
| 她看起來非常悲傷。 |
她的內側眉毛抬起,下眼瞼收緊,雙唇保持緊閉。 |
| 他變得害羞。 |
他垂下視線,肩膀向內收,手指緊緊握住筆記本。 |
| 她開始哭泣。 |
先是眼中泛起淚光;只有在她無法繼續保持鎮定後,才有一滴眼淚落下。 |
| 他很緊張。 |
他吞嚥一次,淺淺吸氣,並短暫避開視線。 |
| 她很生氣。 |
她的下顎先收緊,接著目光變得銳利;在克制的呼吸中,一側鼻孔微微張開。 |
重點很簡單:描述鏡頭能看見的事,而不是只有角色自己能感受到的事。
Seedance 2.5 的情緒表演公式
可靠的真實表情影片提示詞包含七個部分:
情緒觸發點

+ 試圖抑制反應

+ 不由自主的面部洩漏

+ 呼吸與身體反應

+ 按時間逐步升級

+ 克制的恢復

+ 鏡頭與連貫性限制
抗拒是大多數提示詞忽略的部分。一個立刻哭泣、臉紅或喊叫的角色,只是在展示情緒;一個試圖阻止反應卻失敗的角色,才是在表演情緒。
例如,不要只寫「當他暗戀某人的事被發現時,他的臉變紅」。要賦予他相互衝突的意圖:他想表現得鎮定。這種抗拒會產生避開眼神、延遲臉紅、試圖說話卻失敗、手指收緊以及克制的微笑。這些細微反應,會讓更強烈的情緒顯得可信。
不要在每個階段堆疊所有可能的線索。每個情緒節拍選擇兩到三個面部動作、一個呼吸反應和一個細微的身體動作即可。更多指示可能帶來更多衝突,而不是更多真實感。
將情緒轉化為可見的面部動作
將此表格用作指示資料庫。選擇符合鏡頭的線索,不要整列照搬。
| 情緒 |
眼睛與眉毛 |
嘴巴與下顎 |
呼吸與身體 |
| 強忍淚水 |
下眼瞼泛著淚光;內側眉毛逐漸抬起並靠攏 |
雙唇緊抿;下唇顫抖;下巴收緊 |
吞嚥一次;呼吸不均;肩膀輕微顫抖 |
| 尷尬 |
視線下垂;從睫毛下方短暫向上瞥 |
雙唇張開卻不說話;輕輕咬住下唇;克制的微笑 |
肩膀向內收;手指收緊;呼吸一窒 |
| 壓抑的憤怒 |
目光固定;眉毛不均勻地下壓 |
下顎緊咬;雙唇攤平 |
克制的鼻腔呼吸;肩膀僵硬;雙手保持不動 |
| 恐懼 |
眼睛先睜大再開始掃視;上眼瞼保持緊繃 |
雙唇張開;下顎短暫僵住 |
呼吸一窒;胸口保持緊繃;身體微微後傾 |
| 忍住笑 |
眼瞼微瞇;視線短暫移開 |
嘴角的一側先上揚;雙唇再次抿緊 |
呼吸從鼻腔逸出;肩膀抽動一次 |
| 如釋重負 |
眉間的緊張解除;眼神變柔並重新聚焦 |
雙唇在輕輕吐氣前張開;下顎放鬆 |
肩膀下沉;呼吸變得悠長;姿勢舒展開來 |
「克制的」、「猶豫的」、「不由自主的」、「逐漸的」和「幾乎難以察覺的」等詞語有助於控制強度,但不能取代實際的身體動作。「細微的情緒表情」仍然很模糊;「他保持視線下垂,幾乎難以察覺地下巴顫抖」才是可以直接指導的描述。
範例 1:強忍淚水——圖像生成影片提示詞
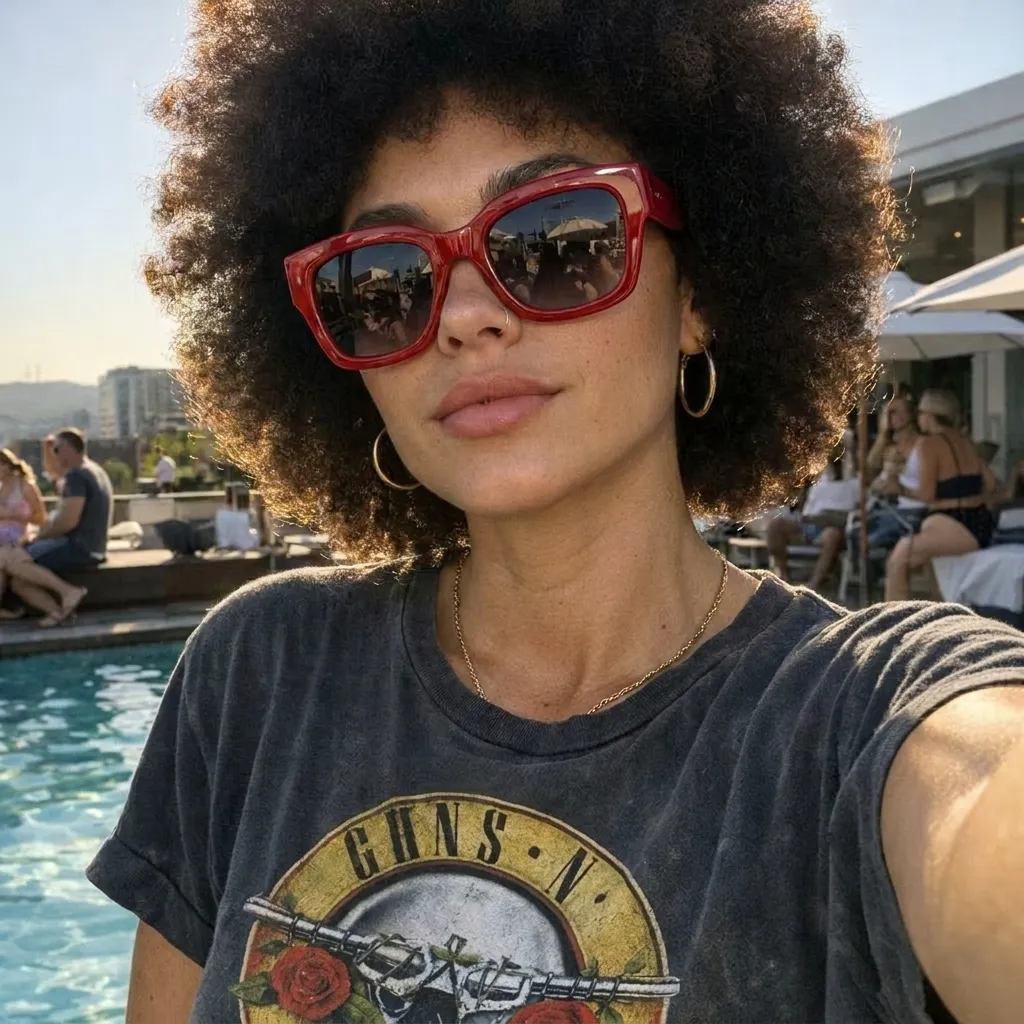
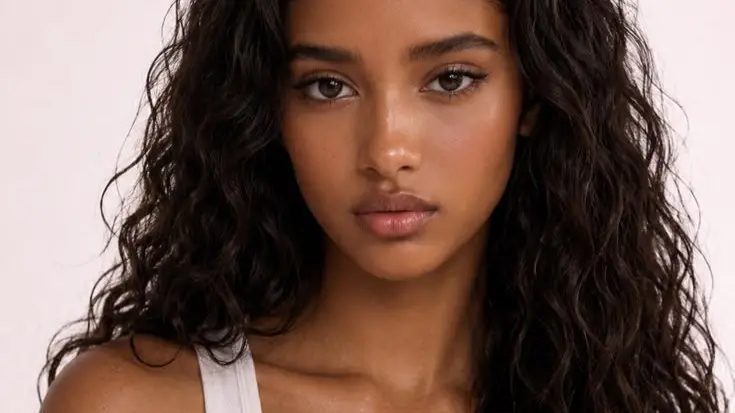
此範例從一張已知角色圖像開始,並將其製作成 15 秒的情緒發展影片。參考圖像應定義臉部、年齡、髮型、服裝、配件和初始構圖。提示詞的大部分篇幅應用於描述表演與連貫性,而不是重新設計人物。
[圖片]
[影片]
情緒時間軸
| 時間 |
情緒節拍 |
可見線索 |
| 0–3 秒 |
努力保持鎮定 |
抿緊的雙唇、緊繃的下巴、含淚的眼睛、吞嚥一次 |
| 3–5 秒 |
控制開始失效 |
內側眉毛抬起,下唇顫抖,眼中聚起淚光 |
| 5–10 秒 |
克制的情緒崩潰 |
眼睛閉上,淚水不均勻地落下,呼吸變得顫抖 |
| 10–12 秒 |
身體恢復 |
低下頭,顫抖著呼吸,用袖子擦拭眼淚 |
| 12–15 秒 |
情緒餘韻 |
濕潤的眼睛重新睜開,視線移開,悲傷仍然存在 |
可複製貼上的圖像生成影片提示詞
@Image 1 定義角色的確切身分、臉部結構、髮型、服裝、配件、年齡和整體外觀。整部影片都要保持同一個人。不要重新設計、美化、改變年齡或替換角色。

以 @Image 1 為基礎,建立一段連續的 15 秒電影感特寫。角色正面對著鏡頭外一位情感上重要的人,拼命努力不讓自己哭出來。

[0–3 秒——努力保持鎮定]
角色一開始保持克制的表情。雙唇緊緊抿住,下顎略微緊繃,下巴肌肉收緊。他吞嚥一次,並不穩定地吸入一小口氣。眼睛逐漸泛起淚光,但暫時不落淚。

[3–5 秒——鎮定開始瓦解]
內側眉毛抬起並微微靠攏。下眼瞼收緊,鼻子輕微泛紅,下唇開始不由自主地顫抖。嘴角的一側先微微下垂,接著另一側也跟上。下眼瞼邊緣慢慢聚起淚水。

[5–10 秒——克制的情緒崩潰]
角色再次試圖壓抑情緒,但失敗了。他的眼睛緊緊閉上,眉間自然收縮,淚水開始以略微不同的速度沿臉頰滑落。嘴巴顫抖成安靜而克制的啜泣。隨著呼吸變得不均勻,下巴、喉嚨和肩膀出現細微的不自主顫抖。

[10–12 秒——恢復呼吸]
角色低下頭,雙唇微張,顫抖地吸一口氣,並用袖子或柔軟的衣料輕輕擦去眼淚。這個動作應該自發、猶豫且不完美。

[12–15 秒——脆弱的恢復]
他慢慢抬起頭,試圖重新控制情緒。他抿緊雙唇,吞嚥一次,濕潤而泛紅的眼睛望向鏡頭之外。哭泣開始平息,但悲傷仍然能從他的呼吸、目光和面部緊張中看出。

保持 @Image 1 的原始構圖與視覺風格。使用緊湊的平視特寫、真實的皮膚運動、自然眨眼、符合物理效果的淚水、細微呼吸和克制的微表情。背景保持穩定,只加入輕微自然的環境動態。

不要剪接,不要身分漂移,不要重新設計臉部,不要改變髮型或服裝,不要突然誇張哭泣,不要戲劇化表演,不要對稱的人工淚水,不要快速搖頭,不要扭曲臉部特徵,不要美顏濾鏡皮膚,也不要讓其他人物進入畫面。
起始圖像很重要。完全歡快的肖像會迫使模型在第一個情緒節拍前走得太遠;一張已經滿臉淚水的臉則會移除情緒堆疊。最好的起始畫面位於兩者之間:下眼瞼泛著淚光、雙唇抿緊、下巴略有張力,但尚未有眼淚落下。
如果來源圖像是半身或全身肖像,請保留該構圖,並要求鏡頭緩慢推近至特寫。不要將推近與走路、轉身和大幅度手勢結合。臉部就是這個場景的核心。
範例 2:秘密暗戀被發現的害羞男孩
這個文字生成影片範例使用了不同的情緒,但結構相同:
發現 → 僵住 → 避開眼神 → 臉紅擴散
→ 不小心對視 → 輕咬嘴唇 → 害羞餘韻
重要細節在於延遲。臉紅應從耳朵周圍開始,逐漸擴散到臉頰和鼻子。瞬間變成鮮紅的皮膚看起來像濾鏡。濕潤的眼睛應該暗示脆弱感,而不是讓場景變成哭泣。
可複製貼上的文字生成影片提示詞
建立一段連續的 12 秒電影感特寫:一名害羞的 18 歲年輕男子,暗戀某人的秘密剛被鏡頭外站著的人發現。

他外表溫和年輕,留著柔軟、略顯凌亂的深色頭髮,皮膚清澈自然,穿著簡單休閒的服裝。他站在安靜的學校走廊窗邊,沐浴在柔和的午後晚些時候光線中。一本夾在他胸前的筆記本書頁間,露出一角折疊的手寫情書。

[0–2 秒——突然意識到]
鏡頭外有人注意到隱藏的情書,意味深長地看著他。年輕男子短暫僵住。當他意識到秘密已被發現時,眼睛微微睜大,呼吸一窒。

[2–5 秒——尷尬地閃避]
他立即將視線垂向地面,無法維持眼神接觸。肩膀略微向內收,手指緊緊握住筆記本。他張開嘴唇,彷彿想要解釋,卻說不出任何話。

[5–8 秒——臉紅擴散]
自然的紅暈從耳朵尖端開始,逐漸擴散到臉頰和鼻樑。膚色明顯變深,但保持真實而非卡通化。他的下眼瞼略微收緊,眼睛因強烈的尷尬與脆弱感而泛起淡淡淚光,但實際上沒有哭泣。

[8–10 秒——試圖掩飾感情]
他從睫毛下方短暫向上瞥,不小心與對方對視,隨即再次低下頭。他輕輕用牙齒咬住下唇,試圖壓抑緊張而不由自主的笑容。下巴幾乎難以察覺地顫抖。

[10–12 秒——害羞的情緒餘韻]
他將筆記本抱得更靠近胸口,臉稍微轉開,鬆開下唇。臉頰仍然深深泛紅。他的眼睛保持低垂且濕潤,嘴角帶著極其克制、尷尬的淡淡微笑,流露出真摯的情感。

自然寫實的真人表演、親密的成長氛圍、真實的皮膚質感、細微的面部肌肉運動、可見的呼吸、自然眨眼、淺景深、柔和窗光與輕柔背景模糊。固定的平視特寫,搭配極慢速推近。主要聚焦於眼睛、嘴唇、臉頰和呼吸中逐漸發生的情緒變化。

不要對話,不要誇張的動漫反應,不要瞬間變成鮮紅的臉,不要卡通腮紅標記,不要淚水沿臉頰流下,不要歇斯底里地哭泣,不要燦爛大笑,不要誘惑性的表情,不要誇張咬唇,不要臉部變形,不要身分改變,也不要鏡頭剪接。
這裡有兩個片語可以避免常見失敗。泛著淚光但沒有真的哭泣將情緒性的濕潤感與哭泣場景區分開來。輕輕用牙齒咬住下唇則將動作控制在足夠細微的程度,避免嘴部變形。
文字生成影片與圖像生成影片的情緒提示詞
情緒時間軸可以在兩種模式中重複使用,但提示詞不應承擔相同的工作量。
| 提示詞組成部分 |
文字生成影片 |
圖像生成影片或參考工作流程 |
| 角色身分 |
描述年齡、外觀、頭髮、服裝和角色 |
讓上傳的圖像定義身分 |
| 場景 |
描述地點、時間和光線 |
保留來源內容,或只加入必要背景 |
| 主要提示詞重點 |
角色、場景和表演 |
表演、時間安排和身分連貫性 |
| 主要風險 |
角色泛化或身分改變 |
臉部漂移、嘴部變形或來源圖像重新設計 |
| 最佳用途 |
從零建立完整場景 |
為既有角色製作動畫 |
根據官方發布詳情,ByteDance 完整的 Seedance 2.5 工作流程支援廣泛的多模態參考,包括最多 30 張圖像、10 部影片和 10 段音訊。這項供應商層級的能力比每一種第三方途徑都更廣泛。
截至撰寫本文時,主要的GPT Proto Seedance 2.5 API 頁面公開提供文字生成影片功能,以及提示詞、長寬比、時長、解析度、音訊、鏡頭和種子控制項。只有在介面確實提供圖像或參考輸入時,才使用上方的圖像生成影片提示詞。不要將@Image 1貼到純文字端點,並期待它理解一張從未上傳的圖像。
如何讓情緒影片呈現電影感,而不是舞台劇感
讓鏡頭保持靠近。平視特寫或中近景能提供足夠像素,讓面部變化保持可見。廣角鏡頭可以呈現肢體語言,但當眼睛和下唇承擔場景核心時,不應作為預設選擇。
使用一個克制的鏡頭移動。極慢速推近或輕微手持漂移能增加臨場感,又不會與表演競爭。快速環繞、變焦和頭部移動會讓臉部穩定性更難維持。
讓反應具有不對稱性。嘴角的一側可以先下垂;一滴眼淚可以先從一隻眼睛落下;角色可以抬頭一瞥後立即低頭。完全同步的面部變化往往顯得人造。
明確指導呼吸。屏住呼吸、吞嚥一次、顫抖地吸氣,或吐氣後肩膀下沉,都能將臉部與身體連結起來。當情緒變化必須保持安靜時,這尤其有用。
留下情緒餘韻。不要在情緒高峰結束影片,將最後兩三秒留給恢復:角色鬆開嘴唇、透過濕潤的眼睛眨眼、移開視線,或試圖穩定呼吸。殘留的情緒往往比最誇張的表情更令人信服。
為什麼你的 Seedance 2.5 面部表情仍然不對
| 問題 |
可能原因 |
提示詞調整 |
| 臉部表情保持扁平 |
只使用了抽象的情緒詞 |
加入眼睛、眉毛、嘴巴、下顎和呼吸的可見變化 |
| 角色立刻哭泣 |
提示詞沒有情緒堆疊 |
將第一階段保留給抗拒和延遲出現的淚光 |
| 表演看起來過度戲劇化 |
太多強烈線索同時出現 |
使用克制的、猶豫的等詞,並減少每個階段的動作數量 |
| 淚水看起來不自然 |
淚水對稱出現或數量過多 |
延遲第一滴眼淚,並讓兩隻眼睛的出現時間有所不同 |
| 咬唇時嘴巴變形 |
身體動作指示過於用力 |
將「用力咬」改為「輕輕咬住下唇」 |
| 上傳的角色發生變化 |
提示詞重新描述或重新設計人物 |
說明參考圖像定義身分與外觀 |
| 面部細節消失 |
大幅度動作或繁忙的鏡頭工作分散了注意力 |
使用特寫並加入一個緩慢的鏡頭移動 |
| 情緒在一秒後消失 |
提示詞定義了高峰,卻沒有結束狀態 |
加入恢復嘗試,以及殘留的目光或呼吸變化 |
當生成結果不理想時,一次只改變一個變數。如果淚水失敗,只修改淚水出現的時間;如果表演過於強烈,就減少同時出現的線索數量;如果身分漂移,就簡化動作並加強保留參考圖像的指示。每次嘗試後重寫整個提示詞,會讓你難以判斷究竟是哪項改動奏效。
可重複使用的 Seedance 2.5 情感表情提示詞範本
[參考圖像與身分指示,如有參考輸入]

建立一段連續的 [時長] 秒電影感[特寫/中近景]。

角色剛剛[情緒觸發點],但試圖[抗拒反應]。

[0–X 秒——初始反應]
[描述兩到三個可見的眼睛、眉毛、嘴巴、呼吸或手部反應。]

[X–X 秒——情緒洩漏]
[描述不由自主的微表情、目光行為和逐漸發生的身體變化。]

[X–X 秒——情緒高峰]
[描述克制的釋放,不要誇張表演。]

[X–X 秒——餘韻]
[描述恢復嘗試、殘留的呼吸變化和最後的目光。]

鏡頭:
[選擇構圖與一個克制的鏡頭動作。]

連貫性:
[說明哪些身分、服裝、背景、光線和構圖細節必須保持不變。]

避免:
[瞬間情緒變化、誇張表演、臉部變形、身分漂移、快速頭部移動、人工對稱反應和無關的背景動作。]
對於 10–15 秒的單鏡頭表演,通常四個按時間安排的階段就足夠了。對於較長的 30 秒敘事影片,應將額外時間用於外部觸發或第二個故事節拍,而不是將同一個面部反應拉伸到整段影片。Seedance 2.5 官方支援每次生成最長 30 秒以及時間戳級別的指示,但 ByteDance 也指出,複雜的身體動作和多個互動主體的場景仍有一定限制。當面部表演是優先事項時,請讓場景保持單純。請參閱官方 Seedance 2.5 模型概覽,以了解目前供應商層級的功能摘要。
如何在 GPT Proto 上使用 Seedance 2.5 生成情感影片
開啟Seedance 2.5 模型頁面,並選擇文字生成影片工作。
貼上完整的情感提示詞。使用即時控制項設定長寬比、時長、解析度、音訊偏好、鏡頭行為和種子。
生成第一個版本,並只評估四件事:情緒時間安排、臉部穩定性、物理真實感,以及最後兩秒是否保留了情緒餘韻。
修改最薄弱的階段,不要替換整個提示詞。
開發人員可以透過模型路由提交相同的文字生成影片提示詞。以下端點已由即時模型路由確認;如果可用值有所變更,請以目前的參數面板為準。
curl --location 'https://gptproto.com/api/v3/bytedance/dreamina-seedance-2-5-260628/text-to-video' \
  --header 'Authorization: GPTPROTO_API_KEY' \
  --header 'Content-Type: application/json' \
  --data '{
    "prompt": "建立一段連續的 12 秒電影感特寫:一名害羞的年輕男子,暗戀某人的秘密剛被發現。他僵住、低下視線、逐漸臉紅、輕輕咬住下唇,最後以濕潤的眼睛和克制而尷尬的微笑收尾。自然皮膚質感、細微呼吸、無對話、無卡通腮紅、無落淚、無鏡頭剪接。",
    "aspect_ratio": "16:9",
    "duration": 12,
    "resolution": "720p",
    "generate_audio": false,
    "camera_fixed": false,
    "seed": -1
  }'
如果你想使用相同的情緒時間軸比較其他影片模型,請保持提示詞、時長、構圖和種子策略不變,然後瀏覽AI 影片模型合集。公平的比較應該關注哪個模型能保留情緒弧線,而不是哪個模型生成了最漂亮的第一幀。