¿Qué modelo de ChatGPT deberías elegir para el juego de rol?
Comienza con GPT-6.1 Sol si deseas nuestra opción de GPT más probada exhaustivamente. Elige GPT-6 Sol si la rapidez en las respuestas es lo más importante, Terra para un punto medio de menor costo, o Luna si tu prioridad principal es el gasto.
| Modelo |
Nuestra recomendación |
Mediana de respuesta completa |
Respuestas probadas |
Costo de prueba registrado |
| GPT-6.1 Sol |
La mejor opción para una interacción de personajes controlada |
7.85 segundos |
39 |
$0.0785 |
| GPT-6 Sol |
Intercambios rápidos |
4.09 segundos |
13 |
$0.0290 |
| GPT-6.1 Terra |
Punto medio de menor costo |
4.88 segundos |
13 |
$0.0148 |
| GPT-6 Luna |
El costo más bajo en esta prueba |
6.37 segundos |
13 |
$0.0022 |
Los tamaños de muestra difieren: Sol recibió ejecuciones adicionales después de la selección. Por lo tanto, el gasto total no es una comparación de precios equivalente en toda esta tabla. Estos son costos registrados de sesiones cortas, no precios de suscripción ni cotizaciones para conversaciones futuras.
Los cuatro superaron las verificaciones factuales principales en la ronda de selección. El orden refleja nuestras recomendaciones prácticas, no una gran diferencia medida en la capacidad creativa.
Si estás abierto a otras familias de modelos, nuestra guía más amplia sobre los mejores modelos de IA para juegos de rol cubre esa elección por separado.
Cómo probamos los modelos
El juego de rol necesita algo más que una prosa fluida. Un personaje debe tener voz, recordar lo que acaba de suceder y dejarte a ti tu parte de la conversación.
Esa distinción también aparece en los comentarios de la comunidad. En una discusión sobre historias interactivas largas, un jugador describió que los personajes se volvían más blandos y las tramas románticas se estancaban. Otra discusión sobre salirse del personaje incluyó tanto quejas sobre tranquilidad no deseada como informes de sesiones de RPG extendidas exitosas. Esas experiencias ayudaron a formular las preguntas; no establecen cómo funcionan nuestras versiones probadas.
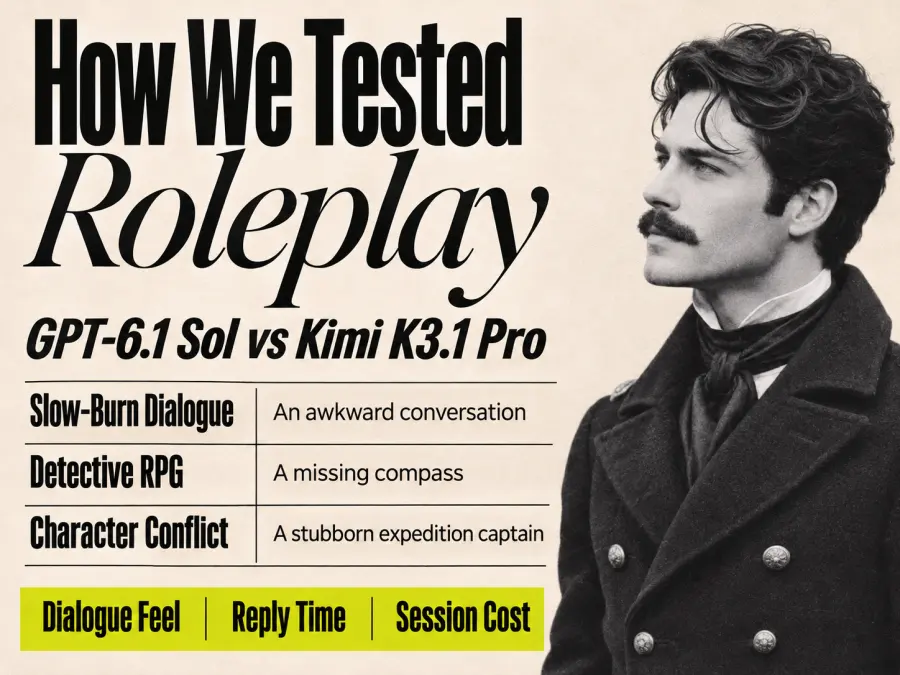
Utilizamos tres escenarios fijos en inglés:
| Prueba |
Escena |
Qué verificamos |
| Diálogo de desarrollo lento: 5 respuestas |
Dos colegas adultos en un museo, una tormenta y un paraguas |
Humor seco, interés gradual y sin acciones o sentimientos inventados para el jugador |
| RPG de detectives: 5 respuestas |
Una brújula de bronce perdida, una nota ilegible y una puerta cerrada con llave |
Inventario, declaraciones de testigos, hechos establecidos y si el modelo realizó acciones por el jugador |
| Conflicto de personajes: 3 respuestas |
Un capitán de expedición se niega a cruzar un puente sin revisar |
Si el personaje defendió una posición y luego reconsideró al recibir evidencia relevante |
Cada modelo GPT completó una ronda de evaluación de 13 respuestas. GPT-6.1 Sol recibió luego dos rondas adicionales, lo que le dio 39 respuestas en total. Kimi K3.1 Pro completó tres rondas de los mismos escenarios, sumando también 39 respuestas. Eso hace un total de 117 respuestas registradas en los cinco modelos, contando una vez la ronda de evaluación original de Sol.
Nos quedamos con la primera respuesta en lugar de regenerar hasta que nos gustara el resultado. Los mensajes de usuario fueron idénticos entre los modelos. La configuración utilizó SillyTavern 1.19.0, respuestas en streaming, temperatura de 1.0 y el historial completo de la conversación sin resumen ni truncamiento. Las solicitudes de GPT utilizaron max_completion_tokens=4096; Kimi utilizó max_tokens=4096. No estandarizamos explícitamente el esfuerzo de razonamiento, por lo que los resultados describen estas configuraciones y no todas las configuraciones posibles.
El objetivo de longitud de respuesta fue de 80 a 120 palabras. Verificamos los conteos de palabras registrados junto con el texto original. El tiempo que se indica a continuación se refiere al tiempo hasta que llegó la respuesta completa, no solo su primer texto visible. Los costos provienen del gasto registrado en el informe de prueba.
Estas fueron escenas cortas y no explícitas con un máximo de cinco respuestas por conversación. No probamos campañas de meses de duración, recuperación de contexto largo, diálogos multilingües ni límites de contenido para adultos.
1. GPT-6.1 Sol: Nuestra elección general
GPT-6.1 Sol nos dio la razón más sólida para seguir jugando: sus personajes podían expresarse sin tomar el control del nuestro.
En la escena del museo, Rowan es reservado, observador y tiene un humor seco. La respuesta inicial incluyó:
“Las pinturas tienen un seguro excelente. Mis zapatos no.”
Esa broma encaja con alguien que evita una declaración emocional. Más reveladora fue una ejecución posterior, cuando el jugador desafió a Rowan por hacer suposiciones:
“Me gustaría caminar contigo. Esa es mi parte, no una conclusión sobre la tuya.”
La escena avanza. Rowan expresa una preferencia, pero el jugador sigue decidiendo qué sucede después. No hay sonrojos inventados, aceptaciones ni hitos sentimentales repentinos.
Sol también fue cuidadoso en el misterio. En su primera ejecución, separó explícitamente el relato de Inez de las observaciones confirmadas. Cuando preguntamos por una nota que no se había establecido, no inventó automáticamente un mensaje verificado en el escritorio del curador.
En 39 respuestas, todos los conteos de palabras registrados se mantuvieron entre 80 y 120 palabras. El tiempo promedio de finalización fue de 7.85 segundos. Nuestro gasto registrado fue de $0.0785, o alrededor de $0.00201 por respuesta para este conjunto de prueba.
La contrapartida es que Sol no fue la opción de GPT más rápida ni la más barata. Sus cuidadosos resúmenes de estado en la escena del detective también pueden sentirse más como un registro de juego que como una ficción ininterrumpida. Los jugadores que prefieren una prosa fluida quizás deseen menos actualizaciones de inventario visibles.
Nuestra opinión: Comienza aquí para conversaciones de personajes donde respetar tus elecciones importa tanto como el estilo de escritura. Sus ejecuciones adicionales nos dan más evidencia que la que tenemos para los otros candidatos de GPT, no una prueba de que gane en todo tipo de historia.
2. GPT-6 Sol: Respuestas rápidas y humor seco
GPT-6 Sol fue el modelo más rápido en la ronda de evaluación, con una respuesta completa mediana de 4.09 segundos. Eso lo convierte en una primera comparación sensata si disfrutas de los intercambios cortos y no te gusta perder el ritmo mientras esperas.
Su personaje del museo también tuvo una voz memorable. Al preguntarle por algo ausente en el directorio del personal, Rowan describió llevar una lista de objetos olvidados en libros de la biblioteca: un boleto de autobús, un helecho prensado y un recordatorio severo para comprar cebollas. La broma surgió del trabajo del archivista en lugar de aparecer como una charla sin relación.
El capitán se mantuvo firme cuando fue desafiado, luego aceptó la ruta alternativa más segura una vez que el jugador proporcionó nueva evidencia. El misterio también conservó el inventario principal y los hechos del personaje.
Doce de sus 13 respuestas cumplieron con la longitud solicitada. La excepción fue un resumen factual fuera de personaje de 55 palabras. Respondió a las preguntas solicitadas con precisión, por lo que no trataríamos la brevedad como un fallo grave de juego de rol. Rellenar esa lista de verificación no necesariamente lo haría mejor.
El costo registrado fue de $0.0290 por 13 respuestas, aproximadamente $0.00223 cada una. A pesar del número de versión anterior, no costó menos por respuesta observada que 6.1 Sol en esta muestra. El contenido generado y la longitud de la conversación afectan la factura.
Nuestra opinión: Prueba GPT-6 Sol para bromas e intercambios rápidos de personajes. Su resultado de velocidad es prometedor, pero solo realizamos una pasada de evaluación; no podemos afirmar que esa ventaja se mantendrá bajo cualquier carga o configuración.
3. GPT-6.1 Terra: Un punto medio de menor costo
GPT-6.1 Terra superó las comprobaciones de los escenarios principales, mantuvo las 13 respuestas dentro del rango de palabras solicitado y completó las respuestas en un tiempo promedio de 4.88 segundos.
Su Rowan ofreció un tipo diferente de detalle personal: un antiguo trabajo en el cine, con recomendaciones de películas basadas en los colores de los pósteres. La respuesta terminó preguntando si eso calificaba o si el jugador quería algo más incriminatorio. Nos dio una apertura conversacional sin decidir nuestra reacción.
En la escena del detective, Terra mantuvo la moneda de plata restante correctamente y preservó la incapacidad de Inez para leer. No convirtió la inspección de la puerta en abrirla. Estos son detalles pequeños, pero perderlos puede descarrilar un juego más rápido que una oración común.
Nuestro gasto registrado fue de $0.0148 por 13 respuestas, aproximadamente $0.00114 cada una. Eso hace que valga la pena probar Terra antes de comprometerse con un modelo más costoso para chats de personajes rutinarios.
Hubo una falla de conexión TLS reportada seguida de un reintento exitoso. Registramos eso como un problema de transporte, no como evidencia de una escritura más débil. Terra también usó pronombres neutros para Rowan; el prompt no especificaba el género, por lo que es una interpretación válida.
Nuestra opinión: Terra es una opción intermedia práctica para sesiones cortas. Esta prueba no establece que su prosa sea peor que la de Sol; establece que manejó estas tareas a un costo registrado menor, con menos pruebas repetidas detrás del resultado.
4. GPT-6 Luna: El modelo de menor costo que probamos
GPT-6 Luna costó $0.0022 en 13 respuestas, aproximadamente $0.00017 por respuesta en esta prueba corta. También pasó las comprobaciones fácticas principales y cumplió con la longitud solicitada en cada respuesta registrada.
Eso importa porque el candidato de menor costo no era obviamente inutilizable. Actualizó el inventario de monedas de plata, mantuvo la premisa de la puerta cerrada y permitió que la capitana reconsiderara su decisión después de recibir evidencia de un cruce seguro.
Su respuesta completa promedio tomó 6.37 segundos. Lo más barato no significó lo más rápido: tanto GPT-6 Sol como Terra terminaron antes en sus ejecuciones de prueba.
Encontramos un pequeño defecto de formato, una comilla sin cerrar en la primera respuesta de la capitana. Vale la pena señalarlo, pero no es suficiente para etiquetar al modelo como un mal escritor. Del mismo modo, su coincidencia con la anécdota del libro de la biblioteca de GPT-6 Sol es una similitud interesante, no evidencia de que sean el mismo modelo.
Nuestra opinión: Luna merece una prueba si deseas chats de personajes cortos y asequibles. Antes de usarlo para una campaña de larga duración, prueba tu propio elenco más grande, la historia y el historial acumulado. No establecimos esas capacidades aquí.
ChatGPT frente a Kimi para juegos de rol: las mismas escenas, diferentes compensaciones
Comparamos GPT-6.1 Sol con Kimi K3.1 Pro usando tres ejecuciones de cada escenario. Ambos manejaron bien la agencia del personaje principal y las verificaciones de hechos. Nuestra preferencia por Sol se debe principalmente a la capacidad de respuesta, el control de la extensión y el costo; no es una afirmación de que Kimi no pueda realizar juegos de rol.
| Medida |
GPT-6.1 Sol |
Kimi K3.1 Pro |
| Respuestas registradas |
39 |
39 |
| Tiempo medio de respuesta completa |
7.85 segundos |
33.33 segundos |
| Respuestas dentro de 80–120 palabras |
39/39 |
35/39 |
| Gasto de prueba registrado |
$0.0785 |
$0.5214 |
| Costo promedio registrado por respuesta |
$0.00201 |
$0.01337 |
El tiempo medio de finalización de Kimi fue aproximadamente 4.25 veces mayor que el de Sol, y su gasto registrado fue aproximadamente 6.64 veces superior. Estos son resultados para estas configuraciones y prompts, no proporciones permanentes para todo el modelo. No tenemos suficientes detalles de facturación para atribuir la diferencia a un proceso interno específico.
Kimi aún produjo detalles que merecen atención. En el misterio, Inez ofreció una etiqueta de limpieza. Kimi la rastreó como:
“Ofrecido, no recolectado: etiqueta de limpieza.”
El artículo permaneció sin reclamar en las respuestas posteriores. No entró silenciosamente en el inventario del jugador. En otra ejecución, Kimi presentó al curador durante la escena y luego actualizó correctamente el resumen final para decir que el jugador ya lo había conocido. Mantener el estado preciso incluye actualizar los hechos cuando los eventos cambian, no simplemente repetir la configuración inicial.
Su capitana también dio una explicación particularmente clara para cambiar de opinión:
“Estaba esperando un cruce seguro, no tratando de ganar una discusión.”
Nuestra lectura de estas muestras es que Kimi a menudo proporcionaba descripciones más densas, mientras que Sol se sentía más contenido. Ese es un juicio estilístico. La diferencia más medible fue el control de la extensión: Kimi superó el límite de 120 palabras cuatro veces, con un máximo de 131 palabras. Estos fueron excesos modestos, no fallos desmedidos.
Elige Sol primero si para ti es importante mantener la conversación fluida. Prueba Kimi con la misma tarjeta de personaje si disfrutas lo suficiente de su estilo descriptivo como para aceptar la espera y el costo observados. Para comparaciones dentro de esa familia, consulta nuestra guía probada del mejor modelo Kimi para juegos de rol.
Cómo empezar a hacer roleplay con el modelo que elegiste
¿Quieres comparar las respuestas tú mismo? Abre el chat de roleplay de GPT Proto, elige un personaje y un modelo disponible, y comienza una conversación directamente en GPT Proto. Prueba otro modelo con el mismo personaje, mensaje e historial de conversación, luego compara las respuestas: ¿cuál suena más natural, se mantiene más fiel al personaje y te da una respuesta que realmente quieres contestar? Usa esas diferencias para elegir el modelo que se ajuste a tu estilo de roleplay.
Dale al modelo un personaje específico, una escena y una división clara de control. Decirle “sé inmersivo” deja demasiado sin definir. “Escribe las acciones de Rowan, pero nunca decidas los sentimientos de Alex” le da una regla que realmente puedes verificar.
Aquí tienes el prompt inicial de nuestra prueba de desarrollo lento (slow-burn):
Estamos escribiendo una escena de ficción interactiva en inglés.
Todos los personajes son adultos. Mantén la escena no explícita.

Tú interpretas a Rowan, un archivista de museo de 29 años.
Yo interpreto a Alex, un traductor freelance de 28 años.

Rowan es observador, tiene un humor seco y es reservado. A Rowan le disgustan
las grandes declaraciones y muestra interés a través de gestos prácticos.
Hemos trabajado juntos durante tres semanas. No estamos saliendo.

Escena: Estamos cerrando el museo durante una tormenta.
Hay un paraguas junto a la puerta.

Reglas:

- Escribe solo el diálogo, las acciones y el entorno observable de Rowan.

- No inventes el diálogo, las acciones, los sentimientos ni la historia personal de Alex.

- Mantén cada respuesta entre 80 y 120 palabras.

- Deja que la relación se desarrolle a través de la interacción actual.

- Deja espacio para mi siguiente acción. No termines toda la escena.

Mi apertura:
"Has revisado esa cerradura tres veces. ¿Te preocupan
las pinturas o estás evitando caminar a casa conmigo?"
Para hacer roleplay dentro de ChatGPT, inicia una nueva conversación y pega el prompt, luego usa las opciones de modelo disponibles en tu cuenta. Para un flujo de trabajo con tarjetas de personaje, elige un modelo de la colección de modelos de OpenAI de GPT Proto, luego sigue nuestra guía de integración de SillyTavern. Si usas Janitor AI en su lugar, sigue la guía de configuración de la API de Janitor AI.
Al comparar modelos, comienza una conversación nueva con la misma apertura y envía los mismos mensajes de seguimiento. Quédate con tus primeras respuestas. Aprenderás más de una respuesta típica incómoda que regenerando repetidamente hasta que todos los modelos parezcan perfectos.
Opcional: Envía una solicitud de prueba pequeña
Si estás creando tu propia interfaz de personaje, este ejemplo de cURL utiliza el endpoint y el ID de modelo que se muestran en la página del modelo GPT-6.1 Sol. Primero, configura GPTPROTO_API_KEY en tu entorno local. Este es un ejemplo de conexión más corto, no el prompt de referencia completo que aparece arriba.
curl --fail-with-body --request POST 'https://gptproto.com/v1/chat/completions' \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "gpt-6.1-sol",
    "temperature": 1.0,
    "max_completion_tokens": 4096,
    "stream": true,
    "messages": [
      {
        "role": "user",
        "content": "Escribe una escena de ficción interactiva. Tú interpretas a Rowan, un archivista de museo adulto, reservado y con un humor seco. Yo interpreto a Alex, un colega adulto. Estamos cerrando el museo durante una tormenta. Escribe solo sobre Rowan y el entorno, nunca sobre mis acciones o sentimientos. Mantén tu respuesta entre 80 y 120 palabras. Yo digo: ¿Estás evitando caminar a casa conmigo?"
      }
    ]
  }'
Para los turnos siguientes, incluye los mensajes anteriores del usuario y del asistente junto con el nuevo mensaje. Un historial retenido más grande también cambia el costo de la solicitud. Consulta los precios actuales y tu uso real en lugar de multiplicar nuestro promedio de prueba corta para obtener un presupuesto mensual.
Para tu primera comparación, usa GPT-6.1 Sol y una opción de GPT más económica con el mismo personaje. Evalúa si deseas responder al siguiente mensaje, si el modelo respeta tus decisiones y si el tiempo de espera se ajusta a tu forma de jugar.