Descripción general de Qwen 4 Max: De la prueba a ciegas de "Qoduck" a la vista previa de 14 días
Si deseas una descripción general práctica de Qwen 4 Max, comienza con los cuatro días previos a que su nombre se hiciera público. Entre el 7 y el 10 de noviembre de 2026, un modelo anónimo con el nombre en clave Qoduck apareció dentro de Qoder, un IDE de programación agéntica. Los desarrolladores que probaron Qoduck notaron un patrón inusual: en lugar de devolver un fragmento de código rápido de una sola pasada y esperar la retroalimentación humana, el modelo dedicaba de diez a quince minutos a ejecutar comprobaciones de shell, escribir recursos SVG personalizados desde cero y ejecutar pruebas unitarias contra sus propios diffs antes de devolver una respuesta final.
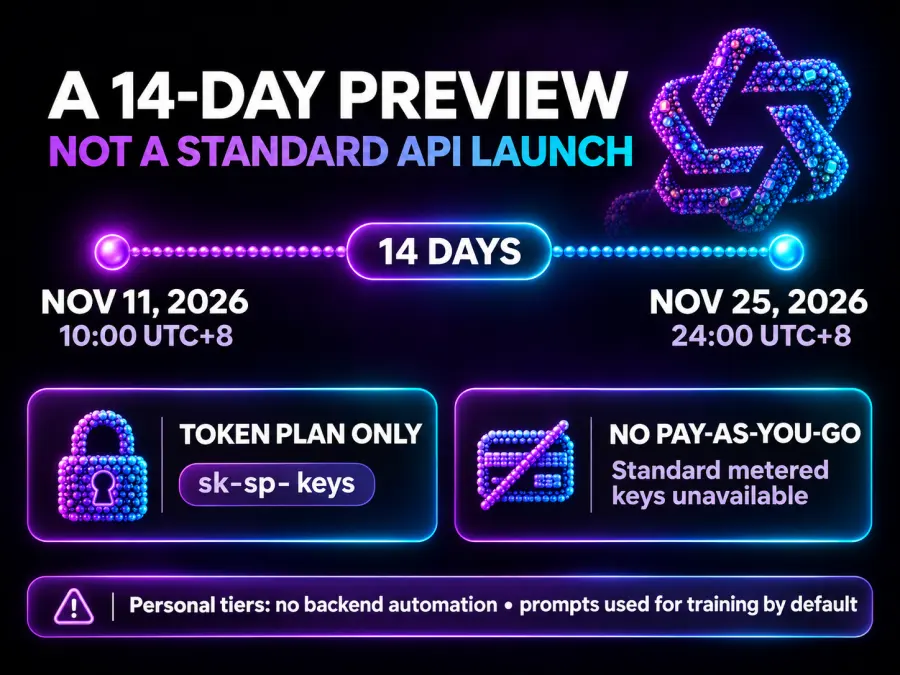
El 11 de noviembre de 2026 a las 10:00 UTC+8, Alibaba confirmó que Qoduck era el modelo más reciente de Qwen, Qwen 4 Max, y lo expuso en Alibaba Cloud Model Studio bajo la cadena de modelo qwen4-max-preview (referenciado como qwen4.0-max-preview en configuraciones de cliente seleccionadas). En lugar de organizar un lanzamiento comercial completo con precios de lista por token, Alibaba estructuró el despliegue —a menudo descrito en los documentos para desarrolladores como la introducción de Qwen 4 Max a través de una vista previa de 14 días de Qwen 4 Max— diseñado para realizar pruebas de estrés en flujos de trabajo agénticos dentro de herramientas de desarrollo como Claude Code, Cursor, Cline y Qoder.
| Especificaciones |
Estado confirmado (qwen4-max-preview) |
Fuente / Nota de ingeniería |
| ID oficial del modelo |
qwen4-max-preview |
Documentación de Alibaba Cloud Model Studio / Bailian |
| Ventana de vista previa |
11 de nov. de 2026 (10:00) – 25 de nov. de 2026 (24:00 UTC+8) |
Vista previa limitada estricta de 14 días |
| Ventana de contexto |
1,000,000 de tokens (entrada máxima: 967,000 tokens) |
Verificado en documentos de CN e internacionales |
| Tokens de salida máximos |
393,216 en total (131,072 de salida final + 262,144 de razonamiento) |
max_tokens limita el pensamiento + salida combinados |
| Modalidades de entrada / salida |
Entrada: Texto, Imagen, Video · Salida: Texto |
Sin entrada de audio nativa en la ruta de vista previa |
| Control de razonamiento |
reasoning_effort: low, medium, xhigh |
Pensamiento activado por defecto; el valor predeterminado es xhigh |
| Protocolos de API compatibles |
OpenAI Chat Completions, Responses API, Anthropic Messages |
Requiere un endpoint de plan de tokens sk-sp- dedicado |
| Tamaño de parámetros y pesos |
No revelado (Vista previa comercial cerrada) |
Las cifras de 2.4T / 95B en línea pertenecen a Qwen3.8-Max |
| Tabla de benchmarks oficial |
No publicada en el lanzamiento de la vista previa |
La puntuación GameFeel de 49.9 que circula es de Qwen-4-Flash-Early |
Entender qwen 4 max explicado como un paso generacional se reduce a cómo utiliza el cómputo durante el tiempo de inferencia. Donde las versiones anteriores trataban la llamada a herramientas como un asistente opcional, la actualización principal de qwen 4 max integra un ciclo de autoverificación en el proceso de razonamiento predeterminado. Cuando se le pide crear una aplicación web o corregir una utilidad de línea de comandos, el modelo encadena rutinariamente docenas de invocaciones de herramientas: inspeccionando árboles de directorios, ejecutando pytest o navegadores headless locales, detectando sus propias regresiones de sintaxis o diseño, y reescribiendo las líneas defectuosas antes de que el usuario vea el resultado.
Arquitectura, tamaño del modelo y la realidad de los benchmarks
Dos piezas de información errónea dominan actualmente los resultados de búsqueda para qwen 4 max size y qwen 4 max benchmark. Aclararlas es la forma más rápida de entender qué lanzó realmente Alibaba y qué permanece sin revelar.
Primero, Alibaba no ha revelado el conteo total o activo de parámetros para alibaba qwen 4 max. Varios blogs de terceros lo catalogan como un modelo de mezcla de expertos (MoE) de 2.4 billones de parámetros con 95 mil millones de parámetros activos por token. Esas cifras exactas pertenecen al buque insignia anterior, Qwen3.8-Max, que se lanzó en septiembre de 2026. Aunque Qwen 4 Max casi con seguridad utiliza una arquitectura base MoE dispersa para ofrecer una ventana de contexto de 1M de forma económica, cualquier cifra específica de billones de parámetros que leas en noviembre de 2026 es un remanente no verificado de la generación 3.8.
Lo que sí tenemos sobre el aspecto arquitectónico proviene del lanzamiento técnico de Alibaba en agosto de 2026 de Qwen3.8-Flash-Next, que el equipo de Qwen designó explícitamente como un banco de pruebas para validar las actualizaciones arquitectónicas principales para la serie Qwen 4. Ese informe precursor documentó cuatro cambios estructurales que explican cómo qwen4-max-preview maneja cargas de trabajo de un millón de tokens:
Atención híbrida GDN + QSA: La combinación de capas de atención lineal Gated DeltaNet (GDN) con Qwen Sparse Attention (QSA) redujo la latencia de prellenado del tiempo hasta el primer token (TTFT) en un contexto de 1,000,000 de tokens hasta en 7.6 veces en comparación con la atención completa estándar.
Conexiones residuales cerradas de 4 flujos: La expansión del ancho del flujo residual con puertas aprendidas mejora el flujo de gradiente y el enrutamiento de características entre capas durante el razonamiento profundo de varios pasos.
Capas de incrustación (embedding) de N-gramas: La inyección de contexto local de múltiples tokens directamente en la etapa de incrustación descarga la coincidencia de patrones léxicos de los bloques de atención iniciales.
Entrenamiento con optimizador Muon: El cambio de la optimización del preentrenamiento a gran escala a Muon mejoró la eficiencia de la muestra en corpus de código y lógica formal.
Segundo, si buscas resultados de qwen 4 max benchmark, probablemente te encontrarás con afirmaciones de que Qwen 4 Max obtuvo 49.9 en GameFeel Bench v1.4, superando a Claude Opus 5.5 con 47.2. Revisé la tabla de clasificación y los registros de confirmación (commit logs) subyacentes: esa puntuación de 49.9 fue registrada por un punto de control de prueba temprano y ligero llamado Qwen-4-Flash-Early (nombre en clave interno hawk), no qwen4-max-preview. Al 13 de noviembre de 2026, Alibaba no ha publicado una tabla de clasificación oficial de MMLU-Pro, SWE-bench Verified o AIME para Qwen 4 Max.
Lo que puedes verificar ahora mismo es la mecánica de la qwen 4 max context window y su presupuesto de salida, y aquí es donde los desarrolladores que migran se topan con una pared. Aunque la ventana de contexto contiene 1,000,000 de tokens (con un límite documentado de 967,000 tokens para el prompt), la salida máxima aparece como 393,216 tokens en el portal internacional y desglosada en el portal nacional como 262,144 tokens de razonamiento más 131,072 tokens de respuesta final.
Aquí está el detalle: el parámetro de API max_tokens en qwen4-max-preview rige la sum de reasoning_content y content. Debido a que el modelo utiliza por defecto reasoning_effort: "xhigh" (el más alto de los tres ajustes disponibles: low, medium y xhigh), un prompt de programación complejo puede consumir fácilmente de 15,000 a 40,000 tokens dentro del bloque de razonamiento oculto. Si tu código de cliente actual pasa max_tokens: 4096 o 8192, el modelo agotará toda su asignación a mitad del razonamiento y devolverá una cadena de content vacía. Para evitar el truncamiento silencioso, aumenta max_tokens por encima de 65,536 o reduce explícitamente reasoning_effort a medium para tareas rutinarias.
Análisis práctico de Qwen 4 Max: Lo que realmente muestran las pruebas de la comunidad y los medios
Debido a que Alibaba omitió un comunicado de prensa tradicional con benchmarks, los datos más confiables de la reseña de qwen 4 max provienen de equipos de ingeniería que integraron qwen4-max-preview en entornos de agentes en vivo durante las primeras 48 horas de la versión preliminar. Sus registros muestran un patrón claro: cada salto en la calidad de salida viene acompañado de una latencia y un costo de tokens notables.
El 11 de noviembre, la consultora de IA japonesa WEEL publicó una evaluación en tres partes probando el modelo preliminar en síntesis de frontend, investigación de múltiples fuentes y depuración a nivel de repositorio dentro de Claude Code:
Página de aterrizaje SVG personalizada de 908 líneas (vs Qwen 3.8 Max): Ante la misma instrucción para crear una página de aterrizaje responsiva para una clínica de fisioterapia con temática forestal, Qwen3.8-Max terminó en unos 9.5 minutos, pero extrajo fotos de stock externas aleatorias que rompieron la cuadrícula o no cargaron. qwen4-max-preview tardó aproximadamente 17 minutos, casi el doble. En lugar de enlazar URLs externas frágiles, invocó su Intérprete de Código docenas de veces en segundo plano para dibujar mediante programación ilustraciones SVG personalizadas de copas de árboles, arquitectura de la clínica e iconos del personal, entregando un archivo HTML de 908 líneas sin activos rotos.
Depuración autónoma de CLI en Claude Code (36/36 pruebas superadas): WEEL apuntó Claude Code (impulsado por qwen4-max-preview a través del endpoint compatible con Anthropic) a una CLI de contabilidad doméstica en Python (kakeibo) y le pidió que añadiera los flags de filtrado --export-csv y --month con pruebas unitarias. La ejecución tomó 11 minutos y 48 segundos. Después de escribir la implementación inicial, el modelo ejecutó pytest, detectó 2 pruebas fallidas —incluyendo un caso extremo donde una cadena de moneda negativa como -100日元 fue malinterpretada por argparse de Python como un flag de línea de comandos— y corrigió el analizador por sí mismo. Sin que se lo pidieran, también antepuso un encabezado BOM utf-8-sig para que los caracteres japoneses no se corrompieran en Microsoft Excel y escapó los caracteres iniciales =, +, - y @ para bloquear la inyección de fórmulas CSV. Las 36 pruebas fueron superadas, consumiendo solo el 0.4% de la cuota mensual del plan Lite.
Investigación de políticas autoverificada: Con la tarea de compilar una tabla comparativa de subsidios para PYMES japonesas de 2026, el modelo pasó 2 minutos realizando más de una docena de consultas web en portales ministeriales y otros 5 minutos ejecutando grep y scripts de validación en Python para verificar que ninguna columna de la tabla Markdown se desplazara antes de presentar el resultado de 8 minutos.
Dos días después, el 13 de noviembre, la publicación tecnológica china Silicon Star (GuiXingRen) realizó una prueba de ingeniería visual y 3D contra qwen4-max-preview. Cuando se le pidió generar la clásica animación SVG de un "pelícano montando una bicicleta", el modelo articuló el movimiento del pedal y las sombras de paralaje de los árboles, mientras añadía sin que se lo pidieran un control deslizante de velocidad de 0.5x–1.75x y un selector de temas día/atardecer/noche. En una prueba más difícil de Three.js —construir un juego jugable de aviones de papel en 3D llamado Paper Skies donde el avión vuela a través de la ventana de un dormitorio hacia un jardín—, los revisores notaron que su física y manejo de obstáculos igualaban al Claude Fable 5.1 de Anthropic, centrado en la creatividad, aunque todavía estaba por detrás del nuevo Claude Fable 5.2 en el pulido de sombreadores. Cuando se le pidió rediseñar la propia página de inicio responsiva de Silicon Star, el modelo inició un navegador local, detectó que las miniaturas de artículos externos devolvían errores 403 de hotlink, las reemplazó automáticamente con marcadores de posición de degradado SVG estilizados y completó una segunda ronda de revisiones de diseño editorial en 5 minutos.
Los comentarios de los desarrolladores en X (anteriormente Twitter) y en foros de desarrolladores japoneses añaden matices importantes a cada aspecto destacado de qwen 4 max feature. El desarrollador @round_boys demostró que el modelo renderizó una escena 3D completa usando Java y Three.js en un solo intento, pero señaló que la ejecución consumió aproximadamente 69,000 tokens. Otros usuarios pioneros que midieron el rendimiento bruto informaron velocidades de transmisión de alrededor de 33 tokens por segundo bajo la configuración predeterminada xhigh, comentando que sus trayectorias de uso de herramientas mediante aprendizaje por refuerzo (RL) a veces analizan demasiado las lecturas simples de archivos; un recordatorio de que el sufijo -preview es literal.
Precios de Qwen 4 Max, reglas del plan de tokens y bloqueos de producción
Si buscas precios de qwen 4 max esperando una tabla estándar de "$X por millón de tokens de entrada", no encontrarás una. Alibaba no ofrece facturación medida de pago por uso para qwen4-max-preview. La única forma de enviar solicitudes es a través de una suscripción activa al Alibaba Cloud Model Studio Token Plan (anteriormente llamado Coding Plan), que factura en "Créditos" mensuales abstractos en lugar de dólares directos por token.
En el portal internacional de QwenCloud, el Plan de Tokens se divide en niveles personal y de equipo:
Plan Lite (3 por el primer mes para nuevos usuarios): Incluye 20,000 Créditos al mes, regidos por una estricta limitación continua de 1,200 Créditos por ventana de 5 horas y 9,000 Créditos por semana.
Plan Pro (15 por el primer mes): Incluye 100,000 Créditos al mes, con un tope de 6,000 Créditos por ventana de 5 horas y 45,000 Créditos por semana. (En el portal nacional de Alibaba en China, los planes Lite y Pro aparecen a 39 RMB y 199 RMB al mes, con promociones de mitad de precio el primer mes a 19.5 RMB y 99.5 RMB).
Descuento de vista previa de 14 días (11 de nov. – 25 de nov. de 2026): Durante la ventana de vista previa de dos semanas, las llamadas diurnas (08:00–22:00 UTC+8) consumen solo el 20% del peso estándar de Créditos, mientras que las llamadas nocturnas fuera de hora pico (22:00–08:00 UTC+8) reciben un descuento adicional del 80% sobre eso, reduciendo el consumo efectivo de Créditos a solo el 4% de las tarifas normales.
Para un desarrollador individual que experimenta en un IDE por la noche por $3, esa matemática promocional es difícil de superar. Sin embargo, para un equipo de ingeniería que construye un producto o ejecuta agentes de CI/CD automatizados, el Plan de Tokens introduce tres bloqueos de producción importantes:
Prohibición de automatización de backend e integración de API: Los términos del Plan de Tokens de Alibaba restringen explícitamente las claves personales Lite y Pro (sk-sp-) a la codificación interactiva activada por humanos dentro de complementos de IDE compatibles. Usar una clave de suscripción para alimentar un script de backend automatizado, una función SaaS orientada al cliente o una canalización de datos por lotes viola los términos de servicio y provoca la suspensión de la cuenta.
Entrenamiento de datos obligatorio en niveles personales: Según las reglas del Plan de Tokens, las suscripciones personales Lite y Pro inscriben todos los prompts, el contexto del repositorio y las finalizaciones del modelo en el programa de mejora de entrenamiento de modelos de Alibaba de forma predeterminada, y no hay una opción para desactivarlo. Solo el Plan de Equipo empresarial ($40 por asiento/mes) proporciona una garantía de cero retención de datos / sin entrenamiento.
Límites de tasa continuos de 5 horas y el cierre del 25 de noviembre: Incluso si tu flujo de trabajo es puramente interno, un techo continuo de 1,200 Créditos cada 5 horas no puede absorber picos de múltiples desarrolladores, y el endpoint qwen4-max-preview está programado para cerrarse el 25 de noviembre de 2026 a las 24:00 UTC+8.
Comparativas directas: Qwen 4 Max vs. Qwen 3.8 Max, Kimi K3.1 Pro, GLM-5.3 y Claude Opus 5.5
Debido a que actualmente no puedes integrar qwen4-max-preview en un entorno de producción, la pregunta práctica detrás de cada consulta de comparación es qué modelo insignia de pago por uso cubre la misma carga de trabajo de agentes con 1M de contexto sin bloqueos por suscripción ni exposición de datos para entrenamiento.
| Modelo |
Facturación y disponibilidad |
Ventana de contexto |
Salida máxima |
Modalidades de entrada compatibles |
Tarifa medida de GPT Proto (Entrada / Salida por 1M) |
Qwen4-Max-Preview (qwen4-max-preview) |
Solo vista previa de 14 días (finaliza el 25 de nov.); suscripción al plan de tokens ($6–$30/mes) |
1,000,000 |
393,216 (incl. 262K CoT) |
Texto, imagen, video |
No alojado (sin API upstream medida) |
Qwen3.8 Max 0902 (qwen3.8-max-0902) |
Pago por uso en producción |
1,000,000 |
65,536+ |
Texto, imagen, video, audio, documento |
4.20 (30% por debajo de la lista oficial) |
Kimi K3.1 Pro (kimi-k3.1-pro) |
Pago por uso en producción |
1,048,576 (1.05M) |
131,072 |
Texto, imagen, documento |
10.00 ($0.20 entrada en caché) |
GLM-5.3 (glm-5.3) |
Pago por uso en producción |
1,050,000 (1.05M) |
128,000 |
Texto, imagen, documento |
3.74 (15% por debajo de la lista oficial) |
Claude Opus 5.5 (claude-opus-5-5) |
Pago por uso en producción |
1,000,000 |
128,000 |
Texto, imagen, documento |
18.00 (10% por debajo de la lista oficial) |
Qwen 4 Max vs. Qwen 3.8 Max
Al evaluar qwen 4 max vs qwen 3.8 max, el equilibrio está entre el tiempo de verificación autónoma frente a la estabilidad en producción y una compatibilidad de modalidades más amplia. Como demostró la prueba de la página de destino de 17 minutos frente a 9.5 minutos de WEEL, Qwen 4 Max está dispuesto a invertir el doble de tiempo real ejecutando comprobaciones de Python en segundo plano y sintetizando archivos SVG personalizados. Sin embargo, qwen4-max-preview prescinde del análisis nativo de audio y documentos en su ruta de vista previa y no puede ser invocado por token.
Si tu flujo de trabajo ya depende del formato de prompts, la tokenización multilingüe o la visión multimodal de Alibaba, qwen3.8-max-0902 es el modelo insignia listo para producción que debes elegir hoy. Ofrece la misma ventana de contexto de 1,000,000 de tokens mientras acepta entradas de texto, imagen, video, audio y documentos. En GPT Proto, qwen3.8-max-0902 funciona a 4.20 por cada 1M de tokens de salida—un 30% por debajo del precio de lista oficial de Alibaba—y puedes compararlo junto a sus hermanos de pesos abiertos más pequeños en el centro de modelos de Qwen.
Qwen 4 Max vs Kimi K3.1 Pro
El enfrentamiento entre qwen 4 max vs kimi k3.1 pro fue probado cara a cara en los benchmarks Blender MCP y WebGL del 13 de noviembre de Silicon Star, y la diferencia entre ambos modelos es notablemente clara: Qwen 4 Max piensa como un ingeniero mecánico estructural, mientras que Kimi K3.1 Pro piensa como un diseñador industrial.
En el prompt de Blender ("Muelle de mantenimiento de meganave orbital de Júpiter") y la prueba de puerta de aguas profundas de WebGL ("Puerta de los Diez Mil Mares"), qwen4-max-preview construyó costillas de carga interna más densas, brazos de acoplamiento complejos y un control deslizante de interfaz de usuario para el nivel de la marea que recalculaba dinámicamente las lecturas de altura y presión del agua. Sin embargo, los revisores calificaron consistentemente a kimi-k3.1-pro más alto en composición visual, iluminación de sombreadores de agua y armonía de color. Si estás creando interfaces orientadas al usuario, experiencias web 3D interactivas o agentes de documentos de contexto largo que necesiten una ventana de contexto de 1,048,576 tokens (1.05M) y 131,072 tokens de salida máxima hoy en día, Kimi K3.1 Pro está disponible en GPT Proto a 10.00 por cada 1M de salida (con la entrada en caché reduciéndose a $0.20 por cada 1M).
Qwen 4 Max vs GLM-5.3
Los desarrolladores que buscan qwen 4 max vs glm5.3 generalmente buscan eficiencia en programación de alto volumen y uso de herramientas a un precio agresivo. Aunque la promoción Lite del primer mes de $3 de Qwen 4 Max parece barata en papel, el límite de crédito renovable de 5 horas y la prohibición de scripts automatizados lo hacen inutilizable para flotas de agentes en segundo plano.
El glm-5.3 de Z.ai resuelve exactamente ese problema en una API medida. De hecho, supera ligeramente a Qwen 4 Max en capacidad total de contexto —ofreciendo una ventana de contexto de 1.05M junto con un límite de salida de 128K— y acepta entradas de texto, imagen y documentos. A 3.74 por cada 1M de tokens de salida en GPT Proto (15% por debajo de la tarifa oficial de Z.ai), GLM-5.3 es el caballo de batalla más rentable de pago por uso para bots de revisión de PR automatizados, enrutamiento de herramientas de alta concurrencia y generación de código de múltiples archivos.
Qwen 4 Max vs Claude Opus 5.5
Alibaba integró la compatibilidad nativa con la API de Anthropic Messages en qwen4-max-preview específicamente para atraer a los desarrolladores que analizan qwen 4 max vs claude opus 5.5 dentro de Claude Code. Como demostró la prueba de CLI de Python de WEEL, Qwen 4 Max ya puede ejecutar un bucle de reparación de pytest de 12 minutos y detectar errores sutiles de argparse e inyección CSV.
Donde claude-opus-5-5 mantiene una ventaja decisiva es en la eficiencia de trayectoria, la capacidad de respuesta en streaming y la confiabilidad del SLA de producción. Los evaluadores de la comunidad notaron que el ajuste de RL en etapa temprana de Qwen 4 Max puede hacer que realice bucles a través de comprobaciones de shell redundantes a ~33 tokens/s bajo razonamiento xhigh. Cuando estás refactorizando repositorios de producción de misión crítica donde los turnos de herramientas desperdiciados o el entrenamiento de datos de nivel personal son inaceptables, Claude Opus 5.5 ofrece una ventana de contexto de 1M y 128K de salida máxima con una adherencia a las instrucciones madura. A través de GPT Proto, puedes llamar a claude-opus-5-5 a 18.00 por cada 1M de salida—10% por debajo del precio oficial de Anthropic.
Cómo llamar a alternativas de producción mediante una API unificada
Si deseas ejecutar los cuatro modelos insignia de producción mencionados arriba sin tener que gestionar SDK de proveedores por separado, ventanas de crédito de suscripción o endpoints regionales sk-sp-, GPT Proto los expone todos detrás de una única ruta compatible con OpenAI (https://gptproto.com/v1/chat/completions).
Un detalle de autenticación que vale la pena notar antes de copiar el fragmento: como se documenta en nuestra guía de autenticación y nuestra página de inicio rápido, siempre envía tu clave en el encabezado Authorization con el prefijo Bearer (Authorization: Bearer $GPTPROTO_API_KEY). A continuación, se muestra un ejemplo basado en la documentación sobre cómo llamar a qwen3.8-max-0902 y cambiar directamente a glm-5.3, kimi-k3.1-pro o claude-opus-5-5 con solo cambiar una cadena de texto:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max-0902",
    "messages": [
      {
        "role": "user",
        "content": "Audita este analizador CLI de Python en busca de colisiones de flags de números negativos y riesgos de inyección de fórmulas CSV."
      }
    ]
  }'
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://gptproto.com/v1",
    api_key=os.environ["GPTPROTO_API_KEY"],
)

# Intercambia libremente el ID del modelo entre los modelos insignia de 1M de contexto:

# "qwen3.8-max-0902" ($1.40/$4.20) | "glm-5.3" ($1.19/$3.74)

# "kimi-k3.1-pro" ($2.00/$10.00)   | "claude-opus-5-5" ($3.60/$18.00)
response = client.chat.completions.create(
    model="qwen3.8-max-0902",
    messages=[
        {
            "role": "user",
            "content": "Audita este analizador CLI de Python en busca de colisiones de flags de números negativos y riesgos de inyección de fórmulas CSV.",
        }
    ],
)

print(response.choices[0].message.content)