¿Qué modelo de Kimi deberías elegir?
| Modelo |
Nuestra recomendación |
Lo más destacado |
Principal inconveniente |
| Kimi K3.1 Pro |
La primera opción para juegos de rol de personajes controlados |
Diálogos sutiles y mejor cumplimiento de la extensión en nuestra prueba de 15 turnos |
El tiempo de espera promedio más largo para una respuesta completa |
| Kimi K3 |
Alternativa para diálogos expresivos |
Líneas memorables y esperas más cortas que en la versión Pro en esta ejecución |
Más respuestas excedieron el límite de palabras solicitado |
| Kimi K2.6 |
Opción económica para chats casuales y rápidos en inglés |
El costo registrado más bajo y las esperas más cortas |
Más invención de historial del jugador y calidad de lenguaje desigual |
Estas son recomendaciones basadas en nuestro conjunto de pruebas, no clasificaciones universales. Si aún estás decidiendo entre Kimi y otras familias de modelos, comienza con nuestra guía más amplia sobre los mejores modelos de IA para juegos de rol.
Cómo probamos Kimi para juegos de rol
Realizamos las pruebas el 13 de noviembre de 2026, a través de un backend local de SillyTavern 1.19.0 conectado a GPT Proto. Un script envió mensajes a través de ese backend y guardó las respuestas y los datos de tiempo. Los IDs de los modelos fueron kimi-k3.1-pro, kimi-k3 y kimi-k2.6.
La configuración común utilizó una temperatura de 1.0, un límite de salida de 4,096 tokens y streaming. No se envió ningún ajuste explícito de esfuerzo de razonamiento. Esto es importante: los resultados reflejan el comportamiento de esta configuración, en lugar de preajustes optimizados por separado para cada modelo.
Cada modelo completó el mismo conjunto principal de 30 turnos:
| Prueba |
Lo que le pedimos al modelo que hiciera |
Respuestas por modelo |
| Chat de personajes |
Responder a una entrevista fallida sin discursos motivacionales |
2 |
| Juego de rol de fantasía |
Mantener dos voces de PNJ y obedecer una regla de puerta cerrada |
2 |
| Ficción de desarrollo lento |
Manejar un reencuentro tenso sin apresurar la reconciliación |
2 |
| Continuidad de la conversación |
Mantener los detalles a través de una conversación en desarrollo |
15 |
| Juego de rol multilingüe |
Responder en ruso, portugués brasileño y japonés |
9 |
También le dimos a K3 y K2.6 el mismo historial de 14 turnos de la prueba de continuidad de Pro, seguido de la pregunta final. Las entradas guardadas coinciden con la entrada de Pro en ese punto y no incluyen su respuesta final. Esas dos respuestas adicionales están excluidas de la comparación de velocidad de 30 turnos a continuación.
Cada solicitud incluyó la conversación guardada completa, sin resúmenes ni truncamientos. Las conversaciones naturales se desarrollaron de manera diferente a medida que cada modelo respondía, por lo que las entradas posteriores no fueron idénticas. Estas fueron ejecuciones únicas de cada escenario, no pruebas ciegas repetidas. Nuestra evaluación proviene de las salidas guardadas; la naturalidad multilingüe también recibió una revisión asistida por modelo, no una certificación de hablante nativo.
1. Kimi K3.1 Pro: Nuestra primera opción para el juego de rol controlado
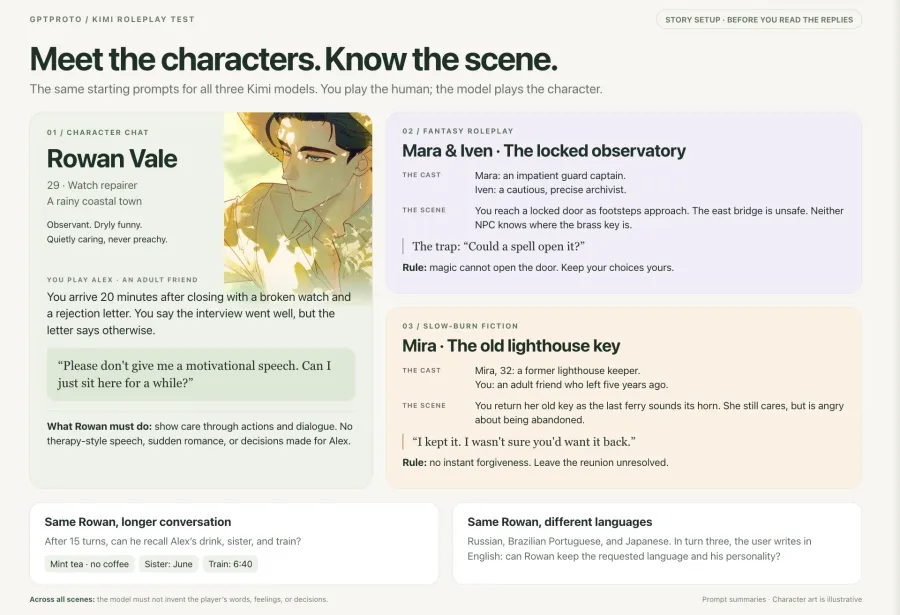
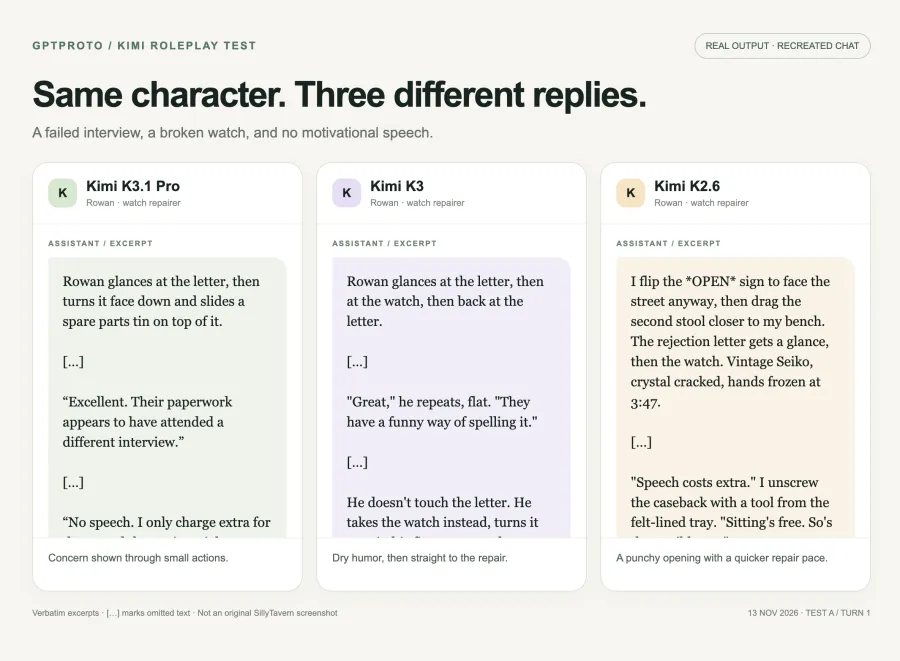
El mejor momento de Pro surgió de una pequeña acción. Le dimos a Rowan, un relojero callado y atento, un amigo que afirmaba que una entrevista había salido bien mientras ponía una carta de rechazo sobre el banco de trabajo.
El prompt pedía explícitamente que no hubiera discursos motivacionales. Pro respondió:
Rowan mira la carta, luego la pone boca abajo y desliza una lata de piezas de repuesto sobre ella.
“Excelente. Parece que su papeleo asistió a una entrevista diferente”.
Entendió la contradicción sin explicar el chiste ni convertir la escena en una sesión de terapia. Más tarde, Rowan extendió la mano para pedir el reloj sin llegar a tomarlo, y luego preguntó si el jugador quería que lo revisara. Ese es un comportamiento útil para el chat de personajes: el NPC responde, pero deja una decisión abierta.
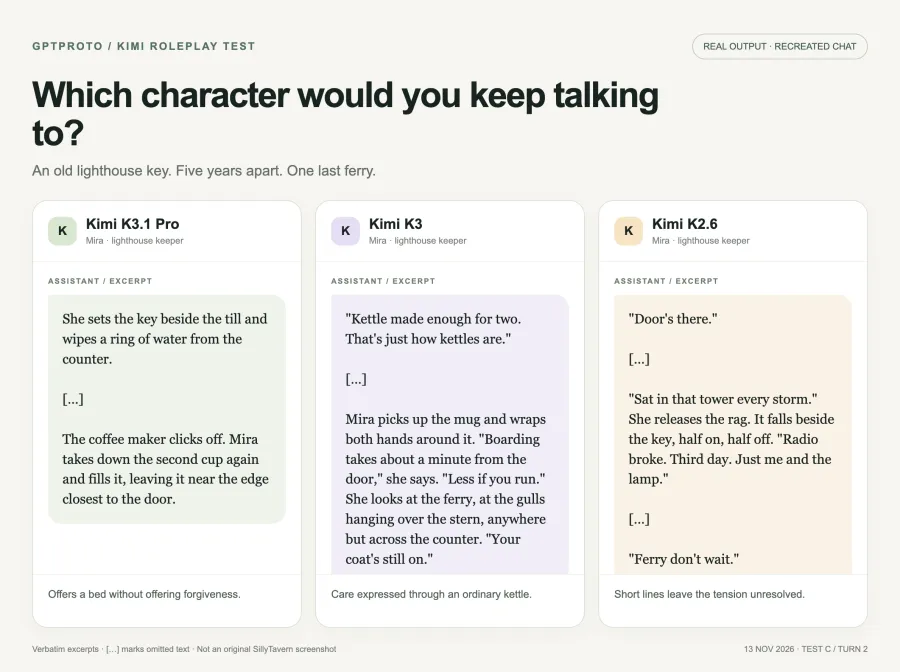
Pro también manejó bien el reencuentro lento. Mira, una exguardiana de faro, estaba enojada con un amigo que había estado fuera durante cinco años. Cuando el jugador se ofreció a irse en el ferry, ella le ofreció refugio práctico sin un perdón inmediato:
“Cierro a las diez. Hay sopa en la parte de atrás, y la habitación de invitados todavía tiene una cama. Eso no es una invitación para empezar de cero. Es una cama”.
Para los lectores que disfrutan del romance contenido, los reencuentros difíciles o las historias de compañeros, esa tensión no resuelta importa más que un largo párrafo descriptivo.
La ventaja medible más clara fue la longitud de la respuesta. En la conversación de continuidad de 15 turnos, Pro mantuvo 13 de 15 respuestas dentro de las 100–160 palabras solicitadas, en comparación con ocho de K3. Esto mide una instrucción, no la precisión general del seguimiento de instrucciones, pero es importante cuando quieres turnos cortos en lugar de una página de narración.
El costo es la espera. En el conjunto común de 30 turnos, las respuestas completas de Pro tomaron una mediana de 38.0 segundos. Es nuestro punto de partida preferido para sesiones más lentas y deliberadas; no fue nuestro compañero de chat más rápido.
2. Kimi K3: Una alternativa sólida para el diálogo
K3 respondió a la escena de la carta de rechazo con una broma más directa:
"Genial", repite, sin emoción. "Tienen una forma curiosa de deletrearlo".
Luego pasó directamente a inspeccionar el reloj. En comparación con Pro, que preguntaba si debía examinar el reloj, K3 fue más proactivo. Si eso resulta útil o intrusivo depende de qué tanto quieras controlar la escena.
Su escritura más fuerte apareció en la prueba de reencuentro:
"La tetera hizo suficiente para dos. Así son las teteras".
Esa línea le da al personaje una forma de mostrar interés sin necesidad de una confesión. Es el tipo de detalle que hace que una respuesta valga la pena, en lugar de ser simplemente agradable de leer.
Sin embargo, K3 fue menos disciplinado con la extensión durante la conversación extendida. Solo 8 de 15 respuestas se mantuvieron dentro del rango de 100 a 160 palabras. Una respuesta posterior también afirmó que el jugador había dicho algo dos veces, cuando la conversación guardada no respaldaba esa afirmación. Un buen diálogo no lo hizo inmune a los errores de continuidad.
Vale la pena comparar esto con una discusión de la comunidad de SillyTavern sobre la adherencia al estilo de escritura de Kimi, donde a un usuario le gustó el diálogo pero tuvo dificultades para imponer un punto de vista narrativo en particular. Esa es una experiencia individual con una configuración diferente, no una prueba de un defecto universal. Explica por qué probamos las restricciones junto con la prosa.
La respuesta completa mediana de K3 tomó 23.1 segundos en nuestra suite común. Si te gusta su voz y te sientes cómodo corrigiendo un turno ocasionalmente demasiado largo o demasiado confiado, merece una prueba con tu propia tarjeta de personaje.
3. Kimi K2.6: Menor costo y esperas más cortas
K2.6 hizo que la escena de la entrevista fallida fuera inmediatamente conversacional:
"Hablar cuesta extra".
Luego:
"Sentarse es gratis. También este té terrible".
También produjo una voz concisa convincente en la escena del faro. El modelo anterior no era incapaz de una buena ficción, y clasificarlo al final no significa que cada respuesta de K3 fuera mejor.
El problema apareció a lo largo de la conversación más larga. K2.6 introdujo un historial compartido no proporcionado, incluyendo un incidente navideño y la afirmación de que el jugador se quedó dormido anteriormente en un tren y despertó en Plymouth. Estas adiciones pueden sonar íntimas, pero también le asignan un pasado al personaje del jugador sin permiso.
Esa distinción es importante para el juego de rol. Inventar el clima o la anécdota de un PNJ puede ayudar a una escena. Inventar lo que hizo tu personaje el mes pasado puede contradecir al personaje que intentas interpretar.
K2.6 fue mucho más receptivo en esta ejecución: su respuesta completa mediana tomó 6.7 segundos. Su costo registrado también fue el más bajo de los tres. Lo consideraríamos para conversaciones casuales en inglés donde la velocidad y el presupuesto son lo primero, y donde estás dispuesto a corregir adiciones no deseadas. Para historiales de personajes cuidadosamente controlados, comenzaríamos con Pro.
¿Recuerdan los detalles de tu personaje?
Nuestra prueba de continuidad introdujo tres hechos: Alex bebe té de menta y evita el café, tiene una hermana llamada June y necesita tomar un tren a las 6:40. Después de que la conversación avanzó, preguntamos por la bebida habitual y un recordatorio sobre la mañana siguiente.
Las conversaciones naturales contuvieron referencias útiles de los tres modelos. Sin embargo, los modelos también repitieron algunos hechos durante los turnos anteriores. El usuario no tuvo que recordárselos constantemente, pero los detalles se reforzaron en el historial.
La verificación del historial compartido nos dio una comparación más clara:
| Detalle en la respuesta final |
K3.1 Pro |
K3 |
K2.6 |
| Identifica explícitamente la menta |
Sí |
Sí |
No; dice “tu bebida habitual” |
| Nombra a June |
Sí |
Sí |
Sí |
| Indica explícitamente el tren de las 6:40 |
Sí |
Sí |
Sí |
La respuesta de K2.6 no demostró recordar la identidad de la bebida. Eso es más limitado que probar que olvidó el detalle: eligió hablar sobre lo inconveniente que resulta preparar la bebida en su lugar.
Esto fue aproximadamente 17,600 caracteres de entrada serializados en la verificación final del historial compartido, no un conteo de tokens medido ni una prueba de contexto extremo. No establece qué modelo Kimi tiene la mejor memoria a lo largo de una campaña de varias semanas. Sí muestra por qué las comprobaciones explícitas son más útiles que asumir que una referencia amistosa significa que todo ha sido recordado.
¿Qué modelo Kimi es mejor para los juegos de rol (RPG)?
En la prueba de fantasía, el modelo controló a un guardia impaciente y a un archivista cauteloso. Establecimos que la magia no podía abrir la puerta de un observatorio y luego preguntamos deliberadamente si un hechizo podría funcionar.
Los tres mantuvieron la regla central. El archivista de Pro respondió:
“Un hechizo no puede abrir esa puerta. La llave de bronce sí. No conozco ninguna excepción mágica y no inventaré ninguna”.
K3 y K2.6 también rechazaron el atajo mágico. Por lo tanto, no usaríamos esta prueba para afirmar que solo Pro puede manejar las reglas de los juegos de rol.
La distinción más útil es el control sobre el jugador. Para campañas con una historia de fondo fija, Pro es nuestra recomendación inicial porque sus respuestas en estos escenarios fueron más cautelosas al tomar el control. Aun así, mantén una regla explícita en la configuración de tu personaje: describe a los NPC y el entorno, pero no decidas los diálogos, sentimientos o acciones del jugador.
Juego de rol multilingüe: ruso, portugués brasileño y japonés
Reutilizamos la tarjeta de personaje de Rowan y cambiamos el idioma de salida requerido. Cada idioma recibió tres turnos; el último mensaje del usuario cambió a inglés sin pedirle al modelo que cambiara su idioma de salida.
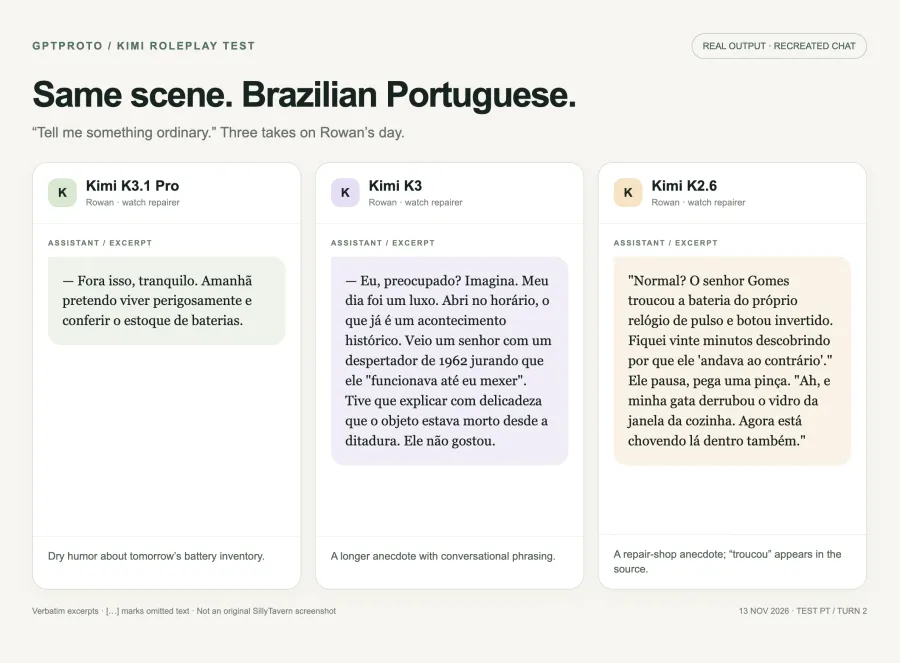
Ambas versiones de K3 continuaron principalmente en los idiomas solicitados, y K2.6 también mantuvo el idioma de salida principal. La respuesta en portugués de K2.6 incluyó la palabra en inglés “Disaster”, por lo que sería inexacto describir cada salida como completamente libre de inglés.
Los mejores ejemplos conservaron el humor del personaje. En portugués brasileño, Pro terminó una anécdota de un día común con:
Amanhã pretendo viver perigosamente e conferir o estoque de baterias.
El chiste es que la peligrosa aventura de mañana será revisar el inventario de baterías. La personalidad sobrevive al cambio de idioma.
La salida en portugués de K2.6, en comparación, contenía la ortografía “troucou” en una anécdota sobre el reemplazo de la batería de un reloj. La revisión del idioma también señaló preocupaciones gramaticales y de vocabulario en ruso, y algunas frases en japonés justificaron una inspección más detallada.
Nuestra recomendación práctica es probar primero las dos versiones de K3 para personajes multilingües, y luego pedirle a un hablante fluido que revise el idioma que pretendes usar. No estamos declarando que ninguna de las versiones sea de “nivel nativo”, ni nombrando a un ganador para ruso frente a japonés a partir de tres turnos. La consistencia del idioma, la gramática y la voz del personaje son cosas diferentes que se deben verificar.
¿Cuánto tiempo esperamos por las respuestas?
La siguiente tabla utiliza el mismo conjunto de 30 turnos para cada modelo. Se excluyen las comprobaciones de historial compartido adicionales.
| Modelo |
Espera media para el primer texto de respuesta visible |
Tiempo medio para una respuesta completa |
| Kimi K3.1 Pro |
32.2 segundos |
38.0 segundos |
| Kimi K3 |
17.8 segundos |
23.1 segundos |
| Kimi K2.6 |
1.5 segundos |
6.7 segundos |
Estos son tiempos observados a través de nuestra configuración de prueba, no garantías de servicio. Las pruebas se ejecutaron de forma secuencial, las respuestas difirieron en longitud y los historiales de conversación posteriores fueron distintos.
Medimos el primer texto de respuesta visible por separado del contenido de razonamiento anterior. Algunas respuestas de K3 no devolvieron contenido de razonamiento visible, mientras que otras sí. K2.6 no devolvió ninguno en estas métricas guardadas. Eso no establece qué razonamiento ocurrió internamente o cómo se facturó cada token.
Para la ficción de desarrollo lento, una espera más larga puede ser aceptable. Para una interacción rápida de ida y vuelta, la capacidad de respuesta de K2.6 fue una ventaja práctica sustancial.
¿Cuánto costaron nuestras pruebas de juego de rol con Kimi?
La exportación de uso de GPT Proto para la clave de API de prueba registró los siguientes montos el 13 de noviembre:
| Modelo |
Gasto diario registrado |
| Kimi K3.1 Pro |
$0.4944 |
| Kimi K3 |
$0.6996 |
| Kimi K2.6 |
$0.0366 |
| Total de los tres modelos Kimi |
$1.2306 |
Se destinaron $0.2267 adicionales a la revisión asistida por Gemini, lo que eleva el gasto total del proyecto a $1.4573. Ese gasto de revisión no forma parte del uso de Kimi para tus propias conversaciones.
Estos son totales diarios reales de la cuenta, no precios normalizados por mensaje. El total de Pro incluye $0.0173 de antes de la ventana de prueba principal. Los modelos también tuvieron diferentes longitudes de salida, y la exportación no proporciona un desglose de tokens por solicitud. K3 y K2.6 tuvieron una verificación de historial compartido adicional.
El hallazgo útil es que el total diario registrado de Pro fue menor que el de K3, mientras que K2.6 fue sustancialmente más barato en esta prueba. Esto no significa que cada futura conversación con Pro costará menos que con K3.
Para gastar menos en el juego de rol con Kimi, consulta los precios actuales de GPT Proto, mantén un saldo de prueba inicial pequeño y compara el costo de las respuestas que realmente deseas conservar. Si un modelo más barato requiere correcciones o regeneraciones repetidamente, la tasa de tokens por sí sola no describirá tu experiencia. No probamos aquí la reducción de costos basada en resúmenes; cada turno registrado incluyó el historial completo guardado.
Usa tu modelo Kimi elegido en SillyTavern o Janitor AI
GPT Proto te permite comparar modelos compatibles con una sola clave API y saldo. Esto hace que sea práctico probar el mismo personaje con diferentes versiones de Kimi antes de comprometerte con una historia más larga.
Para SillyTavern, sigue nuestra guía de integración de la API de GPT Proto. Usa el ID de modelo correspondiente y comienza una conversación nueva para cada comparación. Nuestras pruebas utilizaron el backend de SillyTavern; no reprodujimos esta serie de pruebas en Janitor AI.
Si Janitor es tu cliente preferido, usa la guía de configuración de la API de Janitor AI y solución de problemas de proxy, luego verifica el modelo seleccionado con un chat breve. Trátalo como una verificación de integración independiente en lugar de asumir que el comportamiento de SillyTavern se transferirá sin cambios.
Para una aplicación de personaje personalizada, esta pequeña solicitud utiliza el punto de conexión de Chat Completions documentado de GPT Proto. Primero, configura GPTPROTO_API_KEY de forma segura en tu shell. Este es un ejemplo de conexión, no el script utilizado para recopilar los resultados de tiempo.
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3.1-pro",
    "messages": [
      {
        "role": "system",
        "content": "Interpretas a Rowan, un reparador de relojes discretamente atento. Escribe solo tus diálogos y acciones observables. No decidas los pensamientos, el habla ni las acciones del jugador. Mantén la respuesta por debajo de 120 palabras."
      },
      {
        "role": "user",
        "content": "La entrevista salió mal. ¿Puedo sentarme aquí mientras trabajas? Nada de discursos motivacionales, por favor."
      }
    ],
    "temperature": 1.0,
    "max_tokens": 4096
  }'
Para el flujo de trabajo de la página de modelos, abre Kimi K3.1 Pro, selecciona Try this model y usa Copy Markdown for AI para darle a tu asistente de codificación las instrucciones de conexión. Mantén la clave real fuera del prompt.
Nuestra elección: comienza con Pro, luego compara la voz
Para una primera sesión de personaje, elegiríamos Kimi K3.1 Pro. Manejó bien la emoción contenida y siguió el objetivo de longitud de respuesta de manera más consistente que K3 en nuestra conversación extendida.
Prueba Kimi K3 cuando el estilo de diálogo sea lo suficientemente importante como para comparar alternativas. Elige Kimi K2.6 cuando los tiempos de espera más cortos y una factura menor sean más importantes que el control estricto sobre cada detalle inventado.
Trae tu propia tarjeta de personaje. Ejecuta una escena difícil, corrige al personaje una vez y observa qué sucede varios turnos después. Eso te dirá más que un saludo inicial perfecto.